
TL;DR:應該選擇哪個 GPT-6 Astra API 替代方案?
請按工作負載選擇模型:Claude Opus 5 作為最接近的高階替代,Claude Fable 5.1 用於最難的持續推理,GPT-5.6 Sol 便於最低摩擦的 OpenAI 遷移,Claude Sonnet 5 適合高量產線,Gemini 3.8 Flash 用於低成本多模態任務,當以 token 成本為首要約束時則選 DeepSeek V4.1 Flash。
保留 GPT-6 Astra 用於其更強的電腦操作、自主執行、科學推理或網路安全表現能實質降低重試與人工介入的工作負載。
重點摘要:替換 GPT-6 Astra 時應關注什麼?
- GPT-6 Astra 在其最強的代理型任務上難以替代。官方 GPT-6 Astra 基準表記錄了 Terminal-Bench 4.0 的 57.9%、FrontierMath Tier 4 的 97.6%、以及 GPQA Diamond 的 96.0%。
- Claude Opus 5 是最平衡、值得優先測試的直接替代。Anthropic 將 Opus 5 定價為每百萬輸入/輸出 token 分別 $5/$25,為 Astra 基礎費率的一半。
- Claude Fable 5.1 並非預算型替代。其$10/$50 輸入/輸出定價與 Astra 標稱費率一致,且在選定的知識與長期推理評測上偏向 Fable 5.1。
- GPT-5.6 Sol 是最容易的降級選擇,而非真正的平臺切換。其 1.05M 上下文視窗、128K 最大輸出與 $4/$20 定價,降低了 OpenAI 應用的遷移摩擦。
- Gemini 3.8 Flash 在託管價效上具優勢。其2026 年導入價為 $0.75/$3.75 的每百萬輸入/輸出 token。
- DeepSeek V4 Flash 屬於不同的成本級別。其官方尖峰與離峰費率遠低於高階模型,但更低的 token 成本並不代表相同的代理成功率。
- 最佳的產線指標通常是每個被接受且完成任務的成本。請納入重試、工具失敗、延遲、輸出 token 使用量與人工返工。
什麼是 GPT-6 Astra API?
OpenAI 將 GPT-6 Astra 定位為面向複雜端到端工作的旗艦模型。其 API 規格包括1,050,000-token 的上下文視窗與 128,000-token 最大輸出、文字與圖片輸入、推理 token 支援、以及五檔推理力度設定:low、medium、high、xhigh、max。
Astra 有別於傳統聊天機器人,因其設計用於長時間執行。官方能力總覽強調電腦操作與專業工作,以及軟體工程、瀏覽、科學、網路安全與複雜推理。
| GPT-6 Astra specification | Value |
|---|---|
| API model ID | gpt-6-astra |
| Provider | OpenAI |
| Context window | 1,050,000 tokens |
| Maximum output | 128,000 tokens |
| Input | Text, images |
| Output | Text |
| Knowledge cutoff | April 30, 2026 |
| Reasoning effort | Low, medium, high, xhigh, max |
| Standard input price | $10 / 1M tokens |
| Cached input | $1 / 1M tokens |
| Standard output price | $50 / 1M tokens |
| Long-context threshold | More than 272K input tokens |
長上下文定價說明:
其整個請求將以 $20/M 輸入與 $75/M 輸出重新計價。請對此類請求單獨編列預算。
為何團隊會考慮 GPT-6 Astra 以外的選項
當 Astra 的額外能力能消除失敗嘗試、工具錯誤、人工介入或反覆呼叫較弱模型時,最具吸引力。但對於摘要、抽取、分類、常規 RAG、一般聊天與標準程式碼生成等任務,其高昂定價較難合理化。
因此,團隊會評估替代方案以降低成本、留在既有供應商生態、改善快取經濟性、增加多模態支援,或以更快的模型處理常規流量,並保留 Astra 供升級處理。
基準比較與侷限
證據說明:下表採用 OpenAI 發佈的比較框架,在共同設定下放置若干替代方案。這些由廠商回報的分數會隨模型快照、提示、工具與評測方法變動;請用於篩選候選,最後仍需在具代表性的產線任務上驗證決選名單。
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
結果顯示,稱任何模型為通用的「Astra 替代品」都不精確。Astra 在多項代理與科學評測中有明顯領先,而 Fable 5.1 在 Humanity’s Last Exam 表現更佳,且多個替代方案在 DeepSWE 上極為接近。
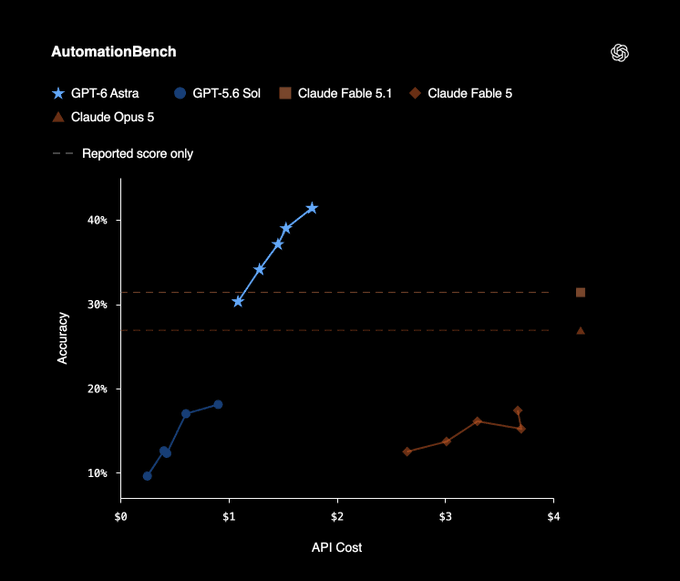
OpenAI 官方 AutomationBench 基準圖。
公開的基準索引也會隨方法與模型快照修訂而變動。請用於篩選,而非取代針對特定工作負載的評估。
GPT-6 Astra 的替代方案
沒有單一模型能在每種工作負載上取代 Astra。最實際的選擇取決於你所需的能力、既有供應商生態、以及失敗或重跑的成本。
| Alternative | Official input / output price per 1M tokens | Context | Best reason to choose it |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | 最接近的整體高階替代 |
| Claude Fable 5.1 | $10 / $50 | 1M | 最難推理與長時間代理 |
| GPT-5.6 Sol | $4 / $20 | 1.05M | 最低摩擦的 OpenAI 遷移 |
| Claude Sonnet 5 | $2 / $10 | 1M | 高量產線生產 |
| Gemini 3.8 Flash | $0.75 / $3.75 promotional | 1M | 低成本多模態與批次工作 |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | 最低 token 成本與高量處理 |
Claude Opus 5
為何考慮
當產品需要高階推理、程式設計或專業工作效能,且希望低於 Astra 的標價時,Claude Opus 5 是首個應測的替代方案。
價格、上下文與快取
Anthropic 將 Claude Opus 5 定價為每百萬輸入 $5、輸出 $25,並提供 1M-token 上下文視窗。正式上線前請確認當前快取條款以利預算編列。
表現良好的場景
在程式設計、分析、專業寫作與代理工作流程上具競爭力;前述基準顯示其在 DeepSWE 與 FrontierCode 上接近 Astra。
侷限
未能持續超越 Astra。當電腦操作、進階自主執行、網路安全或 OpenAI 原生工具是產品核心時,Astra 仍更有優勢。
適用/避免時機
適用於: 高階程式代理、複雜分析與專業寫作。避免於: 工作流程高度依賴 Astra 特定工具或電腦操作能力。
Claude Fable 5.1
為何考慮
Claude Fable 5.1 是面向最難推理、研究、程式設計與長時間代理任務的旗艦對手,而非低成本替代。
價格、上下文與快取
其每百萬輸入 $10、輸出 $50 的費率與 Astra 一致。1M-token 上下文視窗與每百萬 $0.25 的快取讀取價,在大型提示頻繁重用時可改善經濟性。
表現良好的場景
對長時推理與快取密集的代理尤具吸引力;在前述比較中,其於帶工具的 Humanity’s Last Exam 領先 Astra。
侷限
無法降低標稱 token 費率,而且 Astra 在多項代理與科學基準及 OpenAI 原生工具上仍具優勢。
適用/避免時機
適用於: 追求極致推理品質與重複長上下文的工作流程。避免於: 主要目標是大幅降低標準 token 定價。
GPT-5.6 Sol
為何考慮
GPT-5.6 Sol 為既已圍繞 OpenAI 相容行為與工具打造之應用提供最低摩擦的遷移。
價格、上下文與快取
引用的模型規格為每百萬輸入 $4、輸出 $20,1.05M 上下文視窗,128K 最大輸出。最終預算前請核實當前快取輸入條款。
表現良好的場景
在 DeepSWE 與 GPQA Diamond 上與 Astra 相近,同時於標準短上下文層級下成本大幅更低。
侷限
在 Terminal-Bench 與 FrontierMath 所代表的任務上差距擴大,若較低的任務完成度導致重試或人工修復,節省可能消失。
適用/避免時機
適用於: 既有 OpenAI 應用與不需 Astra 最強代理能力的一般工作負載。避免於: 工作負載反覆受益於 Astra 在基準上的大幅領先。
Claude Sonnet 5
為何考慮
Claude Sonnet 5 是實務產線的默認選擇,適合不需每次都用到前沿旗艦的稱職、可重複知識工作。
價格、上下文與快取
其長期費率為每百萬輸入 $2、輸出 $10,提供 1M-token 上下文視窗。對提示重用密集的部署,請確認當前快取條款。
表現良好的場景
適用於工單分類、文件抽取、標準 RAG、內容轉換、程式碼解說、常規函式呼叫與結構化生成。
侷限
無法穩定取代 Astra 處理每一個長期或前沿推理問題。
適用/避免時機
適用於: 高量產線流量與常規商務自動化。避免於: 困難代理任務失敗的成本高於使用旗艦模型的溢價。
Gemini 3.8 Flash
為何考慮
Gemini 3.8 Flash 將多模態輸入、大上下文與低託管 API 成本結合,適合文件、媒體、程式設計與批次管線。
價格、上下文與快取
其導入期費率為每百萬輸入 $0.75、輸出 $3.75(至 2026-12-31),具有 1M-token 上下文視窗,且促銷期間快取折扣。
表現良好的場景
適合多模態抽取、PDF、音訊、影片、影像、大型文件集合、批次分析與成本敏感的程式設計工作負載。
侷限
促銷定價有期限;對最難的自主代理或電腦操作任務,仍須相對 Astra 進行工作負載特定驗證。
適用/避免時機
適用於: 低成本多模態與高量批次處理。避免於: 無論 token 成本如何,應用都需要最強的自主執行。
DeepSeek V4.1 Flash
為何考慮
DeepSeek V4.1 Flash 是以成本為先的選項,面向高吞吐的推理、程式設計、摘要、抽取、分類與離線處理。
價格、上下文與快取
其尖峰與離峰價目表列示:快取命中輸入 $0.007–$0.014/M、快取未命中輸入 $0.22–$0.44/M、輸出 $0.66–$1.32/M,並提供 1M-token 上下文視窗。發布前請重查最新 V4.1 定價頁。
表現良好的場景
當 token 成本占主導,且應用能透過路由、驗證或離線品質檢查管理變異時最具吸引力。
侷限
更低的 token 價格不代表相同的自主任務成功率。可靠性、工具行為、延遲與接受率必須在目標工作負載上量測。
適用/避免時機
適用於: 具驗證的、大規模成本敏感處理。避免於: 高價值自主執行一旦失敗,將抵銷 token 節省。
GPT-6 Astra 對比替代方案:各類別誰勝出?
綜合定價、架構、上下文與基準證據,比單純從第一排到第六更有用的決策表如下。
| Category | Best choice | Why |
|---|---|---|
| Overall Astra alternative | Claude Opus 5 | 以半價提供接近前沿的整體表現 |
| Maximum reasoning | Claude Fable 5.1 | 旗艦級推理與強大的長期表現 |
| Stay inside OpenAI | GPT-5.6 Sol | 相似 API 生態且 token 價格低 60% |
| High-volume production | Claude Sonnet 5 | 以 $2/$10 提供高品質 |
| Multimodal price/performance | Gemini 3.8 Flash | 1M 上下文加上 2026 年超低導入價 |
| Lowest API cost | DeepSeek V4.1 Flash | 輸入 $0.22–$0.44、輸出 $0.66–$1.32 |
| Computer-use-heavy agents | GPT-6 Astra | Astra 最明確的差異化之一 |
| Scientific and difficult mathematical workflows | GPT-6 Astra | FrontierMath 與科學代理結果非常強勁 |
| Cache-heavy long agents | Claude Fable 5.1 | $0.25/M 快取讀取 |
最重要的結論是 GPT-6 Astra 仍在若干類別取勝。介紹替代方案的文章不應暗示較便宜的模型能普遍取代它。當 Astra 較高的任務完成率可取代若干較弱模型的多次嘗試時,即便昂貴,也依然經濟。
以替代 GPT-6 Astra API,實際能省多少?
考慮某工作負載消耗 100 萬未快取輸入 token 與 200,000 輸出 token。忽略快取折扣、工具費用、重試、批價與長上下文加價:
| Model | Approximate API cost |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Gemini 3.8 Flash promotional rate | $1.50 |
| DeepSeek V4.1 Flash off-peak | $0.35 |
基本計算為:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
這個簡單示例也說明為何 token 定價不能是唯一指標。若一次 $20 的 Astra 請求可成功,而一個 $4 的模型需要六次嘗試、多次工具重試與人工修復,那麼 Astra 其實更便宜。
更好的產線指標是:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
請同時追蹤該數字與延遲、任務成功率、重試率、工具呼叫錯誤、以及升級至人工的比率。
如何透過 CometAPI 測試 GPT-6 Astra 替代方案?
多模型 API 層的一個實務好處是:評估不必變成供應商整合專案。CometAPI 透過單一模型目錄提供 GPT-6 Astra API、GPT-5.6、Claude Fable 5.1、Claude Sonnet 5、Gemini 3.8 Flash 與 DeepSeek V4.1 Flash。
使用 OpenAI 相容的用戶端,可將模型設為可配置,而非硬編碼:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
你可以使用如下模型 ID 重新執行相同評估集:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
這通常比只看基準排行榜更具資訊價值。取 100–500 個具代表性的產線提示,記錄任務成功、人審通過、重試、工具錯誤、總 token、延遲與總 API 成本。
應以一個模型替換 GPT-6 Astra,還是使用模型路由?
對許多應用而言,用一個通用模型替換 Astra 並非最佳化之道。更有效率的架構如下:
- 例行流量 → Claude Sonnet 5、Gemini 3.8 Flash 或 DeepSeek V4.1 Flash
- 困難推理 → Claude Opus 5 或 GPT-5.6 Sol
- 非常困難的長期任務 → Claude Fable 5.1 或 GPT-6 Astra
- 電腦操作或 Astra 特定代理流程 → GPT-6 Astra
這將 Astra 變為升級模型,而非預設模型。若只有 10% 的請求真正需要前沿代理效能,將 100% 的流量都送往 Astra 等於為另外 90% 支付溢價。
應該選擇哪個 GPT-6 Astra API 替代方案?
若想在品質與價格上取得最接近的整體平衡,請選擇 Claude Opus 5。
若最大化推理品質比降低標稱 token 費率更重要,請選擇 Claude Fable 5.1。
若你已使用 OpenAI,且希望最小化整合變更,請選擇 GPT-5.6 Sol。
若你的產線流量多為稱職但普通的知識工作,請選擇 Claude Sonnet 5。
若重視多模態、規模與低託管 API 成本,請選擇 Gemini 3.8 Flash。
若 token 成本是主要約束,且工作負載可容忍更多評估與驗證,請選擇 DeepSeek V4.1 Flash。
而當應用確實受益於更強的電腦操作、困難的自主軟體工作、科學推理或其他代理能力時,請選擇 GPT-6 Astra 本身。
最大錯誤並非選錯「前沿模型」,而是為那些從未需要前沿模型的請求支付前沿模型的價格。
常見問題
GPT-6 Astra API 的最佳整體替代是什麼?
Claude Opus 5 是最強的通用替代之一。其具備 1M 上下文視窗、強大的程式與代理能力,並提供 $5/$25 的標價——為 Astra 標準 token 費率的一半。
最便宜的 GPT-6 Astra 替代是什麼?
在本文涵蓋的模型中,DeepSeek V4.1 Flash 擁有最低的一方定價。其目前離峰費率為未快取輸入 $0.22/M、輸出 $0.66/M。然而,僅因更便宜不應假定其能匹敵 Astra 的自主任務成功率。
Claude Fable 5.1 是否優於 GPT-6 Astra?
兩者皆非每種工作負載的贏家。OpenAI 的比較顯示 Astra 在 FrontierMath Tier 4 與 Terminal-Bench 4.0 上有顯著優勢,而 Fable 5.1 在帶工具的 Humanity’s Last Exam 得分更高。
在有了 GPT-6 Astra 之後,GPT-5.6 Sol 是否仍值得使用?
是。其 $4/$20 的標準 API 定價明顯低於 Astra 的 $10/$50,且保留 1.05M 上下文視窗。因此對 Astra 提升無法實質改善任務完成的工作負載而言,它可成為更好的預設。
Gemini 3.8 Flash 是否足以取代 GPT-6 Astra?
對某些程式設計、多模態、文件與批次處理工作負載而言,是的。它便宜許多,且具 1M 上下文視窗。對最困難的自主代理與電腦操作任務,Astra 仍是更強選擇。
GPT-6 Astra 在超長提示上是否有定價劣勢?
是。OpenAI 在輸入超過 272K tokens 時採用更高定價層級,故長上下文請求應單獨編列預算。
我應該用 token 價格或基準分數比較模型?
兩者僅作篩選指標。產線中最重要的通常是每個被接受且完成任務的成本,並包含推理 token、重試、工具呼叫、延遲與人工返工。
我可以在同一應用中使用多個 GPT-6 Astra 替代方案嗎?
可以。在許多應用中,模型路由優於將每個請求綁定到單一模型。可用低成本模型處理例行請求,而更強的模型處理逐步升級的困難任務。