

TL;DR
Claude Opus 5.5 是一個強而有力的起始候選,因為它在多項公開評測中可與 Fable 5.1 相當或更勝一籌,同時提供顯著更低的 token 定價:輸入每百萬 $4、輸出每百萬 $20;相比之下,Fable 5.1 分別為 $10 與 $50。
Fable 5.1 仍有其角色:當任務異常困難、執行時間長、重試成本高,或預期在缺乏嚴密監督下運作時。實務法則很簡單:先用 Opus 5.5,僅當具代表性的生產測試顯示 Fable 5.1 確實能足以降低失敗、修正或重試成本,才升級以支付其溢價。
Claude Opus 5.5 vs Claude Fable 5.1 一覽
| Dimension | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Release date | Sep. 22, 2026 | Sep. 1, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Context / max output | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache read per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-to-Rust migration | 9.5 hours; 51% lower task cost | 12 hours; baseline task cost |
| Speed option | Fast mode, up to 2.5× normal speed | No equivalent launch mode |
| Effort starting point | Medium-oriented | High |
| Best default use | Daily frontier coding, agents, supervised production, and high-volume API traffic | Highest-value, difficult, long-running, or unattended autonomous work |
| API access | Anthropic API and compatible providers including CometAPI | Anthropic API and compatible providers including CometAPI |
閱讀說明:基準數據由 Anthropic 報告,並取決於 effort 等級、評測框架、安保措施、任務版本、試驗次數與標準誤。僅應在匹配的評測條件下比較。
關鍵重點
- Opus 5.5 的標準輸入與輸出費率比 Fable 5.1 低 60%。
- 兩者皆支援 1M-token 上下文與最高 128K 輸出,因此成本、effort 設定與工作負載適配,比名目上下文大小更重要。
- Anthropic 公布的結果顯示,Opus 5.5 在多項程式與代理型評測上佔優,但評測設定會顯著影響結果。
- 獨立評測支持 Opus 5.5 的前沿地位,但回報的絕對分數有所不同,強化了進行匹配測試的必要性。
- 對多數受監督的生產工作而言,Opus 5.5 是更強的起點。Fable 5.1 是升級層,而非自動預設。
什麼是 Claude Opus 5.5?
Claude Opus 5.5 是 Anthropic 的首個 Claude 5.5 模型。定位於代理式程式開發、長時代理、專業知識工作、企業流程、財務分析、視覺與電腦操作。
其 API model ID 為 claude-opus-5-5。自適應思考始終啟用,開發者可透過 low、medium、high、xhigh 與 max 的 effort 設定控制推理強度。Anthropic 亦提供 Fast mode,可在 $8/M 輸入與 $40/M 輸出下,以最高 2.5 倍於一般速度執行。
什麼是 Claude Fable 5.1?
Claude Fable 5.1 定位於要求嚴苛、長時間的專案,例如多小時的程式工作、複雜研究、瀏覽器互動、自主代理,以及跨應用的工作流程。
其 API model ID 為 claude-fable-5-1。採用自適應思考,起始於較高的 API effort 設定;當失敗或重試的預期成本高於額外的推理成本時,最適合作為高階選擇。
簡化來看,Opus 5.5 幾乎以 Fable 標準 token 價格的 40% 提供相近的能力範圍。但這正是為何僅靠規格表會產生誤導。
程式碼與基準比較
Anthropic 報告在 Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0、GDPval-AA v2.1、AutomationBench、Humanity's Last Exam(含工具)、Terminal-Bench-Science、OSWorld 2.0 與 Chartography 等,Opus 5.5 領先 Fable 5.1。
如何解讀基準結果
Anthropic 在 Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0、GDPval-AA v2.1、AutomationBench、Humanity's Last Exam(含工具)、Terminal-Bench-Science、OSWorld 2.0 與 Chartography 上報告 Opus 5.5 領先 Fable 5.1。這些數據是評估結果,而非與配置無關的模型常數。
多數 Opus 5.5 的頭條分數使用 max effort,而 Terminal-Bench 4.0 使用 xhigh。評測框架設計、工具配置、安保、試驗次數、標準誤、回退行為與成本上限等都會改變結果。Anthropic 亦提醒,基準的差距可能高估了前沿模型在實務上的差距。
程式表現
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | 解讀 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 對終端代理任務有 10.6 個百分點的報告領先 |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Opus 5.5 的 medium 仍具生產經濟性的競爭力 |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | medium effort 略高於所報告的 Fable 結果 |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | 在專業代理型工作上具報告優勢 |
這些數據是 Anthropic 報告的基準結果。請結合後續章節中的評測設定注意事項與官方 Claude Opus 模型頁一併閱讀。
前三個結果之所以突出,是因為它們涵蓋了 Claude 在商業上愈加重要的工作負載:軟體工程代理。Terminal-Bench 4.0 顯示 10.6 個百分點的絕對差距;FrontierCode 顯示 4.1 點;CursorBench 4.0 顯示 6 點。
衡量專業代理型工作的 GDPval-AA 也報告了 Opus 5.5 為 1846 Elo、Fable 5.1 為 1735 Elo。若僅看這些數字,產品階層似乎顛倒。然而事情並非如此單純。
獨立評測
Artificial Analysis 將 Opus 5.5 Max 評為其 Intelligence Index 的 58,並在 AA-Briefcase、GDPval-AA、AutomationBench-AA、Terminal-Bench 4.0、SciCode 與 Humanity's Last Exam 上展現強勁表現。其 Terminal-Bench 4.0 結果為 59.6%,低於 Anthropic 的 66.4%,說明當分數不一致時,團隊應記錄模型版本、effort 設定、評測框架、工具、試驗次數與成本上限。
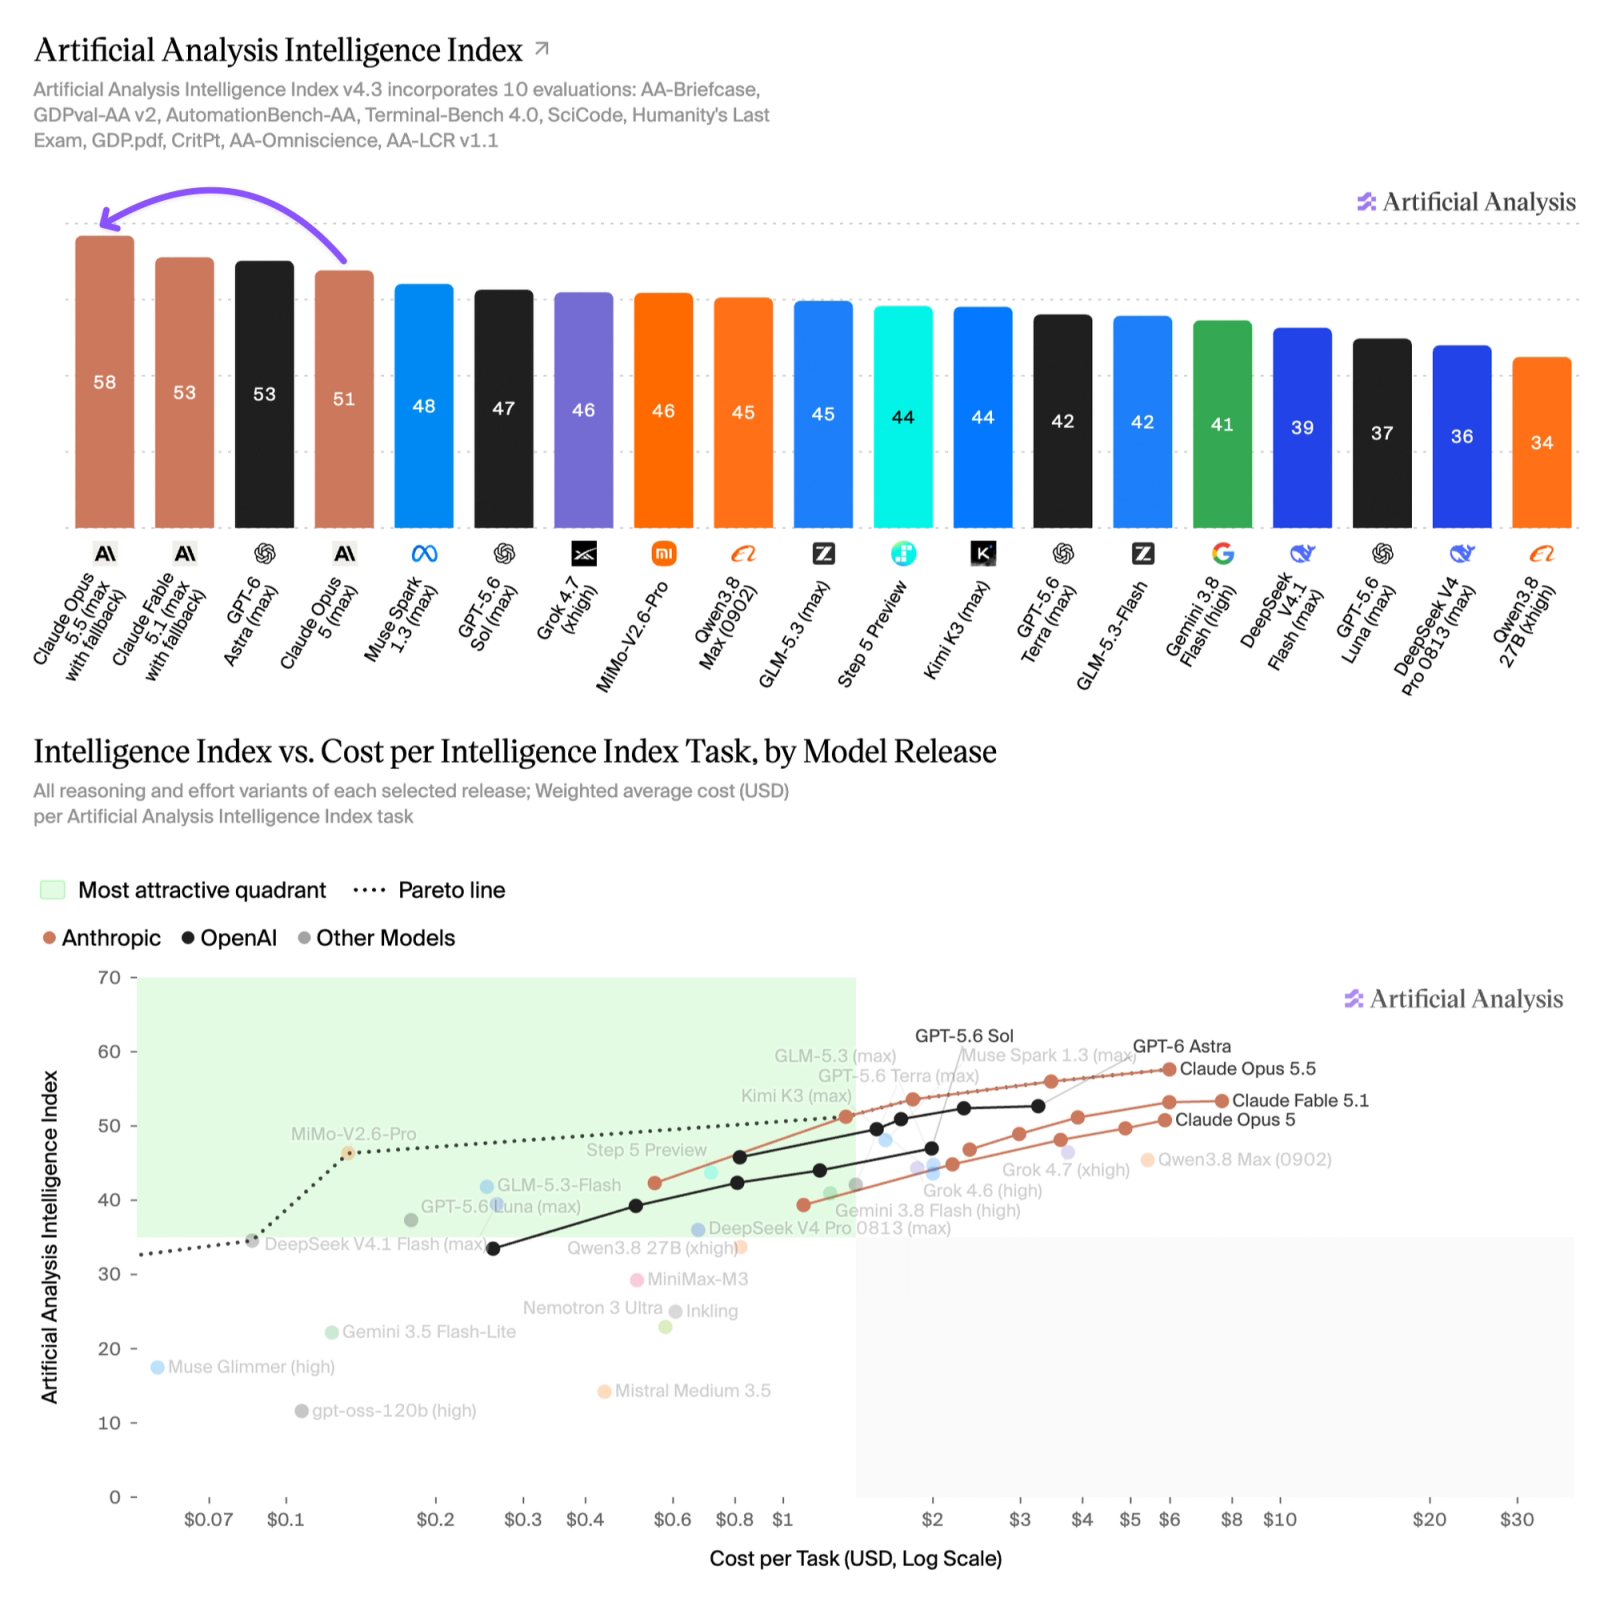
價格與完成任務成本比較
CometAPI 提供低於官方的 token 價格,讓開發者能用標準訊息請求格式達到與官方 API 相同的效能。
Token 價格
| Pricing | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| 5-min cache write | $5 | $12.50 |
| 1-hour cache write | $8 | $20 |
| Cache read | $0.20 | $0.25 |
| Batch input/output | 50% discount | 50% discount |
假設某工作負載消耗 10 百萬新鮮輸入 token 與 2 百萬輸出 token,在無快取影響下:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
在這些假設下,Opus 5.5 成本低 60%。但此數字不應與 Anthropic 所述「Opus 5.5 相較 Opus 5 的執行成本約低 40%」混為一談。
這是兩種完全不同的比較。40% 的數字包含了 Opus 5.5 相較 Opus 等級更低的價格「以及」相對 Opus 5 每項任務減少的 token 消耗。60% 的數字則是直接比較 Opus 5.5 與 Fable 5.1 的標價。
每項完成任務的成本
模型 API 真正賣的不是 token。開發者購買的是完成的工作。
程式團隊不在乎模型用掉了 6.2 百萬 token;他們在乎模型是否修好了 bug、完成了遷移、通過了測試套件,或完成了研究任務。
Anthropic 在其What a task costs on Opus 5.5 分析中直接指出:兩個價格相近的模型,若其中一個需要更多回合、重讀更多上下文、更常重試,或產生更多思考 token,任務成本可能差異巨大。
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
最後一項常被忽略。較便宜的模型若失敗兩次,可能比一次就完成任務的較貴模型更昂貴。同樣地,能避免十次重試回合的高 effort 設定,實際上可能降低總成本。
提示快取經濟學
大量使用快取的代理會反覆重用工具定義、版本庫上下文、系統指令、對話歷史與測試輸出。由於 Opus 5.5 與 Fable 5.1 的快取讀取價格分別為 $0.20/M 與 $0.25/M,差距遠小於新鮮輸入定價 $6/M 的差異。因此,團隊應分別追蹤新鮮輸入、快取讀取、快取寫入、輸出、工具回合與重試。
Effort 等級經濟學
有可能。Artificial Analysis 測試了五種 Opus 5.5 的 effort 設定,並發現明確的能力—成本曲線。
| Opus 5.5 effort | Artificial Analysis Intelligence Index | 每個 Index 任務成本 |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Medium effort 對於例行的程式變更、已知重構與受監督除錯是合理的起點。對於模糊的系統故障、通宵遷移,或錯誤計畫會帶來大量返工的任務,高或 xhigh 可能更有正當性。
安全性與可靠性比較
僅憑能力基準不應將任一模型標示為更安全。可辯護的比較需要匹配的提示、工具、權限、effort 設定、重試上限與驗收標準。更高的能力可減少偶發錯誤,但更大的自主性與更長的執行時間也會放大錯誤計畫、提示注入、不安全工具呼叫或未被察覺漂移的影響。
| Safety dimension | 實務比較 | 生產控制 |
|---|---|---|
| Reasoning and effort | Opus 5.5 暴露多種 effort 等級,而 Fable 5.1 從較高 effort 姿態起步。更多推理不等於政策執行。 | 依工作負載固定 effort 政策,且每次變更皆重測安全行為。 |
| Long-running autonomy | Fable 5.1 定位於困難、無人看管的工作;Opus 5.5 亦支援代理型工作流。風險隨時間、權限與不可逆動作數量增加而增長。 | 使用檢查點、審批閘、時間與成本上限,以及自動回滾或關閉條件。 |
| Tool and computer use | 兩者皆可操作工具,因此僅靠模型選擇無法控制資料暴露或破壞性動作。 | 採最小權限、允許清單、沙箱、機密隔離,並在外部或不可逆動作前要求確認。 |
| Evaluation and auditability | 公開基準分數無法建立拒絕品質、抗提示注入能力或生產事故率。 | 記錄工具呼叫與政策決策;測量不安全合規率、誤拒率、注入成功率、機密洩漏、破壞性嘗試與復原品質。 |
實務安全準則:從能滿足任務需求的最小特權 Opus 5.5 配置開始,僅在相同安全測試通過後才升級至 Fable 5.1。對高影響工作流,無論能力測試哪個更高,都要求人工審批。
- 以實際生產工具集進行對抗性提示注入與資料外洩測試。
- 將讀、寫、發佈、刪除與財務權限拆分,而非授與單一廣泛工具角色。
- 為政策違規、工具重複失敗、範圍意外擴大與成本超支定義回滾觸發條件。
- 當模型、系統提示、effort、工具、權限或路由變更時重新驗證。
如何在 Opus 5.5 與 Fable 5.1 之間選擇
| 工作負載 | 建議起點 | 升級條件 |
|---|---|---|
| 日常程式與程式碼審查 | Opus 5.5,medium effort | 僅對異常困難或高風險案例升級 |
| 多檔案功能工作 | Opus 5.5,medium 或 high | 當反覆的規劃失敗成為成本主因時使用 Fable |
| 全版本庫遷移 | 先測 Opus 5.5 的 high 或 xhigh | 對最困難且無人看管的專案再升級 |
| 通宵自主執行 | Opus 5.5,並設嚴格檢查點 | 當走錯方向的成本極高時優先考慮 Fable |
| 高流量 API 請求 | Opus 5.5 | 僅將易失敗的少數任務升級 |
| 既有且已驗證的 Fable 部署 | 測試期間維持現狀 | 僅在 Opus 達到相同驗收門檻後才切換 |
實務生產測試
以相同的代表性任務、提示、工具、effort 政策、驗收標準與重試上限,同時跑兩個模型。記錄可接受任務率、延遲、新鮮與快取輸入、輸出與思考 token、工具呼叫、重試、人工修正,以及每個被接受結果的總成本。涵蓋例行任務與困難失敗案例。
既有 Claude Opus 5 使用者的遷移指引
既有 Opus 5 使用者應將 Opus 5.5 視為後繼者進行測試,而非假設可直接替換 model ID。比較規劃深度、工具呼叫模式、回應長度、格式遵循、延遲、提示快取行為、對失敗工具呼叫的復原、安全路由與完成任務的成本。設定回滾標準,並在 Opus 5.5 通過類生產驗收測試前保留原模型可用。
既有 Fable 5.1 使用者不需要通用遷移章節。應將 Opus 5.5 作為優化候選,並在相同的生產驗收標準下評估,方可變更已驗證的部署。
透過 CometAPI 存取
評估任一模型的開發者,可參閱與之相關的 CometAPI 指南:Claude Opus 5.5 與 Claude Fable 5.1。透過任何相容 API 供應商整合時,於生產部署前請確認精確的 model ID、支援的 effort 參數、快取行為、頻率限制、區域可用性與當前價格。
在支援這些識別符的地方,Opus 5.5 使用 claude-opus-5-5,Fable 5.1 使用 claude-fable-5-1。避免將兩類工作負載悄然路由至單一固定的 effort 等級;模型選擇與 effort 政策應獨立配置。
Python — 透過 CometAPI 使用 Anthropic Messages API
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("分析此程式碼庫並提出安全的遷移計畫。"),}],)print(message.content[0].text)
結論
Claude Opus 5.5 改變了 Anthropic 日常前沿模型與高階升級層之間的實務邊界。它在標準 token 費率上便宜許多,在多項已公布的程式與代理基準上領先,並提供足夠的 effort 彈性以涵蓋廣泛的生產場景。
當任務困難、高價值、長時間或無人看管,且失敗成本超過推理費用時,Claude Fable 5.1 仍具相關性。對多數團隊而言,最佳策略是從 Opus 5.5 開始,衡量「完成任務」的結果,再選擇性升級。
常見問題
團隊該如何設計 Opus 5.5 與 Fable 5.1 的生產環境 A/B 測試?
對兩個模型使用相同的代表性任務、提示、工具、effort 政策、驗收標準與重試上限。記錄可接受任務率、延遲、新鮮與快取輸入、輸出與思考 token、工具呼叫、重試、人工修正與每個被接受結果的總成本。任務數量要足以涵蓋例行工作與困難失敗案例。
何時較低的 token 單價無法降低任務總成本?
若模型需要更多回合、重讀更多上下文、產生更多思考 token,或必須反覆重試,較低的單價仍可能導致更高成本。快取行為同樣重要:在以快取讀取為主的長對話中,輸入單價差距會縮小。請比較「完成任務成本」,而非僅看標價。
當基準結果不一致,應記錄哪些資訊?
記錄模型版本、effort 等級、評測框架、回退與安全設定、試驗次數、任務版本、標準誤與成本上限。將每個結果標記為官方或獨立來源,並避免將不同配置下的分數混排於一個排名中。
既有 Fable 5.1 使用者應關注哪些遷移風險?
留意規劃深度、工具呼叫模式、回應長度、格式遵循、延遲、提示快取行為、失敗工具呼叫的復原能力與安全路由的變化。在評估期間保留既有部署可用,建立回滾標準,僅在 Opus 5.5 於類生產任務上達到相同驗收門檻後才遷移。
SEO 中繼資料
Meta title: Claude Opus 5.5 vs Fable 5.1:程式碼、成本與基準測試
Meta description: 比較 Claude Opus 5.5 與 Claude Fable 5.1 在程式基準、API 定價、速度、快取、effort 設定、完成任務成本與工作負載適配等面向的差異。
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude 程式碼基準測試, Claude API 定價, CometAPI, AI 程式碼模型
URL slug: claude-opus-5-5-vs-claude-fable-5-1