
TL;DR
DeepSeek V4.1 Flash 以 552B 參數的因果式編碼器—解碼器 MoE 架構、原生影像理解、100 萬 token 的上下文視窗與大幅降低的服務成本,取代先前的 V4 Flash 代。依 DeepSeek 官方對比結果,其在多數程式碼、終端、資安與代理相關基準上優於 V4 Pro 0813,而 V4 Pro 在 GPQA Diamond 與不使用工具的 HLE 上仍領先。
DeepSeek 目前的官方 API 訂價頁面再次分別列出 deepseek-flash 與 deepseek-v4-pro 路由,分別對應 V4.1 Flash 與 V4-Pro-0813。兩者在價格、併發限制與視覺支援上不同。因此,新整合應選擇符合預期工作負載的模型 ID,而非依賴歷史別名行為。
重點摘要
- V4.1 Flash 與 V4 Pro 目前是不同的官方 API 選項:使用 deepseek-flash 代表 V4.1 Flash,使用 deepseek-v4-pro 代表 V4-Pro-0813。
- 最大的可比提升出現在終端任務、程式碼代理、自動化與偏執行的資安工作負載上,而非所有閉卷推理基準。
- 在快取命中輸入、快取未命中輸入與輸出 tokens 上,V4.1 Flash 的成本均明顯低於目前列示之 V4 Pro 路由。
- V4.1 Flash 新增原生視覺能力,文件化併發量從 500 提升到 2,500,且將全域 KV 快取儲存降至每 token 890 位元組。
- 儘管別名仍可用,遷移應採明確方式:更新模型 ID、驗證思考與非思考行為、重新測試工具呼叫與影像輸入,並監控 token 使用與延遲。
當前路由說明:官方訂價頁面指出 deepseek-v4-pro 對應 V4-Pro-0813,與 V4.1 Flash 為獨立路由。
DeepSeek V4.1 Flash 與 V4 Pro 規格如何比較?
架構自 V4 Pro 的超大型稀疏 MoE,轉變為 V4.1 Flash 的非對稱因果式編碼器—解碼器設計。新模型在處理輸入時啟用的參數少於產生輸出時,有助降低預填成本,同時保留更強的生成能力。
| 規格 | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| 架構 | 因果式編碼器—解碼器 MoE | 稀疏 MoE |
| 總參數數量 骨幹參數 / 儲存庫權重計數 | 552B 骨幹參數;Hugging Face 列示 763B 模型大小 | 1.6T 骨幹參數;Hugging Face 約列示 1.7T 模型大小 |
| 活躍參數 | 輸入 8B;輸出 16B | 每個 token 49B |
| 上下文視窗 | 1M tokens | 1M tokens |
| 最大輸出 | 384K tokens | 384K tokens |
| 思考與非思考模式 | 支援 | 支援 |
| 原生影像理解 | 支援 | 不支援 |
| 文件化併發量 | 2,500 | 目前配置為 500 |
| 當前官方 API 狀態 | 以 deepseek-flash 提供 | 以 deepseek-v4-pro(V4-Pro-0813)提供 |
參數數量說明:DeepSeek 的 V4.1 Flash 模型卡以 552B 為「骨幹」參數,而 Hugging Face 儲存庫則報告 763B 模型大小。這兩個數字描述的統計範圍不同,不應互相替代當作相同的總量。
輸出長度說明:V4.1 Flash 模型卡建議本地推論設定 max_tokens ≥ 256K,但 DeepSeek 目前的 API 訂價頁面明確標示兩個 API 模型的最大輸出皆為 384K。建議的推論設定不等同於 API 強制的上限。
DeepSeek V4.1 Flash 在哪些方面優於 V4 Pro?
DeepSeek 的官方基準表顯示,在執行密集的工作負載上提升最為明顯。下列百分比由公布分數計算;若量測方式為評分或百分比不具意義,則省略百分比對比。
| 基準測試 | V4.1 Flash | V4 Pro 0813 | 差異 | 解讀 |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 分;+3.1% | 終端執行更可靠 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 分;+154.2% | 較難的終端任務上有大幅提升 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 分;+151.6% | 較新的終端任務上有大幅提升 |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 分;+18.3% | 儲存庫層級軟體工作更強 |
| ProgramBench | 20.3 | 15.5 | +4.8 分;+31.0% | 程式合成能力提升 |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 分;+4.1% | 自然語言到儲存庫任務更佳 |
| CyberGym | 88.1 | 83.3 | +4.8 分;+5.8% | 資安任務執行更強 |
| HLE with tools | 63.9 | 60.0 | +3.9 分;+6.5% | 工具增強推理表現更好 |
| Automation-Bench | 54.8 | 43.2 | +11.6 分;+26.9% | 自動化能力顯著提升 |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 分;+23.7% | 一般代理行為更強 |
| Codeforces rating | 3,471 | 3,348 | +123 積分 | 競程表現提升 |
| GPQA Diamond | 90.9 | 92.4 | −1.5 分 | V4 Pro 仍具優勢 |
| HLE without tools | 36.8;文字子集為 39.1 | 文字子集為 42.7 | 可比文字子集 −3.6 分 | V4 Pro 仍具優勢 |

結果具有多面向:在程式碼代理、終端操作、自動化、資安任務、工具使用、視覺、併發與成本上,V4.1 Flash 具有決定性優勢。V4 Pro 的剩餘優勢集中在部分純推理測試。工作負載應依任務組成評估,而非依賴單一總體結論。
為何 DeepSeek V4.1 Flash 比 V4 Pro 更高效?
輸入與輸出計算不對稱
V4.1 Flash 在處理輸入時啟用 8B 參數,在產生輸出時啟用 16B。此非對稱設計針對預填與解碼的不同計算需求降低成本,無需讓兩個階段共用相同的活躍參數預算。
更小的 KV 快取佔用
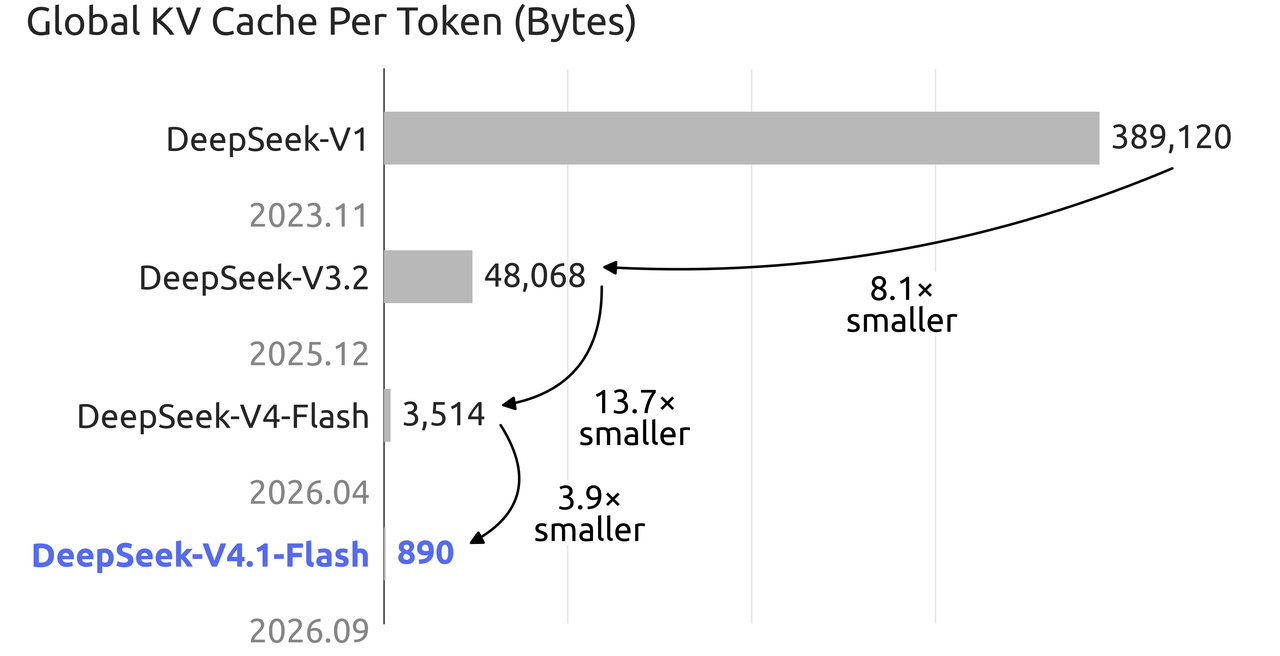
DeepSeek 報告指出,V4.1 Flash 的 KV 快取只需前一代的四分之一 HBM 與八分之一 SSD 容量。已發布的圖表顯示,全域 KV 快取為每 token 890 位元組,相較於 V4 Flash 的 3,514 位元組。
原生多模態輸入與更高併發
V4.1 Flash 可原生理解影像,並提供文件列示的 2,500 併發上限,為目前 V4 Pro 之 500 的五倍。這對於基於截圖的代理、文件擷取、視覺疑難排解與高量產線佇列尤為重要。
DeepSeek V4.1 Flash 與 V4 Pro 的成本如何比較?
目前官方 API 資費表將兩個路由分別定價。每 100 萬 tokens,V4.1 Flash 在快取命中輸入為 $0.003/$0.006、快取未命中輸入為 $0.15/$0.30、輸出為 $0.60/$1.20(離峰/尖峰)。V4 Pro 分別為 $0.022/$0.044、$0.66/$1.32 與 $1.98/$3.96。價格可能變動,生產環境預算應參考即時官方價格頁。
應如何從 DeepSeek V4 Pro 或 V4 Flash 遷移至 V4.1 Flash?
明確使用生產模型 ID
當你需要 V4.1 Flash,請使用 deepseek-flash。較舊的 deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 名稱仍會路由到 V4.1 Flash,且按新 Flash 價格計費,但明確命名更利於監控與未來回滾審計。當你明確需要目前列示的 V4-Pro-0813 後端時,請使用 deepseek-v4-pro。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # 或 "deepseek-v4-pro"
    messages=[{"role": "user", "content": "檢視此遷移計劃。"}],
)

print(response.choices[0].message.content)
重測行為,不僅是端點相容性
- 在思考與非思考模式下執行具代表性的提示;比較任務成功率、token 數與延遲。
- 重新測試工具綱要、JSON 輸出、Responses API 行為、前綴補全與 FIM(若有使用)。
- 若產品將使用新的原生視覺能力,新增影像輸入測試。
- 以尖峰與離峰費率重新校準預算,而非沿用 V4 Pro 的假設。
- 追蹤提示快取命中率,因為在規模化場景中它可能主導輸入成本。
明確選擇預期後端
目前 deepseek-v4-pro 路由會選擇 V4-Pro-0813。團隊應記錄解析到的模型版本、評估日期、提示集與價格視窗,以便在路由再次變更時仍可重現比較。
哪些工作負載最適合 DeepSeek V4.1 Flash?
| 工作負載 | 建議選擇 | 原因 |
|---|---|---|
| 程式碼代理與儲存庫維護 | V4.1 Flash | 在 DeepSWE、ProgramBench、NL2Repo 與終端分數更高 |
| 工具驅動的自動化 | V4.1 Flash | 在 Automation-Bench、HLE-with-tools 與代理分數更高 |
| 具備影像感知的助理 | V4.1 Flash | 原生影像理解 |
| 高吞吐或對成本敏感的服務 | V4.1 Flash | 更高併發與更低的 token 價格 |
| 歷史 V4 Pro 重現當前 V4 Pro 存取與評估 | V4 Pro | 官方路由目前指向 V4-Pro-0813 |
| 純閉卷推理 | 以領域資料驗證 | V4 Pro 在 GPQA Diamond 與不使用工具的 HLE 仍較高 |
DeepSeek V4.1 Flash vs V4 Pro 常見問答
DeepSeek V4.1 Flash 是否優於 V4 Pro?
在多數生產維度——程式碼代理、終端任務、自動化、工具使用、視覺、吞吐與價格——是的。V4 Pro 在 GPQA Diamond 與不使用工具的 HLE 上仍有較高公佈分數,因此純推理工作負載應以領域特定提示進行測試。
我仍可以呼叫 deepseek-v4-pro 嗎?
可以。當前官方 API 頁面將 deepseek-v4-pro 列為 V4-Pro-0813,具有獨立的價格與併發限制。
新的整合應該使用哪個模型 ID?
使用 deepseek-flash 代表 V4.1 Flash,或使用 deepseek-v4-pro 代表 V4-Pro-0813。不要將兩個 ID 視為別名。
舊的 V4 Flash 模型 ID 還能使用嗎?
DeepSeek 表示,deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 的請求會自動路由到 V4.1 Flash,並依新 Flash 價格計費。但仍建議更新已設定的模型 ID 以便於管理。
DeepSeek V4.1 Flash 是否支援影像?
是的。V4.1 Flash 具備原生影像理解;歷史的 V4 Pro API 不提供此能力。
DeepSeek V4.1 Flash 是否比目前的 V4 Pro 更便宜?
是的。當前官方資費表在快取命中輸入、快取未命中輸入與輸出上,V4.1 Flash 均低於 V4 Pro。
遷移後我是否能期待相同的輸出?
不會。端點相容性不保證相同的推理路徑、工具選擇、token 使用或格式。請在依賴既有門檻之前重新執行生產評估。