SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. ai-comparisons/CometAPI 研究
Eleven v4 與 Eleven v4 Turbo:應該選擇哪一款?
以下比較基於常見的型號定位與官方釋出的能力特徵,著重實務選型要點:
- 聲音品質
- Eleven v4:追求最高保真與自然度,韻律、停連、情緒細節更細膩,適合長篇與精緻製作。
- Eleven v4 Turbo:接近 v4 的整體自然度,但在極端語速、強情緒或複雜場景下細節略遜;以穩定、可用的高品質為前提優化延遲。
- 延遲
- Eleven v4:首幀與整體延遲較高,適合非即時的內容管線。
- Eleven v4 Turbo:顯著降低首幀延遲與整體生成時間,支援更即時的互動。
- API 價格
- Eleven v4:單位字數/時長成本較高(品質優先)。
- Eleven v4 Turbo:較低成本(延遲與吞吐優先),更適合高併發與互動場景。
- 具體單價與方案以官方最新計費為準;一般而言 Turbo 走量更划算。
- 串流能力
- Eleven v4:支援標準串流輸出,但更偏向批量/長段生成;串流首幀不如 Turbo 快。
- Eleven v4 Turbo:面向即時串流優化,支援低延遲分塊輸出,利於邊播邊生成與打斷/續播等互動需求。
- CometAPI 存取
- Eleven v4 Turbo:優先支援/最佳化於 CometAPI 類型的即時語音管線(超低延遲、雙向互動)。
- Eleven v4:可透過常規 API 使用,對 CometAPI 的使用與效能不如 Turbo 理想;通常不作為即時通話/助理的首選。
選型建議
- 內容製作(長篇有聲書、播客、旁白、廣告成片、敘事影片)
- 優先:Eleven v4(最高音質與情感細節)
- 次選:Eleven v4 Turbo(若需要縮短出片時間或控制成本,且品質要求略低於極致)
- 即時代理(語音助理、客服機器人、遊戲內 NPC 對話、互動教學/導覽)
- 優先:Eleven v4 Turbo(低延遲串流與更佳的即時體驗,對 CometAPI 更友好)
- 次選:Eleven v4(僅在對音質有極高要求、可容忍更高延遲的情境)
- 混合場景
- 生成正式內容用 v4,互動預覽/實時對話用 v4 Turbo;在同一專案中按管線角色分工可兼顧品質與效率。

Deon GoodwinAI 模型與 API 研究團隊 from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-5-mini",
messages=[{"role": "user", "content": "Build this workflow."}],
)
print(response.choices[0].message.content)
重點摘要
在以製作品質為優先的有聲書、旁白與角色表演場景選擇 Eleven v4。在回應時間至關重要的語音代理與互動式應用選擇 Eleven v4 Turbo。ElevenLabs 表示兩者具有相同的表現力範圍;Turbo 公布的 API 字元費率低 50%。最終請使用你自己的腳本、盲聽測試與端到端延遲量測做出選擇。
重要要點
- 對於製作音訊:先從標準變體開始,評估表現、穩定性與剪輯工作量。
- 對於即時互動:先從 Turbo 開始,量測從使用者輸入到可聽見回應的完整時間。
- 對於成本:Turbo 公布的每字元費率低 50%,尚未計入重試或其他服務費用。
- 對於基準:已發布的偏好結果比較的是標準模型與競品,未建立其相對於 Turbo 的直接品質差距。
- 對於整合:原生串流與第三方非同步產生有不同的作業要求。
Eleven v4 與 v4 Turbo 一覽
| 主要工作負載 | 製作型旁白、有聲書與角色表演 | 即時代理與互動式語音 |
| Model ID | eleven_v4 | eleven_v4_turbo |
| 語言 | 90+ | 90+ |
| 原生價格 | $0.08 / 1,000 characters | $0.04 / 1,000 characters |
| 推論延遲中位數 | 未找到可直接比較的數值 | ~100 ms |
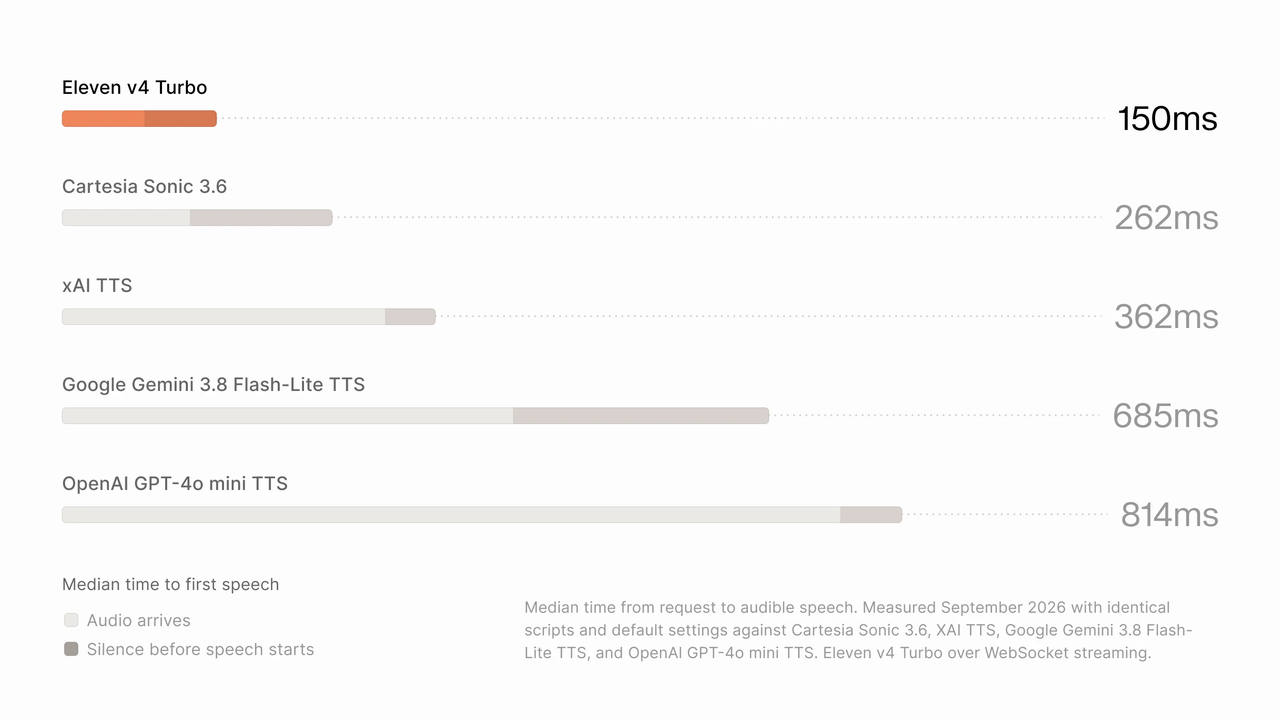
| 首句可聽語音時間中位數 | 未找到可比較的數值 | ~150 ms:透過 WebSocket 的請求到可聽語音時間中位數;不含測得的網路延遲 |
| 每個 Text to Dialogue WebSocket 連線的已註冊語音數 | 最多 10 | 僅 1 |
150 ms 數值出自 ElevenLabs 於 2026 年 9 月使用相同腳本與預設設定的比較。它量測的是可聽語音的起始,而非整段語音代理對話的完整延遲。語音註冊限制適用於 Text to Dialogue WebSocket 端點。
Eleven v4 與 v4 Tu
Eleven v4 vs v4 Turbo:總覽與規格
Eleven v4:製作音訊與多說話者表演
標準模型的已發布定位指向最高品質的語音製作,包括自然的多說話者對話與長篇旁白。這使其在發佈前可審聽與剪輯的錄音情境中成為合理的首選。關鍵問題在於:它的表現能否在完整段落與重生的台詞中持續保持可信度。
Eleven v4 Turbo:即時表現力語音
Eleven v4 Turbo 針對即時代理、助理與互動角色而設計。ElevenLabs 表示它保留了 Eleven v4 的完整表現力範圍並支援 Professional Voice Clones,同時優先考量低延遲生成。
請在音訊串流並播放時進行評估,因為單獨聽起來令人信服的片段,無法證明整段對話的回應足夠即時。其低推論延遲是起始規格,而非對整個應用的保證。
簡短的教學語音在兩者上可能同樣可接受,但戲劇性場景可能會暴露足以證成更昂貴生成的差異。
架構與評估範圍
官方架構公告表示 Eleven v4 建立在全新架構之上,Turbo 則將相同技術帶入低延遲用例。未披露足夠細節比較參數量、層級結構、訓練算力,或導致速度差異的具體改動。將這些細節視為未披露,而非推斷 Turbo 更小或經蒸餾。
原生限制與語音控制
在分割長腳本之前,請先確認你計劃使用的模型與端點的輸入限制。某介面發布的限制不會自動適用於另一介面;未標示限制亦不代表無限制輸入。
兩種變體都提供 Stability 與 Similarity 控制。當你在 Eleven v4 中選擇 Professional Voice Clone,會多出一個 Clone Strength slider 用來調整輸出與該克隆訓練錄音的貼合度。較低數值允許更靈活的表現並略微平滑聲音;較高數值則更保留原始表演與獨特嗓音特徵(含口音)。ElevenLabs 建議大多數聲音從 0% 開始。原生 v4 體驗中不提供 Style 與 Speed 滑桿,且不支援 SSML。
對遷移的實務意涵是:保留既有語音指令的意義,但檢視其表達方式。過去嚴重依賴 SSML 的腳本應調整並試聽,而非不加改動地直接沿用。
Eleven v4 vs v4 Turbo:效能
已發布基準與來源邊界
兩項官方結果在此重要:聆聽偏好與回應延遲。它們回答的是不同問題。
|
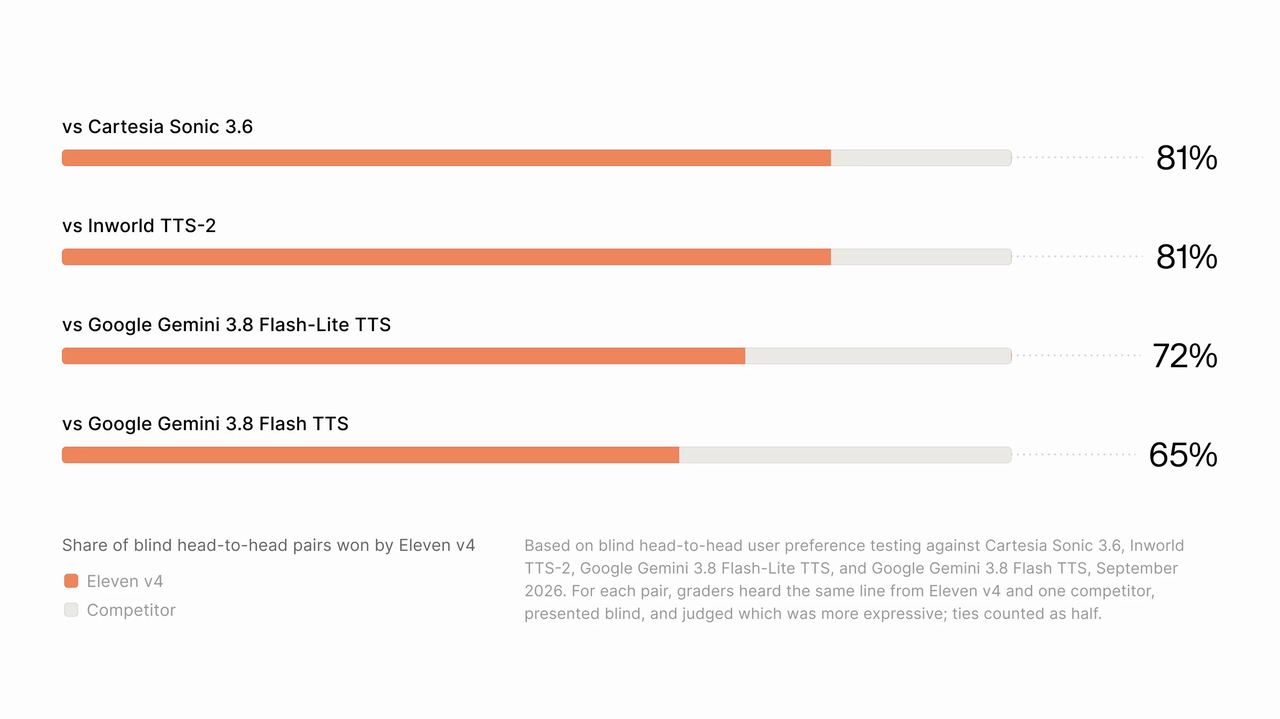
| 標準模型的盲聽偏好測試 | 約 75% 的整體偏好;圖表結果涵蓋 65%–81% |
已發布的聆聽測試比較的是 Eleven v4 與競爭語音模型,未建立聽眾對它優於 Eleven v4 Turbo 的偏好幅度(若有)。為了做出該選擇,請使用相同腳本與語音,對兩種變體進行你自己的盲聽測試。
官方 ElevenLabs 延遲圖表。其回報的計時不含測得的網路延遲。
評估條件
官方 2026 年 9 月的聆聽研究,使用 Eleven v4 與競品模型在相同台詞上的盲式配對比較,判斷表現力與自然度;平手計半分。被比較的系統與各系統偏好率見下方官方圖表。這些供應商回報的結果比較的是 Eleven v4 與競品,並未量化 Eleven v4 與 Eleven v4 Turbo 之間的聆聽品質差異。
2026 年 9 月的延遲比較使用相同腳本與預設設定,對每個系統都移除了測得的網路延遲,並在 WebSocket 串流上執行 Turbo。回報的 150 ms 量測的是從請求到可聽語音的時間;它不同於約 100 ms 的推論數字。所述方法論並未提供完整的硬體、區域、負載與樣本數細節,因此不足以構成生產延遲保證。
語音品質與製作一致性
ElevenLabs 強調 Professional Voice Clone 支援、跨重生台詞的說話者一致性提升,以及長篇音訊的請求拼接。請用完整段落與插入既有錄音的替換台詞來評估這些主張。
對於錄製音訊,將表現力與製作一致性分開評估。注意重音、情緒、發音,以及同一說話者在不同段落中是否保持可辨識性。標準模型是供應商的品質優先選項,但簡單的教學腳本未必能顯現有用差異。請比較「被採用的 take」,而非假設價格較高的生成總是需要更少剪輯。
語音指導與多語交付
兩種變體都支援富表現力的輸出,但有用的表現取決於你的腳本與所選語音。先從少量且明確的指示開始,再聽它們是否強化了預期含義。
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
這是示意用提示,非量測之表現結果。請將其與不帶標註的版本一同測試。只有在能改善輸出時,額外指示才有價值。
在在地化方面,也值得另行聆聽。依據原生產品指南,同語言生成會保留參考語音的原始口音,而跨語言生成則改用目標語言的自然發音,而不延續來源語言的口音。
此行為可能適合本地化的產品教學,但對於刻意保有明顯外國口音的虛構角色,可能需要額外指導。請分別評估發音、身份與預期口音;語音可能聽起來流利,但未能符合創意簡報。
延遲與可靠性
對於生產環境的語音代理,語音合成僅是延遲的一部分。語音辨識、回合偵測、語言模型輸出、網路傳輸與音訊緩衝都會影響使用者聽到回應的時間。
在你的應用中同時量測中位數與較慢尾端的回應時間。低中位數可能與偶發的停頓共存,後者會讓對話令人沮喪。
Eleven v4 vs v4 Turbo:成本
官方 API 字元價格
以下原生 API 比較使用 2026 年 10 月 19 日查核的公布費率。總量金額為依該等費率計算,而非額外的套裝報價。
這些數字描述的是以字元計費的語音生成,不代表整體語音代理的帳單。訂閱額度、其他服務與適用商業條款應另行考量。
CometAPI 以代幣為單位顯示定價,而上述原生費率是按字元計費。僅在確認所選端點的計量與計費方式後再比較成本。若你需要 Turbo,請先確認該模型在你選用的 CometAPI 路由上可用,再規劃整合。
每個被採用錄音或互動的成本
語音生成成本 = 計費字元 ÷ 1,000 × 適用字元費率
對於內容製作,更有用的營運指標是每個被採用錄音的成本。包含重生 take 與剪輯時間。若價格較低的變體在困難表演上屢次失手,其單價優勢可能縮水。
對於即時代理,請比較在你要求的品質與回應時間下,完成的互動成本。若使用者因為緩慢或困惑的對話而流失,合成帳單再低也意義有限。
Eleven v4 vs v4 Turbo:比較與選擇
依能力與工作負載的選擇
以下建議結合了已發布定位與實務評估準則。它們是測試的起點,而非額外的基準結果。
對於有聲書、廣告與戲劇場景,請用中性段落、情感段落與插入既有錄音的重生台詞來測試 Eleven v4。聆聽跨接點的語音身份、節奏與發音是否一致。當被採用表現或剪輯節省足以抵銷較高的生成成本時,選擇標準變體。
對於客服代理與互動角色,請在完整對話流程中測試 Turbo:使用者語音、回合偵測、回應生成、合成與播放。納入慢速連線、連線失敗與打斷情境。確認播放在使用者打斷時能即時停止,且下一段回應能乾淨開始。當 Turbo 同時滿足你的聆聽品質門檻與回應時間目標時,選擇 Turbo。
- 構建具代表性的測試集:包含中性解說、令人安心的回應、情感段落、名稱或縮寫,以及你的受眾會使用的多語文本。
- 在各介面允許的範圍內,盡可能保持腳本、語音與輸出設定可比。
- 以不帶模型標籤的方式審聽錄音。記錄發音錯誤、語音身份不一致與每個 take 所需的修正。
- 將即時回應時間與聆聽品質分別量測,包含中位延遲與較慢尾端延遲。
- 在做出路由選擇前設定驗收門檻:發音、語音一致性、剪輯工作量、中位回應時間與尾端回應時間。
- 在你要部署的端點上跑具代表性的流量。追蹤被拒輸出、重試、以及播放或連線失敗。
- 比較每個被採用錄音或完成互動的成本,包含重生 take 與剪輯工作量。
- 對於同時有預錄與即時音訊的產品,測試分流並確認各路由都滿足其各自的驗收門檻。
在哪裡可使用 Eleven v4 與 v4 Turbo?
官方供應商存取
依工作負載選用對應的原生路由:製作音訊採用產生語音與對話;Turbo 互動採用 Text to Dialogue WebSocket 串流。以下官方示例記錄了串流連線與其語音註冊限制。連接生產工作負載前,請驗證當前端點結構、驗證需求與帳戶限制。
ElevenLabs 的官方串流示例在 Turbo 上使用 Text to Dialogue WebSocket:
Eleven v4 Turbo WebSocket 端點:
wss://api.elevenlabs.io/v1/text-to-dialogue/stream-input?model_id=eleven_v4_turbo
同一份參考明確指出 Turbo 連線「每個連線僅能註冊一個語音」,而標準變體在該端點上則為最多十個。這些是連線層級規則,並非對所有介面的普遍陳述。
這些是供應商特定的整合細節。原生的 10,000 字元限制與原生 UI 控制,不應取代此介面所記載的行為。同樣地,非同步工作流程也不代表能透過此路由取得 Turbo 原生 WebSocket 的表現。
實務的整合步驟是:先提交短腳本,依文件化的任務狀態流程追蹤,取回結果,並檢查發音與輸出時長,再逐步增加量能。
結論
當被採用的錄音在表現品質或製作節省上,足以抵銷較高的每字元費率時,選擇 Eleven v4。當它通過你的聆聽門檻,並支援即時對話所需的即時性時,選擇 Eleven v4 Turbo。請在你將要部署的端點上做出最終決定,並納入具代表性的腳本、重試以及總體營運成本。
常見問題
長篇 Eleven v4 腳本應如何分段製作?
請在段落、句子或場景邊界分段,而非在單字或說話者回合中途切分。於端點允許的輸入內預留指示文本空間,並保留每段的腳本與語音設定記錄,組裝音訊後試聽接點。比較跨邊界的響度、節奏、發音與語音身份;逐段驗收並不代表組合後的錄音無縫。請以實際供應商端點的限制為準,因為原生與 CometAPI 的請求限制不同。
中斷的 Eleven v4 請求應如何重試?
追蹤原始請求或任務識別碼,並在重送相同文本前判定其狀態。對於非同步供應商工作流程,檢查原任務是否已完成以及結果是否仍可取回。對於即時串流,記錄已播放的音訊,並決定是否重播該語句或在乾淨邊界恢復。確認端點的重試、冪等與計費規則;不要假設重送免費或產生相同音訊。
團隊應如何對 Eleven v4 語音版本做回歸測試?
維護固定的驗收集合,包含品牌名稱、縮寫、數字、困難發音、情感段落,以及產品所用語言。封存腳本、模型識別碼、語音識別碼、可用設定、生成日期與被採用的參考錄音。當模型、語音或整合變更時,將新樣本與參考錄音對聽,並記錄所需修正。將可重現的測試程序與「音檔完全相同」的假設區分開來:一次錄音通過,並不保證後續每次生成都能通過。
| Turbo 推論延遲中位數 | 約 100 ms | 一項模型推論計時主張 |
| Turbo 首句可聽語音時間中位數 | 約 150 ms | 在所述測試設定下的請求到可聽語音計時 |
| 1,000 字元 | $0.08 | $0.04 | $0.04 |
| 100,000 字元 | $8.00 | $4.00 | $4.00 |
| 1,000,000 字元 | $80.00 | $40.00 | $40.00 |
| 10,000,000 字元 | $800.00 | $400.00 | $400.00 |
| 有聲書或紀錄片 | 標準變體 | 跨段落與重生台詞的一致性 |
| 戲劇性角色場景 | 標準變體 | 情感表現與說話者之間的互動 |
| 客服代理 | Turbo | 可聽回應時間、發音與打斷處理 |
| 互動式遊戲角色 | Turbo | 短回合期間的即時性與表現 |
| 簡單教學短片 | 兩者皆測 | 聽眾是否能察覺有意義的品質差異 |
| 多語製作 | 依語言皆測 | 發音、口音與語音身份 |
| 同時含錄製與即時語音的產品 | 依工作負載分流 | 各路由是否滿足其各自的驗收標準 |
| Model ID | eleven_v4 |
| Submission endpoint | POST /runwayml/v1/text_to_speech |
| Processing | 非同步任務提交流程 |
| Output | MP3 音訊 |
| Input limit | 每次請求最多 2,500 字元 |
| Voice configuration | 預設語音 |
| Additional exposed control | 可調整語速 |
Eleven v4 與 Eleven v4 Turbo:應該選擇哪一款? - CometAPI