
TL;DR
GLM 5.4 是社群對 Z.ai 的 GLM 系列可能後繼者的稱呼。截至 2026 年 10 月 14 日,本文查閱的官方模型文件與發佈記錄未能證實 GLM-5.4 的發佈、規格表或 API 識別碼。Union Alpha 是一個謠傳線索,而十月發佈僅是依循節奏的可能性。更有用的問題是未來版本是否能提升編碼可靠性與每個完成任務的成本;現有 GLM 模型提供了評估的基準。
Key Takeaways
- 發佈狀態:截至 2026 年 10 月 14 日查閱的官方來源未確認 GLM-5.4;未確立精確發佈日期。
- 謠傳證據:Union Alpha 與 GLM-5.4 的關聯仍未獲驗證,被引用的彙總亦未標示原始歸因貼文。
- 表現基準:現有的 GLM-5.3 結果可作為參考,但並非 GLM-5.4 的測量。
- 架構:GLM-5.3-Flash 展示了不同的效率與多模態方向;GLM-5.4 是否承襲尚未可知。
- 開發者行動:現在就評估可用模型,並在升級前要求經驗證的模型 ID、相容性與任務層級測量。
Has GLM 5.4 Been Released?
GLM 5.4 是一個未經官方確認的 GLM 潛在後繼者名稱。official documentation index 與 release records 的 2026 年 10 月 14 日查驗指出現有 GLM 模型,但未能證實 GLM-5.4 的產品發佈。這是一次具日期標註的來源檢查,並非證明不存在私下開發。
兩條已記載的開發路徑解釋了潛在後繼者為何受到關注。
Z.ai 確認 GLM-5.3 沿用 GLM-5.2 的基座模型,並透過後訓練取得提升。GLM-5.3-Flash 則改採新的多模態基座與混合稀疏-線性注意力架構。這些事實描述的是既有模型,而非已披露的 GLM-5.4 設計。
實務上,一條路徑是在既有模型上加訓練提升,而另一條路徑是重設架構以降低計算成本並支援新能力。
未來的 GLM-5.4 可能延續其中任一方向,但目前證據不足以判斷 Z.ai 將採取哪種做法。
How Reliable Are the GLM-5.4 Rumors and Leaks?
Confirmed Information
已確認的技術基準來自 GLM-5.3 與 GLM-5.3-Flash,而非 GLM-5.4。GLM-5.4 的名稱、最終規格、發佈日期與基準測試結果,於本文查閱的官方來源中仍未獲確認。
Community Reports / Leaks
2026 年 10 月 8 日,X 上 @NFT_Chen 的貼文將可能的 GLM-5.4/5.5 開發方向歸因於唐杰的發言。貼文描述了三個擴展優先順序:擴大預訓練、透過 SFT、RLHF 與 RLVR 強化後訓練,以及延伸推理與代理執行以涵蓋更難且更長的任務。
作者將下一步解讀為更長時間的自主代理與遞歸自我改進(RSI)。這是一則社群對演講的轉述,而非 Z.ai 的發佈公告。版本名稱與開發主張仍屬於該貼文的歸因,並未建立 GLM-5.4 的發佈日期、最終架構、參數規模或已展示的自我改進能力。
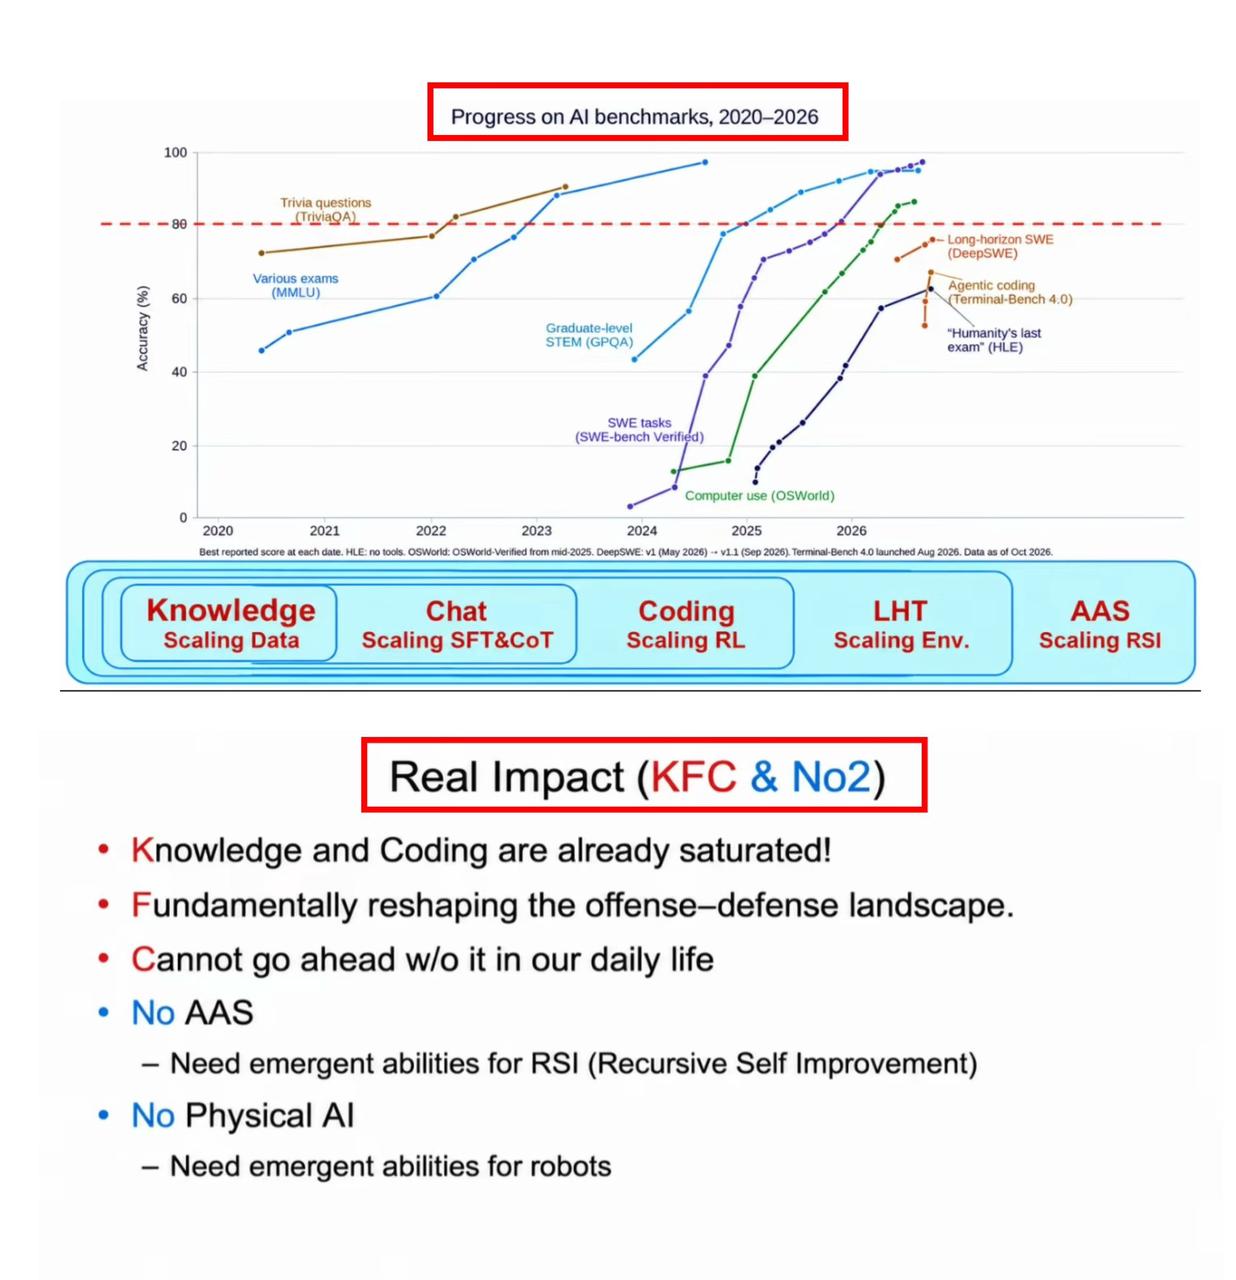
2026 年 10 月 8 日 @NFT_Chen 原始 X 貼文附圖中的簡報頁。內容討論基準進展與 RSI 作為未來方向;它不是 GLM-5.4 的基準報告。
2026 年 10 月 8 日 @NFT_Chen 原始 X 貼文附圖中的演講照片。
Analysis
有用的謠言分析在於找出能改變結論的觀察。官方模型識別碼、發佈公告,或匿名別名的已披露對應,都能實質強化證據。類似的命名模式或發佈間隔本身無法做到這一點。針對其他未來 GLM 版本號的舊有猜測,亦無法建立 GLM-5.4 的規格。
When Could GLM 5.4 Be Released?
Z.ai 的 release-note timeline 記錄了 GLM-5 於 2 月 12 日、GLM-5.1 於 4 月 7 日、GLM-5.2 於 6 月 16 日、GLM-5.3 於 8 月 18 日、GLM-5.3-Flash 於 2026 年 8 月 26 日發佈。這些是發佈說明中的日期;不應與所有研究公告或服務商可用日期混為一談。
主要點版本約兩個月的推進,使十月成為合理的觀察窗口。這並不等同確立十月發佈、特定日期,甚至下一個版本名稱。若缺乏可追溯的預測來源及其方法,精確到 10 月 20 日或 10 月 23 日的預測將暗示超出證據支持的精度。
較晚的發佈、不同名稱或獨立產品變體仍有可能。開發者應以目前可用的 API 為規劃基礎,而非僅依行事曆估計。
What Are GLM 5.4's Expected Specs?
目前沒有可靠的 GLM-5.4 規格表。與其將謠傳的硬體與模型參數套在未發佈的產品上,不如比較最新有文件記載的 GLM 模型,並指出尚不明確之處。
| Specification | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Release | August 18, 2026 | August 26, 2026 | Unannounced |
| Model foundation | GLM-5.2 base; further post-training | New multimodal base | Unknown |
| Architecture | MoE foundation | MoE; hybrid sparse-linear attention | Unknown |
| Context support | 1M documented API context | 1M | Unknown |
| Native multimodality | Text-only input | Text, image, video, and file inputs | Unknown |
| Primary emphasis | Coding, agents, cybersecurity | Efficiency, coding, multimodality | Unknown |
| Published benchmarks | Available | Available | Not available |
| Model weights | Released | Released | Not available |
該表呈現的是既有模型的文件化能力。GLM-5.4 欄位維持「未知」,而非從任一前代繼承值。模型的評估場景、API 上下文窗口與最長輸出長度是不同的限制。
GLM-5.3-Flash 架構概覽 報告了 320B 總參數、18B 啟用參數,以及混合稀疏-線性注意力。這些是 Flash 的公開規格,不應指派給 GLM-5.4。
Agentic Coding as a Potential Upgrade Direction
代理式編碼是最值得關注的方向之一。GLM-5.3 已經展現擴大後訓練可以大幅提升多步驟工程任務的表現。其開發者強調複雜倉庫工作、更長的執行跨度,以及更佳的工具驅動問題解決。
未來的模型或可透過更好的環境互動、更可靠的規劃,以及更少的工具呼叫失敗來擴展這些能力。
最有用的評估不僅是測量正確回答編碼問題的百分比,而是衡量代理是否能端到端完成複雜任務,包括除錯、測試、修訂,以及故障後的恢復。
Efficient Multimodal Architecture as a Possible Direction
GLM-5.3-Flash 為未來發展提供了架構參考點,但本文查閱的官方來源未能建立其在 GLM-5.4 中的採用。
Z.ai 描述了 30T-token 的多模態預訓練語料庫,作為 GLM-5.3-Flash 的效率導向設計的一部分。這描述的是現有模型的訓練資料規模,並非 GLM-5.4 的路線圖承諾。
官方的 Flash 概覽報告,在所述比較下,注意力計算降低 3.01×,KV-cache 需求降低 4.44×。這些是元件層級的效率結果,並非保證的應用層速度提升或 API 折扣。
這些是有意義的工程改進,但尚無證據確認 GLM-5.4 會承襲相同架構。更大的次世代模型可能優先追求極致推理表現,而獨立的 Flash 變體可能持續優化延遲與成本。
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
GLM-5.3 Benchmark Baseline
可用的基準數據支援對 GLM-5.3 表現軌跡的分析,而非 GLM-5.4 的直接測量。以下數值為 Z.ai 報告的既有模型評估。本文未對其進行獨立重現,亦非 GLM-5.4 的測量。每個基準使用各自的任務集與計分方式;分數差異不應被解讀為任務間可對等的增益。
| Benchmark and methodology | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | GLM-5.3 vs GLM-5.2 difference |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Not reported in the cited Flash comparison | +23.7 points |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 points |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 points |
| CyberGym | 77.2 | 84.5 | Not reported in the cited Flash comparison | +7.3 points |
| ExploitBench | 24.4 | 54.4 | Not reported in the cited Flash comparison | +30.0 points |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 points |
| GDPval-AA v2 | 1508 | 1769 | Not reported in the cited Flash comparison | +261 Elo |
| Toolathlon Verified | 59.9 | Not reported in the cited GLM-5.3 comparison | 78.4 | Not available |
綜合表將既有模型結果並置;其中不包含 GLM-5.4 的測量。未報告的數值並非零分。請注意各基準的評估條件,且將 GDPval-AA 的差異視為 Elo,而非百分點。
Methodology:DeepSWE v1.1 使用 mini-swe-agent、temperature 0.95、top_p 1.0、六小時逾時、400K 上下文。AutomationBench 使用 v1.0.6。HLE with Tools 使用 temperature 1.0、top_p 0.95、163,840 token 的生成上限,以及 300K 上下文上限與上下文管理。GDPval-AA v2 採 Elo 尺度,因此其差異不是百分點增益。
對於 CyberGym 與 ExploitBench,Z.ai 報告 Claude Code 2.1.207 啟用最大推理努力、無網頁工具、temperature 1.0、top_p 1.0,以及 128,000 token 的輸出上限。CyberGym 報告在 1,507 個任務上的單次 pass@1,且每個任務無限時上限。ExploitBench 使用最多 300 回合互動,並在三個版本中對 41 個任務的覆蓋率取平均。模型卡附註提供了基準特定的環境細節。
Flash methodology:DeepSWE 使用 mini-swe-agent、400K 上下文、六小時逾時;AutomationBench 使用 v1.0.6。Toolathlon Verified 報告為透過官方評估服務的三次獨立運行之 pass@1 平均。HLE 使用上述取樣與上下文管理設定。詳見 Flash model-card methodology。這些基準結果不構成生產延遲或成本的保證。
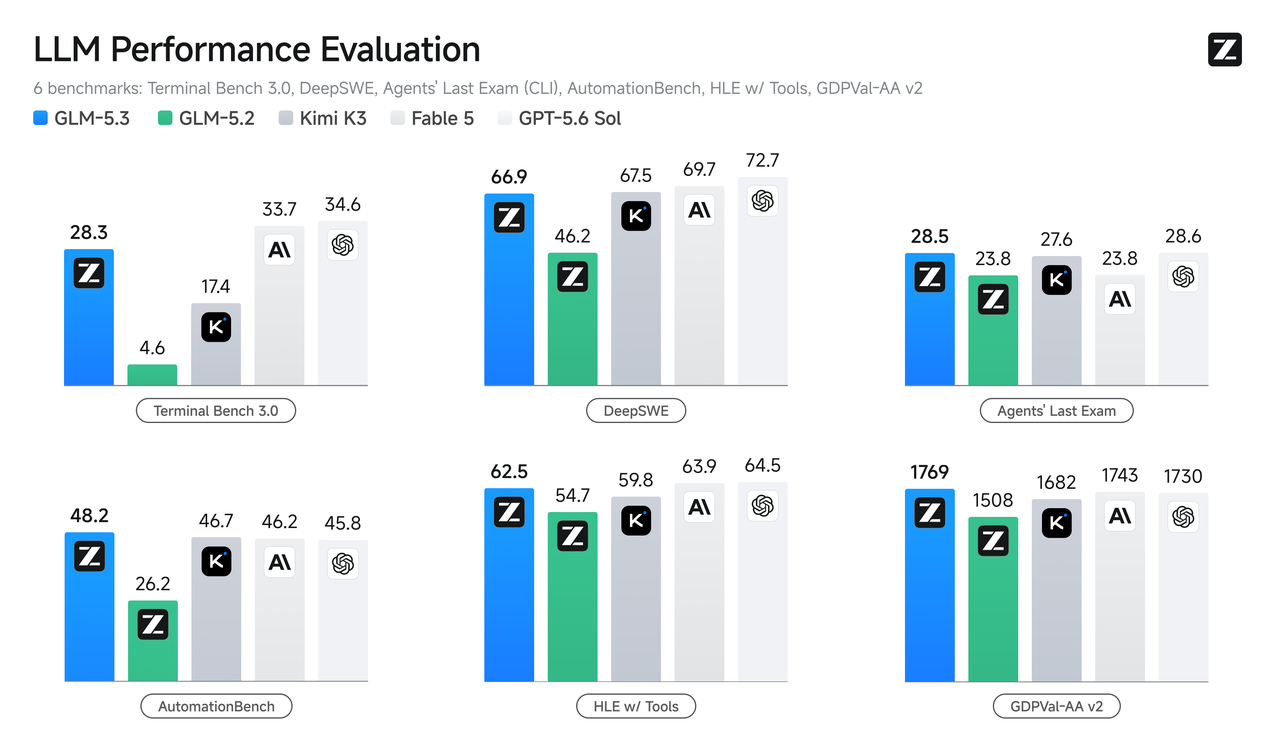
官方 GLM-5.3 表現圖,重製自 Z.ai 的基準公告。該圖展示前代模型的評估;不含 GLM-5.4 結果。
最大的提升出現在需要與環境持續互動的任務。Terminal Bench 3.0 從 4.6 提升至 28.3,ExploitBench 從 24.4 提升至 54.4。
這些增益顯示,在不改變底層基座架構的情況下,透過後訓練與面向代理的環境,能夠大幅改變模型的表現。然而,不應將其外推為 GLM-5.4 的數值預測。
Capabilities and Production Fit
在生產環境中,GLM-5.3 更適合作為複雜編碼、長期工程與網安評估的參考。GLM-5.3-Flash 新增原生視覺輸入,並強調高效工具使用。現有的 GLM-5.2、GLM-5.3 與 Flash 提供了基準;本文查閱的來源未建立等同的 GLM-5.4 能力或可用性。
文件化的模型支援最高 1M 上下文,但該限制不保證所有端點具有相同的可用上下文或任務表現。請以具代表性的工作負載與每個成功完成任務的成本作為選擇依據。
未來的 GLM-5.4 必須提供可量化的改進,才值得遷移。若僅提升基準準確率卻使任務完成成本倍增,對生產部署可能不具吸引力。反之,適度的準確提升加上顯著減少工具呼叫,可能在規模化場景中更有價值。
請在相同評估架構下,比較任務成功率、輸入與輸出 token、延遲、失敗的工具呼叫,以及每個成功任務的成本。定性模型描述並非受控的正面對正面測試。
What Is the Current GLM-5.4 API Status on CometAPI?
CometAPI 已建立 GLM 5.4 的專頁與穩定模型識別碼條目。然而,該頁仍將模型標示為「Coming soon」,並描述為預發佈模型。開發者在嘗試生產使用前,應驗證實際模型 ID、帳戶存取、端點可用性、支援的參數、上下文限制與定價。
若要使用目前有文件記載的整合,請選擇可用的 GLM 模型,例如 GLM-5.2 或 GLM-5.3。在模型 ID 與端點確定可呼叫前,CometAPI 的 GLM-5.4 頁面應被視為預發佈目錄條目。
Preparing for GLM 5.4 API Integration
最務實的準備,是避免將應用邏輯緊耦合到單一模型版本。可配置的模型識別碼,能讓你在不重寫請求管線的情況下評估升級。
保持模型識別碼可配置,並使用可用的 GLM 模型建立可運作的基準。在切換至 GLM-5.4 前,確認可呼叫的模型 ID、帳戶存取、支援的請求參數、上下文與輸出上限、串流行為,以及工具呼叫相容性。保留回滾選項。
當 GLM-5.4 正式可用時,核實模型 ID、支援參數、上下文限制與端點相容性。以相同的評估資料集對新舊模型進行測試,追蹤成功率、延遲、輸出 token、工具呼叫失敗,以及每次成功執行的成本。
What Could GLM 5.4 API Pricing Look Like?
目前沒有官方的 GLM-5.4 API 定價公告。因此,發布具體的輸入或輸出 token 價率並將其當作真實洩漏,將具有誤導性。
當前 GLM 家族顯示,僅以模型尺寸不足以預測定價。GLM-5.3-Flash 引入的架構優化,旨在以顯著較低的推理成本提供競爭力。
Z.ai 的 Artificial Analysis Intelligence Index v4.1.1 comparison 報告 GLM-5.3-Flash 取得分數 57,估算的折扣後每次任務成本為 $0.045。此評估成本不是輸入/輸出 token 費率,亦不預示 GLM-5.4 的定價。
未來 GLM-5.4 的定價可能取決於架構、推理努力、快取 token 折扣、託管基礎設施與變體。對生產規劃而言,每個成功完成任務的成本往往比最低的輸入 token 標價更有價值。
Should Developers Wait for GLM 5.4?
對多數開發者而言,等待未宣佈的模型並非必要。現有 GLM 模型提供了可在實際應用中測試的編碼與代理能力。
打造編碼助理或多步驟工程代理的團隊,可以以 GLM-5.3 建立基準。強調視覺理解、長上下文與高效重複呼叫的應用,則可評估 GLM-5.3-Flash。
現在建立評估架構,並預留未來 GLM-5.4 的比較槽位。當其可用時,若能改進與你的應用相關的關鍵成果,才具有實質意義。
研究人員應關注新的基座架構、長期任務基準的變化,以及端到端可靠性。企業應在具代表性的生產資料上,優先考量可用性、成本、延遲、相容性與品質。
Conclusion
GLM 5.4 是 Z.ai 快速演進的模型家族中合乎情理的下一步,但其當前敘事仍多為臆測而非確認。
Union Alpha 是未經驗證的身份線索,發佈節奏僅支撐寬鬆的時程假設。兩者皆未建立發佈日期。本文於 2026 年 10 月 14 日查閱的官方來源,為既有模型提供了基準,而非確認的 GLM-5.4 發佈。
已可驗證的是 GLM-5.3 與 GLM-5.3-Flash 的進展。代理式編碼、網安評估與推理效率的顯著提升,為任何後繼者立下了嚴苛的基準。
關鍵問題是 Z.ai 能否交付可靠的自主執行、更強的推理,以及具競爭力的每次完成任務成本。在官方規格與基準出現前,GLM-5.4 應被視為潛在發佈,而非可用產品。
FAQ
How can I verify a GLM 5.4 API listing?
確認供應商提供可呼叫的模型識別碼、支援端點、存取條件與當前定價。然後將其身份與 Z.ai 的官方公告或文件比對。供應商清單能建立該供應商的產品提供,但本身不足以驗證匿名模型的開發者身份。
Which compatibility checks matter before a GLM 5.4 migration?
在實際端點上驗證請求參數、推理設定、工具呼叫結構、結構化輸出、串流行為、上下文限制與最長輸出。包含對不支援參數的負向測試,並保留現有模型以供回滾。OpenAI 相容性描述的是介面;它不保證相同的模型行為。
How should I evaluate GLM 5.4 for coding agents?
使用一組固定且具代表性的倉庫任務,對兩個模型採用相同的工具、權限、逾時與評估架構。統計成功的可測試變更、工具故障的恢復、token 使用量、延遲與總成本。記錄每次運行,並重複任務到足以揭示變異,而非僅呈現單一有利範例。
What would justify waiting for GLM 5.4?
只有當有文件記載的即將推出能力,能滿足現有模型無法滿足的需求,且延遲符合交付時程時,等待才合理。在僅有謠傳的情況下,請基於可用模型構建,並保持模型選擇可配置。定義未來版本必須達到的能力與成本門檻,方可取代你的基準。