
TL;DR
Claude Fable 5.1 在困難的自主編碼與長期任務上具備更強的基準證據。GPT-5.6 Sol 在一般情況下的 token 成本更低、具備廣泛的原生工具堆疊,且在獨立的最大努力比較中擁有更短的首 token 延遲。正確的預設取捨取決於失敗任務的成本,而不僅僅是最高的基準分數。
在 2026 年 9 月 8 日的 Intelligence Index 快照中,Fable 5.1 得分 53,GPT-5.6 Sol 為 47。輸出吞吐實際持平:69.9 對 69.8 tok/s。這些結果支持以品質對成本的決策;但並未建立一個普遍的速度勝者。
Key Takeaways
- 當你自己的評估能證成較高價格時,對於最困難的自主任務選擇 Fable 5.1。
- 對於成本敏感的前沿推理與受益於其整合工具的應用,先從 GPT-5.6 Sol 開始。
- 將啟動延遲與輸出速度分開比較:GPT-5.6 Sol 的首 token 時間較低,而吞吐幾乎相同。
- 將模型快取寫入、讀取、保留與長上下文費率分別建模。標稱的輸入/輸出價格無法描述每一種智能體工作負載。
數據檢查時間:2026 年 9 月 8 日。獨立結果使用 GPT-5.6 Sol 的最大努力,與 Fable 5.1 的 Adaptive Reasoning、Max Effort、Default Fallback。供應商基準與獨立基準使用不同的評估設置。除非另有說明,價格為每百萬 token(MTok)之美元。
GPT-5.6 Sol vs Fable 5.1: quick verdict
| Dimension | GPT-5.6 Sol | Claude Fable 5.1 | Better choice |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Context window | 1.05M | 1M | Effectively tied |
| Maximum output | 128K | 128K | Tie |
| Text/image input | Yes | Yes | Tie |
| Official input price / MTok | $4 | $10 | Sol |
| Official output price / MTok | $20 | $50 | Sol |
| Official cache read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Independent output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Effectively tied |
| API tool breadth | Very broad | Strong | Sol |
| Long-running autonomous work | Excellent | Core strength | Fable 5.1 |
| Cost-sensitive production | Better default | Premium escalation | Sol |
一個有用的起始策略是將 Sol 用於常規前沿工作,並在任務未達品質或自主門檻時,將 Fable 5.1 作為升級路線。請用每次成功任務的成本來驗證該策略。
GPT-5.6 Sol 提供六個推理努力等級,從 none 到 max,預設為 medium。Fable 5.1 採用常時啟用的自適應思考;effort 控制推理深度,預設為高。
GPT-5.6 Sol 在上下文多出 50,000 個 token 通常不會決定大多數架構。隨著請求接近一百萬 token,計費與快取重用變得更具影響力;下方長上下文章節說明原因。
What is GPT-5.6 Sol?
GPT-5.6 Sol 是 OpenAI GPT-5.6 家族中面向高需求的程式開發、研究、規劃與智能體工作流程的高能力等級。在本次比較中的主要吸引力是其推理控制與周邊執行環境的結合。
透過 Responses API,GPT-5.6 Sol 支援廣泛的原生工具組:web search、file search、code interpreter、hosted shell、apply patch、computer use、MCP、skills 與 tool search。這可減少應用需要整合的獨立執行期元件數量。
OpenAI 也介紹了programmatic tool calling 與家族的多智能體執行。當模型必須在工具間協調工作、而非只回傳單一答案時,這些平台特性十分關鍵。
What is Claude Fable 5.1?
Claude Fable 5.1 面向高要求的程式開發、專業知識工作、研究與長時間運作的智能體。其直接基準結果使其成為在恢復、持續性與成功完成較重於短回覆的任務中強而有力的候選。
Anthropic 強調跨應用的持續自主執行,包括規劃、從失敗步驟中恢復,以及溝通進度。將這種定位視為測試更長任務的理由,而非保證每個流程都會正確完成。
Fable 5.1 在 API 行為上也與 GPT-5.6 Sol 不同:其強制工具選擇限制對需要模型呼叫特定工具的工作流程很重要。當遷移至確定性的智能體循環時,請檢查支援的 tool_choice 模式。
因此,整合問題是務實的:你的應用能否容忍更自主的推理循環,或是需要對每一步有更細緻的控制?在選擇路線前,先測試確切的工具行為。
Benchmark comparison: Fable 5.1 has the stronger direct evidence
不同供應商間的基準比較很容易被誤用。OpenAI 最初的 GPT-5.6 發布評估早於 Fable 5.1,而 Anthropic 的 Fable 5.1 發布則包含較新的 GPT-5.6 Sol 直接比較。
因此,解讀證據最乾淨的方式是三層:Anthropic 的直接比較、當前獨立測試,以及 OpenAI 自身對 GPT-5.6 Sol 的能力描述。
Anthropic’s direct Fable 5.1 vs GPT-5.6 Sol results
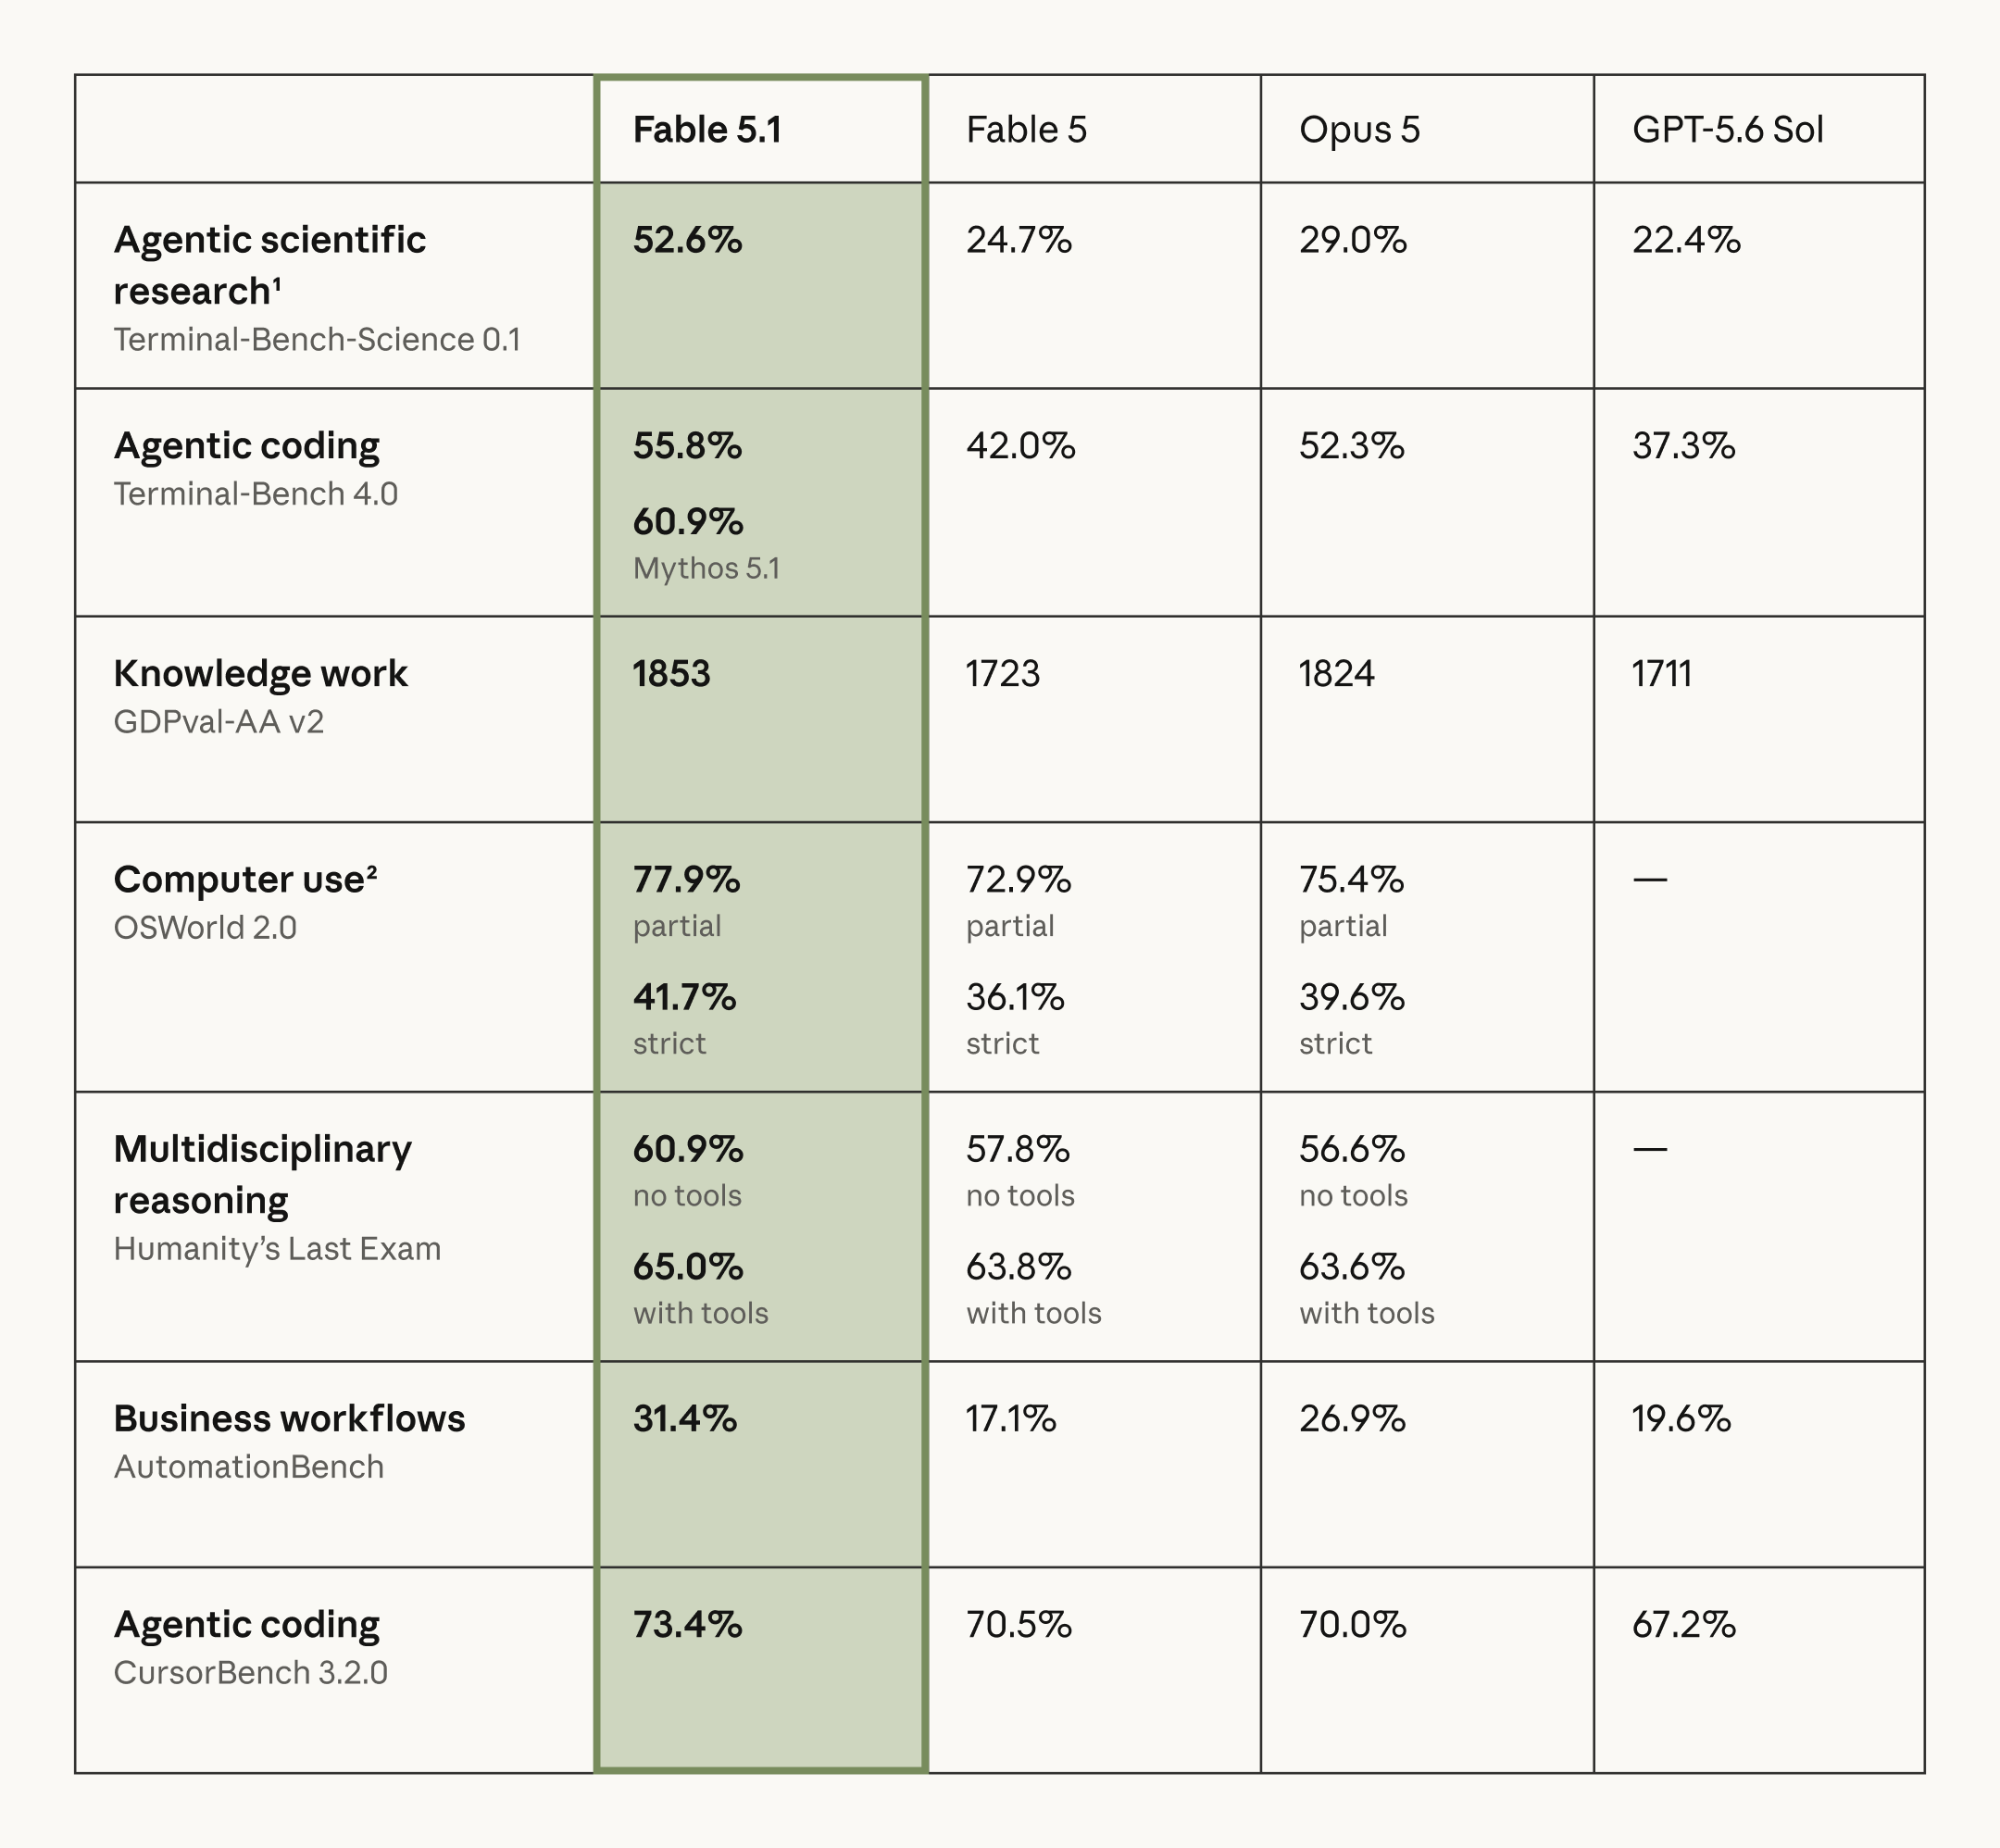
官方基準結果包含兩個模型都有報告分數的五個任務。下方的百分點與 Elo 差異由這些公布值計算。
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1 lead |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
結果異常一致:在 Anthropic 公布的每一列直接比較中,Fable 5.1 都領先 GPT-5.6 Sol。最大的差異出現在代理式科學研究與基於終端機的編碼,而非一般短篇推理。
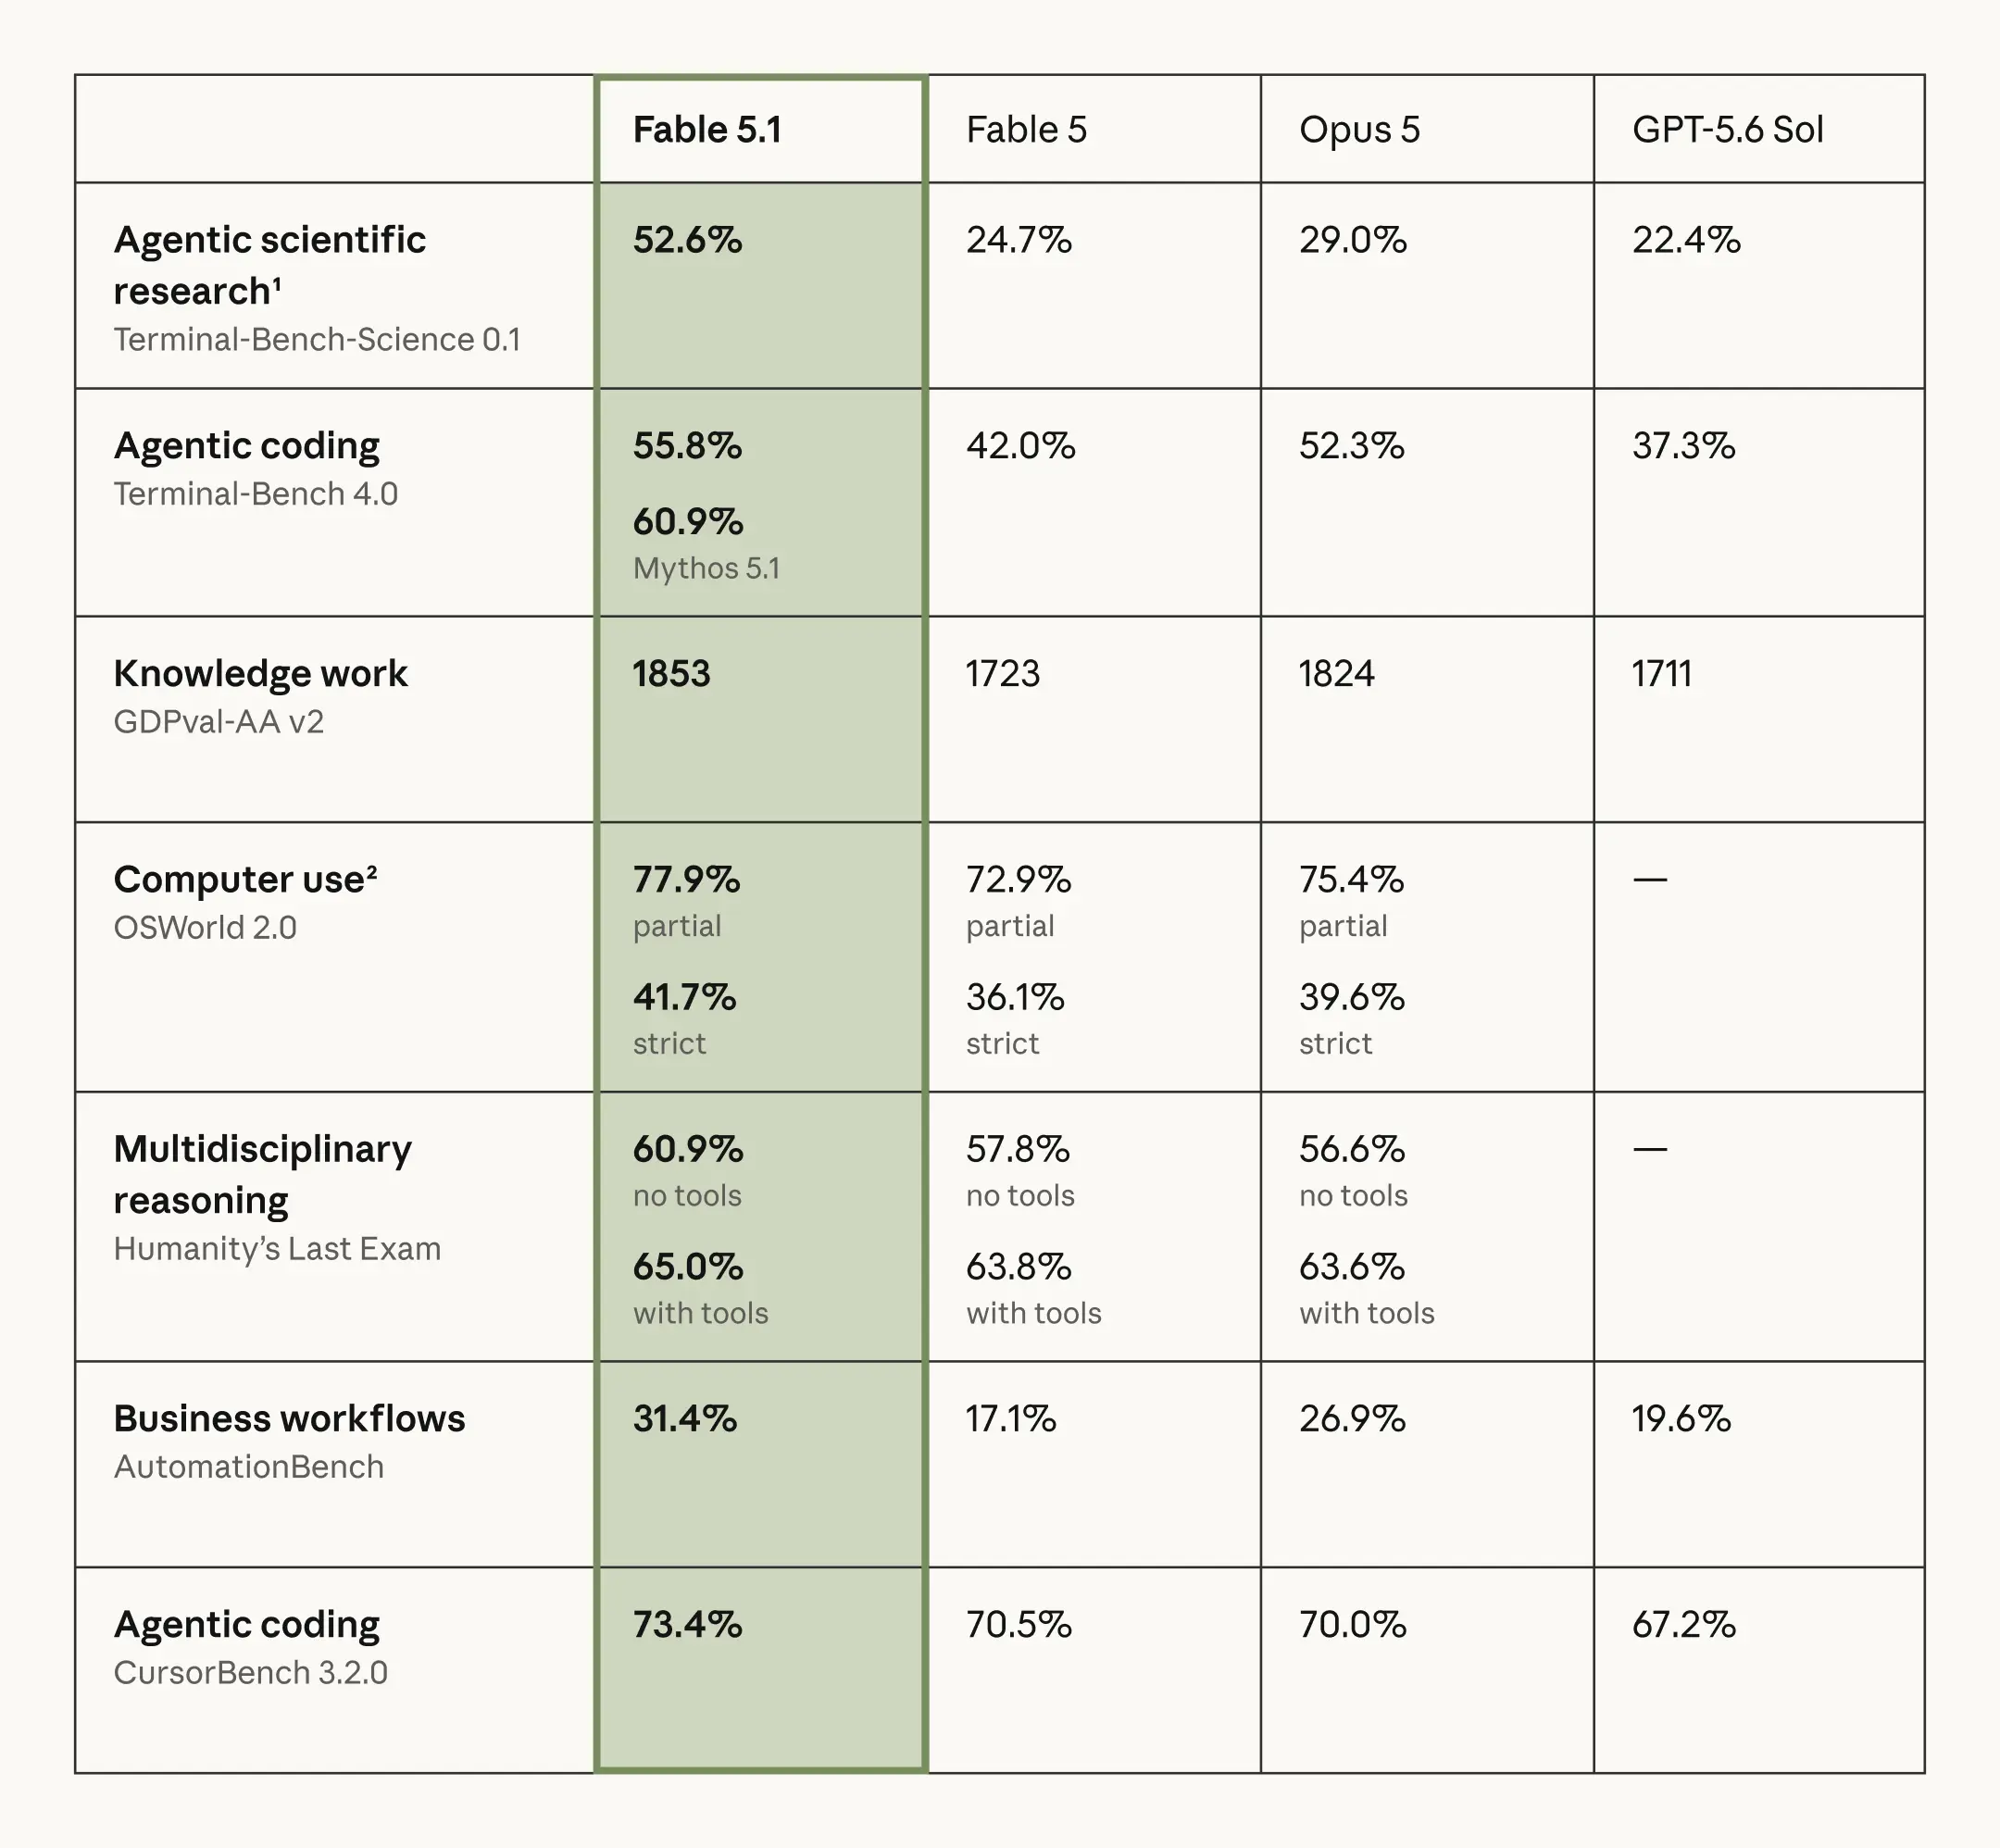
來源:Anthropic — 原始基準圖。
這些是供應商執行的評估:Anthropic 同時測試了自家模型與競品。它們提供直接的比較證據,但不是獨立測試。Anthropic 報告在 Terminal-Bench-Science 上每個模型的標準誤差為 ±3.5–4.5 個百分點;上表顯示的是點估計值,而非信賴區間。
供應商結果偏向 Fable 5.1,但獨立證據需要各自的日期與配置。
Independent benchmarks: separate dated results from live measurements
Artificial Analysis 於 9 月 7 日推出 Intelligence Index v4.3,以 Terminal-Bench 4.0 取代 Terminal-Bench 2.1,並新增 AutomationBench-AA。發布報告 Fable 5.1 為 53、GPT-5.6 Sol 為 47,與 9 月 8 日比較中顯示的四捨五入分數一致。表格將發布時的 terminal 結果與後續的效能快照區分。
| Independent metric AA comparison / v4.3 release | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Result |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (Sep 7 release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Effectively tied |
| Time to first token (Sep 8) | 132.10 s | 277.47 s | Sol |
| AA normalized token-mix price / MTok | $3.08 | $7.175 | Sol |
快照:2026 年 9 月 8 日,除特別標註 9 月 7 日的 Terminal-Bench 列。Fable 5.1 使用 Adaptive Reasoning、Max Effort、Default Fallback;Sol 使用 max。即時測量會變動。AA 的標準化 token 組合價格使用 7:2:1 的快取命中/輸入/輸出比例;它不是每個 API 請求的成本。
OSWorld 2.0 是本次比較中 Sol 的最大優勢:62.6% 對 41.7%,領先 20.9 個百分點。這抵消了 Fable 在 Intelligence Index 與 Terminal-Bench 上更強的結果。
證據支持一個明確的取捨:Fable 5.1 擁有較高的 Intelligence Index,而 Sol 具有更低的首 token 延遲與較低的標準化價格。輸出吞吐實質持平。這些測量支持在重品質的批次工作與互動式應用上做出不同選擇。
具日期的獨立 Terminal-Bench 比較與 Anthropic 的測試趨勢一致:52.0% 對 39.9%,相較於供應商的 55.8% 對 37.3%。兩者差距不可互換,因為評估設置不同。
What OpenAI’s benchmarks still tell us about GPT-5.6 Sol
OpenAI 的發布評估為 GPT-5.6 Sol 的能力提供了額外背景。它們早於上述較新的正面交鋒結果,因此不應直接與 Fable 5.1 做數值比較。
OpenAI 報告 GPT-5.6 Sol 在 Terminal-Bench 2.1 為 88.8%。那是在發布設置下強大代理式編碼能力的證據;較舊的基準版本不應與 Terminal-Bench 4.0 分數做數值對比。
GPT-5.6 Sol vs Fable 5.1 for coding
對於直截了當的程式碼生成,兩者對許多生產工作負載而言都已過度勝任。當編碼演變為代理式軟體工程時,差異更為明顯:檢視大型版本庫、編輯多個檔案、執行指令、診斷失敗、撰寫測試,並反覆迭代直到通過任務。
在此,Claude Fable 5.1 具備更強的當前基準證據。它在供應商與獨立的 Terminal-Bench 4.0 比較中都領先,Anthropic 的 CursorBench 結果亦以 73.4% 對 67.2% 支持它。
對於實務的編碼評估,請納入全倉變更、測試、審查與效能工作。一段成功的短程式碼片段是跨多檔案與多次失敗嘗試才能完成之任務的弱代理。
當周邊執行環境的重要性與模型品質相當時,GPT-5.6 Sol 仍具吸引力。對 shell execution、apply-patch、code interpreter、file search、computer use 與 MCP 的原生支援,能減少你必須自行構建的編排基礎設施。
編碼結論:當你的評測強調最困難的自主版本庫工作時選擇 Fable 5.1。當稍低的基準能力可接受,且換取較低成本與廣泛整合執行堆疊時選擇 GPT-5.6 Sol。
Reasoning controls and developer experience
兩個 API 以不同方式呈現智能。
Sol 從 none 到 max 的推理範圍讓團隊能在多個設置測試品質與延遲。較低努力可減少推理工作,但正確設定取決於任務失敗的成本。
Fable 的常時自適應思考使得 effort 調整成為不同的動作。請比較你的應用將部署的設定,而非將相同的 effort 標籤視為相同的運算預算。
因此,不存在「預設 Sol」與「預設 Fable」之間普遍公平的比較。它們的預設推理配置不同。生產評估應比較等效的運算預算,或你的應用實際將部署的確切設定。
GPT-5.6 Sol vs Fable 5.1:Which is better for AI agents?
選擇取決於瓶頸是困難的推理,還是其周邊的執行期。
Fable 在本文引用的 terminal、automation 與專業工作基準中的領先,使其成為最困難任務的合理候選。請測量完成率與從失敗步驟的恢復能力,然後再將該優勢推廣至你的智能體。
GPT-5.6 Sol 已記錄的 Responses 工具組,對於圍繞 search、files、shell execution 與 patches 構建的應用頗具吸引力。這是需要與任務準確性一併評估的整合優勢,而非可取代準確性的因素。
| Agent requirement | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Hard long-horizon reasoning | Excellent | Best fit |
| Terminal/repository autonomy | Excellent | Stronger evidence |
| Native integrated tool portfolio | Stronger | Strong |
| Forced tool selection | Supported; check chosen API | Restricted; check tool_choice modes |
| Multi-agent platform integration | Strong advantage | Available through agent architecture |
| Progress communication during long jobs | Good | Core behavior |
| Cost-sensitive high-volume agents | Better | Premium |
| Repeated massive cached context | Good | Potentially very attractive |
當僅有少部分任務需要升級時,兩者並用可能更經濟。請衡量額外的成功完成是否能抵銷第二個模型較高的價格與啟動延遲。
Long context: 1.05M vs 1M is not the important difference
標稱數字幾乎相同:GPT-5.6 Sol 提供 1.05M token、Fable 提供 1M。5% 的容量差異不太可能決定你是否能分析大型版本庫、法律語料、研究檔案或多小時的智能體歷史。兩者均已達百萬級上下文。
對 GPT-5.6 Sol,輸入超過 272K 將觸發該請求的較高長上下文費率:$8/MTok 輸入、$0.80/MTok 快取讀取、$30/MTok 輸出。快取寫入也從 $5 升至 $10/MTok。
Fable 5.1 維持其標準 1M 上下文費率:$10/MTok 輸入、$50/MTok 輸出,以及 $0.25/MTok 快取讀取。在此文件化設定中,沒有高於 272K 的額外費率。
考慮一次回合有 100K 未快取的輸入 token、900K 快取讀取 token,以及 20K 總計計費的輸出 token。GPT-5.6 Sol 成本為 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12。Fable 5.1 成本為 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225。
這種快取占比較高的回合幾乎抹平了價格差距,因為 Fable 的快取讀取更便宜。結果取決於工作負載的 token 組合;這不代表在完整的智能體工作階段中兩者成本相同。
成本假設:900K token 的前綴已被快取,而 100K 新鮮輸入未計入新的快取寫入。估算不包含初始快取寫入與工具費用。20K 輸出額度包含所有計費輸出,包含任何計費的推理 token。
Pricing: Sol wins ordinary workloads, Fable wins one important cache metric
在檢查的費率下,Sol 每 MTok 為 $4 輸入 / $20 輸出,快取讀取 $0.40。Fable 5.1 為 $10 輸入、$50 輸出、$0.25 快取讀取。下表將供應商價格與 CometAPI 中 GPT-5.6 Sol API 與 Claude Fable 5.1 API 的費率分開。
| Price component | GPT-5.6 Sol Official prices | Claude Fable 5.1 Official prices |
|---|---|---|
| Official input / MTok | $4.00 | $10.00 |
| Official output / MTok | $20.00 | $50.00 |
| Official cache read / MTok | $0.40 | $0.25 |
| Official cache write / MTok | $5.00 (30 minutes) | $12.50 (5 minutes) |
| Above 272K input: input / cache read / cache write / output | $8 / $0.80 / $10 / $30 | Same documented base rates |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
快取寫入時長不同:Sol 使用預設 30 分鐘保留期,而 Fable 5.1 顯示的費率為 5 分鐘寫入。請檢查你實際使用的供應商與路由的快取建立、刷新與到期行為。
在檢查到的直連供應商費率下,Fable 5.1 在未快取輸入($10 vs $4/MTok)與輸出($50 vs $20/MTok)上都是 Sol 的 2.5 倍。將這些費率視為具日期的比較,因為供應商促銷與閘道價格可能變動。
短上下文請求,含 100K 輸入與 10K 總計計費輸出,在直連供應商費率下,Sol 約 $0.60,Fable 約 $1.50。在上表 CometAPI 費率下,同樣組合分別約 $0.48 與 $1.20。這些示例不包含快取寫入與工具費用。
Fable 的短上下文快取讀取費率低 37.5%:($0.40 − $0.25)÷ $0.40。對重用大型穩定前綴的智能體而言可能有影響,但總節省仍取決於新增輸入、寫入頻率與輸出量。
定價結論:對於新鮮上下文流量,Sol 是更便宜的起點。隨著快取讀取占比升高,Fable 變得更具競爭力;請比較完整工作階段成本,包括建立與刷新快取。
Speed and latency
最大努力測試可能在首個可見 token 出現前花費大量推理時間。
9 月 8 日的吞吐與延遲測量顯示:Fable 的輸出 69.9 tok/s,Sol 為 69.8 tok/s。首 token 時間為 277.47 秒對 132.10 秒。輸出吞吐幾乎相同;在此配置下,Sol 更快開始產生可見輸出。
這些是最大努力基準測量,不是每次 API 呼叫的承諾延遲。提示長度、推理配置、供應商負載、工具與快取狀態都可能改變結果。首 token 時間與完整回覆時間是不同指標。
對互動式工作,較低的觀測啟動延遲可能偏向 Sol。對非即時研究或隔夜版本庫工作,成功完成可能比等待首 token 更重要。請在你打算使用的設定與併發度下,同時測試兩個模型。
Safeguards are a production difference
兩個模型都採用更強的防護,因其能力延伸至敏感的網路安全與科學領域,但實作方式不同。
OpenAI 為 GPT-5.6 家族描述了分層防護與監控。在敏感領域的應用應將相關防護納入部署行為的評估。
Anthropic 的改道與保留條款描述將部分敏感的網路安全或生物領域請求導向能力較弱的模型,且不按 Fable 費率收費。預設資料保留期為 30 天,企業方案可能有例外。
對於一般編碼與知識工作,這些差異可能不會出現。對於安全產品、受監管的工作負載或隱私敏感的部署,它們應與基準品質與價格一起列入評估清單。
Which model should you choose?
總體比較可歸結為工作負載形狀。
| Workload | GPT-5.6 Sol | Claude Fable 5.1 | Recommendation |
|---|---|---|---|
| Difficult autonomous coding | Excellent | Stronger current benchmarks | Fable 5.1 |
| Long-horizon research | Excellent | Core strength | Fable 5.1 |
| High-volume frontier API | Much cheaper | Expensive | Sol |
| Interactive coding assistant | Lower measured max-effort TTFT | Higher measured max-effort TTFT | Test deployed settings |
| Tool-heavy API agent | Broader native tool stack | Strong | Sol |
| Million-token cached agent | Competitive | Very low cache-read price | Test both |
| Maximum reasoning quality | Excellent | Independent lead | Fable 5.1 |
| Cost per ordinary request | Clear advantage | Premium | Sol |
| Image/document reasoning | Strong | Strong | Test on workload |
| Single-provider OpenAI stack | Natural fit | Requires migration/gateway | Sol |
| Model-independent routing | Strong | Strong | Use both through CometAPI |
路由策略應當配得上其複雜度。將單模型基線與以 Sol 為先、對困難任務升級至 Fable 5.1 的策略比較,只有在它能以既定品質改善每次成功任務的成本時,才保留該路由器。
How to compare GPT-5.6 Sol and Fable 5.1 through CometAPI
CometAPI 已整合 GPT-5.6 Sol 與 Claude Fable 5.1。以其原生請求格式存取兩個模型,送出相同評估集,並在匹配設定下比較回傳結果。
對每個模型使用原生格式請求,並固定提示、資料集、effort 設定、併發度與計分規則。重複執行;單次每模型順序請求不足以可靠估計延遲或品質。
對於生產評估,使用固定提示集、交替順序重複執行、記錄 effort 設定,並評分正確性、測試通過率、工具成功率、重試次數、token 使用量、經過時間與每次成功任務的總成本。在共同基線之後,分別微調各模型。
Final verdict: GPT-5.6 Sol or Claude Fable 5.1?
Fable 5.1 在最困難的自主編碼與長期任務上具備更強的直接證據。它在五個共享的供應商基準列與具日期的獨立 terminal 比較中領先。這使其成為強力的升級候選,但須以你自己的任務驗證。
Sol 具有更低的一般 token 價格、更精細的推理控制,以及廣泛的原生工具堆疊。在檢查到的獨立最大努力配置中,它也有更低的首 token 時間;輸出吞吐實質持平。
當最困難的自主任務決定你的成功率時,優先考慮 Fable 5.1。對於成本導向的前沿推理或工具密集的應用,以 Sol 起步。對互動式工作負載,請在部署的 effort 設定下測試,以確認其觀測到的啟動延遲優勢是否持續。
當單一模型能簡單滿足你的需求時,就選它。只有當評估結果顯示在兩者之間切換能改善品質或每次成功任務的成本時,才新增路由。
FAQ
Is Claude Fable 5.1 better than GPT-5.6 Sol?
在 9 月 8 日快照中,它的獨立 Intelligence Index 更高:53 對 Sol 的 47。它也領先具日期的獨立 terminal 測試。這支持在這些評估上的品質優勢,但不是對所有工作負載都更好的主張。
Is GPT-5.6 Sol cheaper than Claude Fable 5.1?
對於一般未快取的 API 流量,是的:在檢查到的直連供應商輸入/輸出費率中,Sol 為 $4/$20 每 MTok,Fable 5.1 為 $10/$50。快取占比高的工作負載可縮小差距,因為 Fable 的快取讀取更低。請將寫入與到期行為納入估算。
Which model is better for coding?
在本次比較中,Fable 5.1 於自主編碼基準證據更強。Sol 仍對較低成本的工作流程與其整合執行工具具吸引力。請使用帶可執行測試的版本庫任務來判斷量測到的能力差距,是否對你的應用有實質影響。
Which model has the larger context window?
Sol 名義上以 1.05M 領先 Fable 5.1 的 1M token,兩者皆允許最多 128K 輸出。實務上,Sol 的 >272K 計價門檻與 Fable 便宜的快取讀取通常比 50K token 的容量差更重要。
Can I access both models through CometAPI?
可以。CometAPI 中的 GPT-5.6 Sol API 與 Claude Fable 5.1 API 為文字評估提供共同起點。將基線擴展至生產智能體前,請檢查各路由的推理、快取與工具支援。