TL;DR
GPT-6.1 Sol 並不是 GPT-6 Sol 的更大上下文或更昂貴替代品。它保持相同的 1.05-million-token 上下文視窗、128K 最大輸出,以及 $2/$10 的標準 API 定價,同時在程式撰寫、電腦操作、專業工作流程、事實可靠性與代理行為方面有所提升。最明顯的價格變化是提示快取:快取輸入從 $0.20 降至 $0.10(每百萬 token)。
實務上,GPT-6.1 Sol 更像是在相同大致 token 預算下,能完成顯著更多有用工作的升級,而非改變 API 形狀的更新。
Key Takeaways
- GPT-6.1 Sol 是 GPT-6 Sol 的能力升級,維持相同的 1,050,000-token 上下文視窗與 128,000-token 輸出上限。
- 標準 API 的輸入與輸出價格維持 $2/M 與 $10/M;快取輸入從 $0.20/M 降至 $0.10/M。
- 官方評測顯示在程式撰寫、電腦操作、商務自動化與科學工作流程上更強;結果依基準與推理設定而異。
- 遷移需同時檢查推理強度與 API 端點相容性:GPT-6.1 Sol 未移除任何端點,但工具呼叫需使用 Responses API。
- 在替換穩定的 GPT-6 Sol 部署前,請驗證任務成功率、延遲、實際快取命中與端到端成本。
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI 於 2026 年 9 月 22 日推出 GPT-6 Sol。一週後,9 月 29 日的 system-card 附錄宣布了 GPT-6.1 Sol。OpenAI 將新版本定位為 GPT-6 Sol 的升級,而非獨立定價層級。
短發布間隔之所以重要,是因為 GPT-6.1 Sol 並未被定位為新產品層級。OpenAI 保留了 Sol 的定價層級,並將更新重點放在艱難任務的能力、成本效率與代理可靠性上。
OpenAI 將 GPT-6.1 Sol 聚焦於代理式程式撰寫、電腦使用與專業工作。重要比較在於「在既定成本下的任務成功率」,而非僅看型號名稱。下方官方基準總結將能力提升與不變的 API 規格分開。
這使比較異常直接:GPT-6.1 Sol 主要是能力與效率的升級,而非上下文視窗或基礎價格的升級。
GPT-6.1 Sol vs. GPT-6 Sol: What Stays the Same?
兩個模型維持相同的標題容量、支援的輸入/輸出模態與標準輸入/輸出價格。表格同時記錄知識截止、推理選項、工具呼叫與快取讀取費率的差異;這些差異不應被誤認為共用規格。
Shared Specifications and Compatibility Differences
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
上述兩欄官方模型規格顯示相同的上下文與輸出上限。這些數字描述的是容量;並不代表在每個長上下文工作負載上的檢索準確度或延遲都相同。
知識截止稍微前移,從 2026 年 4 月 20 日至 4 月 30 日。更重要的是,GPT-6.1 Sol 不再支援 reasoning.effort="none";其可用推理設定自 low 起跳。
對依賴極低延遲行為的開發者來說,此相容性細節值得測試,因為 GPT-6 Sol 仍支援 reasoning effort none。
Architecture: What Remains Undisclosed
兩個用於比較的模型頁面都未提供參數規模或詳細架構拆解。官方的 system-card 附錄 表示 GPT-6.1 Sol 使用與 Astra 相同類型的資料與訓練;此敘述不代表 Sol 與 Astra 架構相同。因此,架構與參數規模差異在引用資料中仍未披露。
Base Pricing Is Unchanged; Cached Reads Are Cheaper
對一般未快取的 token 而言,否。標準輸入與輸出費率未變。主要的價格改進在於快取輸入。
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol 將快取輸入降至 $0.10 每百萬 token,即未快取輸入費率的 5%。
例如,重複使用 1 億個快取輸入 token,在 GPT-6.1 Sol 上約花費 $10,而在 GPT-6 Sol 上約為 $20。對單次提示而言差異不大,但對具有穩定提示前綴的高量代理來說更有意義。
模型文件所示的官方定價條件同樣適用:超過 272K 輸入 token 的請求,整個請求將套用 2 倍輸入與快取費率,以及 1.5 倍輸出定價。GPT-6.1 Sol 的 Fast 模式為標準的 2 倍;Batch 與 Flex 比標準低 50%。指定區域處理在可用時加收 10%,且 EU 資料駐留不支援 Fast 模式。工具可能另行計費。請依所選處理模式、區域與實際快取命中來預估預算。
What Has Improved in GPT-6.1 Sol?
此升級最好從程式撰寫、代理工作流程、專業文件、科學、事實性與故障復原來評估。以下分組呈現這些改進,同時保留原始基準條件與限制。
Benchmark Overview: Reported Gains and Evaluation Conditions
GPT-6.1 Sol 最強的證據來自任務層級表現,而非原始規格。OpenAI 報告在軟體工程、商務自動化、電腦互動、科學工作流程、事實性與代理對齊方面有所提升。
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | What the Change Means |
|---|---|---|
| DeepSWE v1.1 | 比 GPT-6 Sol 的最佳結果高出 6.4 個百分點,且在更低推理強度與任務成本下;並非相同強度對比 | 更強的長期軟體工程能力 |
| AutomationBench 1.0.6 | 兩者均在 medium 強度下比較,GPT-6.1 Sol 高出 4.8 個百分點;相較 Opus 5.5 在 medium 強度下高出 2.2 點 | 更佳的多步驟商務代理執行 |
| OSWorld 2.0 offline | 在 max 強度下高出 7 個百分點;使用離線集、部分獎勵、版本 v2026.08.08;每個任務成本不到原本的一半 | 更好的電腦使用工作流程 |
| Terminal-Bench Science 0.1 | 在 max 強度下得分超過 GPT-6 Sol 的 2 倍,每個任務成本不到一半 | 科學代理工作流程的大幅提升 |
| Difficult factuality evaluation | 在 low 強度下,含錯誤回應由 11.4% 降至 7.7%;這是一組挑選的困難提示評估 | 困難提示上的事實錯誤更少 |
| Broken-search alignment test | 在最大強度下,未揭示搜尋故障的比例由 4.9% 降至 2.1%;為刻意對抗性的任務 | 更能辨識工具失效 |
以上為 OpenAI 報告的結果,而非第三方 CometAPI 的獨立量測。OpenAI 在其研究環境或透過其 API 評估模型;實際生產行為可能受系統提示與可用工具影響。競品數據來自公開報告。任務成本反映測試組態,並不等於 token 價格。未揭露的細節(如單次執行預算或腳手架)不應被推論。
基準表中的官方結果,是以 GPT-6.1 Sol 在較低推理強度對比 GPT-6 Sol 的最佳分數。此比較不應被描述為在相同強度下的速度或成本對照。DeepSWE v1.1 以真實程式碼庫中的原創、長期軟體工程任務進行評估。
作為背景,最初的 GPT-6 Sol 發布在 DeepSWE v1.1 的最大強度得分為 68.8%。
Coding: Stronger Long-Horizon Software Engineering
程式撰寫可謂最明顯的升級。DeepSWE v1.1 評估代理在真實程式碼庫中的原創軟體工程任務,這些任務需要長時間、多步驟的投入。
上述 DeepSWE 的提升,與代理需要檢視儲存庫、規劃變更、使用工具並在多步驟中修復失敗等情境高度相關。開發者在決定是否為最艱難的任務選用更高成本模型時,可將此升級與 GPT-6 Astra API in CometAPI 比較。
這比短程式碼基準更重要,因為長時間執行的程式代理會透過反覆推理、工具呼叫、檔案讀取、修補與上下文重用累積成本。GPT-6.1 Sol 在不提高標準 $2/$10 token 費率的情況下,改善了任務完成率與重複上下文經濟性。
GPT-6 Sol API in CometAPI 對既有部署仍然實用,並為程式與代理工作負載提供相容 OpenAI 的路徑。
AI Agents and Business Workflows: Automation and Computer Use
是的,且提升不僅限於程式撰寫。AutomationBench 評估代理是否能使用眾多工具完成端到端工作流程,涵蓋銷售、行銷、營運、客服、財務與人資。
基準摘要中的 matched-medium AutomationBench 結果,對工具密集的商務工作流程具有參考價值。但它仍是基準結果,並不保證能在某公司的實際工具堆疊中成功。比較同時包含 Claude Opus 5.5 API in CometAPI;在選型前,請用相同工具與成功標準評估所有候選方案。
對電腦操作而言,上述 OSWorld 結果使用離線集與部分獎勵。較高的部分獎勵分數不必然代表每個任務都端到端完成。瀏覽器狀態、權限、復原行為與工具整合品質仍會影響部署結果。
Professional Documents and Science: Broader Complex-Task Capability
GPT-6.1 Sol 也讓 Sol 層級在專業知識工作上更進一步。OpenAI 使用 GDP.pdf 評估複雜文件理解,模型需根據包含表格、圖表、示意圖、密集格式與細則的 PDF,回答貼近真實的問題,領域涵蓋金融、醫療與法律。
GDP.pdf 為超越一般純文字問答的專業 PDF 分析提供了證據。請將發布聲明中的結果視為「文件理解」的評估,而非保證能正確解讀每張圖表、註腳或掃描頁面。
官方基準摘要中的 Terminal-Bench Science 結果涵蓋資料分析、模擬與定理證明等工作流程。實務的在地評估應同時衡量最終輸出的正確性與可重現性,並量計工具與模型的總成本。
這並不代表 GPT-6.1 Sol 能普遍取代 Astra。OpenAI 仍將 Astra 定位為最難端到端工作的最高能力模型。重點在於 Sol 與 Astra 的性能差距縮小,而其 token 價差仍然顯著。
Factuality and Agent Reliability: Fewer Errors and Better Failure Handling
OpenAI 的事實性數據顯示朝此方向前進,但此評估不應被解讀為普遍的幻覺率。
官方公告直接報告了低強度下的事實性改進:含錯誤回應由 GPT-6 Sol 的 11.4% 降至 GPT-6.1 Sol 的 7.7%,下降 3.7 個百分點,約 32% 的相對減少。這些對話是先前容易觸發錯誤的挑選案例;數值並非通用的幻覺率。
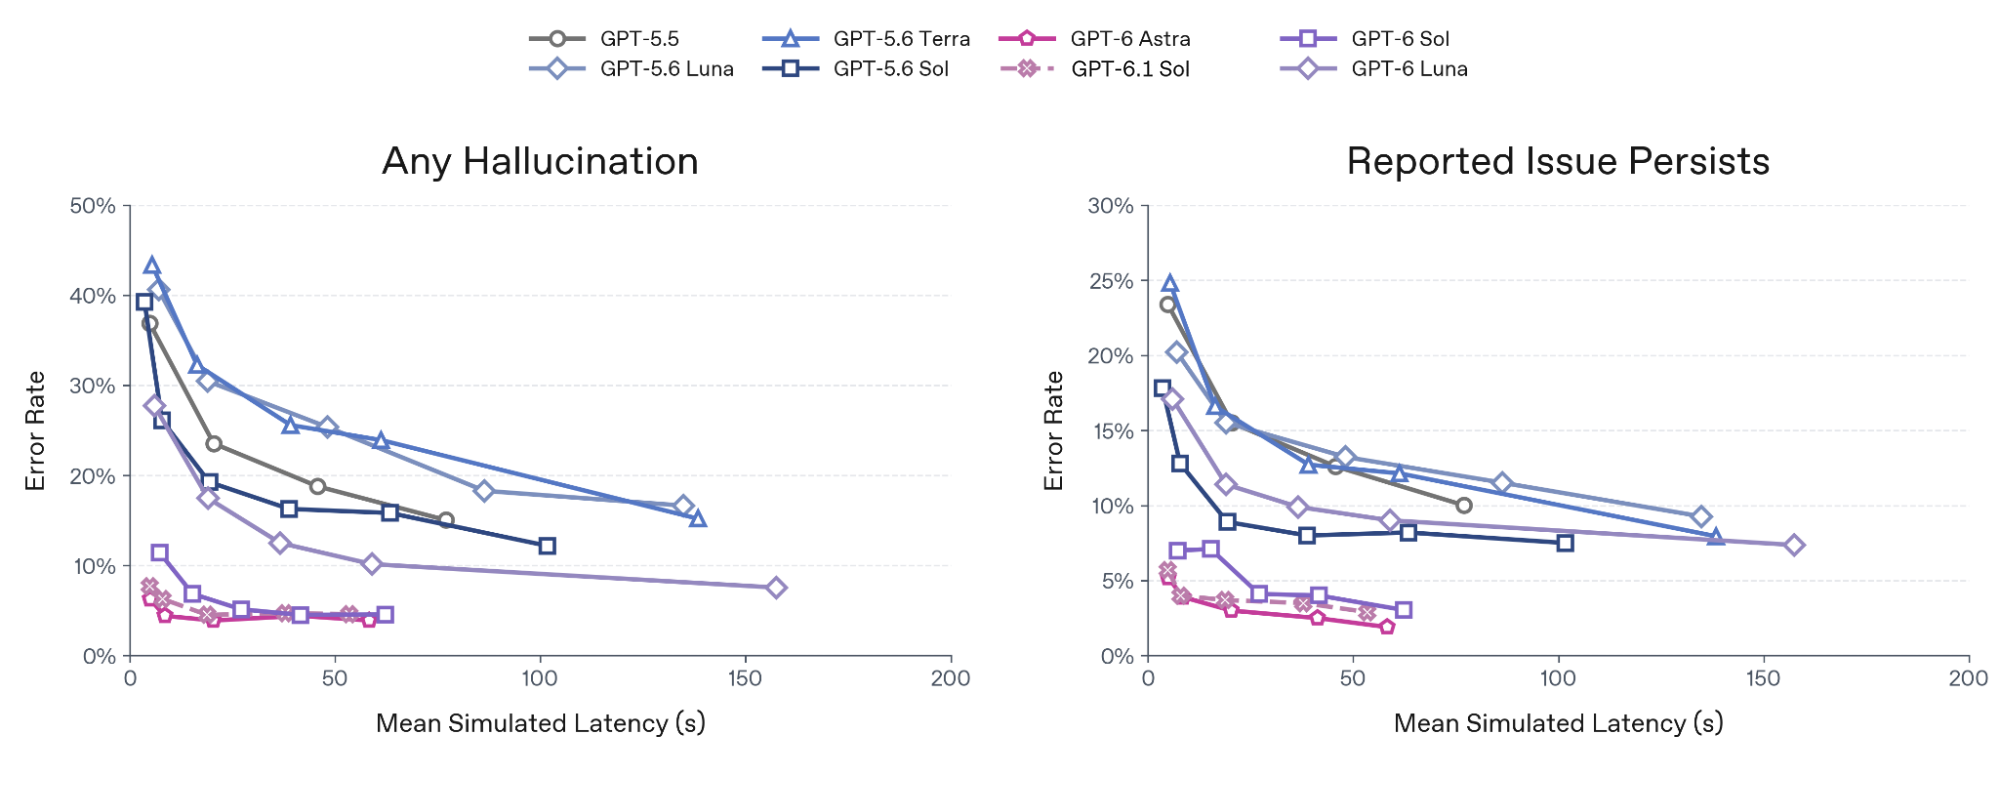
上圖直接擷取自 OpenAI system-card PDF,未重新繪製。它將挑選的困難對話評估對上模擬延遲;兩個子圖分別衡量任何幻覺與問題持續性。請勿將其視為生產環境的整體錯誤估計。
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API in CometAPI 是另一個成本導向選項,但其在此處的搜尋故障結果也說明:代理除了成功的工具執行外,還必須在故障處理上受測。
這些是刻意對抗性的評估,而非生產中具代表性的故障率。它們有助於顯示 GPT-6.1 Sol 在辨識工具不可用或損壞時,比較不會自信地繼續給出不受支持的說法。
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
對於新的複雜工作流程,GPT-6.1 Sol 是很強的評估候選。對於穩定的 GPT-6 Sol 部署,僅在量測到的收益足以支撐遷移成本時再升級。共享的上下文上限與基礎 token 價格讓公平比較成為可能,但公開基準無法決定你的應用是否會變得更快、更可靠或更便宜。
When Upgrading Is Worth Testing
若你的工作量中有相當比重來自儲存庫層級的程式開發、多步驟商務自動化、電腦使用或困難的文件分析,請優先試用。前述章節的官方改進與這些用例相關。將它們視為測試的理由,而非保證你的生產成功率將以相同比例提升。
重複上下文的應用也是有價值的測試案例。較低的快取讀取費率能在請求實際重用穩定前綴時,降低輸入端的費用。若大部分支出來自生成 token、工具或失敗嘗試,單靠快取折扣可能影響有限。請比較每個被接受結果的總成本,包括重試與審核時間。
When Keeping GPT-6 Sol Is Reasonable
當 GPT-6 Sol 已滿足你的品質、延遲與預算目標,且新模型在具代表性的評估中沒有帶來實質好處時,保留現況是合理的。運作中的整合本身也具價值:不要僅因型號較新就替換穩定路由。
相容性可能具有決定性。GPT-6 Sol 支援「none」推理;GPT-6.1 Sol 則從「low」開始。若應用在 Sol 的 Chat Completions 以「none」進行函式呼叫,要使用 6.1 Sol 就必須將工具迴路移到 Responses。也請稽核採樣參數與回應剖析。這些是遷移變更,而非僅換一個 model ID。請見 OpenAI 遷移指引。
How to Make the Upgrade Decision
以目標工作流程建立固定的評估集,包含日常任務、困難案例與工具故障。保持任務定義、工具權限與驗收標準一致。以驗證過的 Sol 基線對比有效的 6.1 Sol 組態;明確記錄推理設定,而非假裝 none 與 low 等同。
- 品質:量測被接受的完成次數、事實修正、無效工具呼叫與人工審核投入。
- 速度:比較端到端延遲的 p50/p95,包含重試與工具等待。
- 成本:記錄未快取輸入、快取讀取、快取寫入、輸出/推理 token、工具費用與工程投入。
- 發布:從小流量切片開始,保留 Sol 後援,僅在達成預先定義門檻後擴大流量。
實務建議:當試用能在不出現不可接受的回退下,帶來更好的被接受任務經濟性或必要能力提升時,選擇 GPT-6.1 Sol。對於那些相容性與既有成果勝過量測收益的路由,保留 GPT-6 Sol。當只有部分任務類別改善時,混合部署是合理的。這些是基於工作負載的建議,而非宣稱任一模型能普遍取勝。
How Do You Migrate From GPT-6 Sol to GPT-6.1 Sol?
最簡單的層次是將模型識別從 gpt-6-sol 改為 gpt-6.1-sol。
A Responses API request can look like this:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="分析此儲存庫,並找出測試失敗的原因。"
)

print(response.output_text)
更改模型識別只是第一步。GPT-6.1 Sol 支援 low、medium、high、xhigh 與 max,而 GPT-6 Sol 另支援 none。請移除任何明確的 none 設定,並選擇允許的強度。使用工具的應用也需要 Responses API:GPT-6.1 Sol 的 Chat Completions 不支援工具呼叫;而 GPT-6 Sol 的 Chat Completions 僅在 reasoning_effort=none 時支援函式呼叫。規格表中的官方欄位已記錄這些端點限制。
團隊應重新測試對延遲敏感的工作流程、工具呼叫、提示快取、長上下文行為,以及任何明確傳送 reasoning.effort="none" 的邏輯。
此範例直接以 OPENAI_API_KEY 連線至 OpenAI,並非 CometAPI 的驗證範例。請在分段發布期間保留 GPT-6 Sol 路由,記錄任務成功與 p95 延遲,若未達到應用的驗收標準則回滾。
Which GPT-6.1 Sol Workloads Benefit Most From the Upgrade?
| Workload | GPT-6.1 Sol Advantage |
|---|---|
| Coding agents | 更高的 DeepSWE 表現 |
| Repository-scale debugging | 更佳的長期軟體工程 |
| Browser/computer agents | OSWorld 2.0 提升 7 個百分點 |
| Enterprise automation | 更高的 AutomationBench 表現 |
| Repeated-context agents | 快取輸入成本降低 50% |
| Complex PDF analysis | 接近 Astra 的專業文件表現 |
| Scientific workflows | 在 OpenAI 的 Terminal-Bench Science 評估中得分超過 GPT-6 Sol 的 2 倍 |
| Fact-sensitive workflows | 困難提示下較低的事實錯誤率 |
| Tool-heavy agents | 工具失效時更好的行為 |
對於既有整合已穩定或開發者特別需要 none 推理設定的情境,GPT-6 Sol 仍然有用。對於以代理、程式撰寫、電腦使用或重複上下文工作流程為核心的新部署,GPT-6.1 Sol 在不改變一般輸入/輸出 token 價格的前提下改變了成本表現關係。
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
對已使用 GPT-6 Sol API in CometAPI 的開發者而言,升級到 GPT-6.1 Sol 通常是相對小的遷移,而非全面改寫整合。
GPT-6.1 Sol 已可透過 CometAPI 使用,模型識別為 gpt-6.1-sol。CometAPI 目前顯示短上下文輸入起價為每百萬 token $1.60,相較 OpenAI 官方的 $2.00;輸出則起價為每百萬 token $8.00。這讓較新的 Sol 模型維持與 GPT-6 Sol 相同的折扣定價結構,同時讓開發者能使用其更強的程式、代理與電腦使用表現。
由於 CometAPI 提供 相容 OpenAI 的介面,現有的 GPT-6 Sol 應用通常可以保留相同的 SDK 結構與請求流程,只需切換模型 ID 為 gpt-6.1-sol。CometAPI 也提供模型比較、提示測試、工作負載成本估算與遷移行為檢視等工具,便於在生產前測試。
更安全的升級流程是先以相同的具代表性提示,分別對 GPT-6 Sol 與 GPT-6.1 Sol 執行,再比較輸出品質、延遲、工具行為與總成本。對依賴推理設定、結構化輸出、工具呼叫或長時間運作代理的應用而言尤其重要,因為「模型相容」並不保證在每個工作負載上的行為相同。
對於重複上下文或代理密集的工作負載,較新的路由也可改善經濟性。CometAPI 目前將 GPT-6.1 Sol 的短上下文快取讀取定價為每百萬 token $0.08,低於 OpenAI 官方的 $0.10,而短上下文輸入與輸出費率標示為比官方定價低 20%。
實務上,CometAPI 可將 GPT-6 Sol → GPT-6.1 Sol 的過程化為三步驟:
- 將
gpt-6-sol替換為gpt-6.1-sol。 - 在切換流量前,以相同的生產級提示與代理工作流程進行基準測試。
- 當輸出品質、工具行為、延遲與成本達標後,逐步移轉工作負載。
此方式讓開發者無需圍繞新 API 堆疊重建應用,即可採用 GPT-6.1 Sol,同時驗證新模型帶來的行為差異。
Conclusion
GPT-6 Sol 並未在技術上過時。它仍保有 1.05M 上下文視窗、128K 輸出上限、結構化輸出、影像輸入與 $2/$10 的標準定價。其 none 推理選項對既有整合也可能很重要。升級決策應取決於量測到的任務結果與相容性,而非單靠版本號。
不過,OpenAI 的 GPT-6 Sol 文件現已引導開發者前往 GPT-6.1 Sol 作為較新的 Sol 模型。
對多數複雜工作負載而言,關鍵問題不是 GPT-6.1 Sol 是否有更大的上下文或更高的 token 費率——答案是否定的。關鍵在於:更高的任務成功率、更便宜的快取讀取、更好的事實性與更穩定的代理行為,是否足以支撐更換模型識別並重新測試工作負載。
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?
不可以。請先稽核端點與請求欄位,接著將工具迴路移至 Responses API,並測試工具呼叫解析、引數驗證、重試與錯誤處理。在提高流量前,請以具代表性的任務進行金絲雀測試;僅有文字請求成功並不代表工具迴路正常。
Is GPT-6.1 Sol cheaper in real workloads?
請記錄快取與未快取的輸入 token、快取寫入、推理與輸出 token、處理模式與工具費用。比較每個被接受任務的成本,而非僅看快取 token 價格。只有在請求實際命中快取且前綴穩定時,快取才有幫助;更長的工具迴路或失敗嘗試可能抵銷快取節省。
How should you test GPT-6.1 Sol before switching from GPT-6 Sol?
請使用固定的、貼近生產的任務集合,記錄成功完成、事實修正、無效工具呼叫、p50/p95 延遲與總成本。在測試前先定義可接受門檻。保留模型路由的回滾路徑,僅在新組態達標後再擴大流量。
How do you test GPT-6.1 Sol with PDFs?
建立一個小型語料,涵蓋密集表格、註腳、圖表與掃描頁面,能代表你的目標工作流程。以可驗證答案的問題提問,並要求提供頁面或表格證據。分別評分計算正確性、遺漏的說明與不受支持的答案;對錯誤代價高的輸出保留人工審核。