SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. ai-comparisons/CometAPI 研究
GPT-6.1 Terra 與 GPT-6.1 Sol:基準測試、定價,以及該選哪一個
比較 GPT-6.1 Terra 與 GPT-6.1 Sol 在官方基準測試、推理能力、API 定價與實務工作負載方面的表現,並提供一個 CometAPI 的 Python 範例。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)
TL;DR
針對高量、可驗證、重視成本的任務,先從 GPT-6.1 Terra 開始。對於複雜程式設計、多步驟工具使用,以及失敗成本高的工作流程,評估 GPT-6.1 Sol。實用的預設做法是先用 Terra,當預先定義的測試或驗證檢查失敗時,再升級至 Sol。
Key Takeaways
- 標準 Token 定價: 在 OpenAI Standard 上,Terra 的輸入為每百萬 Token $1,輸出為 $5;Sol 分別為 $2 和 $10。
- 針對任務的效能: 在最大推理強度下,Terra 在 Agents’ Last Exam v1 和 Terminal-Bench-Science 0.1 略勝一籌,而 Sol 在 Terminal-Bench 4.0 與 OSWorld 2.1 取得領先。
- 共享的上下文容量: 兩者皆提供 1.05 百萬 Token 的上下文視窗,並支援文字與影像輸入。
- Terra 支援以 關閉推理;Sol 至少需要 的推理強度。
不同的推理控制:
none
low
運營成本很重要: 比較每個成功完成任務的支出,包含重試與工具呼叫;另行追蹤人工審核成本。GPT-6.1 Terra vs GPT-6.1 Sol: Overview and Specifications
以下概覽總結了取捨;後續章節說明每個選擇背後的證據、計費假設與限制。
|
| Starting workload | 常規視覺工作與可重複的代理 | 複雜編碼與持續的專業推理 |
| Context and modalities | 相同總上下文容量;文字與影像輸入 | 相同總上下文容量;文字與影像輸入 |
| Reasoning control | 包含關閉推理的選項 | 至少需要低推理強度 |
| Published performance pattern | 在可重複代理任務上具較低成本的效能 | 在數個困難的程式與桌面測試上更強 |
| API access | OpenAI 與 CometAPI | OpenAI 與 CometAPI |
GPT-6.1 Terra: Efficient Visual and Agent Workflows
OpenAI 於 2026 年 10 月 26 日推出 GPT-6.1 Terra。它結合視覺推理、電腦操作與通用文字生成,適用於常規專業工作流程。其較低的 Token 費率,使其在任務頻繁且結果可檢核時成為實用的起點。
GPT-6.1 Sol: Complex Coding and Professional Reasoning
GPT-6.1 Sol 於 2026 年 9 月 29 日推出,面向高要求的程式設計與專業工作。當面對不熟悉的程式庫、長串相依步驟,或更正代價高昂時,應評估其額外的推理能力價值。
Context, Reasoning, and API Specifications
|
| Official release date | October 26, 2026 | September 29, 2026 |
| API model ID | gpt-6.1-terra | gpt-6.1-sol |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Knowledge cutoff | June 1, 2026 | April 30, 2026 |
| Input / output | Text and images / text | Text and images / text |
| Reasoning effort | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Default reasoning effort | medium | medium |
API features: 兩個模型皆支援 Structured Outputs、串流與 Batch API。工具呼叫使用 Responses API,且不支援微調。請確認你選擇的供應商與端點提供你應用所需的功能。
兩者皆允許在 1,050,000 Token 的上下文視窗內輸出最多 128,000 個 Token。若預留完整的輸出配額,則其餘交流(包含你的輸入、系統指令與工具歷史)可用 922,000 個 Token。這是規劃用的估算,並非獨立的固定輸入上限。
架構揭露: 連結的公開模型規格並未提供足夠的內部架構細節,無法進行可靠比較。上下文容量與推理設定不應被視為參數量或架構的證據。
推理控制: Terra 的 none 設定適用於直接的轉換與抽取。首次比較時,應在兩者上使用相同的受支援推理設定,之後再依你的工作負載所需的品質與延遲進行調整。
兩者公布的上下文容量相同,但這不意味著檢索準確度或長上下文推理品質相同。因此,模型選擇應考量推理品質、工作流程效率、成本,以及特定任務的檢索表現。
結果呈現混合情況:Terra 在某些代理與科學程式評測中略勝,而 Sol 在一般終端機程式、桌面自動化與視覺方面得分較高。下列比較將 OpenAI 的發佈結果與獨立評估分開,並說明各自對生產表現能(與不能)提供的資訊。
Official Benchmark Results and Test Conditions
以下結果來自 OpenAI 的 Terra 發佈評估。Terra 顯示 medium 與最大推理強度;Sol 顯示最大強度。最後一欄僅比較最大強度設定。
OSWorld 使用離線的 2.1 評估。事實性測試使用 OpenAI 的內部提示,旨在誘發錯誤。這些為供應商報告、特定評估設定下的結果,並非你的生產工作負載的量測。
|
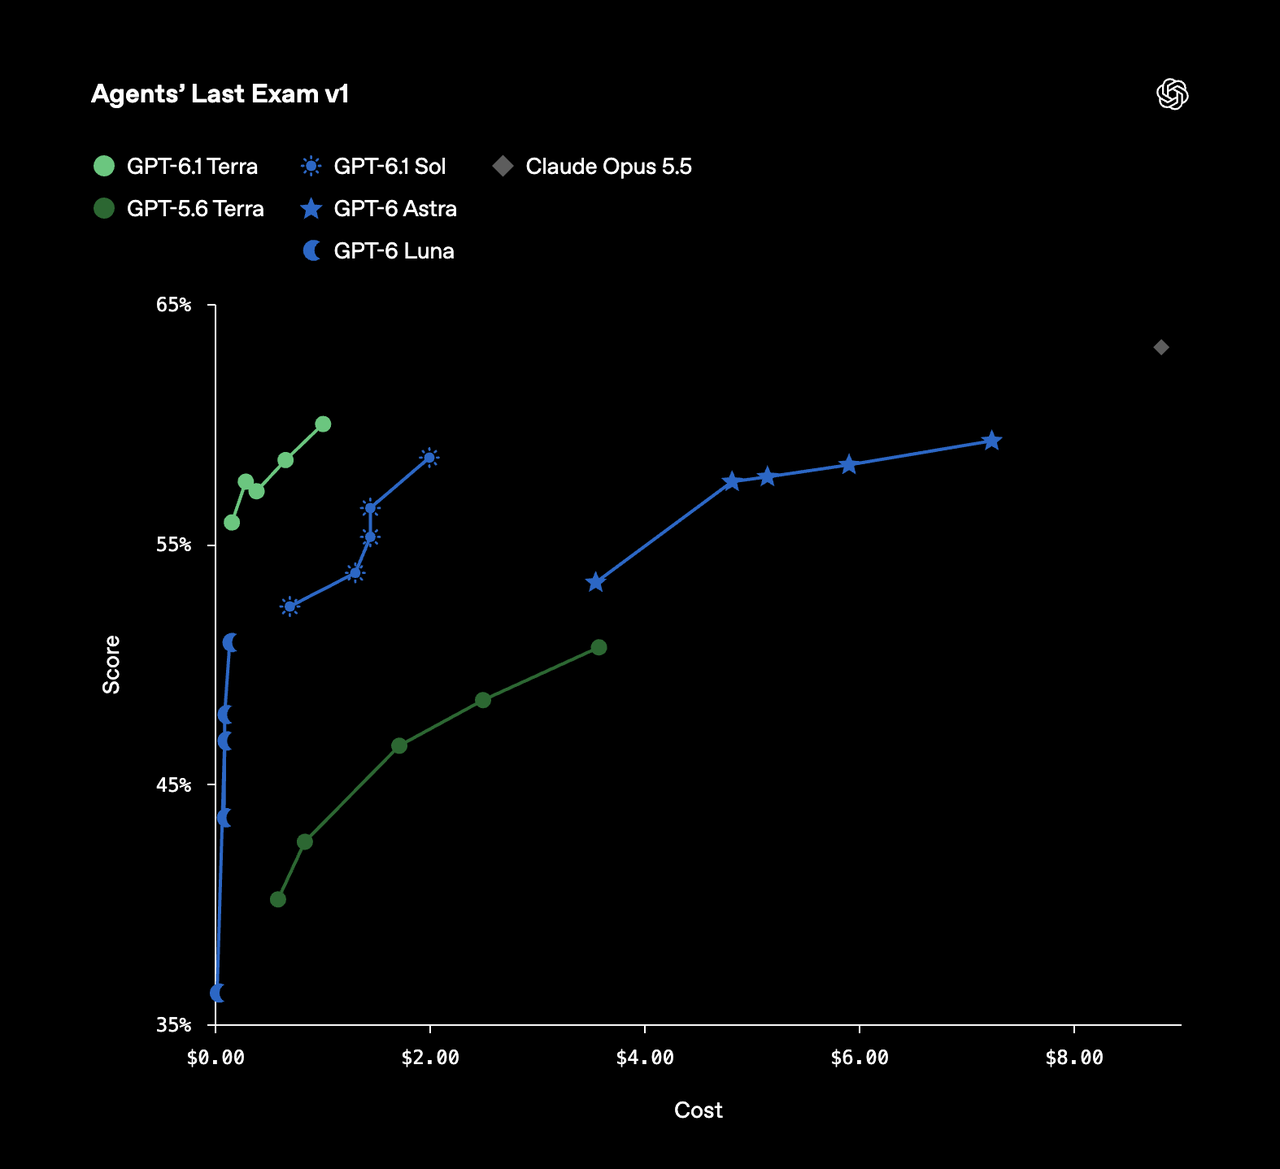
| Agents’ Last Exam v1 | 57.60% | 60.00% | 58.60% | Terra +1.4 pp |
| MMMU-Pro (Vision) | 84.60% | 85.50% | 86.30% | Sol +0.8 pp |
| OSWorld 2.1, offline | 66.70% | 74.20% | 78.00% | Sol +3.8 pp |
| Terminal-Bench 4.0 | 35.80% | 50.30% | 55.90% | Sol +5.6 pp |
| Terminal-Bench-Science 0.1 | 34.30% | 58.30% | 57.00% | Terra +1.3 pp |
| Factual error rate on difficult prompts | 10.10% | 4.30% | 4.40% | Terra 0.1 pp lower |
所有分數皆為百分比;差值以百分點(pp)表示。只有事實錯誤率越低越好。僅 0.1 的錯誤率差異本身不足以建立有意義的可靠性優勢。
對軟體工程而言,Sol 在 Terminal-Bench 上的領先,以及 Terra 在 Terminal-Bench-Science 上的些微領先,暗示結果取決於程式任務類型。對應用工作流程而言,Sol 較高的 OSWorld 分數支持在桌面自動化上評估它,而 Terra 的 Agents’ Last Exam 成績使其成為專業代理任務的候選者。兩者皆無法構成普適的勝者。
代理腳手架、工具存取與環境配置都會影響結果。使用這些數據來挑選測試候選,然後針對你實際需要完成的程式庫修改與應用工作流程進行驗證。
OpenAI 的 Agents’ Last Exam v1 圖表將分數與不同模型配置下的估算任務成本對應繪製。它為上表分數加入成本效率視角;圖中所繪成本僅適用於該評估設定。
Independent Intelligence and Coding Evaluations
Artificial Analysis 於 10 月 26 日的評估顯示,在最大推理強度下,Terra 在其 Intelligence Index 上比 Sol 低 4 分。其 Coding Agent Index v2.0 分別給予 Terra 48 與 Sol 54。這些為獨立評估,具有各自的方法與計分尺度;不應將其與 OpenAI 的基準結果數值合併。
同一分析指出,Terra 的 low 與 medium 推理設定在智慧評估上特別具成本效率。這支持在最大強度之外,同步測試實用配置。評估成本仍然特定於測試設定,不應視為你應用程式支出的估計。
Speed and Latency: Task Completion vs. Token Generation
OpenAI 報告稱,Terra 完成所評估的 Agents’ Last Exam 任務的速度比 Sol 快三倍以上。這是一項端到端任務測量,包含推理與軟體互動。這並不意味著輸出 Token 吞吐量提升三倍,或每個 API 請求都有相同的加速。
對互動式應用,應區分「首個 Token 的時間」(time to first token,輸出開始前的等待)與「每秒輸出 Token 數」(output tokens per second,輸出持續速度)。對代理來說,優先考量包含工具呼叫、重試與恢復在內的「端到端完成時間」。
以相同的提示、工具、受支援推理設定與驗收準則比較兩個模型。記錄延遲與任務成功率:若需要更多修正或無法完成工作流程,較快的回應價值有限。
Vision and Long-Context Performance: What the Results Establish
Sol 在 MMMU-Pro 上以最大強度領先 0.8 個百分點,這是一項報告的視覺結果,並不保證在每個視覺工作流程上都更佳。請用具代表性的輸入測試小字標籤、品質不佳的掃描、密集圖表與不熟悉的版面。
上述評估並未建立哪個模型在長上下文檢索或推理上更佳。雖然兩者公布的上下文容量相同,但容量本身無法證明檢索準確度或跨工作階段的記憶。請測試各模型是否能在你的文件中定位並使用相關證據,並在請求間以明確方式維持應用狀態。
GPT-6.1 Terra vs GPT-6.1 Sol: Cost
Token 價格只是比較成本的起點。重試、推理 Token、工具呼叫與人工審核也會影響完成任務的總支出。
以下費率以美元計,單位為每百萬 Token 與定價。
|
| OpenAI Standard — input | $1.00 | $2.00 |
| OpenAI Standard — cached input | $0.05 | $0.10 |
| OpenAI Standard — output | $5.00 | $10.00 |
| OpenAI Standard — 30-minute cache write | $1.25 | $2.50 |
| OpenAI Standard — 12-hour cache write | $2.50 | $5.00 |
| CometAPI ordinary input | $0.80 | $1.60 |
| CometAPI ordinary output | $4.00 | $8.00 |
OpenAI API Pricing
在上述類別中,Terra 的 Standard 費率為 Sol 的一半。實際收費取決於請求配置:長上下文請求、處理層級、區域處理與工具使用可能有不同條款。在估算生產成本前,請查閱適用的 OpenAI 定價文件。
CometAPI 是第三方存取路徑,具有自己的定價與功能可用性。其列出的「一般輸入」與「一般輸出」費率如下分別顯示。
在這些費率下,CometAPI 的一般輸入與輸出價格比上述 OpenAI Standard 低 20%。部署前請確認你帳戶的即時價格、長上下文收費、快取支援與工具可用性。
Example Cost for 1,000 Requests
假設某應用程式發出 1,000 次請求,每次使用 2,000 個未快取的輸入 Token 與 500 個可計費的輸出 Token。這將產生總計 200 萬個輸入 Token 與 500,000 個輸出 Token。
對於 1,000 次請求,每次使用 2,000 個未快取的輸入 Token 與 500 個可計費的輸出 Token,其估計成本為:
- Terra 經由 OpenAI: 輸入 $2.00,輸出 $2.50,合計 $4.50。
- Sol 經由 OpenAI: 輸入 $4.00,輸出 $5.00,合計 $9.00。
- Terra 經由 CometAPI: 輸入 $1.60,輸出 $2.00,合計 $3.60。
- Sol 經由 CometAPI: 輸入 $3.20,輸出 $4.00,合計 $7.20。
這些計算使用上述一般費率,未包含 Batch API 折扣。未包含快取寫入、獨立工具收費與重試。任何作為輸出計費的推理 Token 必須包含在輸出總數中。
Effective Cost per Successful Task
本文中,「成功任務」定義為在不需額外人工更正的情況下,通過預先定義的品質、(如適用的)結構與完成檢查的任務。
較低的 Token 價格未必帶來較低的運營成本。若 Terra 需要更多次嘗試、更多推理 Token,或更多人工介入,其節省可能縮水。若 Sol 能更多次在首次嘗試即成功完成任務,其較高費率可能值得。
每個成功任務的有效模型與工具成本 = 所有嘗試的模型與工具總支出 ÷ 成功任務數。
請分開追蹤人工審核與更正成本。選擇在達成品質目標的前提下,總成本最低的模型,而非僅比較 Token 價格。
Which Model Should You Choose: GPT-6.1 Terra or GPT-6.1 Sol?
根據任務複雜度、可驗證的輸出品質與總完成成本做選擇。對常規工作流程,Terra 是實用起點;當困難推理或高失敗成本值得額外支出時,Sol 值得評估。
When to Choose GPT-6.1 Terra
對高量抽取、文件撰寫、目錄匹配與可預期的應用程式工作流程,先使用 Terra。當結果可對照來源文件、必填欄位或自動驗證規則檢核時,這些任務是適合的候選。
當 Terra 能在允許的重試與人工審核預算內達到你的準確性與完成目標時,選擇它。若反覆失敗抹去了節省,較低的 Token 費率就失去意義。
When to Choose GPT-6.1 Sol
對於困難除錯、涉及多重相依的程式庫變更,以及具長串相依步驟的桌面工作流程,評估 Sol。
當測試顯示其能產生更多被接受的修補、通過更多測試,或需要更少手動更正時,Sol 較高的 Token 成本是值得的,因為這些改善降低了完成工作的總成本。
When to Use Terra First and Escalate to Sol
混合工作流程可先用 Terra 進行初次嘗試,當預先定義的檢查失敗時再升級至 Sol。請基於可觀察的結果進行升級,而非僅依模型的自信分數。
- 要求 Terra 產出所需變更。
- 執行相關測試與驗證檢查。
- 若變更未通過檢查或超出 Terra 已驗證能力,升級至 Sol。
- 一旦重試預算用盡,將未解決個案送交人工審查。
升級時,保留原始請求、相關上下文、失敗輸出與驗證結果。記錄兩個模型的使用情況,讓成本比較包含完整工作流程。
Production Evaluation Checklist
- 使用具代表性的任務: 同時包含常規請求與失敗代價高的案例。
- 保持比較受控: 使用可比的指示、證據、工具與驗收標準。記錄模型 ID、端點、推理設定與測試日期。
- 衡量被接受的結果: 檢查準確性、(如適用)結構有效性、測試結果,以及是否無需人工更正即可完成。
- 衡量時間與支出: 追蹤中位與尾端延遲、計費 Token、工具呼叫、重試次數與人工審核投入。
- 重複比較: 多次執行任務並交替模型順序,降低偶發結果的影響。
- 定義操作界限: 預先設定重試預算、升級觸發條件與人工核准要求。
- 比較完整工作流程: 在計算每個成功任務的支出時,包含未成功嘗試與升級成本。
Where Can You Access GPT-6.1 Terra and GPT-6.1 Sol?
Official Provider Access
兩個模型皆可透過 OpenAI API 使用。對文字請求,支援 Chat Completions;工具呼叫需使用 Responses API。請確認模型支援的參數、你的帳戶限制,以及你擬用路徑上的工具可用性。
若透過 CometAPI 使用任一模型,請參考其 quickstart guide 設定相容 OpenAI 的 SDK。透過 COMETAPI_KEY 環境變數安全地提供你的 CometAPI 金鑰,並將 base URL 設為 https://api.cometapi.com/v1。選擇 gpt-6.1-terra 或 gpt-6.1-sol 作為模型識別符,並確認該路徑在你的帳戶上已啟用。
首次比較時,給兩個模型相同的代表性任務,並使用 medium 的推理強度。保持指示與驗收標準一致,重複執行各任務並交替模型順序。比較成功結果、耗時、計費 Token 與重試次數,而非由單次回應評斷任一模型。
Conclusion
對於頻繁且可驗證的工作流程,當較低的 Token 定價與更快的任務完成時間重要時,從 GPT-6.1 Terra 開始。當困難程式設計、多步驟工具使用,或失敗成本高使更高推理能力有價值時,評估 GPT-6.1 Sol。最終選擇應基於具代表性評估集下,每個被接受任務的成本,而非僅基於價格或單一基準。
對許多應用而言,實用的下一步是進行小規模、具代表性的試驗,設定明確的通過條件與有界的升級路徑。讓量測結果決定模型,而非依賴價格或單一基準。