
重點摘要
OpenAI 於 2026 年 11 月 17 日推出 GPT-6.2 Astra,作為其面向複雜專業、代理型、科學、法律、設計與程式設計工作的全新前沿模型。相較 GPT-6 Astra,它在長期視野的專業任務與科學基準上帶來可量化的提升,同時將標準 API 代幣價格下調 20%,並透過更高效率進一步降低每項任務成本。
該模型可在 OpenAI API(gpt-6.2-astra)、ChatGPT Work/Codex 以及 CometAPI 上即時使用,與 500+ 其他模型並列提供統一且具成本競爭力的存取。
重點摘要
- GPT-6.2 Astra 是 OpenAI 目前的前沿等級,優化於艱難、需多步驟的專業工作流程、科學研究、法律撰寫、CAD/3D、投影片,以及代理型程式設計。
- 相較 GPT-6 Astra,在關鍵的專業與科學基準上表現更佳,同時使用更少的輸出代幣,大幅降低有效的每項任務成本。
- 標準 API 價格:每 100 萬輸入代幣 $8.00、快取輸入 $0.40、每 100 萬輸出代幣 $40.00(相較 GPT-6 Astra 的輸入/輸出下調 20%;快取輸入下調 60%)。
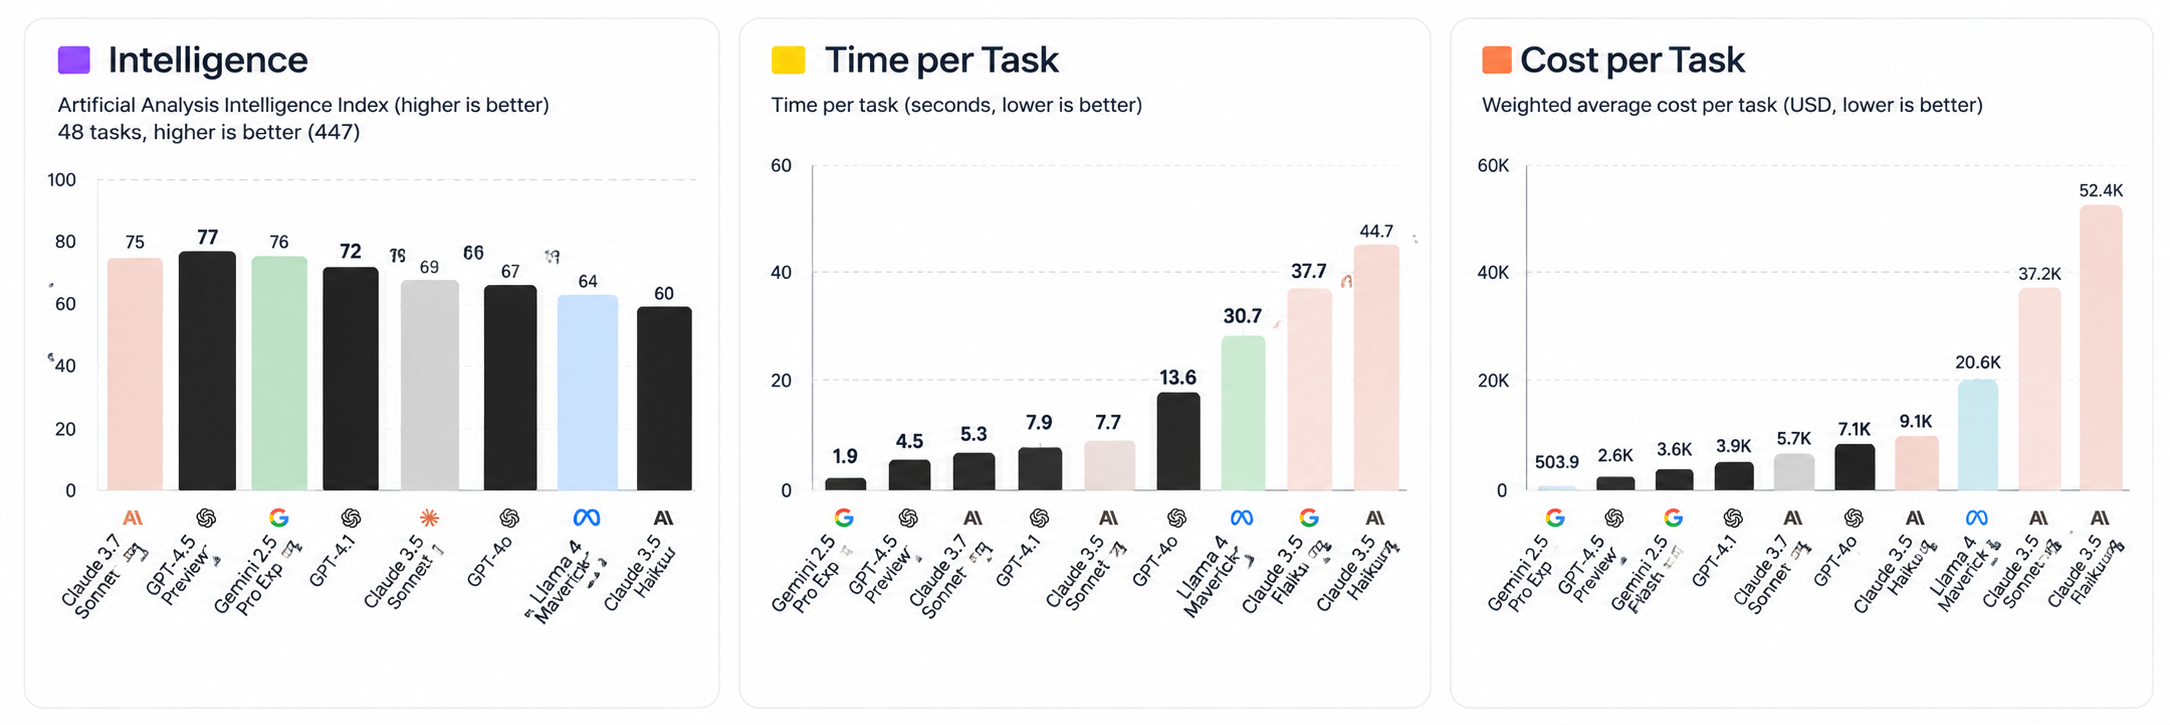
- Artificial Analysis Intelligence Index 分數:62(僅次於 Claude Fable 5.2 的 65,且在多項比較中領先 Gemini 4 Carbon 與 Claude Opus 5.5)。
- 上下文視窗:1,050,000 代幣(最大輸入 922,000 / 最大輸出 128,000)。
- 已在 CometAPI 上線,支援 OpenAI 相容端點,讓開發者僅需一行程式碼即可切換模型,且常能獲得額外節省。
- 推薦用於生產級代理系統、專業文件生成、科學工作流程,以及在成本效率與能力皆重要的高風險程式設計。
什麼是 GPT-6.2 Astra?
GPT-6.2 Astra 是 OpenAI 最新的前沿推理模型,於 2026 年 11 月 17 日與更高效的日常模型 GPT-6.2 Sol 一同發布。它承襲並提升 GPT-6 Astra,明確定位於最困難的專業與長期代理型工作,而非休閒聊天。
OpenAI 將其描述為能生成更乾淨、更符合模板規範的投影片、試算表、文件、網站與 3D 設計。在多步驟的專業工作流程、基於終端環境的科學研究、法律指派完成、CAD 任務,以及與資安相關的評估上表現突出(由於能力提升,適用更嚴格的防護)。
該模型支援極大的上下文視窗(1,050,000 代幣),已記載的最大值約為 922,000 個輸入代幣與 128,000 個輸出代幣。知識截止 reportedly 約為 2026 年 5 月中。它接受文字與圖像輸入,並設計支援工具使用、結構化輸出、提示快取與代理式循環。
需要注意的是,這次推廣重點在 ChatGPT Work、Codex 與 API;並未加入一般免費版 ChatGPT 消費者介面。Enterprise 與 Edu 工作區通常需要管理員啟用。
GPT-6.2 Astra 的關鍵升級
GPT-6.2 Astra 在專業工作、科學研究、程式設計與電腦使用方面提升了 OpenAI 的旗艦模型。其主要升級結合了「更強的任務表現、更高的代幣效率、更低的 API 價格,以及擴增的部署防護」。
1. 更好的專業文件、試算表與簡報
OpenAI 訓練 GPT-6.2 Astra 以生成更清晰、且更符合金融、會計、銷售與法律等專業慣例的成果。據報告,包含更準確的簡報模板匹配、更好的試算表組織,以及更直接的寫作。
在 GDPval v2(評估長期專業工作流程)上,GPT-6.2 Astra 相較 GPT-6 Astra 提升 6.2 個百分點,且使用的輸出代幣減少 22%。對企業而言,值得用於財務工作簿、投資備忘錄、簡報與詳細報告的評估。
2. 更強的科學推理與研究工作流程
Astra 提升了使用計算工具執行科學工作的能力,而不僅是回答知識性問題。
OpenAI 報告在 Terminal-Bench-Science 0.1 相較 GPT-6 Astra 提升 九個百分點,且在測得的任務成本上不到三分之一。同時也在 Vals Science Index(透過模擬實驗評估生物資料解讀與推理)上創下新高。
這些結果支持在科學程式設計、資料集分析與計算研究中測試 GPT-6.2 Astra。科學結論仍需專家驗證。
3.. 改進的程式設計風格與互動式 3D 開發
OpenAI 報告更乾淨的程式碼、更聚焦的測試,以及在複雜版本庫變更上的更強實作。Astra 在互動式網站、遊戲與 3D 體驗方面亦有出色表現。
在 Artificial Analysis 的 AA-3D 評估中,Astra 達到 1,318 Elo,而 GPT-6.2 Sol 為 1,259。此評估衡量人類對生成的互動式體驗之偏好。
程式設計的提升仍依賴工作負載。Artificial Analysis 發現 Astra 在其 Coding Agent Index 上與 GPT-6 Astra 持平,因此開發者應另外評估實作品質與版本庫理解。
4. 進階電腦操作與工具整合
Astra 透過 Responses API 支援工具輔助的工作流程,包括網頁搜尋、檔案搜尋、程式碼解譯器、託管 Shell、Computer Use、MCP 與工具搜尋。OpenAI 也文件化了一個多代理(Multi-agent)測試版以委派工作。
發布重點強調在 CAD、模擬與機械設計工作流程中更精準的電腦互動。這些能力取決於應用程式所提供的工具與權限。
對 CometAPI 整合而言,部署前請確認每個所需端點與託管工具的支援情況。
5. 更低的 API 價格與更佳代幣效率
相較 GPT-6 Astra,OpenAI 將標準輸入與輸出代幪價格下調 20%,而快取輸入價格則下調 60%。
| 代幣類別 | OpenAI 標準費率 | CometAPI 列示費率 |
|---|---|---|
| 輸入 | $8.00 / 百萬代幣 | $6.40 / 百萬代幣 |
| 快取輸入 | $0.40 / 百萬代幣 | $0.32 / 百萬代幣 |
| 輸出 | $40.00 / 百萬代幣 | $32.00 / 百萬代幣 |
價格檢視日期為 2026 年 11 月 19 日。以上為短上下文的費率比較;長上下文請求、工具、快取寫入與處理等級會改變總成本。
對於同時評估 Astra 與其他模型的團隊,CometAPI 提供 OpenAI 相容的整合路徑。請在代幣價格之外,對比每個被接受結果的實際成本。
6. 擴增的安全控制與代理監控
GPT-6.2 Astra 在能力提升的同時引入更強的部署防護。OpenAI 描述了若干改動:
- 更嚴格的資安限制: 6.2 Astra 與 Sol 達到 OpenAI 的 Critical cybersecurity capability threshold。高風險協助在預設情況下面臨更嚴密的限制,若需更寬鬆的存取則需額外審核。
- 更廣泛的監測與介入: OpenAI 擴大了對代理推理與行動的監控。其內部 Control Room 追蹤研究工作負載,並可在出現安全或保全疑慮時終止。
- 更強的研究環境隔離: GPT-6.2 Astra 是 OpenAI 首個對外發布、達到 High threshold for AI Self-Improvement 的模型,因而採取了額外的隔離、監督與分階段部署控制。
- 新增私人推理保護: OpenAI 強化了加密推理保護與防止未授權抽取的檢查。據報導,在受測條件下,具自適應的紅隊抽取嘗試成功率低於 1%。
安全進展仍不均衡。OpenAI 報告模型在某些評估中更常遺漏已知的任務阻礙,然而 Codex 的開發者指令明顯降低了這些遺漏。因此,應用程式應要求明確回報不可用的檔案、工具或來源。
GPT-6.2 Astra 表現**:在非全面勝出的情況下仍有增益**
GPT-6.2 Astra 的基準表現在科學研究、專業代理工作流程與互動式 3D 生成方面尤為強勁。下列數據結合 OpenAI 的發布結果與獨立評估,不應視為同一測試方法所產生。
Artificial Analysis 的發布日分析 將 GPT-6.2 Astra 置於其 Intelligence Index 第二名,僅次於 Claude Fable 5.2,較 GPT-6 Astra 提升五點。Sol 增兩點至 57,與 GPT-6 Astra 相當,且其測得的每項任務成本約為 15%。
同一分析提供了開發者應關注的但書:在使用 Codex 測試架構、最大努力(Max effort)的情況下,GPT-6.2 Astra 相較 GPT-6 Astra 在 Coding Agent Index 上持平。Sol 相較 GPT-6.1 Sol 下降三點,主因是 SWE-Atlas-QnA-AA 大幅下滑 14 點,較常遺漏關鍵事實。
Epoch AI 的模型成績單 亦獨立列出 Astra 為 174 ECI,與 Claude Fable 5.2 並列;GPT-6 Astra 為 169。不同排名反映不同的評估套件。
1. Artificial Analysis Intelligence Index
62.1 分
Artificial Analysis 報告在 Intelligence Index v5.0.1、最大推理努力下,GPT-6.2 Astra 約 62 分,置於其目前模型排名的第三。
該指數結合涵蓋專業知識工作、程式設計、科學與一般推理的九項評估。其組成基準包括 Terminal-Bench 4.0、FrontierCode-AA 2.0、AA-Briefcase、GDP.pdf 與 HLE-Diamond。
這是有用的廣泛衡量,但不代表 Astra 在每個組成項目都排名第一。
2. Terminal-Bench-Science 0.1
Xhigh 設定為 78.6%
Terminal-Bench-Science 評估模型在終端環境中執行科學研究工作流程的能力。
Artificial Analysis 獨立報告:
| GPT-6.2 Astra 推理力度 | 分數 |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
這些結果使 Astra 位居 Artificial Analysis 該項評估的當前排行榜之首。Xhigh 與 Max 的區別很重要:最佳分數不一定來自計算最密集的設定。
3. Vals Science Index
68.44% · 排名第 1
Vals Science Index 在生物資料調查、機制發現與基於終端的科學工作流程等方面評估科學研究能力。
Vals AI 排行榜更新於 2026 年 11 月 16 日
| 模型 | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Astra 的結果對科學研究代理尤為相關,因為該指數結合多個科學任務,而非依賴單一問答型基準。
4. AA-3D:互動式 3D 體驗生成
1,318 Elo · 排名第 1
由 Artificial Analysis 開發的 AA-3D 衡量模型將文字指示轉化為互動式 3D 網頁體驗的能力。人類評估者透過盲式成對投票比較兩個模型生成的體驗。
| 模型 | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
這對互動設計、前端生成與 3D 視覺化而言是值得注意的結果。Astra 較 Claude Fable 5.2 領先 47 Elo 點。
AA-AnalystAgent 的結果同樣需要謹慎解讀:62.5% 指的是在五次獨立嘗試全部正確的情況,而非一般單次嘗試的準確率。同樣地,AA-3D 的 Elo 差距測量的是相對偏好;不能直接當作設計品質的百分比提升。
5. OpenAI 的專業與代理基準結果
OpenAI 亦在自有的專業工作評估上報告強勁表現。
| 基準測試 | GPT-6.2 Astra 成果 | 比較 |
|---|---|---|
| Agents' Last Exam | 高於 GPT-6 Astra 5.2 點 | 每項任務成本不到其三分之一 |
| GDPval v2 | 50.4% | GPT-6 Astra:44.2%;Claude Fable 5.2:44.8% |
| AA-AnalystAgent | 62.5% | 在突顯的工作簿任務中,五次獨立嘗試皆答對 |
| Harvey LAB-AA v1.1 | 15.0% | 透過報告的通過率,為 Claude Fable 5.2 的兩倍以上 |
Agents’ Last Exam 對購買已完成工作的組織尤為相關。OpenAI 亦報告 GPT-6.2 Astra 在約 5% 的任務成本下,較 Claude Fable 5.2 高出 5.5 分。其比較排除了九個使用後備模型的 Fable 任務,這一方法論細節應與標題一同呈現。
這些結果指向在專業代理執行、財務分析與法律文件工作上的提升。然而,GDPval v2 為內部 OpenAI 評估,而 AA-AnalystAgent 與 Harvey 評估各有其任務定義與計分規則。
這些基準測試實際告訴了我們什麼?
有三點結論尤為明顯:
- 科學是重大強項。 Astra 在 Vals Science Index 與 Terminal-Bench-Science 評估上皆名列第一,是計算研究工作流程的強勁候選。
- 專業代理執行是關鍵改進。 GDPval v2 與 Agents' Last Exam 的結果顯示在長期任務上的表現更強。
- 視覺與互動創作是差異化所在。 AA-3D 的結果顯示 Astra 的強項超越傳統文字推理與程式設計。
一個重要的但書:OpenAI 的發布比較並非全是獨立第三方測試。作為獨立驗證,Artificial Analysis 與 Vals AI 提供了有用的補充證據。此外,Astra 的高通用智能分數並不自動意味著它在每一個程式設計基準上都是最佳選擇,或在每一種工作負載中都是最便宜的模型。
GPT-6.2 Astra 對比 GPT-6 Astra(及相關先前模型)
命名說明:OpenAI 先前的前沿模型稱為 GPT-6 Astra。有報導指出 GPT-6.1 Astra 版本在 6.2 發布前因安全考量被取消或延後。
| 面向 | GPT-6 Astra(先前) | GPT-6.2 Astra | 備註 / 優勢 |
|---|---|---|---|
| 發佈 | 約 2026 年 9 月 | 2026 年 11 月 17 日 | 較新 |
| API 輸入 / 輸出 | $8 / $40 每百萬代幣 | $10 / $50(Astra) | Astra 下調 20% |
| 快取輸入 / 100 萬代幣 | $1.00 | $0.40 | 便宜 60% |
| 上下文視窗 | 約 922k–1.05M | 1,050,000(最大輸入 922k / 最大輸出 128k) | 相近 / 更明確 |
| Agents’ Last Exam | 約 73.1% | 約 78.3% | 明顯提升 + 每項任務成本大幅降低 |
| Terminal-Bench Science | 基準線 | + 約 9 點 | 科學強勢提升 |
| AA Intelligence Index | 約 57 | 62 | 競爭力顯著躍升 |
| 每項任務成本(示例) | 較高 | 在 OpenAI 圖表中常低於三分之一;獨立測試下降 36–50% | 效率大幅提升 |
| 輸出代幣效率 | 基準線 | 許多任務使用更少的代幣 | 擴大節省 |
| 防護措施 | 對高風險資安更嚴 | 先前等級 | 對能力提升之回應 |
| Ultrafast | 擴大供應 | 較受限 | Pro 200 現可用 Sol Ultrafast |
GPT-6.2 Sol(同伴日常模型)維持更低價格($2 / $10),並在許多程式設計任務上接近 Astra 的表現,成本約為其五分之一,成為高量工作更實際的預設選擇。
GPT-6.2 Astra 對比 GPT-6 Astra: Astra 6.2 在專業工作流程與科學研究上帶來更佳的報告表現,同時將標準輸入與輸出代幣價格下調 20%。快取輸入折扣更深。
GPT-6.2 Astra 對比 Claude Fable 5.2: Fable 5.2 在 Artificial Analysis 的 Intelligence Index 中分數更高,而 Astra 在 Vals Science Index 與 AA-3D 領先。這提醒我們,模型選擇應依工作負載而定,而非單一總榜。
如何存取 GPT-6.2 Astra
OpenAI 官方管道
- ChatGPT Work 與 Codex(Plus、Pro、Enterprise、Edu 使用者;工作區可能需要管理員啟用)。
- 使用模型 ID
gpt-6.2-astra的 OpenAI API。某些 Pro 方案與 API 提供 Ultrafast 存取。
透過 CometAPI(推薦許多開發者與團隊使用)
CometAPI 於 2026 年 11 月 18 日左右新增 GPT-6.2 Astra 與 GPT-6.2 Sol(模型 ID:gpt-6.2-astra 與 gpt-6.2-sol)。
CometAPI 提供:
- 單一 OpenAI 相容端點與 API 金鑰,支援 500+ 模型(OpenAI、Anthropic、Google 與其他)。
- 常見較官方供應商更低的競爭性定價(約低 20–40%)。
- 切換模型時無需管理多個供應商金鑰或重寫整合程式碼。
- 支援 Chat Completions 與 Responses API 格式。
- 高可靠性目標與簡單遷移(僅需變更 OpenAI SDK 中的
base_url與api_key)。 - 快速開始範例(Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
這使 CometAPI 對希望即刻獲得前沿效能、能與 Claude Fable、Gemini、Grok 或其他模型進行 A/B 測試、並在不被供應商綁定下持續控管成本的團隊特別有吸引力。前往 CometAPI.com 申請免費點數並立即存取。
實務建議
- 在最艱難的多步驟專案、科學研究、高風險的法律/財務撰寫、複雜代理執行,以及視覺/專業文件生成、品質與可靠性至上的情境下,使用 GPT-6.2 Astra。
- 對高量程式設計、日常代理循環與成本敏感的生產工作,預設使用 GPT-6.2 Sol(或智慧路由)——它常以極低成本提供接近 Astra 的結果。
- 利用提示快取,並保持穩定的系統/提示前綴,以最大化極低的快取輸入費率所帶來的收益。
- 針對某些評估中已記載的「遺漏阻礙」傾向進行監控;在無人看管的代理執行中設計明確的驗證步驟。
- 若需多供應商彈性與進一步節省,請透過 CometAPI 路由。
結論
GPT-6.2 Astra 在專業與代理型 AI 工作的成本—能力前沿上邁出重要一步。其在長期與科學基準上更高的分數、顯著更低的代幣價格,以及提升的代幣效率,使其成為 2026 年末最強的實務選項之一。
無論是直接透過 OpenAI 存取,或透過 CometAPI 等統一閘道,該模型都已可在嚴苛的真實應用中投入生產。能同時評估 Astra 與 Sol、衡量自身每項任務成本、並設計適當監督的團隊,將獲得最大價值。

