
Grok 4.7 發佈更新:從預測到正式可用
資訊檢核日期:2026 年 10 月 16 日。
Grok 4.7 已於 2026 年 9 月 21 日正式發佈。早前提到的 9 月 12 日為預發佈估計值,不能視為實際發佈日期。
官方發佈公告描述了在程式設計、知識型工作、長時間任務,以及模型自我結果驗證方面的改進。並確認可透過 Grok API、Cursor 與 Grok Build 使用。關於精確的 API 模型 ID、支援功能、上下文限制與目前定價,請參閱 Grok 4.7 官方文件。
官方結果顯示相較 Grok 4.6 有可量化的進步。例如,發佈比較報告中,Grok 4.7 在 xhigh effort 下的 Terminal-Bench 4.0 分數為 37.6%,而 Grok 4.6 在 high effort 下為 20.3%。上述為供應商在特定評測設置下所報告的結果;實際應用效能將取決於提示、工具、推理力度與任務難度。
對開發者而言,現在的重點在於 Grok 4.7 是否能更可靠且更經濟地完成工作負載。請在程式庫變更、文件建立與多步驟工具工作流程上進行測試,並衡量成功完成率、延遲、重試次數與任務總成本。
來源:Grok 4.7 官方發佈公告.
Key Takeaways
- 9 月 12 日為依據 Musk 的十天倒數所推測的日期,而非另行發布的 xAI 行事曆公告。
- 關於 2.1T 規模與使用 SpaceX 資料的陳述屬於發佈前說法;活躍參數、路由、架構與訓練方法尚未公開。
- Grok 4.6 已在知識型工作與代理任務上展現強勢表現,包括在 FrontierCode v1.1(Extended)達到 61.3%,但在若干艱難的程式設計評測上仍落後於最強比較模型。
- 評估 Grok 4.7 時,應以任務接受率、長期可靠性、Token 效率、延遲與成功成果的成本為準,而非僅以參數數量判斷。
- CometAPI 將在 xAI 正式發佈並提供生產端點存取後,第一時間整合 Grok 4.7;開發者仍應在遷移前驗證線上模型 ID、價格與回應行為。
什麼是 Grok 4.7?
Grok 4.7 是 Grok 4.6 的後繼者,預期延續 xAI 對程式設計、工程、長時間代理與專業知識型工作的聚焦。目前公眾可見的證據主要來自創辦人聲明與發佈倒數,而非完整的技術發佈套件。
最重要的是區分三個對象:已宣佈的 Grok 4.7 模型、描述其可能規模與訓練的預發佈訊號,以及現行的 Grok 4.6 生產基線。在 xAI 發佈最終文件並可對已發佈端點發出成功請求之前,開發者應將 Grok 4.7 視為待評估候選模型。
Grok 4.7 發佈日期與時間線
Grok 4.7 何時預期發佈?
Musk 於 9 月 2 日表示該模型將在十天內到來,推算為約在 2026 年 9 月 12 日
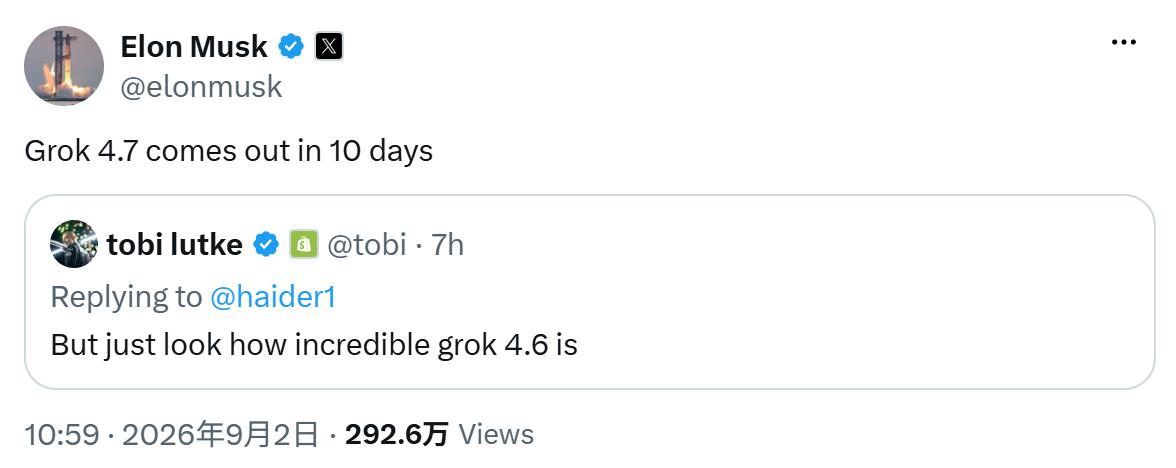
來源: Elon Musk 於 X(2026 年 9 月 2 日)
Grok 4.7 發佈時間線
| 日期 | 公開訊號 | 解讀 |
|---|---|---|
| 2026 年 7 月下旬 | Musk 描述約 2.1T 的模型、改進的 Token 效率,以及稍慢的服務速度。 | 創辦人對模型規模與效率的期望描述。 |
| 2026 年 8 月 12 日 | 初始訓練被描述為已完成;補充訓練 reportedly 納入大量 SpaceX 公司資料。 | 訓練進度更新,非發佈確認。 |
| 2026 年 9 月 2 日 | 「Grok 4.7 將在 10 天內推出。」 | 迄今最明確的公開發佈倒數。 |
| 2026 年 9 月 12 日 | 根據倒數推算的日曆日期。 | 預期目標;最終可用性仍需 xAI 發佈通知與可用端點。 |
Grok 4.7 規格:已確認 vs 未確認資訊
理解當前 Grok 4.7 資訊的最佳方式,是將創辦人直接聲明與 xAI 未發佈的規格區分開來。新的貼文僅確認了模型名稱與發佈倒數;未新增技術參數或基準測試結果。
| 規格項目 | 目前 Grok 4.7 狀態 | 證據等級 |
|---|---|---|
| 發佈時點 | 約在 9 月 12 日,依 9 月 2 日十天倒數推得 | 創辦人宣布之目標 |
| 模型規模 | 約 2.1T 參數 | 創辦人聲明 |
| 初始訓練 | 於 8 月 12 日前描述為已完成 | 創辦人聲明 |
| 補充訓練 | 包含大量 SpaceX 公司資料 | 創辦人聲明 |
| 相對品質 | 聲稱明顯優於 Grok 4.6 | 未經驗證之主張 |
| Token 效率 | 聲稱較 Grok 4.6 有所提升 | 未經驗證之主張 |
| 服務速度 | 預期略慢 | 創辦人聲明 |
| 上下文視窗 | xAI 未發佈 | 未知 |
| 輸入/輸出型態 | xAI 未發佈 | 未知 |
| 最終 API 模型 ID | xAI 文件未確認 | 未知 |
| 官方定價 | xAI 未發佈 | 未知 |
| 官方基準測試 | 尚未發佈 | 未知 |
約 2.1T 參數的主張 未揭露活躍參數、稀疏度、專家路由、推理成本或有效訓練運算量。僅靠參數數量不足以判定生產品質。
為何 SpaceX 訓練訊號可能比 2.1T 更重要
更具影響力的披露可能是 SpaceX 公司資料的補充。高品質工程語料可能改善技術推理、設計、除錯、最佳化與長期代理工作;在這些場景中,任務分配與後訓練品質往往比原始規模更重要。
此方向與 xAI 的已發佈模型策略一致。Grok 4.6 訓練報告 描述了以高品質工程資料進行更長時段的補充訓練,並在程式設計、STEM、網頁開發、核心最佳化與電腦輔助設計等領域進行監督微調與強化學習。
這使得 Grok 4.7 的說法在技術上具可合理性,但尚未得到證實。若要判定是否有實質優勢,需在發佈後透過可重現的工程測試、任務完成率、延遲與每次成功成果的成本來觀察。
Grok 4.7 vs Grok 4.6 表現:基線顯示什麼
目前尚無 Grok 4.7 的官方分數。負責任的比較基準是 xAI 已發佈的 Grok 4.6 評估。完整模型概覽可見於 CometAPI 的 Grok 4.6 深入解析;下表僅保留最有決策價值的基準測試行。
| 官方評測 | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 (Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
基線結果:Grok 4.6 在表中各項均明顯優於 Grok 4.5。它在整體 Intelligence Index 上與 GPT-5.6 Sol 相當,在 GDPVal-AA v2 上領先此組,並在 FrontierCode 略勝 GPT-5.6 Sol。其主要已發佈的差距仍在 DeepSWE 與 Terminal-Bench。
這些結果為 Grok 4.7 設下具體標準。若較大模型與偏工程導向的補充訓練能轉移至生產環境,預期的突破將是更強的儲存庫層級程式設計與終端任務完成能力,同時不失去 Grok 4.6 的知識型工作優勢。可信的延伸目標是,在程式設計與長時間代理工作流程上,與已發佈的 Claude Fable 5.1 競爭。這是待檢驗的預測,而非當前基準主張。
Grok 4.7 vs Grok 4.6:預期突破與升級指引
洩漏與創辦人聲明暗示 Grok 4.7 可能在五個領域有所提升。由於 xAI 尚未發佈最終評估數據,每一項期望都應轉化為可衡量的驗收測試。
儲存庫層級程式設計
Grok 4.6 已在 CursorBench 與 FrontierCode 上表現強勢,但在 DeepSWE 與 Terminal-Bench 上仍有明顯改善空間。Grok 4.7 應在同一批儲存庫上展現更高的補丁接受率、更少的回歸,以及更好的命令列恢復能力,再取代 4.6。
長期代理可靠性
SpaceX 資料訊號與 xAI 現有的代理訓練方向,暗示將聚焦於多階段工程工作。請衡量完成的工作流程、失敗的工具呼叫、重試、人為介入,以及錯誤後的恢復,而非僅看最終文字品質。
知識型工作與技術推理
Grok 4.6 已在 GDPVal-AA v2 上領先比較組。Grok 4.7 應維持此優勢,同時提升在設計審查、研究綜述、除錯、最佳化與其他複雜技術任務上的遷移能力。
Token 效率
較大的模型若能以更少步驟達成正確結果,單次成功任務仍可能更便宜。請比較為達到相同接受結果所需的總輸入、快取輸入、輸出 Token、重試次數與成本。
服務取捨
若 Grok 4.7 較慢,則品質提升必須彌補延遲。請在真實併發下記錄首字延遲、持續吞吐、任務完成總耗時、錯誤率與成本。
Grok 4.7 基準測試:5 項檢驗是否相較 Grok 4.6 為真正升級
- 軟體工程成功率:在具代表性的儲存庫上衡量已解決問題、通過測試、回歸率與補丁接受率。
- 長期代理可靠性:在多步驟執行中追蹤完成的工作流程、工具呼叫失敗、重試、恢復與人為介入。
- 真實工程遷移能力:以公開評分標準測試設計、除錯、最佳化、科學推理與 CAD 相關任務。
- 每次成功任務的 Token 效率:比較達到相同接受結果所需的總 Token 與支出。
- 生產負載下的延遲與成本:在現實併發下評估首字時間、吞吐量、總耗時、錯誤率與成本。
開發者在 9 月 12 日前應做什麼——以及 CometAPI 的角色
Pre-Launch Developer Checklist
- 以真實的程式設計、研究、工程與代理工作流程建立固定評估集。
- 以 Grok 4.6 執行,記錄成功率、重試、工具呼叫、延遲、Token 與總成本。
- 保持模型選擇可配置,避免硬編碼臨時的 Grok 4.7 識別符。
- 留意 xAI 發佈說明 與 CometAPI 模型頁面以確認可用性。
- 發佈後,驗證上下文、輸入/輸出型態、推理控制、定價、速率限制與滾動範圍。
- 在導入生產流量前,以相同評估集重播。
CometAPI 提供統一的 API 層,透過單一帳號與整合模式存取多家 AI 模型供應商。已提供 Grok 4.7 追蹤頁面。CometAPI 將在 xAI 正式發佈並可供生產存取後立即整合 Grok 4.7。
在此之前,請將任何預發佈識別符、價格或能力欄位視為暫定。在導入生產流量前,確認路由已上線、實際請求能成功、返回模型為預期版本,且當前定價可於主控台中查得。
Grok 4.7 定價前瞻 vs Grok 4.6
已發佈的 Grok 4.6 標準費率 為每 100 萬輸入 Token 2 美元、每 100 萬輸出 Token 6 美元(低於長上下文門檻)。xAI 的發佈說明列出超過 200,000 提示 Token 的更高費率。Grok 4.7 的定價尚未正式公佈。
| 已發佈的定價基礎 | 輸入 / 1M | 輸出 / 1M | 狀態 |
|---|---|---|---|
| Grok 4.6,提示低於 200K | $2 | $6 | 已發佈 |
| Grok 4.6,提示高於 200K | $4 | $12 | 已發佈長上下文檔位 |
| Grok 4.7 | 未公佈 | 未公佈 | 需於官方發佈後確認 |
三種定價方向皆具可能性:與 Grok 4.6 持平以加速採用;若服務成本顯著更高則採用溢價層;或依上下文長度與速度分別定價。以上為規劃情境,非 xAI 預測。
Pre-Launch Developer Checklist
- 以真實的程式設計、研究、工程與代理工作流程建立固定評估集。
- 以 Grok 4.6 執行,記錄成功率、重試、工具呼叫、延遲、Token 與總成本。
- 保持模型選擇可配置,避免硬編碼臨時的 Grok 4.7 識別符。
- 留意 xAI 發佈說明 與 CometAPI 模型頁面以確認可用性。
- 發佈後,驗證上下文、輸入/輸出型態、推理控制、定價、速率限制與滾動範圍。
- 在導入生產流量前,以相同評估集重播。
Grok 4.7:接下來應觀察什麼
四項事件將把目前的倒數轉化為可驗證的產品發佈:官方 xAI 發佈貼文;涵蓋上下文、輸入/輸出型態與推理控制的模型文件;最終 API 定價與模型識別符;以及可重現的基準測試或生產評估。
最有用的發佈問題並非 2.1T 是否聽起來很大,而是 Grok 4.7 是否能比既有基線更可靠地完成困難的工程與代理任務,並以更佳的每次成功成果成本達成。
常見問題
Grok 4.7 何時預期發佈?
Musk 的 9 月 2 日十天倒數 指向約 2026 年 9 月 12 日。這是推得的目標,並非 xAI 另行公佈的日曆日期。
Grok 4.7 是否已經發佈?
Grok 4.7 已公開預告/宣佈,但尚未獲得完整的官方 API/模型文件發佈。
Grok 4.7 是否為 2.1 兆參數模型?
Musk 將其描述為 約 2.1T 參數。xAI 尚未發佈確認活躍參數或路由細節的架構文件。
Grok 4.7 會優於 Grok 4.6 嗎?
Musk 聲稱有顯著提升,但尚無官方的 Grok 4.7 基準表。請在可重現結果可得之前,將此視為未驗證主張。
Grok 4.7 是否可透過 CometAPI 使用?
已提供 CometAPI 追蹤頁面,但最終可用性、識別符、定價與支援格式需在官方發佈後確認。
結論
Grok 4.7 的敘事已從早九月的粗略估計,轉向具體的倒數。Musk 的最新聲明指向約 2026 年 9 月 12 日,而較早的貼文則描述了一個約 2.1T 的模型與包含大量 SpaceX 公司資料的補充訓練。
這些是異常具體的預發佈訊號,但它們並非模型卡、基準測試套件或 API 合約。開發者應持續以 Grok 4.6 為可衡量基線,現在就準備受控評估,並在 xAI 與 CometAPI 確認生產存取之前,暫緩做出遷移或預算決策。