
TL;DR
Grok 4.7 與 Xiaomi MiMo‑V2.6 相隔僅一天發布,但代表了兩種不同的前沿 AI 路線。Grok 4.7 強調專有且緊密整合的代理棧,用於程式開發與專業知識型工作;而 MiMo‑V2.6‑Pro 則結合開放權重、更大的上下文視窗、原生多模態理解,以及更具侵略性的 API 價格。
SpaceXAI 將 Grok 4.7 定位為其面向程式開發、代理型任務與知識工作的前沿模型,提供 500K token 的上下文視窗與可配置的推理力度。
Xiaomi 將 MiMo‑V2.6‑Pro 定位為1M 上下文的多模態旗艦,具備開放權重,支援文本、圖像、音訊與影片理解。
**簡而言之:**Grok 4.7 更像是垂直整合、託管代理的產品;MiMo‑V2.6‑Pro 則為開發者提供更大的部署控制與遠低於原始 token 的定價。最佳選擇取決於工作負載,而非單一基準分數。
Key Takeaways
- Grok 4.7 針對長週期程式開發與專業代理而建。In 根據 SpaceXAI 的供應商發布評估,它在 CursorBench 4.0 取得 46.3%,DeepSWE v1.1(高努力)71.0%,AA Briefcase v1.1 1,657 分。
- MiMo‑V2.6‑Pro 對於開放模型而言異常具有競爭力。Xiaomi 公布了模型權重,並報告在多項程式與代理基準上接近專有前沿系統,但跨供應商分數不可直接互換。
- **MiMo 在上下文與多模態上佔優。**MiMo‑V2.6‑Pro 支援 1M token 的上下文視窗,以及文本、圖像、音訊與影片理解;相較之下,Grok 4.7 提供 500K 上下文並支援文本與圖像輸入。
- MiMo 的原始 API token 價格低很多。Official 標準定價為 MiMo‑V2.6‑Pro 的每百萬未快取輸入/輸出 token 分別為 $0.435/$0.87,Grok 4.7 則為 $2/$6。
- 部署架構是關鍵取捨。Grok 提供更強的第一方託管工具棧;MiMo 的開放權重使其可私有部署、自定義服務,並對基礎設施擁有更深控制。
Grok 4.7 vs MiMo‑V2.6‑Pro at a Glance
| 維度 | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| 發布 | September 21, 2026 | September 22, 2026 |
| 存取與控制 | 專有 API 與受管代理生態 | 開放權重、自行託管選項與 API 存取 |
| 性能證據 | 供應商報告在程式與長時運行代理任務上表現強勁;需在相同任務框架下驗證 | 供應商報告在推理、程式與多模態任務上表現強勁;需在相同任務框架下驗證 |
| 差異化優勢 | 第一方工具、受管工作流程與連網(Web/X)代理 | 部署控制、1M 上下文、以及文本/圖像/音訊/影片理解 |
| 上下文視窗 | 500K tokens | 1M tokens |
| 輸入模態 | 文本與圖像 | 文本、圖像、音訊與影片 |
| 官方標準未快取輸入/輸出每 1M tokens | $2 / $6 | $0.435 / $0.87 |
| 推理 | 低至 xHigh | 深度推理 |
| 開放權重 | 否 | 否 |
| 最佳適配 | 受管的程式與代理工作流程 | 私有部署、多模態輸入與更低原始 token 成本 |
What Is Grok 4.7?
SpaceXAI 於 2026 年 9 月 21 日正式發布 Grok 4.7,作為其面向程式與知識工作的最強模型。此發布重要之處在於先前報導混合了已確認事實與洩漏的架構主張。最終發布文件未公佈總參數或活躍參數數量,因此發布前的參數估計不應視為官方規格。
根據官方發布貼文,Grok 4.7 使用了比 Grok 4.6 更大的新基座模型,並以更長的強化學習訓練,偏重於需耗時數小時完成的問題。
這兩個模型優化了不同層級的棧。Grok 4.7 提供更豐富的受管模型周邊環境;MiMo‑V2.6‑Pro 則讓開發者能更直接接觸模型與部署層。
對於超過 200K token 的提示,SpaceXAI 會採用更高的長上下文定價。已公布的分層為每百萬輸入 token $4、每百萬快取輸入 token $1、以及每百萬輸出 token $12。
Changes in Grok 4.7
最關鍵的變化是訓練目標,而不僅是更高的基準分。SpaceXAI 表示其強化學習混合比例轉向更長、需數小時的任務,同時讓模型更仔細地自我驗證工作,並原生理解 Grok Bot 框架。這種結合瞄準真實代理的執行:維持狀態、使用工具、檢查中間成果,並在長任務軌跡中保持一致性。
Grok 4.7 Performance
| SpaceXAI 公布的基準 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
* SpaceXAI 將 Grok 4.7 的 DeepSWE 標註為高努力。以上為供應商發布的評估,應在其文件化的測試框架與推理設定下解讀。
SpaceXAI 在官方公告頁以網頁原生內容呈現發布圖表;上表保留了所披露的基準值,未以重新繪製圖表替代。
What Is Xiaomi MiMo‑V2.6?
Xiaomi 於 2026 年 9 月 22 日正式發布並開源 MiMo‑V2.6。該系列包含 MiMo‑V2.6‑Pro 與 MiMo‑V2.6‑Flash,並提供面向延遲敏感工作負載的 Pro‑UltraSpeed 服務選項。若與 Grok 4.7 直接比較,MiMo‑V2.6‑Pro 是合適的旗艦對標款。
Xiaomi 的官方材料分別說明了開放權重、原生多模態輸入與API 定價。此組合使 MiMo‑V2.6 的重要性超越了基準排行榜。
MiMo‑V2.6 vs MiMo‑V2.5: 改進了什麼?
架構亮點並非只是更大的 checkpoint。Xiaomi 的公開發布重點放在後訓練與 Live RL。根據官方釋出說明,Pro 與 Flash 各自完成了 30 個強化學習步驟,合計生成約 750,000 條軌跡;披露的 RL 階段成本約為 Pro $2.62M、Flash $850K。
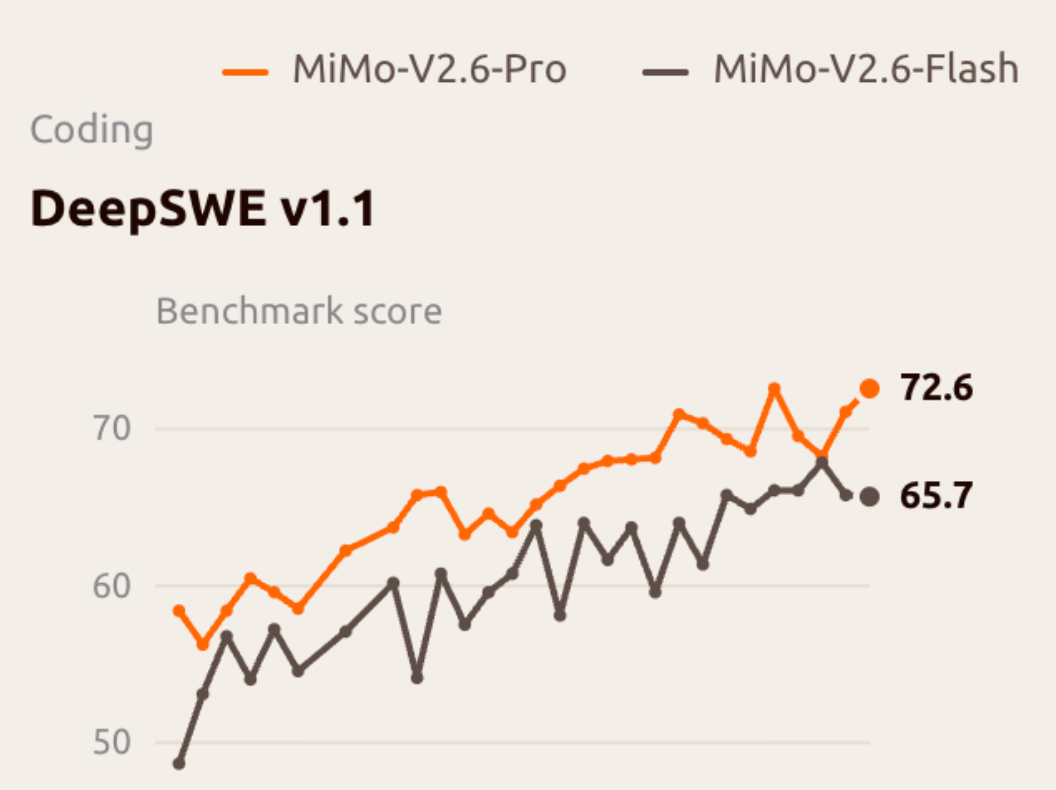
有一個基準細節需謹慎處理:Xiaomi 的 Live RL 曲線顯示 MiMo‑V2.6‑Pro 在訓練過程中於 DeepSWE v1.1 約達 72.6,而最終比較表為 71.9。這些數字屬於不同的評估情境,不應被直接合併。
Grok 4.7 vs MiMo‑V2.6‑Pro: Benchmark Comparison
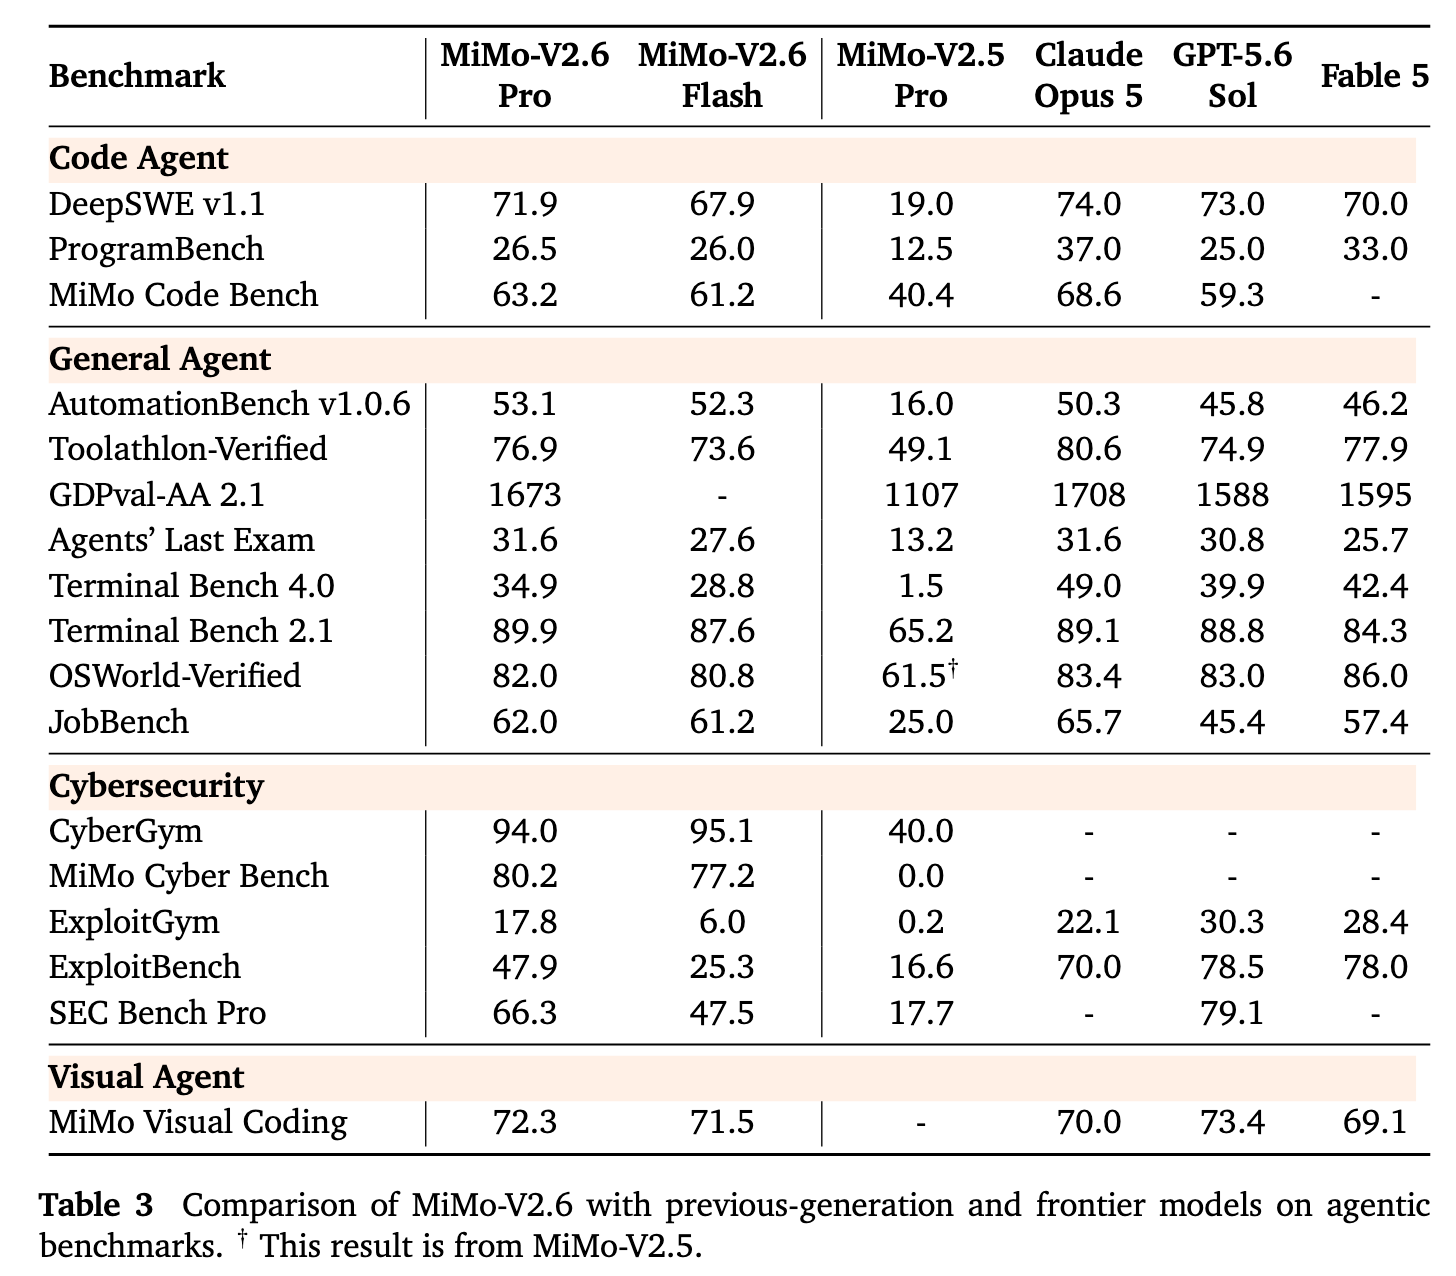
直接比較基準需保持審慎。供應商不一定使用相同的測試框架、推理預算、checkpoint 或工具配置。即使基準名稱一致,些微分差可能沒有看起來那麼重要。最安全的做法是將真正對齊的測量與方向性證據分開。
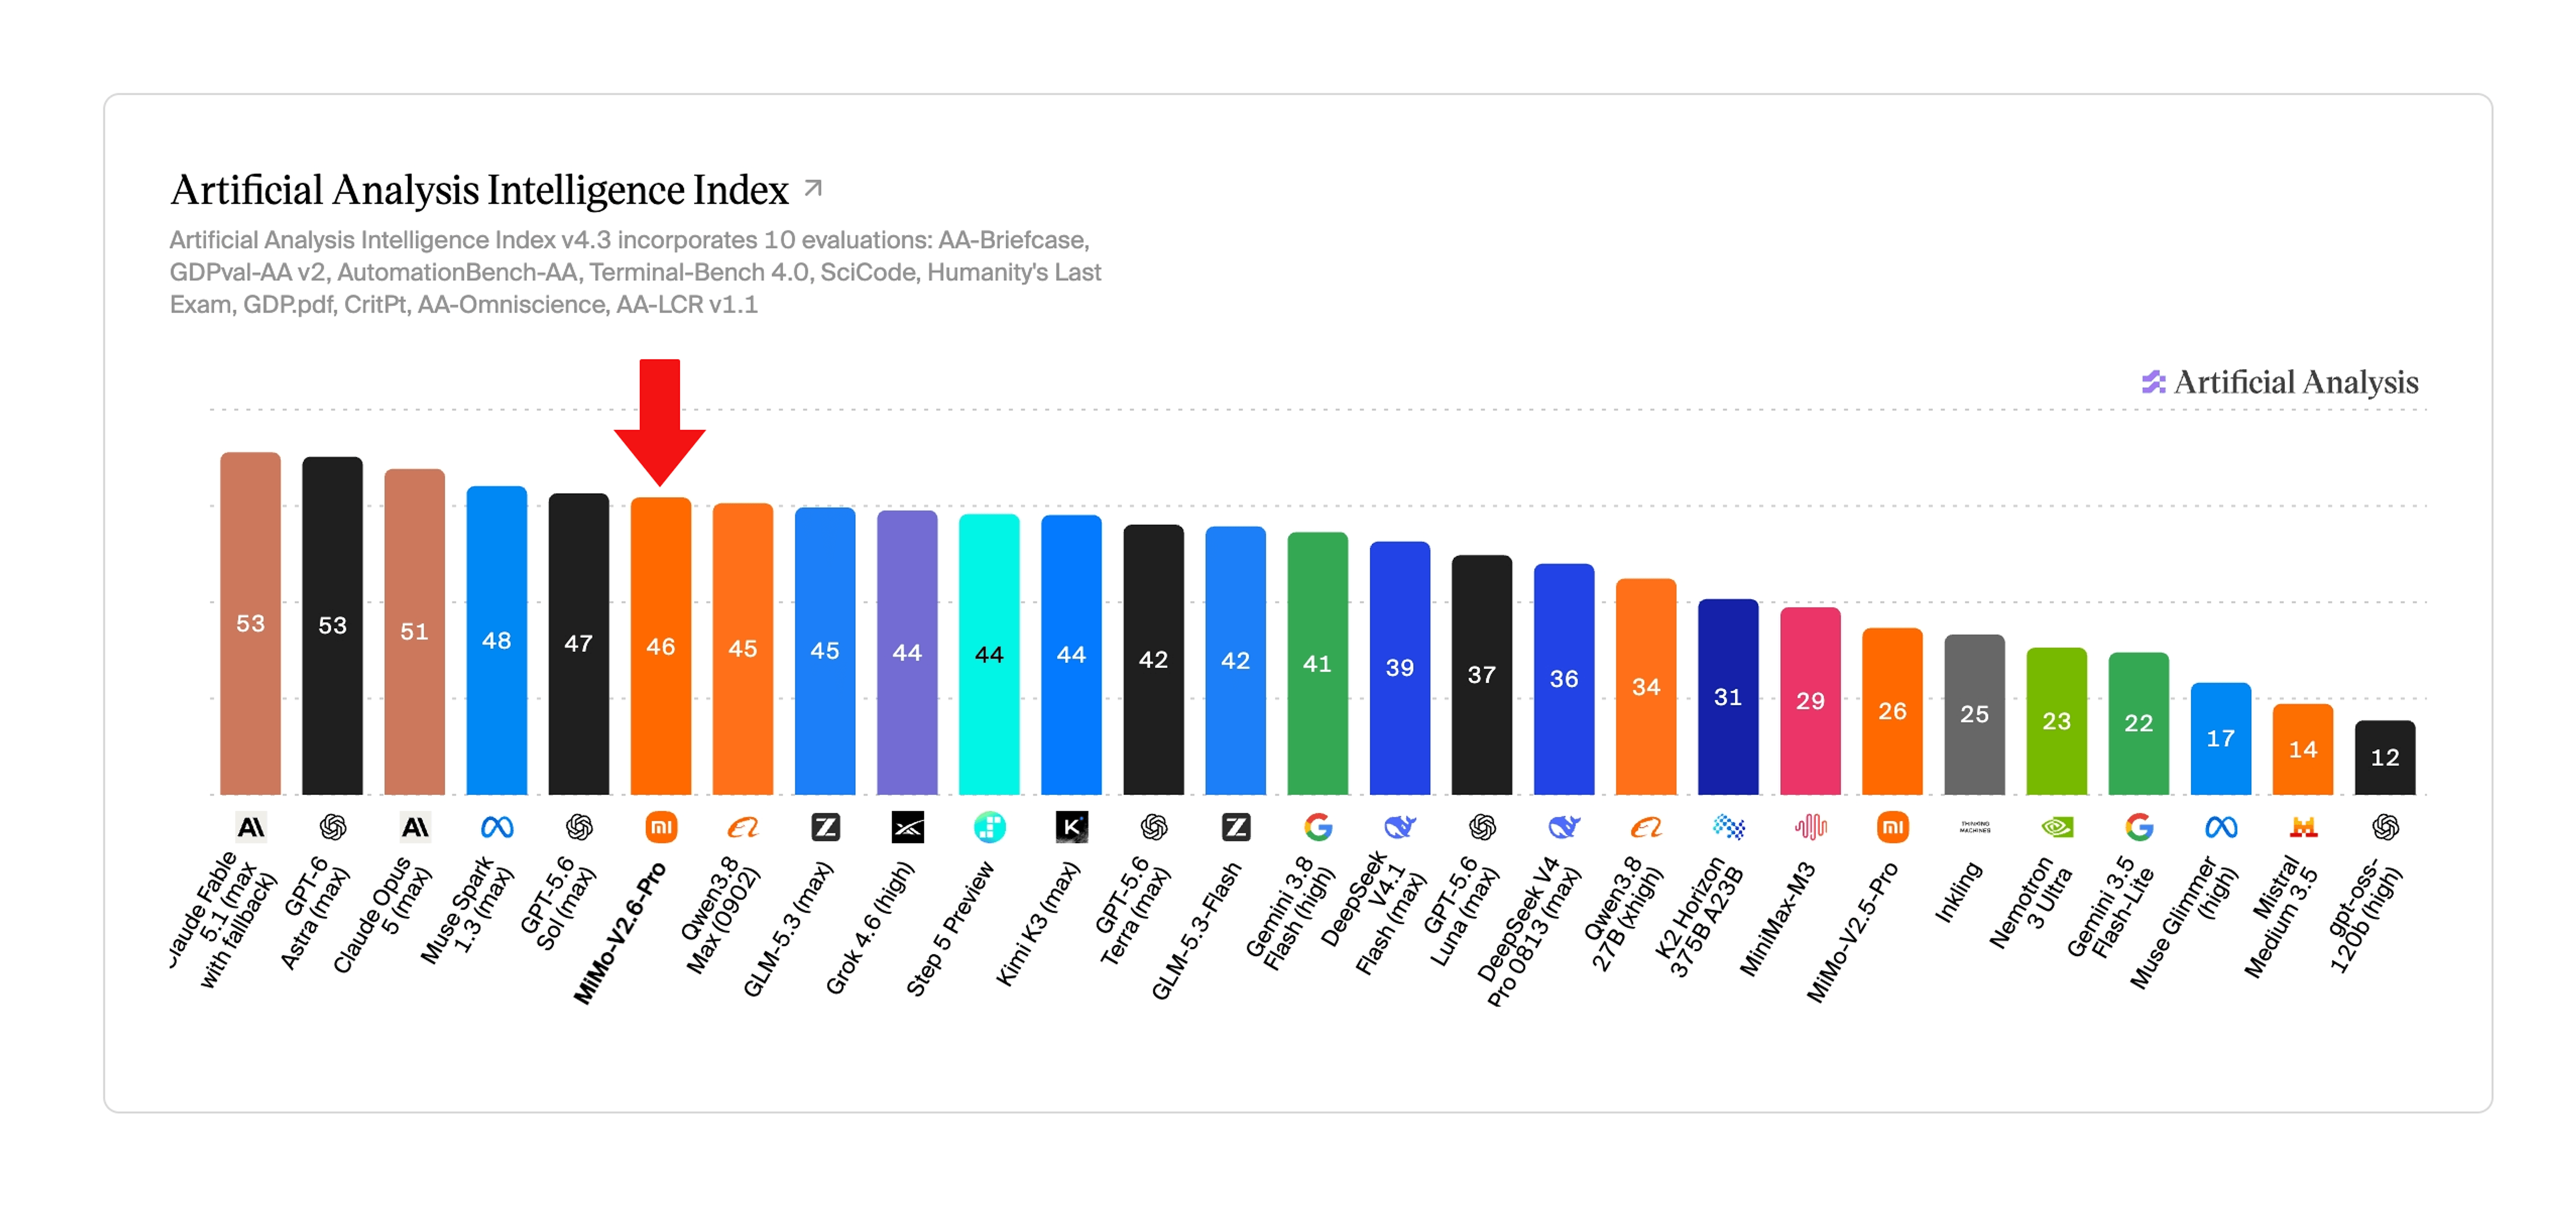
Artificial Analysis Intelligence Index
Xiaomi 報告 MiMo‑V2.6‑Pro 在 Artificial Analysis 綜合指數為 46.32。任何與 Grok 的比較都應綁定使用的精確 Artificial Analysis 快照與模型配置;在沒有來源的情況下,不應提出四捨五入的等值主張。
Coding and Agent Performance
| 基準 | Grok 4.7 — SpaceXAI | MiMo‑V2.6‑Pro — Xiaomi | 解讀 |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | 數值接近;發布的執行與設定不同 |
| GDPval‑AA | 見 SpaceXAI 圖表 | 1,673 | 方向性參考,除非測試框架完全對齊 |
| AA Briefcase | 1,657 | 見 Xiaomi 圖表 | 使用供應商數據並保留來源語境 |
| Terminal‑Bench 4.0 | 38.0 | 34.9 | 方向相似;測試框架設定很重要 |
| 上下文視窗 | 500K | 1M | MiMo 支援更大的工作上下文 |
* SpaceXAI 報告 Grok 4.7 的 DeepSWE 為高努力。 ** Xiaomi 的最終比較表為 71.9;其 Live RL 訓練曲線約達 72.6。這些數字來自不同的評估情境。
Coding Workflow Fit
針對程式開發,關鍵差異在於「程式開發」究竟指原始倉庫問題求解,還是完整的受管程式代理體驗。在 DeepSWE v1.1 上,發布數字足夠接近,不足一分的差距不應單獨決定上線選型。
**Grok 4.7 的優勢在棧的更高層。**它與 Grok Build 整合、可用於 Cursor、能理解 Grok Bot 框架,並搭配第一方程式執行與搜尋工具。
**MiMo‑V2.6‑Pro 的優勢在棧的更低層。**開放權重使其適合構建私有程式助手、客製化服務、強制資料駐留控制,或在自有代理框架中實驗。
對於在兩者之間選擇的團隊,在代表性代碼庫上進行生產級 A/B 測試,會比單一公開程式基準更具參考價值。
Grok 4.7 vs MiMo‑V2.6‑Pro: Multimodal Capability Differences
這是最明顯的差異之一。Grok 4.7 接受文本與圖像輸入並輸出文本。更廣義的 Grok 平台提供獨立的媒體產品,但不應將其與 grok‑4.7 模型本身的模態面混為一談。
MiMo‑V2.6‑Pro 支援文本、圖像、音訊與影片理解。結合 1M token 的上下文視窗,能在單一模型上下文中處理更廣的工作流程。
- 在同一任務中進行截圖與程式碼分析
- 搭配指令的影片理解
- 長篇音訊處理
- 具視覺回饋的電腦使用代理
- 多模態研究助理
- 大規模多模態抽取與品保
Grok 4.7 vs MiMo‑V2.6‑Pro: API Pricing Comparison
| 官方 API 定價 | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| 每 1M 輸入 tokens | $2.00 | $0.435 |
| 每 1M 快取輸入 | $0.50 | $0.0036 |
| 每 1M 輸出 | $6.00 | $0.87 |
| 長上下文附加費 | 是,超過 200K 提示 token | 未公布可比的標準分層 |
| 開放權重/自行託管選項 | 否 | 是 |
按標價,MiMo‑V2.6‑Pro 在一般輸入與生成輸出上的成本低數倍,對快取上下文的差距尤其大。這會實質影響反覆處理代碼庫、長文檔或持久上下文的代理經濟性。
**重要定價提示:**Grok 4.7 的 500K 上下文視窗不代表整個上下文都按標準費率計費。當提示 token 超過 200K 時,該請求將按長上下文分層計價。
截至 2026 年 9 月 24 日,CometAPI 列示 Grok 4.7 的每 1M token 輸入 $1.60、輸出 $4.80,對比官方 $2.00 與 $6.00;MiMo‑V2.6‑Pro 的輸入 $0.348、輸出 $0.696,對比官方 $0.435 與 $0.87。這些列示的標準費率較對應官方價格低 20%。價格與適用資格可能變動;預算前請確認模型當前頁面。
Token 價格不等同於每個完成任務的成本。不同推理模型可能消耗不同的 token 量、使用不同數量的工具呼叫,且需不同的重試率。因此生產評估應同時追蹤完成任務成本、延遲與成功率。
Grok 4.7 vs MiMo‑V2.6‑Pro: Access and Availability
存取差異很直觀:Grok 4.7 經由 API 與受管的 Grok 工作流程提供,且其模型權重不提供自託管;MiMo‑V2.6‑Pro 則既有 API,也提供開放權重,賦予團隊自託管的路徑。
可用性不同於授權或部署靈活度。截止 2026 年 9 月 24 日,兩個模型在 CometAPI 皆有上架頁面。團隊在生產導入前應確認端點、區域、速率限制與帳戶資格;上架不代表每個帳戶享有相同可用性或服務水準。
| 可用性問題 | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| 官方 API | 透過 xAI 提供 | 透過 Xiaomi MiMo 提供 |
| CometAPI 目錄 | 列示可用 | 列示可用 |
| 自託管權重 | 不提供 | 提供開放權重選項 |
| 運維檢查 | 確認帳戶存取、區域、速率限制與工具可用性 | 確認帳戶存取、端點就緒與自託管需求 |
Open Weights and Proprietary Access
MiMo‑V2.6‑Pro 的開放權重使比較超越一分的基準差距。它帶來私有部署、推論引擎調校、自定義後訓練、資料駐留控制及更深度的基礎設施整合等選項。
Grok 4.7 則採取相反取捨:對模型內部控制較少,換取受管、持續運營的服務與緊密整合的第一方生態。對許多組織而言,治理與基礎設施需求會在基準性能之前決定候選清單。
How to Use Grok 4.7 and MiMo V2.6 APIs in CometAPI
開發者可透過CometAPI 的 Grok 4.7 API 使用統一 API 工作流程,減少維護各家供應商特定整合的需求。
對同時基準多個前沿模型的團隊而言,統一的 API 層特別有用,因為同一套生產提示、測試框架、token 統計與應用程式碼可在多個模型間重放,降低整合變數。
CometAPI 現已列示 MiMo‑V2.6‑Pro 可用,API 可用性於 2026 年 9 月 22 日獲得確認。生產使用前請檢查實時目錄與帳戶存取。
隨著兩個模型頁面均顯示可用,應用層級的 A/B 測試可在盡可能一致的前提下保持提示、工具、推理設定與成功標準,並比較任務完成率、延遲、token 使用與失敗型態。
Grok 4.7 vs MiMo‑V2.6‑Pro: Model Fit by Use Case
| 需求 | 模型適配/評估指引 |
|---|---|
| 第一方 Web 與 X 搜尋 | Grok 4.7 |
| 受管長時運行代理 | Grok 4.7 |
| Grok Build/Cursor 工作流程 | Grok 4.7 |
| 1M‑token 上下文 | MiMo‑V2.6‑Pro |
| 原生音訊/影片理解 | MiMo‑V2.6‑Pro |
| 開放權重、自託管與模型控制 | MiMo‑V2.6‑Pro |
| 最低原始 API token 成本 | MiMo‑V2.6‑Pro |
| 代碼庫程式開發 | 在代表性代碼庫上同時基準兩者 |
| 專業知識型代理 | 在實際生產任務上同時基準兩者 |
因此決策應圍繞工作負載架構來制定。Grok 4.7 旨在讓受管代理棧更強;MiMo‑V2.6‑Pro 旨在讓高端智能更便宜、更具多模態與更可控。
Which one should you choose?
若你希望獲得帶第一方 Web 與 X 搜尋、原生程式執行,且運維負擔更低的受管代理體驗,請選擇 Grok 4.7。對重視整合工具棧與長時專業/程式工作流程的團隊而言,它更實用。
若你需要開放權重、私有部署、1M‑token 上下文、原生音訊與影片理解,或明顯更低的原始 API 定價,請選擇 MiMo‑V2.6‑Pro。當部署控制、多模態覆蓋與成本效率是主要約束時,它更有優勢。
若仍難以抉擇,請在相同代表性任務上同時運行兩個模型,保持一致的提示、工具、推理預算、超時與重試策略。選擇在完成率、延遲、每個成功任務的總成本與人工審核成本之間達到最佳組合的模型。
Conclusion
Grok 4.7 與 MiMo V2.6 的比較發人深省,因為「原始智能」已不再是唯一重要的差異。兩者在當前公開評估中處於相近的高能力帶,但其產品策略明顯分歧。
Grok 4.7 結合 500K 上下文視窗、可配置推理、強化長週期代理訓練,以及成熟的第一方搜尋與執行棧。MiMo‑V2.6‑Pro 則結合 1M 上下文、原生多模態輸入與遠低於許多專有前沿系統的 API 定價。
對開發者而言,實際問題不在於「哪個基準分更高?」,而在於「智慧應該部署在哪裡?」受管代理生態與開放、可自定義的模型棧解決的是不同的運營問題。正確的選擇是最契合你的生產工作負載、基礎設施約束與成本模型的那一個。
FAQs
Grok 4.7 是一個 2.1 兆參數的模型嗎?
發布前曾流傳約 2.1T 的數字,但最終的 SpaceXAI Grok 4.7 文件未公佈總參數或活躍參數數量。已確認的說法是 Grok 4.7 使用比 Grok 4.6 更大的基座模型。
MiMo‑V2.6 是開源的嗎?
Xiaomi 將 MiMo‑V2.6 作為開放模型家族發布,提供可下載的權重與相關研究資源。在生產規劃中,團隊仍應查閱其針對預期用途的具體模型授權與再散佈條款。
Grok 4.7 與 MiMo‑V2.6‑Pro 的每個完成代理任務成本是多少?
請標準化任務集、提示、工具許可、重試策略與成功標準。追蹤總輸入、快取輸入、推理與輸出 token、工具呼叫、延遲、重試與人工審核時間。原始 token 價格只是完成任務成本的一部分。
Grok 4.7 與 MiMo‑V2.6‑Pro 的基準比較有多可靠?
請使用相同的代碼庫或任務集、代理框架、工具、推理預算、超時、重試策略與評分規則。報告信賴區間或重複執行的變動,並將供應商發布數字與內部結果分開呈現。
Grok 4.7 對長上下文提示收費更高嗎?
SpaceXAI 文件記載,當提示 token 超過 200K 時將採用更高費率。由於較高分層適用於整個請求,使用大型代碼庫或持久代理上下文的團隊應明確建模此閾值。