Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemini 4 已經打敗 GPT-6 和 Claude Fable 5.1 了嗎?外洩的基準測試解析 new / CometAPI 研究
Gemini 4 已經打敗 GPT-6 和 Claude Fable 5.1 了嗎?外洩的基準測試解析 Gemini 4 或將在關鍵的智能體與程式設計基準測試上超越 OpenAI 的 GPT-6 Astra 和 Anthropic 的 Claude Fable 5.1,其中一些將性能提升歸因於 RSI。
Gemini 4 或將在關鍵的智能體與程式設計基準測試上超越 OpenAI 的 GPT-6 Astra 和 Anthropic 的 Claude Fable 5.1,其中一些將性能提升歸因於 RSI。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TLDR 2026 年 9 月中旬外洩的基準測試與 Arena.ai 的隱匿測試顯示,Google 尚未發佈的 Gemini 4 Pro 成為新一代領先者,在軟體工程、代理式任務、知識型工作、推理與多模態基準上凌駕 GPT-6 Astra 與 Claude Fable 5.1。
重點摘要
Gemini 4 Pro 在外洩評測中領先 DeepSWE v1.1(88.7%)、GDPval-AA v2(2064 Elo)、Terminal-bench 2.1(95.3%)、OSWorld-2.0(86.8%),以及多個其他代理/推理測試套件。在牌價上壓過 GPT-6 Astra($12/$60)與 Claude Fable 5.1($10/$50),同時匹配或超越它們的 1M 級上下文視窗。
以占位名稱(例如 gemini-3.8-flash)在 Arena.ai 進行的隱匿測試,產出了出色的 SVG、Three.js 與代理式程式設計展示。
RSI(遞迴式自我改進)的傳聞四起,但缺乏針對 Gemini 4 本身進行閉環自主改進的公開證據。
Google 已確認對更大型的 Gemini 4 基礎模型投入重資;公開發佈時間仍未官方定案。
CometAPI 等平台已將 Gemini、
我們對 Gemini 4 有哪些已知資訊?(洩漏、來源與已驗證脈絡) 截至 2026 年 9 月 20 日,Gemini 4 Pro 尚未獲得 Google 的官方公告、模型卡或公開 API 端點。除了 Google 早先在 2026 年 7 月財報中表述的「投資於更大型的 Gemini 4 基礎模型」之外,其餘皆來自社群洩漏、Arena.ai 盲測與流傳的基準表。
爆料者 Pankaj Kumar 與後續貼文(約在 9 月上旬至中旬)提到一個內部 Pro checkpoint,預期 10 月公開,且可能更早推出 Flash-Lite 變體。
多位開發者回報在 Arena.ai 拉取到名為「gemini-3.8-flash」(或類似占位)的高能力模型。其輸出包含複雜 SVG 生成(如踩腳踏車的鵜鶘、Three.js 的機械蝴蝶)、長且不重複的 JSON 生成,以及強勁的代理行為。有些使用者聲稱後端細節包括數百萬 token 的上下文、256k 的輸出上限、跨工作階段記憶,以及原生工具/網路能力。
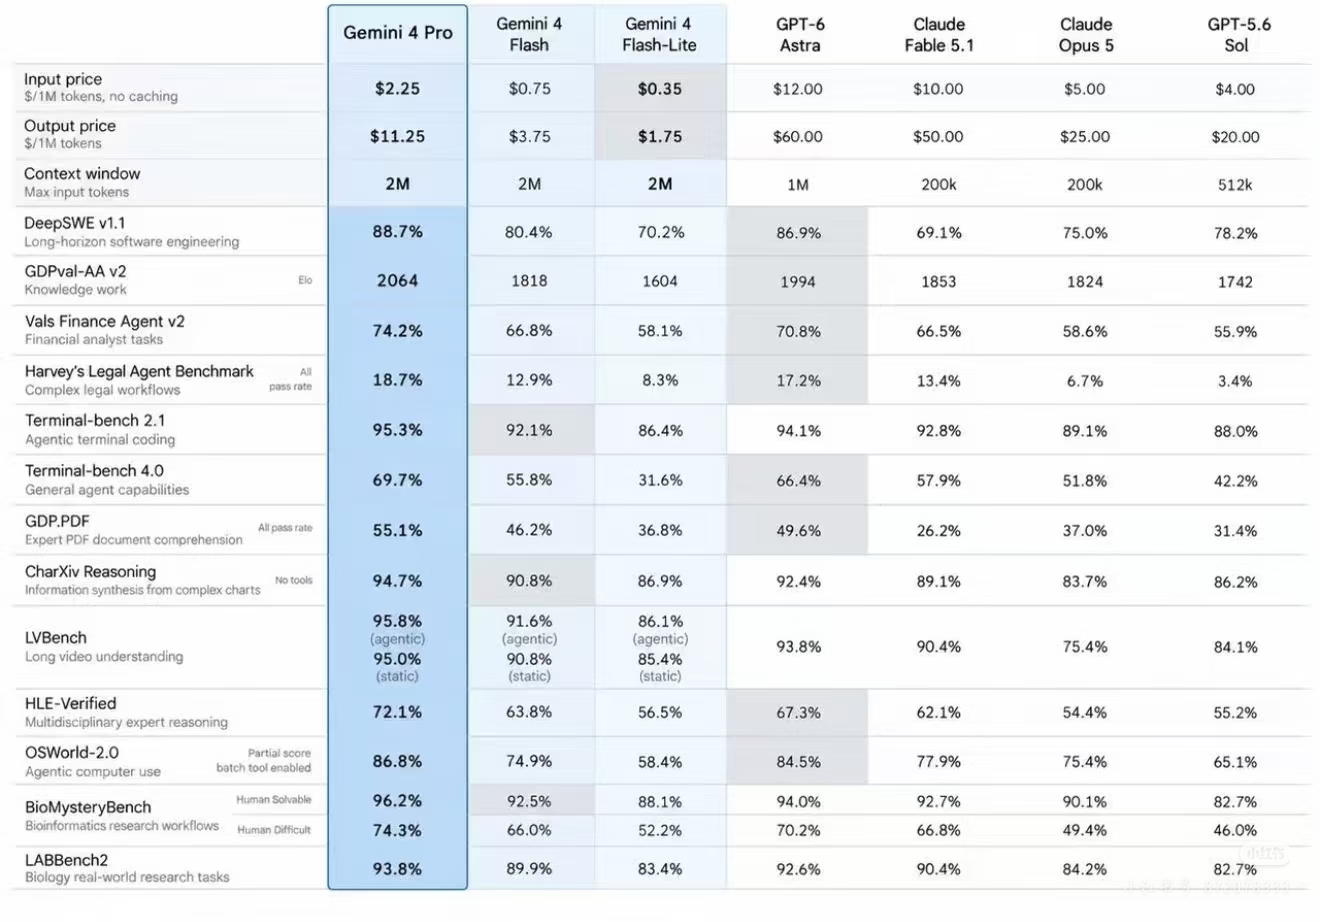
一張廣為流傳的比較表,將 Gemini 4 Pro 與 Gemini 4 Flash、Gemini 4 Flash-Lite、GPT-6 Astra、Claude Fable 5.1、Claude Opus 5、GPT-5.6 Sol 相互比較。
Google 尚未對 Arena 測試或該表格進行確認。歷史模式顯示,該公司經常在正式發表前數週於公開平台進行隱匿評估。
上下文視窗 外洩表格顯示 Gemini 4 家族最高可達 2M 的輸入 tokens——是 GPT-6 Astra 1M 的兩倍,也遠高於 Claude Fable/Opus 5 系列的 200k(部分 Claude 變體曾透過其他機制提供更大的有效視窗)。另有幽靈路由聲稱高達 10M 的上限;目前未獲證實。
Gemini 4 的價格(外洩數據)
Gemini 4 Pro:每 1M tokens $2.25(輸入)/$11.25(輸出)(不含快取)。
Gemini 4 Flash:$0.75/$3.75。
Gemini 4 Flash-Lite:$0.35/$1.75。
這些數字明顯低於 GPT-6 Astra 報稱的 $12/$60 與 Claude Fable 5.1 的 $10/$50(Fable 5.1 提供積極的快取讀取折扣,可降低代理型工作負載的有效成本)。目前官方 Gemini 3.x Pro 的定價依上下文長度不同,約在輸入 $2–$4/輸出 $12–$18 區間,因此外洩的 Pro 定價作為次世代調整並非不合理。
實際公開定價只能待發佈當天揭曉。Google 歷來以具競爭力的 token 費率與免費額度來推動採用。
Gemini 4 Pro 表現:外洩基準詳解 流傳表格將 Gemini 4 Pro 放在幾乎所有類別的最頂端。撰文時,這些數據均為「非官方、未經 Google 或獨立第三方實驗室驗證」。應將其視為方向性訊號,而非定論排名。
軟體工程與代理式程式設計
DeepSWE v1.1(長期軟體工程):88.7%(對比 GPT-6 Astra 86.9%、Claude Fable 5.1 69.1%、Claude Opus 5 75.0%)。
Terminal-bench 2.1(代理式終端程式設計):95.3%(對比 Astra 94.1%、Fable 92.8%)。
Terminal-bench 4.0(通用代理能力):69.7%(相較 Flash 與競品的最大相對差距)。
知識型工作與專業任務
GDPval-AA v2(Elo,知識型工作):2064(唯一超過 2000 的模型;Astra 1994、Fable 1853)。
Vals Finance Agent v2:74.2%。
Harvey’s Legal Agent Benchmark(複雜法律工作流程,全通過率):18.7%。
推理、多模態與專門領域
CharXiv Reasoning(從複雜圖表進行資訊綜整,無工具):94.7%。
LVBench(長影片理解):95.8% 代理式/95.0% 靜態。
HLE-Verified(跨領域專家推理):72.1%。
OSWorld-2.0(代理式電腦操作,部分分數,啟用批次工具):86.8%。
BioMysteryBench 與 LABBench2(生物資訊與生物研究工作流程):在人類可解與困難子集上均為領先分數。
若上述結果方向正確,顯示其在長期、多步驟、工具驅動的代理型工作負載上有特別優勢——正是 GPT-6 Astra 與 Claude Fable 5.1 在 9 月上旬發佈後所主打的領域。
Arena 的質性測試亦佐證此觀察:該隱匿模型在複雜 SVG 與 Three.js 生成上的作品,於社群並排比較中被評為優於或高度競爭於 Astra。
Gemini 4 將如何運作? Gemini 4(Pro)尚未發佈 ,因此任何「如何運作」的描述均基於 Google 的官方說法、關於早期內部 checkpoint 的有限外洩細節、Gemini 3.x 系列的演進軌跡與合理的工程推斷。以下內容皆不應視為已確認規格。
核心訓練與規模策略 Google 將 Gemini 4 描述為「迄今最宏大的預訓練」,建立在明顯大於前代的基礎模型之上。明確目標是保持在前沿競爭力,特別是在程式設計與自主代理方面。
更大的參數規模或更有效的容量(透過專家混合、更佳稀疏化,或更高密度的擴展)。
預訓練期間投入更高計算資源。
持續強化多模態訓練資料(文本、影像、影片、音訊、程式碼、工具使用軌跡)。
此模型預期作為新的高能力基準,未來可衍生出更快速的 Flash 風格變體。
推論與思考風格 對早期「argon」checkpoint 的外洩描述提到一種「高思考投入」模式,單次生成約耗時 2.4 分鐘,且支援顯著更高的輸出上限(據報為 256k tokens,相較先前約 64k)。
可選的高計算量推理路徑(精神上類似競品中的延展思考或「最大投入」模式)。
能在產出答案前,於困難問題上花費更多內部計算。
對長篇且連貫的輸出有更佳支持,例如完整代碼庫、多步驟計畫或冗長報告。
與現有的 Gemini Flash 模型可設定低/中/高思考等級相似,用戶很可能可以控制速度/成本與推理深度間的取捨。
主要能力重點領域
程式設計與軟體工程 更強的長期表現:跨多檔重構、跨版本庫偵錯、自我修正迴圈,以及更高的真實軟體任務完成率。
自主/代理式行為 更佳的規劃、工具使用、觀察中間結果、錯誤恢復,並在多步驟中持續朝目標前進。直接建立在 Gemini 3.5/3.8 Flash 已提供的電腦操作與代理功能之上。
長上下文可靠性 社群回報目標在 150 萬 tokens(或更高)等級。實務目標不僅是更大的視窗,還包括更佳的擷取忠實度,以及在超長文檔、代碼庫或多小時代理軌跡中較少退化。
多模態理解與生成 原生處理文本+影像+影片+音訊,預期在空間推理、影片理解與即時語音/代理互動上提升(延續 2026 年 9 月的 Gemini 3.8 Live)。
工具使用與結構化輸出 更穩健的函式呼叫、程式碼執行、搜尋落地與結構化 JSON/XML 輸出,便於整合至應用與代理。
與 Gemini 3.x 的差異
規模:明確更大的基礎模型,而非漸進式微調。
輸出容量:外洩的更高 token 上限,允許更長的單次生成。
推理深度:更明顯的高投入模式,用於處理困難問題。
代理聚焦:更強調持續、長期的自主工作,而非單輪或短期任務。
定位:旨在成為新的前沿 Pro 等級模型,Flash 系列則持續為速度與成本效率快速迭代。
與遞迴式自我改進(RSI)的關係 Google 高層公開將公司的大型 AI 資本支出與更長期的遞迴式自我改進目標連結——系統能有意義地改進自身或產出下一代系統的流程。相關研究(如 Dream-RSI 論文)顯示代理可在不改變模型權重的情況下,改進自己的探索策略。
Gemini 4 Pro 會超越 GPT-6 與 Claude Fable 5.1 嗎? 輸入/輸出價格 $2.25 / $11.25 $12.00 / $60.00 $10.00 / $50.00 Gemini 4 Pro 約比 Astra 便宜 5× 上下文視窗 2M 1M 200k 對 Gemini 具顯著優勢 DeepSWE v1.1 88.7% 86.9% 69.1% 程式設計領先 GDPval-AA v2 (Elo) 2064 1994 1853 知識型工作領先 Terminal-bench 4.0 69.7% 66.4% 57.9% 通用代理能力 OSWorld-2.0 86.8% 84.5% 77.9% 電腦操作 HLE-Verified 72.1% 67.3% 62.1% 專家級推理 LVBench(影片) 95.8% / 95.0% 93.8% 90.4% 多模態優勢 生物/實驗室研究 最高分 強勁 具競爭力 科學工作流程
重要注意事項
此表非 Google 官方發布。截止 2026 年 9 月 20 日,Google 仍未公布 Gemini 4 Pro 的模型卡、API 端點、定價或已確認的基準數據。數字來源於社群、Arena 現蹤與內部 checkpoint 洩漏(與代號「argon」相關)。
早前流傳的部分表格後來被指出為預測或部分抄錄。每個百分比與定價在 Google 證實前皆應視為「未驗證」。
此處列示的 Claude Fable 5.1 上下文視窗為 200k,低於 Anthropic 官方文件常見的 1M 數字。這可能反映特定評測設定,或是外洩表格中的誤差。
目前 GPT-6 Astra 與 Claude Fable 5.1 仍是唯一完全公開且經獨立評估的前沿模型。第三方追蹤顯示兩者整體表現仍相當接近(各有所長)。
當前實際情況(2026 年 9 月 20 日) Gemini 4 Pro 未發佈(據稱很強) 長上下文、程式設計、代理、多模態、成本 非常激進(據稱) GPT-6 Astra 已發佈 數學、電腦操作、終端、自動化、資安 高價位 Claude Fable 5.1 已發佈 長期代理、推理、程式品質、快取效率 高價位 Gemini 4 Flash / Flash-Lite 據稱為同系成員 速度與成本敏感型工作負載 極低
快速結論
在各面向占優勢 :Gemini 4 Pro 在表中每項皆排名第 1,且多數具明顯差距。特別強項 :長期程式設計/代理(DeepSWE、Terminal-bench)、知識型工作、多模態(影片+圖表)與專門領域(財經、法律、生物、電腦操作)。價格定位 :在輸入與輸出上約為 GPT-6 Astra 與 Claude Fable 5.1 的 1/5,同時取得更高分數。 Astra 著重於電腦操作、資安門檻與科學探索;Fable 5.1 著重於長時間的知識型工作與程式設計,並具有更低的快取讀取成本。Gemini 4 Pro 的外洩側寫顯示,其在廣泛的代理式軟體工程與多模態推理上最為強勢。
在等待 Gemini 4 Pro 正式開放期間,團隊可受益於已支援當前前沿(Gemini 3.x 系列、GPT-6 Astra、Claude Fable 5.1/Opus 5 與 500+ 其他模型)的統一閘道。CometAPI 正提供這樣的能力:單一相容 OpenAI 的端點、一把 API 金鑰、按量計費通常較直連供應商低 20–40%,並能以單一參數切換模型。
透過 CometAPI,在現有的 Gemini Flash/Pro、GPT-6 Astra 與 Claude Fable 5.1 上原型化代理管線。
以相同提示在多模型上跑基準,建立基線。
當 Gemini 4 Pro(及其 Flash 變體)出現在 CometAPI 型錄時——該平台歷來對 Google 新模型上架相當迅速——只需更換 model ID,即可以最小代碼改動重跑評測。
使用成本儀表板追蹤各供應商的 token 支出,將高流量或延遲敏感流量導向最經濟且能力足夠的模型。
此做法可免除多把金鑰管理、降低供應商綁定風險,並讓團隊在公開首日即可採用 Gemini 4 Pro。
若外洩資訊的方向正確,Gemini 4 Pro 將是 Google 迄今最有力的嘗試,重奪代理式軟體工程與長上下文多模態推理的前沿。其宣稱的表現、巨大上下文與激進定價組合,將使其成為許多生產工作負載的優先選項。在官方發佈與獨立評測到來前,審慎之道是持續在現有前沿模型間進行基準對照——透過已統一接入的平台可輕鬆達成。請持續關注正式公告;未來數週很可能釐清多少炒作能轉化為實際生產力。
常見問題
Gemini 4 Pro 是否已發佈? 尚未。依據最新型錄與 Google 的說法(9 月中下旬),尚未公開發佈或列示正式的模型 ID。
Gemini 4 Pro 預計何時發佈? 爆料指出為 2026 年 10 月(也有 9 月下旬猜測)。Google 尚未給出官方日期。請視為待確認的時間窗,等待 API 型錄或部落格文章宣布。
Google 是否已以 Gemini 4 Pro 達成 RSI? 公開證據顯示已有進階的代理迴圈用於模型改進,以及關於策略層級遞迴改進(如 Dream-RSI)的研究。尚無獨立驗證支持「由完整 RSI 產出該模型」的主張。
與 GPT-6 Astra 與 Claude Fable 5.1 在基準上如何比較? 社群外洩圖表宣稱在多個代理/程式設計套件領先。針對已發佈的 Gemini 4 Pro 尚無官方獨立分數。當前公開資料仍建議以實際任務對已上線的 Astra 與 Fable 5.1 做評估。
是否應該等 Gemini 4 Pro 再開始開發? 不必。先以當前最強的可用模型上線(透過 CometAPI 或直接 API),維持評估集就緒,當新模型出現且經獨立與內部測試證實值得切換時再採用。
哪裡可以輕鬆存取當前前沿模型? CometAPI 等統一供應商提供相容 OpenAI 的存取,涵蓋 GPT-6 Astra 級、Claude Fable 5.1、現有 Gemini 與其他模型,並簡化計費與切換。請查閱即時型錄與文件以取得最新的 ID 與定價。