

人工智慧 (AI) 徹底改變了數位影像的創作,只需點擊按鈕即可產生逼真的場景、肖像和藝術品。然而,這種快速進步也引發了一個關鍵問題:我們如何區分真實的照片和人工智慧產生的圖像?隨著人工智慧系統變得越來越複雜,「真實」和「合成」之間的界線變得模糊,這對記者、法律專業人士、數位藝術家和日常用戶都構成了挑戰。在本文中,我們綜合了最新發展和專家見解,提供了評判 AI 圖像的全面指南。
是什麼讓人工智慧生成的影像難以偵測?
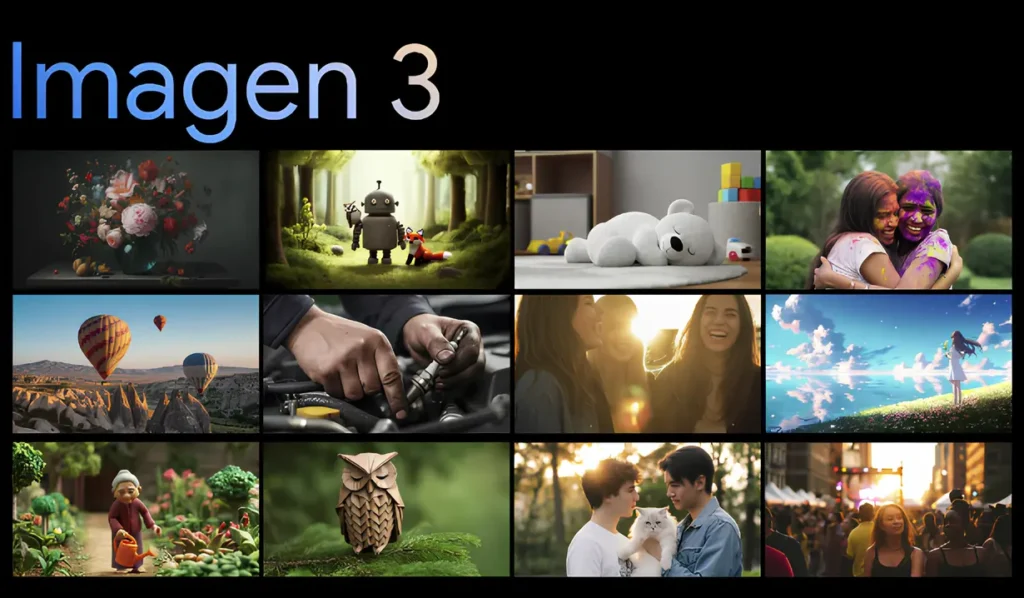
人工智慧生成的圖像是由強大的生成模型(例如擴散網路和生成對抗網路 (GAN))生成的,這些模型學習模仿真實世界照片的統計模式。最近的研究表明,這些模型可以產生複雜的紋理、精確的照明和逼真的反射,因此表面分析是不夠的。
語意合理性與像素級偽影
雖然早期人工智慧生成的圖像經常會出現明顯的瑕疵(例如不匹配的陰影或扭曲的背景),但現代模型克服了許多此類缺陷。相反,它們引入了更微妙的不一致性,例如背景中略微扭曲的文本或手上異常的手指計數,只有通過詳細的法醫分析才能檢測到。這種語義差異需要檢查高級內容(例如,物件關係),而不是僅依賴像素級線索。
分佈相似性和過度擬合
先進的檢測器利用了這樣一個事實:人工智慧生成的圖像源自於一組有限的訓練分佈。例如,事後分佈對齊 (PDA) 方法將測試影像與已知的虛假分佈對齊以標記異常 - 該技術在多個模型系列中實現了 96.7% 的準確率。然而,當面對新的生成架構時,偵測器可能會失敗,這凸顯了持續更新和廣泛訓練資料集的必要性。
有哪些工具和方法可用於檢測?
各種商業和開源工具已經出現以應對檢測挑戰,每種工具都利用不同的分析策略——從元資料檢查到深度學習推理。