Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog 如何在本地部署 Qwen 3.8 Max:硬體、vLLM、SGLang 與量化指南
guide / CometAPI 研究
如何在本地部署 Qwen 3.8 Max:硬體、vLLM、SGLang 與量化指南 如何在本地使用 Qwen3.8-2.4T-A95B 開源權重部署 Qwen 3.8 Max,包含 GPU 需求、FP8/FP4、vLLM、SGLang、1M 上下文,以及生產級優化。
Deon Goodwin AI 模型與 API 研究團隊 如何在本地使用 Qwen3.8-2.4T-A95B 開源權重部署 Qwen 3.8 Max,包含 GPU 需求、FP8/FP4、vLLM、SGLang、1M 上下文,以及生產級優化。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)在本地執行 Qwen3.8-Max 現已可行,但「Qwen 3.8 Max 本地化」這一表述需要一個重要澄清。Alibaba 託管的 Max 產品與可下載的檢查點關係密切,但它們並非相同產品。
Qwen 於 2026 年 8 月上旬率先推出託管版 Max 服務,並於 2026 年 8 月 12 日 釋出 Qwen3.8-2.4T-A95B 為開放權重。該檢查點才是你實際在自有基礎設施上部署的模型。
這不是一篇把 Ollama 裝在遊戲 PC 上的普通教程。未量化的檢查點是一個 2.4 兆參數的 MoE 模型,當前 vLLM 配方估算其 BF16 權重約為 4.45 TiB。即便是面向生產的 4 位元浮點變體,權重仍約為 1.3–1.5 TiB。
**快速答案:**完整的 Qwen 3.8 Max 級自託管屬於資料中心級部署。一個實際可行的生產起點是使用 8× B300 或 8× MI355X GPU 的 FP4 檢查點 ;H200 部署需要更多 GPU。普通工作站則選擇 Qwen3.8-27B。
Qwen 3.8 Max 與實際可部署的開放模型
可下載的 Qwen3.8-2.4T-A95B 檢查點官方描述為一個 2.4T 參數的因果語言模型,每個 token 啟用約 95B 參數。託管版 Max 服務則增加了目前開放檢查點所不具備的產品層功能。
總參數量 2.4T 2.4T 啟用參數量 ~95B ~95B 架構 稀疏 MoE 稀疏 MoE 輸入 文字、影像、影片 文字 上下文 1M 託管上下文 原生 262,144;可擴展至 ~1.01M 思考行為 託管思考/無思考選項 需要思考;可配置推理強度 內建工具 託管服務可用 應用需自行提供工具 自行託管 不需自行管理權重 需要;開放檢查點
託管產品提供文字、影像與影片輸入,以及 1,000,000 token 的上下文。相較之下,開放檢查點僅支援文字,且原生上下文為 262,144 token。若你的應用依賴多模態輸入或託管的內建工具,這一差異至關重要。
Qwen 3.8 架構與規格 CometAPI 已在「What is Qwen3.8 Max」中介紹了模型背景,因此本部署指南僅聚焦於影響記憶體、平行度與服務的架構細節。
總參數 / 啟用參數 2.4T / 每 token ~95B 層級佈局 92 層:69 Gated DeltaNet + 23 全注意力 MoE 路由 512 個路由專家;啟用 10 個路由 + 1 個共享專家 全注意力頭數 64 個 query / 4 個 key-value 頭 原生上下文 262,144 tokens 擴展上下文 約可達 1,010,000 tokens 多詞元預測 支援 開放檢查點模態 僅文字
不要把「95B 啟用參數」誤解為 95B 模型的記憶體足跡。稀疏激活能降低每 token 計算量,但服務系統仍需能存取完整的專家權重集合。
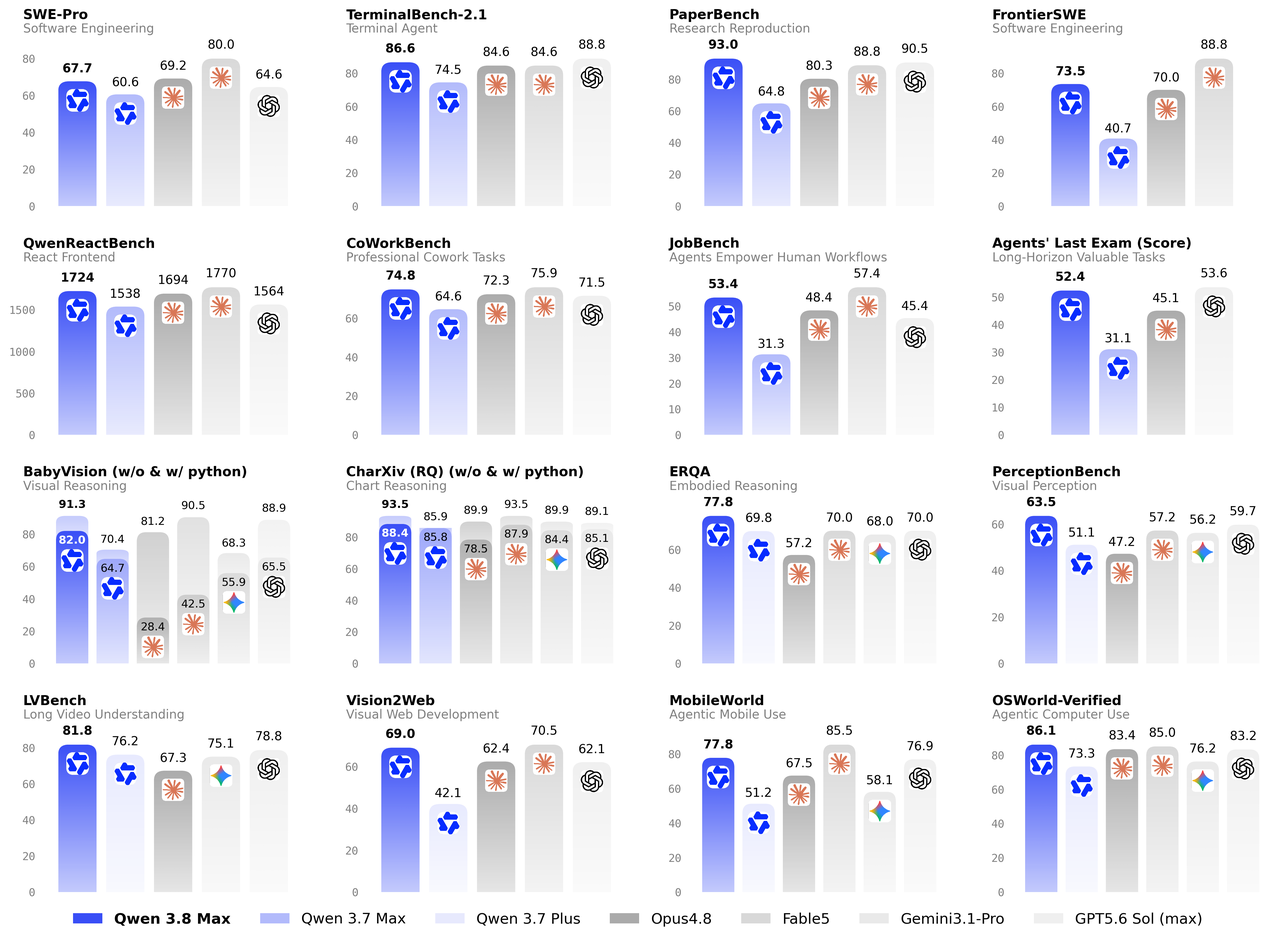
Qwen 3.8 Max 基準測試快照 由於 CometAPI 的 Qwen3.8 Max 概覽已詳細討論了基準,本篇僅採用官方模型卡表格中與部署相關的子集。
Terminal Bench 2.1 86.6 74.5 88.8 SWE-bench Pro 67.7 60.6 64.6 PaperBench 93.0 64.8 90.5 FrontierSWE 73.5 40.7 — CoWorkBench 74.8 64.6 71.5 GPQA Diamond 92.6 92.4 94.1
Qwen 官方釋出的 Qwen3.8 效能圖,來源: Qwen 團隊 。
在此子集中,相對 Qwen3.7-Max 的最大提升發生在 PaperBench 與 FrontierSWE。Qwen3.8-Max 在 SWE-bench Pro 與 PaperBench 上也超過了 GPT-5.6 Sol,而 GPT-5.6 Sol 在 Terminal Bench 2.1 上仍領先。對部署決策而言,將這些視為能力背景;下文的記憶體與服務吞吐量測量更具操作相關性。
基準表並非通用排名。測試框架、超時、上下文限制、工具存取與量化都會影響結果。請以你計畫使用的確切檢查點、精度、服務引擎以及提示分佈進行基準測試。
Qwen3.8 本地部署需要哪些硬體?
Qwen3.8-2.4T-A95B 的 GPU 需求 BF16 4.45 TiB 24 GPUs 24 GPUs 48 GPUs 最高保真度 / 研究 FP8 2.27 TiB 16 GPUs 16 GPUs 32 GPUs 高保真生產 MXFP4 1.45 TiB — 8 GPUs 16 GPUs 實用的 AMD 部署 NVFP4 W4A4 1.32 TiB 8 GPUs — 16 GPUs 實用的 NVIDIA 部署
對大多數確有自託管 Qwen3.8 需求的組織而言,FP4 是實用的起點。突出的 NVIDIA 配置是 8× B300 上的 NVFP4 W4A4 ;相應的 AMD 路線是 8× MI355X 上的 MXFP4。
一臺 8× H200 伺服器不足以滿足上述完整模型部署。官方配方目前將 H200 尺寸定為 FP4 需 16 張、FP8 需 32 張、BF16 需 48 張。
Qwen3.8-27B 的 VRAM 需求 Qwen3.8-27B 是實際可行的工作站級替代方案。原始權重記憶體約為 BF16 54 GB、FP8 27 GB、4 位元 13.5 GB。執行時額外開銷與 KV 快取會提高實際需求,尤其在長上下文下。
BF16 ~54 GB 視上下文與服務開銷選擇 64–80 GB GPU。 FP8 / INT8 ~27 GB 40–48 GB GPU 可提供更充裕的執行時餘量。 4-bit ~13.5 GB 在中等上下文長度下,20–24 GB 消費級 GPU 具有可行性。
上述數字是依參數量推估的規劃值。請在生產規模前確認實際檢查點、量化格式、服務引擎、上下文長度與 KV 快取設定。
Qwen3.8 能在消費級 GPU 上運行嗎? 完整的 Qwen3.8-2.4T-A95B 即便在激進量化下,也不適合於普通消費級 GPU。一個社群專案曾展示過將 UD-Q1_0 極致壓縮至 397 GB 並分散於四套 DGX Spark 系統,但這是實驗性的極端量化,並非面向品質敏感服務的基準路徑。
對於工作站或個人實驗室,更合適的模型是 Qwen3.8-27B,其開放權重於 2026 年 8 月 14 日釋出。該模型的託管難度低數個數量級,如果「本地」指的是一臺工作站,這才是正確選擇。
安裝 Qwen 3.8 Max 之前 uv venv
source .venv/bin/activate
uv pip install -U vllm \
--extra-index-url https://wheels.vllm.ai/nightly
uv pip install -U "transformers>=5.4.0"
如何使用 vLLM 部署 Qwen 3.8 FP8 對於兩節點、16 GPU 的 B300 級部署,在首節點執行:
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
不要將這個 16 GPU 的示例直接照搬到 H200 伺服器而不調整拓撲。相同 FP8 變體在 vLLM 配方中目前為 32× H200 的尺寸。
如何在單臺 8× B300 伺服器上運行 Qwen 3.8 對於 NVIDIA Blackwell,最實用的完整模型配置是 NVFP4。vLLM 目前在 8 張 B300 上以張量並行驗證了 NVFP4 W4A4。
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Inferact 的 NVFP4 構建是量化檢查點,而非原始的 BF16 Qwen 成品。請在自有驗收集上驗證模型品質,再將其視為 BF16 或 FP8 的可替代品。
如何使用 SGLang 部署 Qwen 3.8 SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
--trust-remote-code \
--model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
--tp-size 8 \
--context-length 200000 \
--preferred-sampling-params '{"top_k": 20}' \
--attention-backend trtllm_mha \
--linear-attn-prefill-backend flashinfer \
--linear-attn-decode-backend flashinfer \
--reasoning-parser qwen3 \
--tool-call-parser qwen3_coder \
--host 0.0.0.0 \
--port 30000
SGLang 報告在啟用 MTP、TP8 B300、批次大小為 1 時,可達 346 輸出 token/s,且在解耦式服務佈局中總吞吐量顯著更高。請將這些數值視為服務棧測量,而非模型品質基準。
測試本地的 OpenAI 相容端點 vLLM 與 SGLang 均提供 OpenAI 相容 API,便於應用整合。
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
官方模型卡建議將 temperature 設為 1.0、top_p 設為 0.95、top_k 設為 20 作為基準採樣參數。對於代理型任務,請為推理留出足夠的輸出預算,而不是僅按最終可見答案來設定 max_tokens。
啟用 1M 上下文視窗 VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
--max-model-len 1010000 \
--hf-overrides '{"max_position_embeddings": 1010000}' \
--reasoning-parser qwen3 \
...
不要僅因為支援就把 1M 設為預設。越大的最大上下文會預留更多快取容量,並可能明顯降低併發度。請將 --max-model-len 設為符合實際工作負載的值。
如何提升 Qwen3.8 推理效能?
使用 MTP-3 降低單用戶延遲 Qwen3.8 支援多詞元預測。在 vLLM 公布的測量中,對 FP8 TP16,MTP-3 可將單用戶輸出從 130 提升至 307 tok/s ;對 NVFP4 TP8,則從 133 提升至 304 tok/s。
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
使用 fastsafetensors 加速啟動 對 TB 級模型而言,啟動時間很重要。在某次 vLLM 測量中,結合 fastsafetensors 與懶加載後,權重載入時間從 545 s 降至 306 s。
--load-format fastsafetensors \
--safetensors-load-strategy lazy
使用專家並行以提高併發吞吐量 在高併發下,Qwen3.8 受惠於專家並行佈局,因為它擁有 512 個路由專家。vLLM 報告對 FP8 EP 可達 每 GPU 3,200 總 tok/s ,對經優化的 NVFP4 DEP16 佈局可達每 GPU 4,300 總 tok/s。
設定 --max-model-len 以平衡 VRAM 與併發 將 --max-model-len 設為工作負載真正需要的最長序列。值越大會預留越多 KV 快取容量,增加記憶體壓力,並可能降低併發數,即使模型權重已經裝入。
從具代表性的生產分位數起步,而非模型宣稱的最大上下文。用相同精度、批次模式與服務引擎進行壓測,僅在實際請求需要時再提高上限。
Qwen 3.8 本地部署 vs. API 開放權重並不自動意味著本地推理更經濟。正確決策取決於利用率、資料駐留、團隊人力、可用性目標,以及你是否真的需要託管模型的多模態功能。
基礎設施 多 GPU 伺服器或叢集 無需 GPU 基礎設施 輸入模態 文字 文字、影像、影片 上下文 原生 262K;擴展約 ~1.01M 託管 1M 資料控制 最大化 雲端 API 營運 你負責監控、升級與高可用 由供應商託管 最佳適用 資料駐留、持續高利用率、有基礎設施團隊 多數應用團隊與變動工作負載
Qwen 3.8 本地部署常見問題
伺服器在啟動期間耗盡 GPU 記憶體 若是快取所致,請先降低 --max-model-len。若是權重本身裝不下,減少上下文無法解決根因;請改用經驗證的低精度檢查點或增加 GPU。
張量並行因大小無效而失敗 Qwen3.8 在其全注意力層具有 64 個注意力頭,因此 vLLM 要求 TP 能整除 64 。直接的 TP 尺寸為 1、2、4、8、16、32。僅有總 VRAM 並不足以決定拓撲。
伺服器啟動耗時很長 載入數 TB 權重再加上核心 JIT 需要數分鐘。提高 VLLM_ENGINE_READY_TIMEOUT_S,並探測真實推理端點,而非假設短啟動視窗。
本地模型無法處理影像 這是預期行為。Qwen3.8-2.4T-A95B 開放檢查點僅支援文字。這一限制特定於 Qwen3.8-2.4T-A95B。Qwen3.8-27B 在載入其獨立的視覺投影檔案後可支援視覺輸入。
1M 上下文顯著降低吞吐量 將 --max-model-len 調低到工作負載真正需要的最長序列。最大支援上下文不一定是最佳生產設定;請在工作負載需求、KV 快取使用與併發之間取得平衡。
Ollama 或 LM Studio 能跑 Qwen 3.8 Max 嗎? 生態系可將高度量化的 Qwen3.8 權重包裝為類 llama.cpp 的推理,但這不能與普通桌面級的 Ollama 工作流混為一談。即便量化後仍需數百 GB 的構建,依然需要數百 GB 可用記憶體,且在品質與效能上存在重大取捨。
對於一般本地開發,Qwen3.8-27B 才是合適目標。即便社群極端量化在非常規硬體上讓完整 2.4T 模型「技術上可啟動」,它仍應被視為伺服器/叢集級模型。
應選擇哪種部署方式? 對 NVIDIA Blackwell,目前最乾淨的完整模型起點是 8× B300 的 NVFP4 部署。對 AMD,對應的實用配置是 8× MI355X 的 MXFP4。當你優先考慮檢查點來源與品質而非基礎設施規模時選擇 FP8;只有在最大保真度足以支撐多機櫃級記憶體需求時才選 BF16。
結論 自最初的 API 上線以來,Qwen3.8-Max 已跨過重要門檻:Qwen 的 Max 級家族現已擁有可在自有基礎設施上完全運營的開放 2.4T 檢查點。
但開放權重並不意味著消費級硬體可用。4.45 TiB 的 BF16 佔用、2.27 TiB 的 FP8 檢查點與 1.3–1.5 TiB 的 FP4 變體,使 Qwen3.8-2.4T-A95B 成為最吃基礎設施的開源模型之一。其實用的好處是 vLLM 與 SGLang 已支援該架構,而 FP4 讓單節點的 8× B300 或 8× MI355X 部署成為可能。
當資料控制、持續高利用率與基礎設施所有權足以支撐叢集時,選擇自託管;否則,使用託管的 Max API——若你真正需要的是能在單臺工作站上運行的強力 Qwen 模型,則選擇 Qwen3.8-27B。