
TL;DR
DeepSeek-V4.1-Flash 為開放權重且可自行託管,但「本地」不意味著「在遊戲電腦上」。DeepSeek 將其描述為採用因果式編碼器-解碼器(CED)架構的 552B 參數混合專家(MoE)骨幹,在提示處理期間僅有 8B 參數活躍、生成期間為 16B。完整模型仍是前沿級部署目標。
目前 vLLM 部署配方將檢查點估計為 磁碟約 511 GB、最低 VRAM 約 614 GB,因此使用 8×H200 級伺服器或可比的高記憶體系統要遠比消費級工作站現實得多。
對只需存取而非權重級控制的團隊而言,CometAPI 中的 DeepSeek V4.1 Flash API 比維護多 GPU 推理伺服器簡單得多。
Key Takeaways
- DeepSeek-V4.1-Flash 使用 552B MoE 骨幹,提示預填期間 8B 活躍參數、解碼期間 16B;活躍參數不代表常駐記憶體需求。
- 其 1,048,576-token 上下文與每 token 890 位元組的全域 KV 快取降低快取壓力,但模型權重仍主導容量規劃。
- 官方檢查點約 511 GB。vLLM 配方估算載入模型與執行時開銷至少需約 614 GB 可用 VRAM;此為基線估計,並非對所有批次大小、上下文長度或多模態設定的保證。
- vLLM 是最清晰的生產服務路徑,SGLang 針對進階分散式推理;Ollama 目前路徑為雲端託管而非完整本地推理。
- 自行託管在隱私、隔離環境、權重級研究或持續叢集利用上最具吸引力;多數開發者會覺得使用託管 API 更簡便。
What Is DeepSeek-V4.1-Flash? Architecture, Parameters, and Model Size
DeepSeek 於 2026 年 9 月 10 日正式發佈 V4.1-Flash,為其新架構家族中最小的模型,具備原生視覺理解。儘管名為「Flash」,它並非小型稠密模型。
其關鍵架構變革是 因果式編碼器-解碼器(CED)設計。模型在提示攝取與 token 生成之間以非對稱方式分配計算量,降低活躍計算,同時保留非常大的專家池。
| Specification | DeepSeek-V4.1-Flash |
|---|---|
| Architecture | 多模態 MoE,採用因果式編碼器-解碼器 |
| Backbone parameters | 552B |
| Active parameters, input | 8B |
| Active parameters, output | 16B |
| Transformer layers | 40:20 個編碼器 + 20 個解碼器 |
| Context window | 1,048,576 tokens |
| Global KV cache | 890 bytes/token |
| Modalities | 文本 + 圖像輸入,文本輸出 |
| Weight license | MIT |
| Recommended sampling | Temperature 1.0;top_p 0.95 或 1.0 |
| Official weights | Hugging Face |
| Primary local serving options | vLLM、SGLang、DeepSeek 參考推理 |
區分活躍參數與常駐參數至關重要。MoE 路由可減少單個 token 的運算量,但伺服器仍需能存取可能被選中的專家權重。因此,即使「8B 活躍」的模型也可能需要數百 GB 的儲存與加速器記憶體。
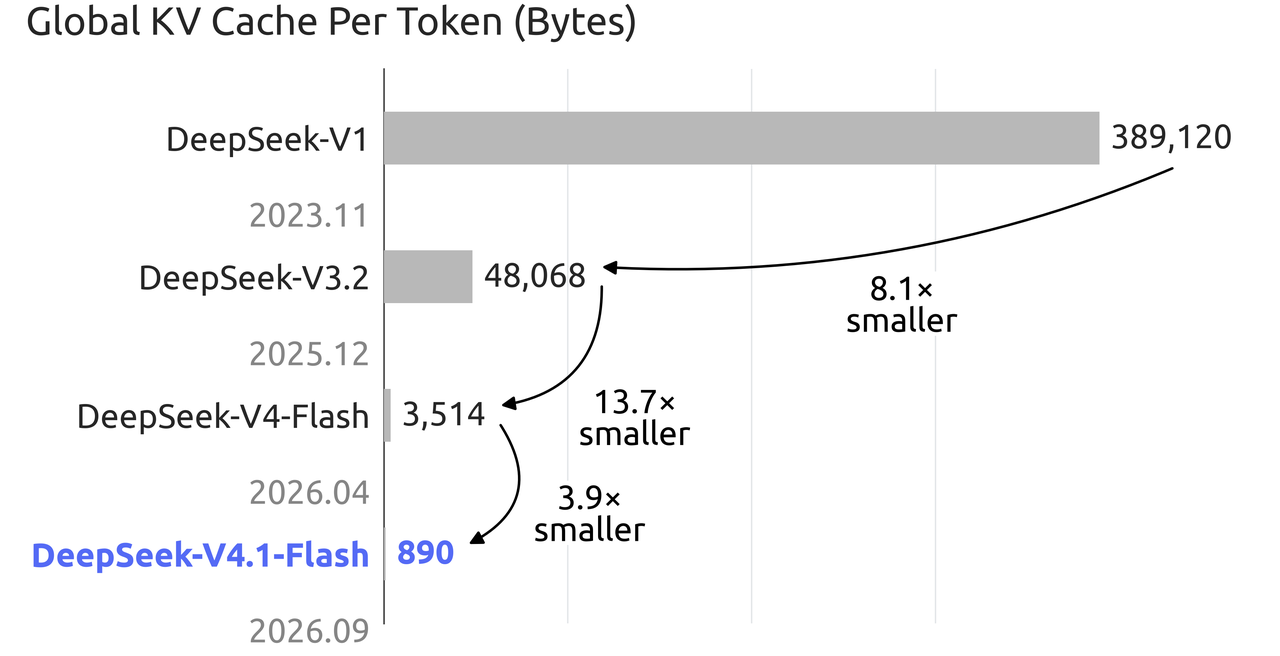
DeepSeek 的官方 KV 快取圖顯示,V4 Flash 的全域快取從每 token 3,514 bytes 降至 V4.1 Flash 的 890 bytes,約降低 3.9×。這對百萬 token 推理很重要,但並不消除模型權重本身造成的更大記憶體需求。
How Good Is DeepSeek-V4.1-Flash Before You Deploy It?
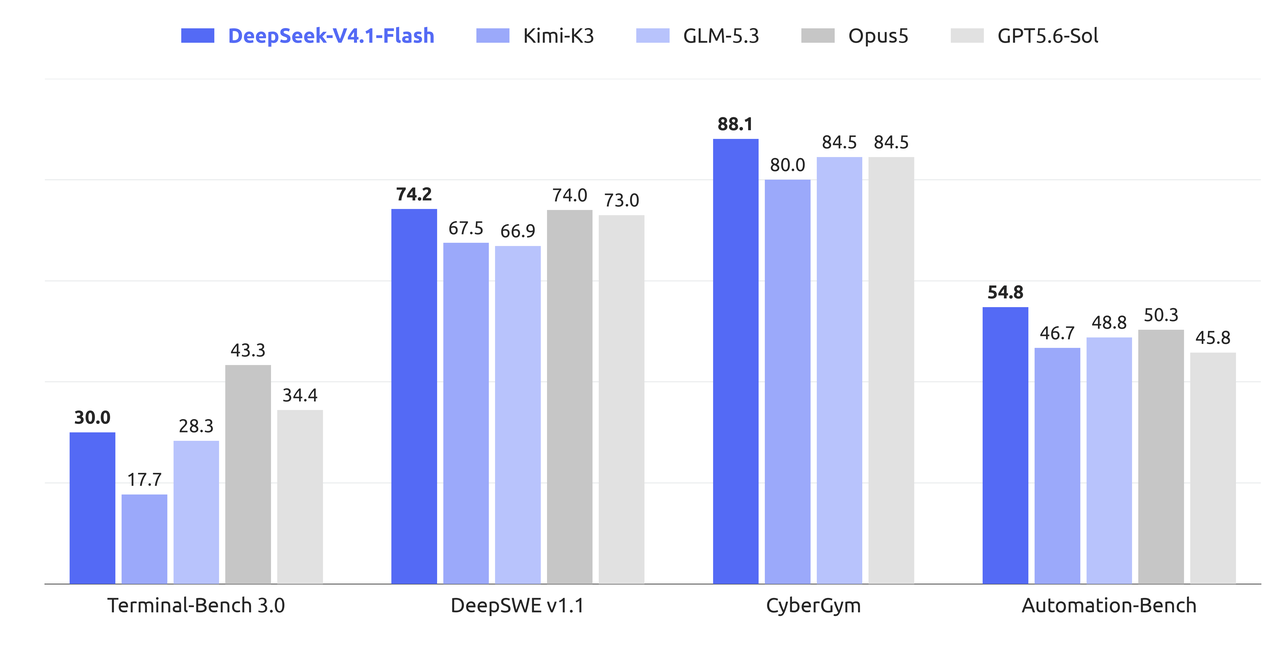
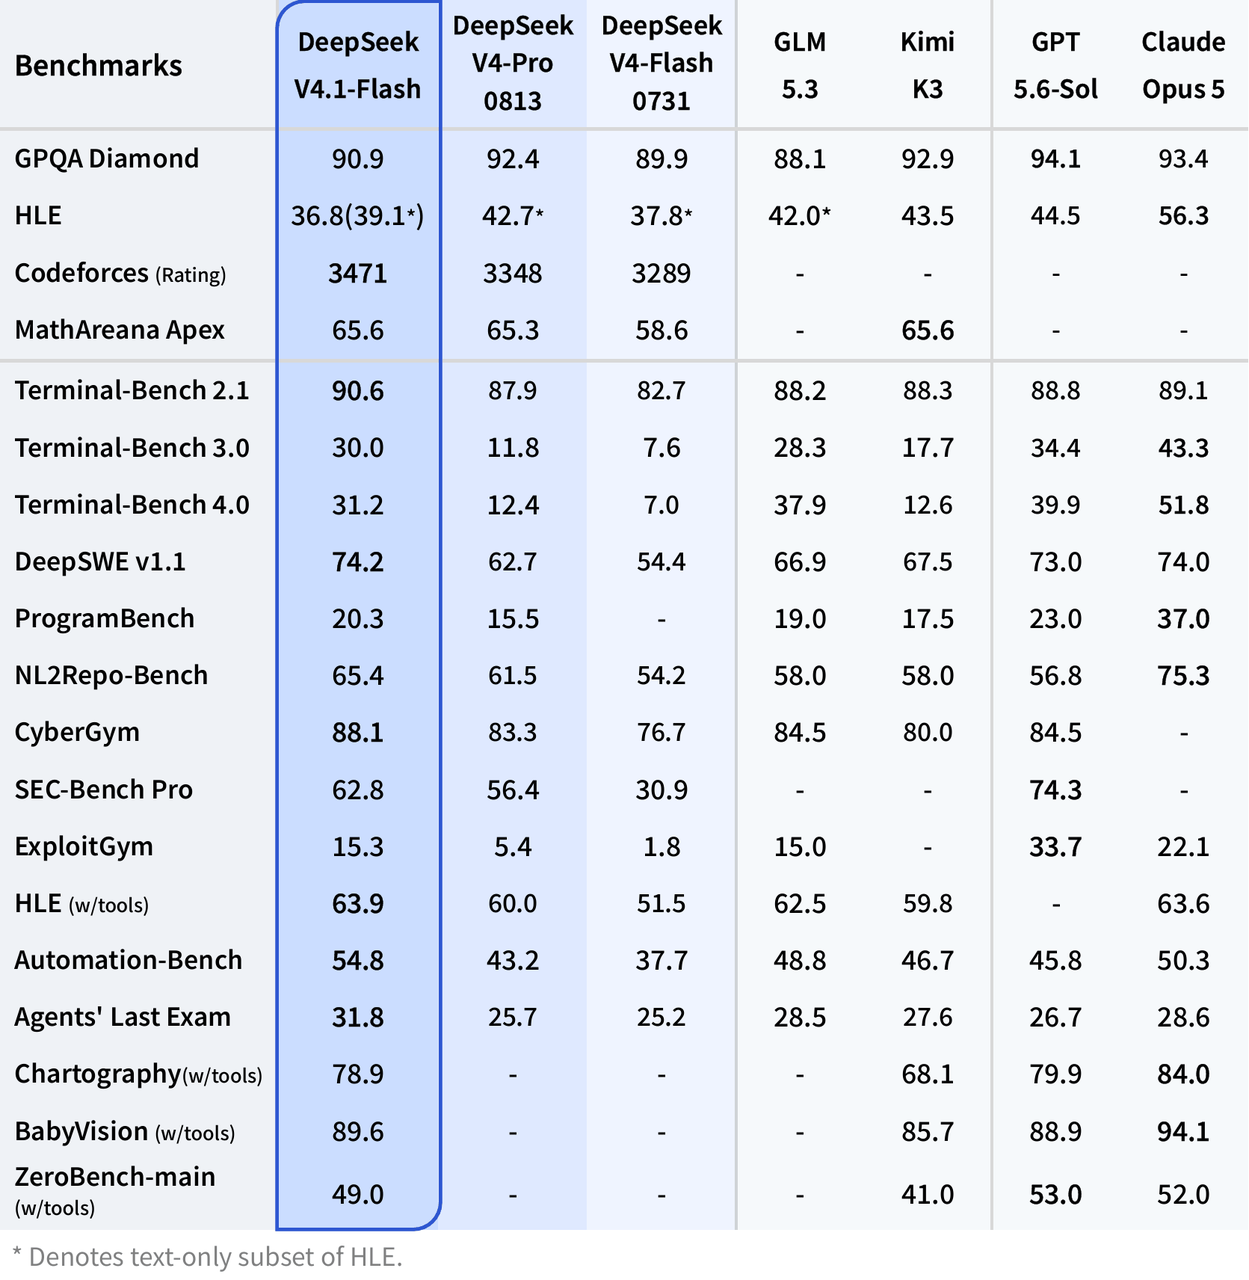
DeepSeek 發佈的基準測試表主要將 V4.1-Flash定位為在智能編碼、終端操作、自動化與軟體工程工作負載上的重大升級。這些是供應商報告的基準結果,應視為參考量測,而非保證的應用效能。
為了可重現性,官方模型卡建議 Temperature 1.0 與 top_p 0.95,而推理努力與 token 預算因評測而異。下列數據為供應商執行的參考結果,非硬體中立的效能保證;再現前應查閱各基準的測試框架細節。
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
模式比任何單一分數更重要。V4.1-Flash 並非在每項基準都領先,但相較 V4 Flash 0731,在 Terminal-Bench、DeepSWE、自動化與網安工作負載上的躍升尤其巨大。這使本地部署對私有編碼代理、倉庫級分析、內部自動化與隔離代理基礎設施尤為相關。
Can You Really Run DeepSeek-V4.1-Flash Locally?
可以,但「本地」一詞需加以限定。最新 vLLM 的 DeepSeek-V4.1-Flash 配方將檢查點分解為約半個 TB,並在計入執行時開銷後建議更大的 VRAM 預算。
| Component | Approximate stored size |
|---|---|
| 路由 + DSpark 專家 | 259.5 GiB |
| Engram 表 | 183.1 GiB |
| Attention、稠密投影與路由器 | 6.9 GiB |
| 詞嵌入、LM head 與正規化 | 3.9 GiB |
| UE8M0 區塊縮放 | 21.9 GiB |
| 完整檢查點 | ~476 GiB / ~511 GB |
| vLLM 建議的最低 VRAM 預算 | ~614 GB |
關鍵驚喜在於 V4.1-Flash 的內部已相當壓縮。路由專家權重使用低精度格式,因此官方檢查點並非簡單的巨大 BF16 模型,等待直接轉換為 4-bit。
DeepSeek-V4.1-Flash Hardware Requirements
| 硬體組態 | 實務狀態 | 備註 |
|---|---|---|
| 1× RTX 4090 / 5090 | 不可行 | 遠低於模型的記憶體占用 |
| 2–4 張消費級 GPU | 對官方完整檢查點而言不可行 | 聚合 VRAM 仍不足 |
| 128 GB 工作站 | 不可行 | 活躍參數不決定常駐權重記憶體 |
| 256 GB 工作站 | 官方服務路徑不可行 | 仍遠低於官方檢查點體量 |
| 512 GB 系統 RAM + GPU 卸載 | 實驗性 | 社群/卸載路線,非等同於經驗證的生產服務 |
| 4× 高記憶體資料中心 GPU | 取決於硬體 | 若加速器足夠大則可能;請檢查執行時配方 |
| 8× H200 | 可行,已有文檔等級 | 約 1,128 GB 聚合 HBM |
| GB200 NVL4 級系統 | 可行 | vLLM 指出 768 GB 托盤可容納該模型 |
重要:8B 活躍參數不意味著 8 GB VRAM。「活躍」描述的是每個 token 計算期間參與的 MoE 網路部分。完整專家集仍必須存放於推理引擎可存取的地方。
Which Runtime Should You Use for DeepSeek-V4.1-Flash?
| Runtime | 目前 V4.1-Flash 狀態 | 最佳用途 |
|---|---|---|
| vLLM | 提供當前部署配方;需使用近期映像 | 生產級、OpenAI 相容服務 |
| SGLang | 透過當前 DeepSeek-V4.1 部署版本支援 | 高效能分散式推理 |
| DeepSeek reference inference | 官方 TP8 參考實作 | 架構研究與驗證 |
| Transformers | 於 Hugging Face 提供模型整合 | 開發與試驗;仍需硬體 |
| Ollama | 官方庫路徑目前使用 :cloud | 便利的雲端呼叫,非等同自託管 |
對生產級自託管而言,vLLM 目前是最清晰的起點。SGLang 部署指南提供另一條受支援的進階分散式推理路徑。
How to Run DeepSeek-V4.1-Flash Locally with vLLM
這是多 GPU Linux 伺服器的務實路線。
以下所有命令範例均已重排為語言特定的程式碼區塊並附簡明英文描述。
Step 1: Check Your Environment
- Linux。
- Docker。
- NVIDIA Container Toolkit。
- 數百 GB 的可用 SSD 空間。
- 受支援的多 GPU 組態。
- 目前官方權重服務設定需約 614 GB 可用加速器記憶體總量。
- 若未本地快取模型,需快速網路。
Step 2: Download the DeepSeek-V4.1-Flash Weights
官方權重以 MIT 授權托管於 DeepSeek-V4.1-Flash 的 Hugging Face 倉庫。
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
確保保存 ~/.cache/huggingface 的檔案系統有遠超過 511 GB 的可用空間。暫存檔與額外引擎產物可能增加峰值磁碟使用。
Step 3: Start DeepSeek-V4.1-Flash with vLLM
依目前 vLLM 配方,DeepSeek-V4.1 支援需要足夠新的 vLLM 映像。僅文本的八 GPU 起始組態如下:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
此處有兩個刻意的設定。首先,--language-model-only 會在僅文本工作負載下停用視覺編碼器。其次,先以 131,072 tokens 啟動比立即開啟百萬 token 上下文更安全。伺服器穩定後可提高:
--max-model-len 1048576
適當的張量平行設定取決於加速器拓撲,請勿盲目將 --tensor-parallel-size 8 套用於所有伺服器。
Step 4: Test the Local DeepSeek-V4.1-Flash Endpoint
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Step 5: Call Your Local DeepSeek-V4.1-Flash Server with Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
How Do You Enable DeepSeek-V4.1-Flash Thinking Mode Locally?
V4.1-Flash 透過其聊天模板支援顯式推理控制。範例如下:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
若模型在較小的 max_tokens 值下似乎返回很少或沒有最終內容,請檢查是否思考模式正在消耗生成預算,再判定部署是否故障。
How Do You Run DeepSeek-V4.1-Flash with Reference Code?
DeepSeek 在模型倉庫中亦包含一個最小化 TP8 推理實作。它主要作為可讀參考程式碼,而非高吞吐量生產伺服器。
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
此路線可用於檢視 CED、MoE 路由、Engram 記憶、推測式解碼與相關實作細節。對一般生產服務而言,vLLM 或 SGLang 更易操作。
Can You Run DeepSeek-V4.1-Flash Locally with Ollama?
不能等同於運行常見的 7B 或 32B Ollama 模型。Ollama 目前透過:
ollama run deepseek-v4.1-flash:cloud
關鍵是 :cloud。目前 Ollama 庫項目使用雲端路徑,因此此命令並非等同於下載完整模型並完全在你的機器上推理。
DeepSeek-V4.1-Flash Local Deployment vs API: Which Makes More Sense?
| 維度 | 本地 DeepSeek-V4.1-Flash | 託管 API |
|---|---|---|
| 前期硬體 | 非常高 | 無 |
| 加速器記憶體 | ~614 GB 的官方務實目標 | 由供應商管理 |
| 模型控制 | 完整 | 受限 |
| 數據留在本地 | 是 | 否 |
| 權重修改 | 是 | 否 |
| 維護 | 你的責任 | 由供應商管理 |
| 設置複雜度 | 高 | 低 |
| 擴展性 | 需要基礎設施 | 基於 API |
| 最適用於 | 隔離、私有、研究、高利用率叢集 | 多數開發者與生產應用 |
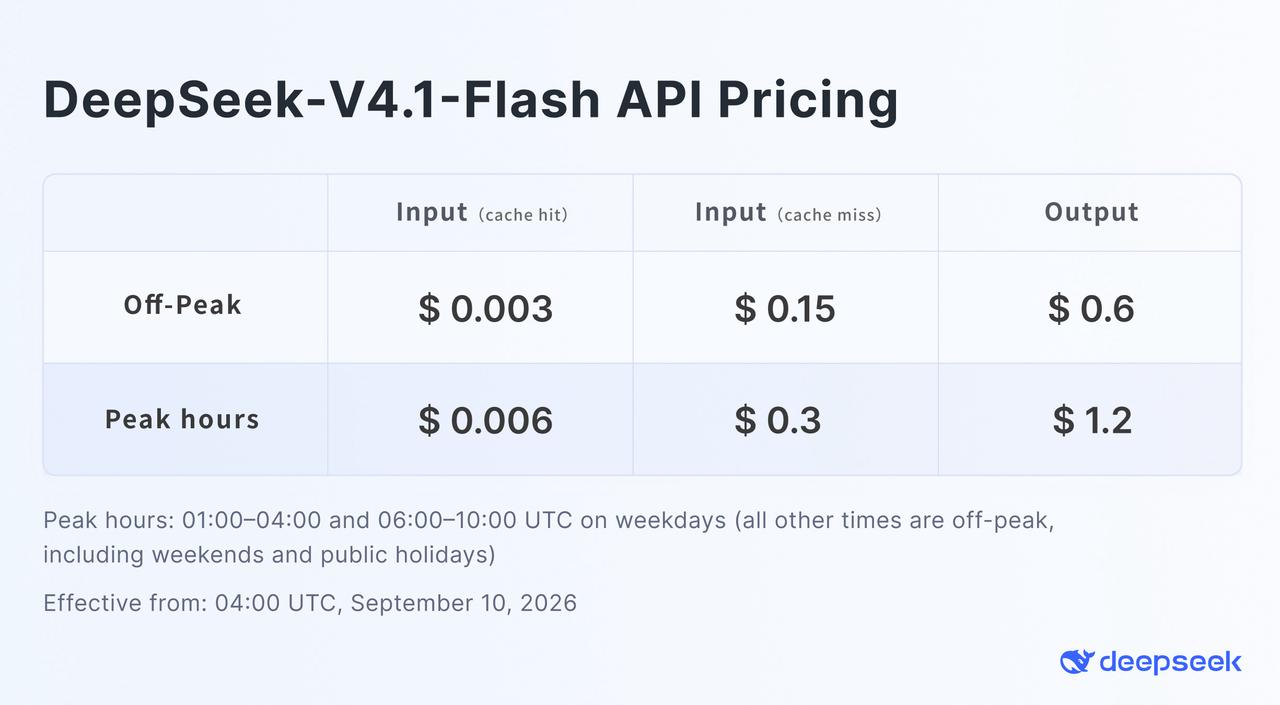
DeepSeek 的官方離峰定價顯示於其 V4.1-Flash 價格圖。對不需持有權重的開發者,CometAPI 中的 DeepSeek V4.1 Flash API 提供 OpenAI 相容的替代方案。
下例使用 CometAPI 的模型識別符。這不是 DeepSeek 官方 API 所用的識別符。
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
實務決策很直接:當隱私、隔離環境、權重級試驗、可預期的高負載利用或合規要求胜過基礎設施成本時,本地部署更具吸引力。對一般應用開發而言,使用託管端點可避免數百 GB 的模型管理與多 GPU 協調。
What Problems Can You Encounter When Running DeepSeek-V4.1-Flash Locally?
在開始生成前伺服器即耗盡記憶體
主要由完整檢查點(而非 8B/16B 活躍參數)決定記憶體需求。請檢查張量平行、GPU 記憶體利用率、視覺載入與可用 HBM。
DeepSeek-V4.1-Flash 啟動耗時很長
半 TB 的檢查點需要時間下載、映射、初始化與分片。對此類模型而言,較長的引擎就緒逾時屬正常。
回應為空或以 finish_reason=length 結束
思考模式可能正在消耗生成預算。請增加 max_tokens、降低推理努力,或在簡單請求中停用思考。
工具呼叫解析不正確
確保伺服器使用 DeepSeek V4.1 的 tokenizer、tool-call parser、reasoning parser 與 auto-tool-choice 旗標。
視覺輸入無法運作
若以 --language-model-only 啟動,代表你已刻意停用視覺編碼器。請在啟用多模態支援後重新測試圖像。
Should You Run DeepSeek-V4.1-Flash Locally?
從自託管角度看,DeepSeek-V4.1-Flash 相當有趣,因其架構大幅降低每 token 的計算與 KV 快取成本,但並未將前沿級開放權重模型變成桌面級模型。
對研究實驗室、企業 AI 平台、私有編碼代理堆疊或隔離環境而言,vLLM 與 SGLang 使自託管在技術上可行。對擁有一兩張 GPU 的開發者而言,完整模型的本地部署並不實際。在此情況下,透過 CometAPI 使用 DeepSeek V4.1 Flash 可在不將服務變成大型基礎設施專案的前提下存取該模型。
FAQ
DeepSeek-V4.1-Flash 是否開源?
其模型權重與倉庫以 MIT 授權發布,允許廣泛使用、修改與再散布,須遵守授權條款。
能否在 RTX 4090 或 RTX 5090 上運行 DeepSeek-V4.1-Flash?
無法運行官方完整模型。單張消費級 GPU 的記憶體僅為完整檢查點所需的一小部分。
8B 活躍參數是否意味著 DeepSeek-V4.1-Flash 只需 8 GB VRAM?
不。8B 數值描述提示處理期間參與計算的參數量;完整專家網路與支援狀態仍需儲存並可供推理引擎存取。
DeepSeek-V4.1-Flash 需要多少 VRAM?
目前 vLLM 配方以約 614 GB 作為官方檢查點加執行時開銷的規劃數值。實際需求隨硬體、批次大小、上下文、視覺支援與服務設定而異。
DeepSeek-V4.1-Flash 在磁碟上有多大?
目前 vLLM 的分解將檢查點定為約 476 GiB,約 511 GB。
DeepSeek-V4.1-Flash 能否在本地運行 100 萬 token 上下文?
架構支援至 1,048,576 tokens,但實際記憶體使用亦取決於批次大小、執行時緩衝、視覺狀態與其他開銷。
能否使用 Ollama 在本地運行 DeepSeek-V4.1-Flash?
目前 Ollama 項目使用 :cloud 路徑,這與在本機完整權重上進行推理不同。
vLLM 或 SGLang 哪個更適合 DeepSeek-V4.1-Flash?
兩者皆以高效能服務為目標。vLLM 目前有特別詳盡的 V4.1 專用配方,而 SGLang 亦適用於進階分散式部署。
在沒有本地硬體的情況下,使用 DeepSeek-V4.1-Flash 的最簡便方式是什麼?
使用託管 API。DeepSeek 提供官方 API,而 CometAPI 提供 OpenAI 相容的 DeepSeek-V4.1-Flash 端點及其他 AI 模型。