
TL;DR
MiniMax M3.1 Flash 將開放權重的 AI 帶到高要求的程式設計與代理工作流程,但在本地執行需要強悍的硬體。其 428B 參數的 MoE 架構每個 token 只啟用約 23B 參數,降低計算量,但仍需存放完整模型。具備受支援多 GPU 系統的開發者可使用 vLLM 或 SGLang 部署。若希望免管理基礎設施,CometAPI 中的 MiniMax M3.1 Flash API 提供更簡單的起步方式。
Key Takeaways
- 硬體是最大門檻。已公布的 vLLM 配置使用四張受支援的 Blackwell 或 AMD MI355X GPU,或八張 H100/H200 GPU。
- 長上下文伴隨記憶體成本。模型支援最多一百萬 tokens,但實際服務上限取決於可用 GPU 記憶體與併發。
- 部署與硬體綁定。請使用相容的推理引擎、量化格式與加速器設定,而非通用安裝指令。
- 基準測試僅是起點。請在自己的工作負載下評估程式準確度、代理任務完成率、延遲與吞吐。
- 本地與託管推理滿足不同需求。自我託管提供更高的基礎設施掌控;API 存取可降低設定複雜度與維運負擔。
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash 接受文字、影像與影片並產生文字。其設計面向程式設計、自動化、電腦互動與安全工作流程。權重依 MiniMax Community License 發布。在提供商業服務前,請閱讀檢查點隨附的授權條款並確認適用條件。
MiniMax M3.1 Flash specifications
How does MiniMax M3.1 Flash use its 428B/23B architecture?
Mixture-of-Experts(MoE)模型會將每個 token 路由到選定的專家。在 MiniMax M3.1 Flash 中,每個 token 約有 23B 參數處於活躍狀態,而完整參數池約為 428B。稀疏啟用可降低計算量;它並不會將檢查點變成稠密的 23B 模型。
What Changed in MiniMax M3.1 Flash?
- 稀疏注意力:在整個模型中應用,以降低長輸入的注意力計算;效益取決於服務端核心與提示。
- 混合精度權重:MXFP8 稠密元件與 NVFP4 專家降低儲存與計算需求,但仍需相容硬體與核心。
- DSpark 解碼:整合的 draft head 可在受支援的 recipe 中加速生成;結果取決於 token 接受率與工作負載。
- 電力感知服務:基礎設施層級排程可提升利用率,但並非下載權重後即可自動獲得的功能。
What Hardware Is Needed for MiniMax M3.1 Flash?
請將 GPU 記憶體預算分為四部分:檢查點權重、先前 token 的 key-value(KV)快取、執行期緩衝區與工作負載餘裕。下列估算僅涵蓋原始參數儲存。混合精度、量化比例尺、多模態元件與服務開銷會改變實際需求。
Validated GPU topologies
記憶體估算:428B 參數的原始儲存約為 BF16 856 GB、8 位元 428 GB、或理想化 4 位元 214 GB。官方檢查點混合了格式,因此這些數字並非執行期 VRAM 需求。請預留量化比例尺、KV 快取、執行期緩衝區與併發;使用實際的檢查點檔案與你的 GPU 相符的 recipe 來規劃系統容量。
請為檢查點、暫時下載與回滾副本預留 NVMe 空間。
Which Deployment Method Should You Choose?
對於受支援的本地叢集,vLLM 是具體可行的起點,提供參考配置與熟悉的 API 整合;SGLang 適合在確認相容性後探索服務自訂的團隊,而 CometAPI 提供原型與模型切換的託管路由。
請選擇有驗證配方且與你的硬體相符的框架,然後在相同提示、精度與併發下比較延遲與吞吐。
How to Run MiniMax M3.1 Flash Locally With vLLM?
以下步驟假設 Linux 主機配備四張相容的 NVIDIA Blackwell GPU、受支援的驅動/CUDA 環境,並可存取官方檢查點。請使用經驗證的 vLLM 版本;在不受支援的 GPU 上做一般安裝即使封包安裝成功也可能失敗。
Step 1: Install the serving tools
python3 -m venv minimax-env
source minimax-env/bin/activate
python -m pip install --upgrade pip
python -m pip install -U huggingface_hub
python -m pip install "vllm>=0.33.0"
python -c "import vllm; print(vllm.__version__)"
請確保已安裝的 wheel 與 CUDA 執行時與你的 GPU 系列相符。若需要專案特定的開發版本,請在使用啟動參數前遵循參考安裝說明。
Step 2: Download the official checkpoint
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./MiniMax-M3.1-Flash
如需,請使用合適的 Hugging Face 存取權杖,保留目錄結構,並在啟動伺服器前驗證分片完整下載。
Step 3: Launch on four NVIDIA GB200 GPUs
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_FLOAT32_MATMUL_PRECISION=high

vllm serve ./MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --attention-config '{"indexer_kv_dtype":"nvfp4","use_prefill_query_quantization":true}' \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE"}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --disable-hybrid-kv-cache-manager \
  --host 127.0.0.1 \
  --port 8000
請等待伺服器載入完成並回報就緒後再送出請求。上述指令將上下文限制為 32,768 tokens、並將同時序列限制為 4,以做初步冒煙測試。這些縮減的界限並非經過基準設定;請在你的硬體上量測記憶體使用與請求行為後再行調整。
Step 4: Send a local request
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./MiniMax-M3.1-Flash",
    "messages": [{"role":"user","content":"Explain sparse attention in three bullets."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024
  }'
若服務的識別碼與目錄名稱不同,請呼叫 /v1/models 並使用精確回傳的 ID。成功的文字回應只驗證基本推理;請另行測試視覺、工具呼叫、併發與長上下文。
Step 5: Integrate with an OpenAI-compatible Python client
python -m pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
model_id = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model_id,
    messages=[{"role": "user", "content": "Write a Python duplicate filename detector."}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=2048,
)
print(response.choices[0].message.content)
此範例在 127.0.0.1 上進行本地測試。在連接遠端客戶端之前,請在端點前方放置存取控制,並設定客戶端逾時、限制重試次數與監控。
H100/H200 variant: use the eight-GPU Hopper recipe
在八張 H100/H200 GPU 上,請使用 Hopper 特定的 FP8 快取與 Marlin MoE 路徑,而非 Blackwell NVFP4 配置。下列指令遵循官方 vLLM Hopper 配方,並將上下文與併發縮減為 32K 與四個序列作為初步測試。它依該配方停用影片輸入。請將此端點置於現有存取控制之後。
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
How to Run MiniMax M3.1 Flash With SGLang?
SGLang 提供硬體特定的 M3.1 部署配方與與 OpenAI 相容的服務。以 10 月 23 日快照為例,文件包含專用開發容器映像,因此不應假設通用 SGLang 安裝已含所有模型特定支援。
Pull the dedicated container image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
接著,請依你的加速器遵循 SGLang MiniMax M3.1 cookbook。拉取映像只會下載執行時;你仍需啟動具 GPU 存取的容器,並在其中啟動相符的服務配置。請使用 cookbook 的完整硬體特定指令,等待就緒,然後在送出測試請求前先查詢端點的模型清單。已記載的 NVIDIA 與 AMD 路徑使用不同相依套件,且應分別設定。
How Does MiniMax M3.1 Flash Compare on Benchmarks?
一旦你的端點通過基本檢查,請使用已發布的基準測試決定下一步要測試的工作負載。下列數字為供應商發布的評估,並非你的本地部署的量測。
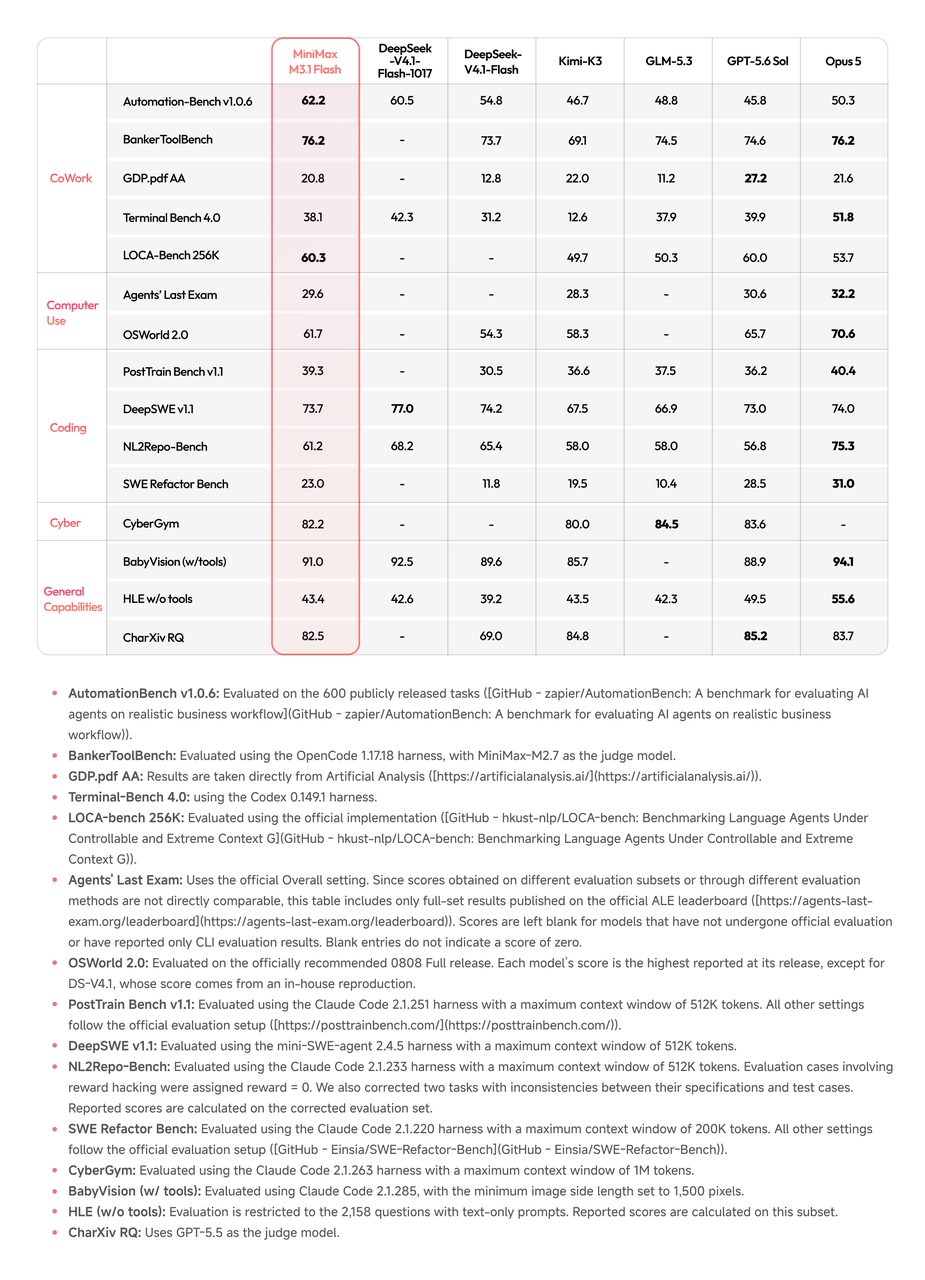
在此比較中,MiniMax 在 Automation-Bench 上領先所列模型,而 DeepSeek 在多項程式設計基準上領先。請閱讀模型卡與評估設定後再下結論,並測試你的應用實際使用的提示與工具。不同基準版本或設定的分數不可直接比較。
How Can You Optimize MiniMax M3.1 Flash Performance?
Control context and concurrency
在第一次成功請求後,請一次只增加一個負載變數:輸入長度、輸出長度或同時請求數。為每次執行記錄峰值記憶體與回應延遲。將最後的穩定設定保留為回滾點,以避免失敗的實驗成為新的基線。
Choose reasoning effort deliberately
M3.1 Flash 支援 low、medium、high、xhigh、max 推理力度。較高設定可提升高難度任務分數,但通常需要更多推理 tokens 與更長延遲。請將任務完成品質與計算成本一併考量。
關於推理力度與任務成本的已發布關係,請見官方 Automation-Bench 分數—成本圖。
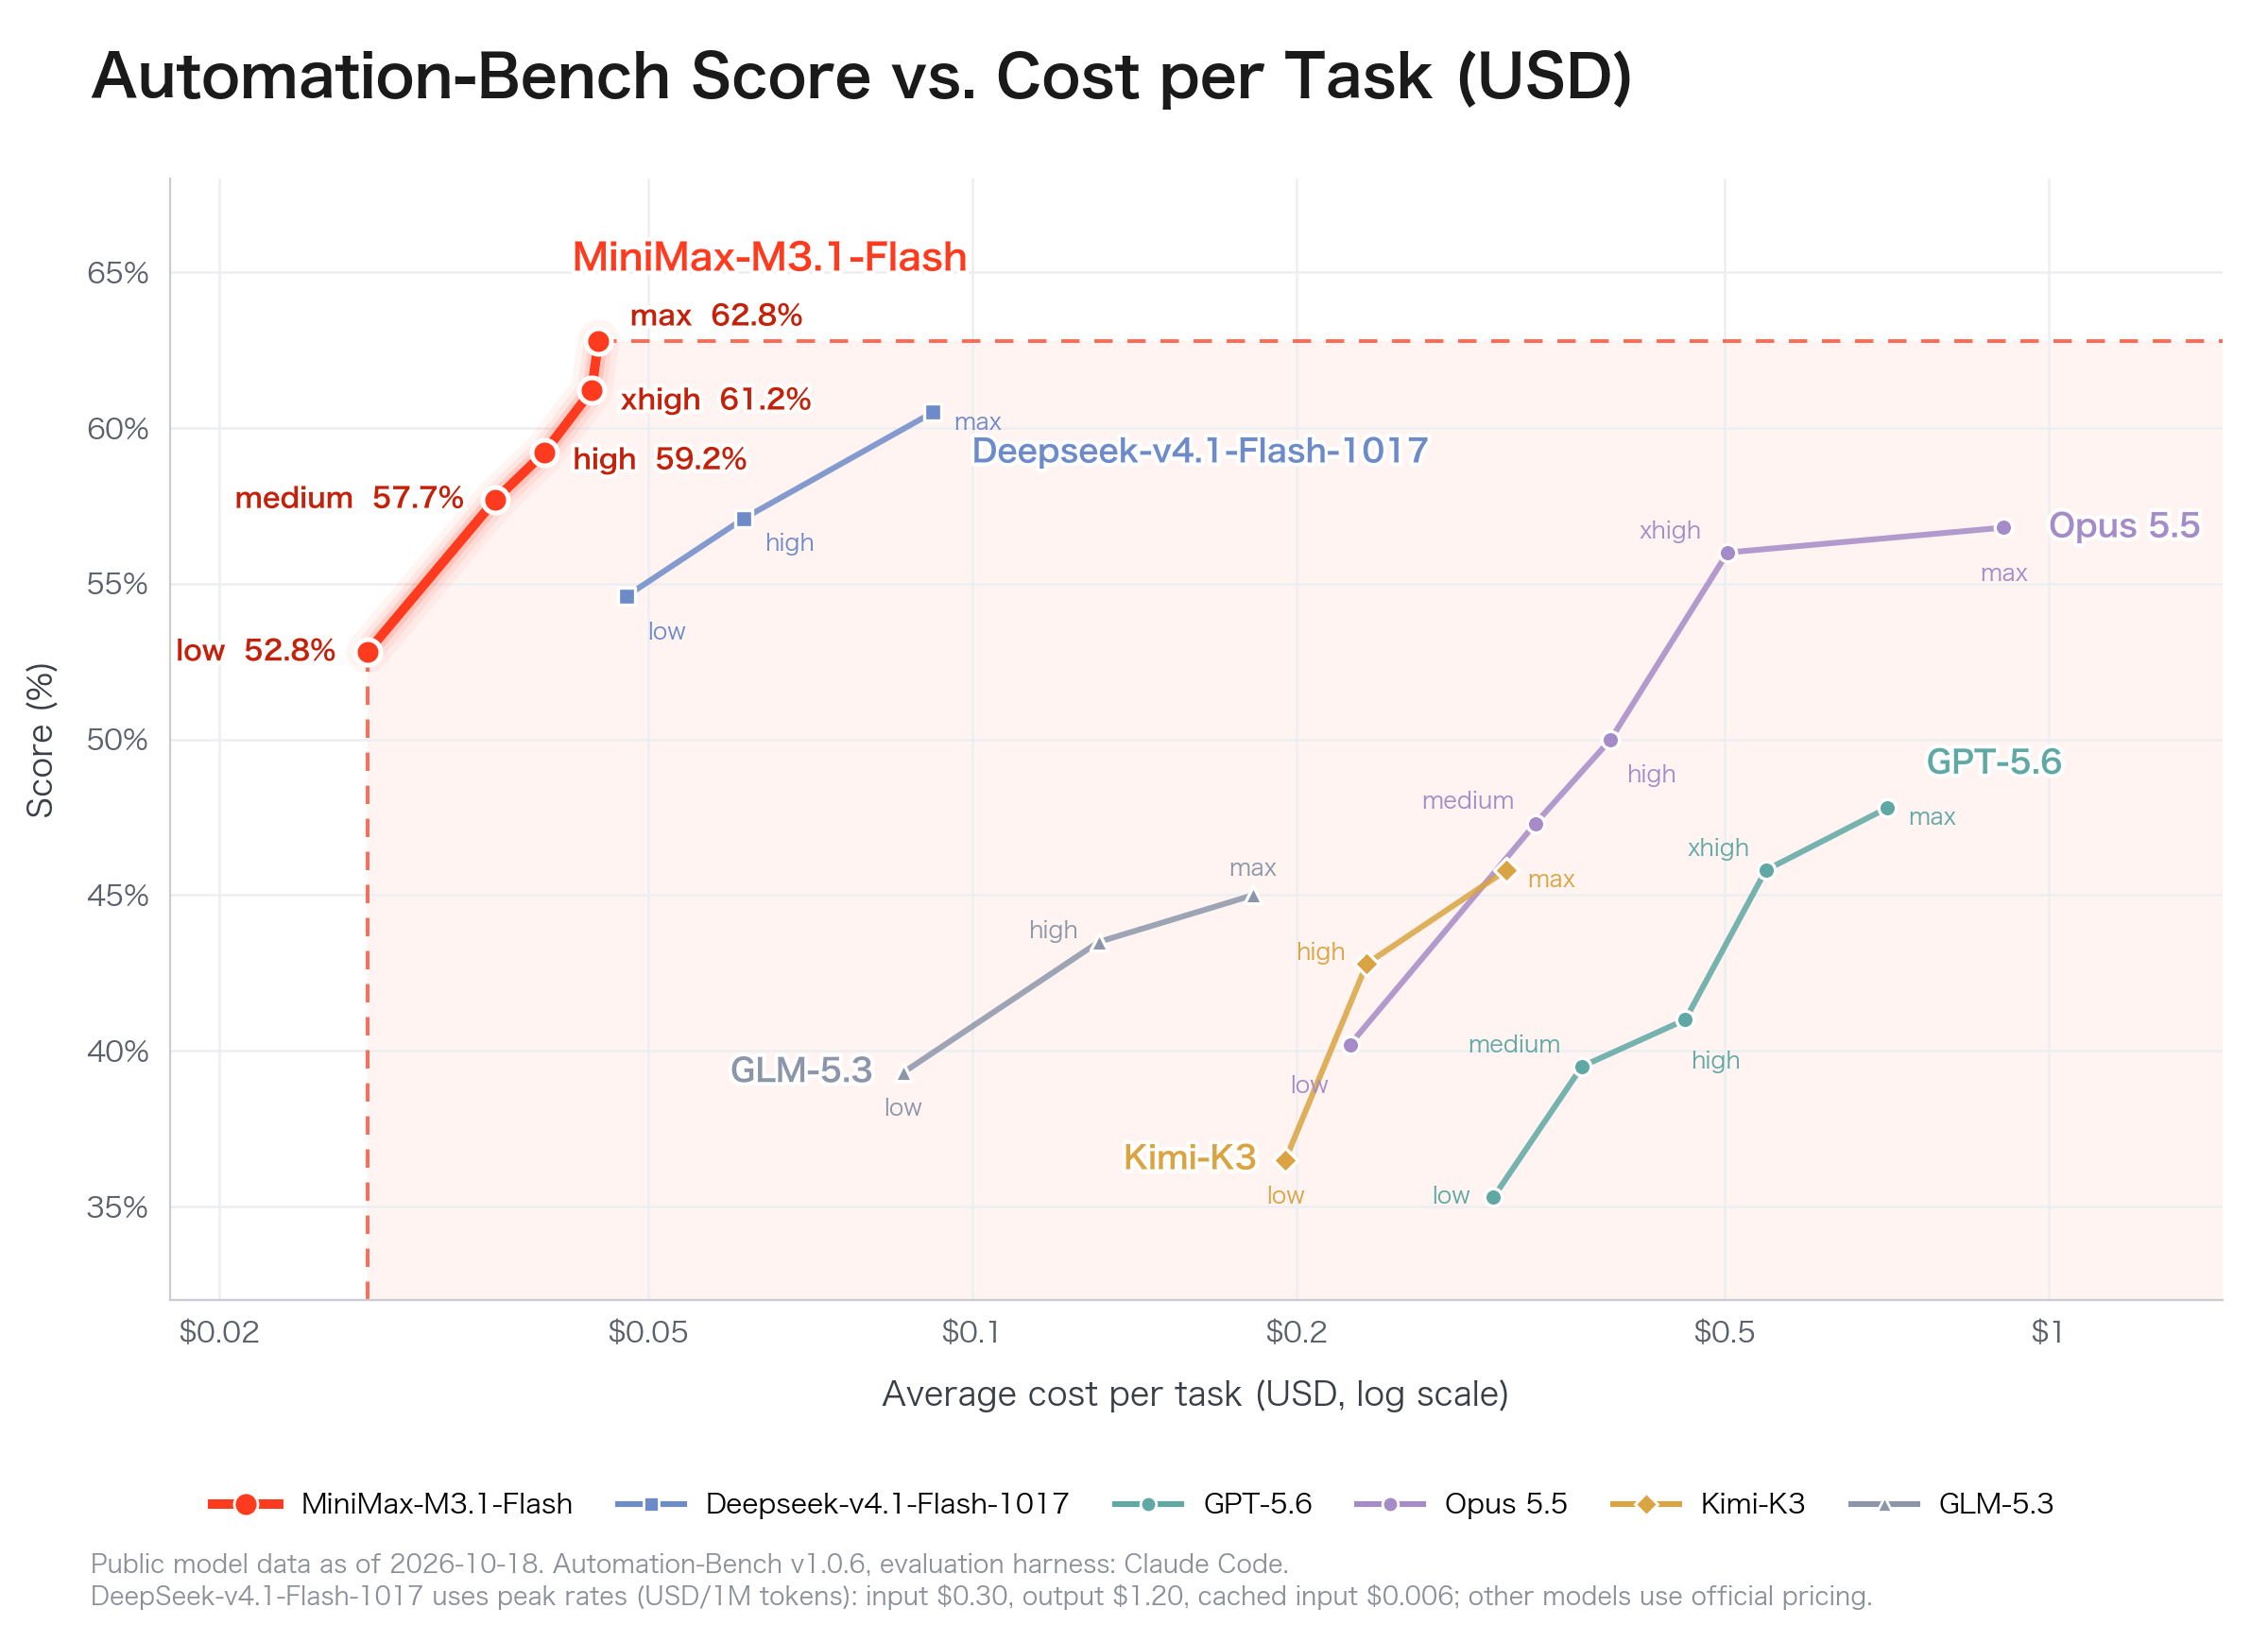
| 推理力度 | 報告的 Automation-Bench 分數 |
|---|---|
| Low | 52.8% |
對於本地 vLLM 請求,該配方在 chat_template_kwargs 下提供推理力度設定。在驗證你的客戶端時,請同時檢查最終答案與任何單獨回傳的推理欄位,因為託管與本地端點可能以不同方式暴露這些欄位。
Track cost per completed task
對於代理而言,每秒 tokens 並不足夠。請記錄首 token 時間、輸出速率、推測解碼接受率、併發吞吐、工具呼叫失敗率、記憶體使用率與完成任務的成本。較慢但工具失敗較少的回應,可能帶來更好的整體經濟效益。
How Can You Use MiniMax M3.1 Flash API in CometAPI?
不需要專用加速器基礎設施的團隊可以使用與 OpenAI 相容的託管端點。這可免除檢查點下載與 GPU 操作,但將請求處理移出自我託管環境。
請使用MiniMax M3.1 Flash API進行託管存取。為了透過同一閘道比較模型,請用相同的應用測試試試 DeepSeek V4.1 Flash API 或 Kimi K3 API。
CometAPI request example
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
在執行此範例前,請於 CometAPI 主控台確認模型識別碼。當跨供應商的通用 API 有助於你的應用時,請使用該閘道;並以你的預期用量比較其當前報價與直接存取。
MiniMax M3.1 Flash API pricing
| 每百萬 tokens 的價格 | MiniMax 官方 API | CometAPI |
|---|---|---|
| 輸入 | $0.15 | $0.80 |
根據 2026 年 10 月 19 日的發佈公告,MiniMax 直連 API 價格為每百萬 tokens:輸入 $0.15、輸出 $0.60、快取輸入 $0.015。對於 CometAPI,請在估算花費前檢查當前模型路由、輸入/輸出費率、快取規則與任何帳戶折扣。請依你的預期 token 組合與重試次數比較總成本。
What Problems Might Occur When Running MiniMax M3.1 Flash?
載入或請求期間記憶體不足
- 若權重載入失敗:請檢查啟動日誌中的失敗階段,確認檢查點完整,並驗證 GPU 拓撲與量化後端與配方相符。若權重超出可用記憶體,請使用容量足夠的配置;縮短請求無法修復權重載入失敗。
- 若權重載入成功但啟動時快取配置失敗:請檢查快取設定與可用記憶體,然後依配方適度降低設定的上下文或併發。
- 若伺服器啟動成功但請求導致記憶體不足:請以一次一個短提示重試,然後分別增加輸入長度、輸出長度與併發,同時監控記憶體。
不相容的量化或注意力核心
NVFP4 的執行在 Blackwell、Hopper 與 AMD 硬體間有所不同。請匹配推理引擎版本、量化後端、CUDA/ROCm 版本與加速器系列,而非不加甄別地重用旗標。
稀疏注意力快取配置
若啟動回報不受支援的快取版型,請將完整快取配置與硬體特定配方比對。目前 vLLM 配方要求 --block-size 128 作為 MSA 稀疏/索引快取。若啟動回報快取版型或區塊大小錯誤,請將完整配置與你的硬體配方比對。
意外的模型識別碼
本地路徑與遠端閘道的模型名稱不一定相同。請查詢本地 /v1/models 回應,並避免從其他端點硬編假設。
觀察到的吞吐不佳
請將提示處理較慢與生成較慢分開。請比較在相同輸入長度與輸出上限下的執行,然後在增加批次大小前先檢查 GPU 利用率與互連行為。供應商託管的速度數字並非你的本地叢集的基線。
Conclusion
請先從你今日能操作的硬體選擇第一個部署途徑。對於受支援的本地叢集,請使用 vLLM 操作指南;若想要替代的服務堆疊,請參考硬體特定的 SGLang cookbook;或在希望專注於應用整合時使用託管 API。請保留在任務品質與延遲達標且具可持續營運成本的配置。
選擇服務方式最可靠的準則,是優化「每美元與每分鐘的正確完成工作量」,而非僅追求峰值 tokens/s。
FAQ
如何在升級執行時後讓部署可重現?
請固定檢查點版本、執行時映像或套件版本、驅動堆疊與啟動設定。每次升級前執行相同的小型驗收集,並保留上一個可工作的配置作為回滾。
當代理呼叫工具時,應如何處理重試?
請將模型重試與工具動作重試分開。對會改變資料的動作使用冪等鍵,檢查第一次嘗試是否成功,並在執行前驗證完整的工具參數。
能否在不改變應用行為的情況下切換本地端點與 CometAPI?
請將端點、憑證與模型 ID 設為可配置。在兩條路由上測試串流、工具呼叫、推理欄位與多模態輸入,並在啟用備援前確認你的資料路由需求。
在接受多模態輸入前應測試什麼?
請測試具代表性的影像與影片,包括低品質與不受支援的檔案。請分別檢查前處理、大小限制、答案品質與逾時;成功的文字請求並不等同驗證多模態路徑。
怎樣判斷部署已準備好面向真實使用者?
請設定任務成功率、有效工具呼叫、延遲、錯誤與成本的目標。測試真實流量、驗證監控與備援行為,並僅在這些目標維持達標時逐步擴大規模。