Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Hy4 vs GPT-6.1 Terra:基準測試、API 定價,以及該選哪個模型
ai-comparisons / CometAPI 研究
Hy4 vs GPT-6.1 Terra:基準測試、API 定價,以及該選哪個模型 比較 Hy4 與 GPT-6.1 Terra 在程式開發、研究、官方 API 規格以及 CometAPI 定價方面的差異。為您的工作負載找到最合適的模型。
Deon Goodwin AI 模型與 API 研究團隊 比較 Hy4 與 GPT-6.1 Terra 在程式開發、研究、官方 API 規格以及 CometAPI 定價方面的差異。為您的工作負載找到最合適的模型。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Hy4 是用於金融研究與高產量文本生成的強勁起點;GPT-6.1 Terra 則是用於終端機編碼與除錯的強勁起點。兩者皆可接受文字與圖像並支援工具使用。最明顯的差異在於任務表現、輸出容量與價格:在下方的終端測試中 Terra 領先,而 Hy4 在金融與研究測試中領先,且在 CometAPI 所列費率下成本更低。
Key Takeaways
依工作負載選擇:研究與輸出密集應用選 Hy4;終端機編碼與除錯選 Terra。
兩者皆提供約百萬 token 的上下文視窗。Terra 提供更大的最大輸出預算。
Terra 在 Terminal-Bench 4.0 領先 10.10 個百分點;騰訊模型在 Vals AI 的 Finance Agent v2.1 領先 8.74 個百分點。
CometAPI 範例中 1,000 萬輸入與 200 萬輸出 token 的成本為 $10.672 與 $16.00(以所示基礎費率計)。
在切換供應商前,請將端點、工具行為與推理設定與您的應用匹配。
規格、基準測試快照與價格檢查時間:2026 年 11 月 6 日。
Hy4 vs GPT-6.1 Terra: 規格與能力 Hy4 結合文本與圖像理解、推理與工具使用,涵蓋命令列與圖形介面的工作流程。GPT-6.1 Terra 支援視覺推理、電腦操作與寫作,提供明確的推理強度控制,且擁有更大的輸出預算。下表比較騰訊與 OpenAI 提供的規格。
Official API Specifications Developer Tencent OpenAI API model ID hy4 gpt-6.1-terra Input / output Text and images / text Text and images / text Context window 1024K tokens (Tencent notation) 1,050,000 tokens Maximum output 64K tokens (Tencent notation) 128,000 tokens Tool calling Supported (Function Calling) Supported; requires Responses API Structured outputs Supported Supported Main applications Software engineering, financial analysis, and long-running agent tasks Visual reasoning, computer use, writing, and scoped code tasks
兩個模型皆可處理大型文件集與程式碼庫。對於長提示,也要為回應預留預算空間:騰訊為 Hy4 列出最大輸入為 960K。宣稱的上下文容量小差異,不如模型能否準確使用您的材料來得有用。
Terra 的長回應空間更多,最大可達 128,000 輸出 token,相較之下 Hy4 公布為 64K。當報告或程式碼交付需一次性裝入單次回應時,這會有所助益。推理 token 也會消耗 Terra 的輸出預算。
推理控制 Terra 提供六種推理強度設定:none、low、medium、high、xhigh、max,預設為 medium。這讓應用可依任務明確調整推理投入。分類請求與困難的除錯任務不必使用相同預算。
騰訊的發佈描述了與視覺感知與工具使用結合的推理,但在該公告中未定義等同的六級控制。將推理參數視為端點特有:不要將一家的強度設定直接套用到另一家的請求中並假設其含義相同。
Hy4 vs GPT-6.1 Terra: 效能 Vals AI 提供兩者在編碼、金融、法務研究與稅務任務上的直接結果。這些分數顯示各模型對不同工作負載的適用性。
獨立基準結果與測試條件 以下為 2026 年 11 月 10 日檢視的 Vals Index v2.2 結果。分數越高越好。
Vals Index 59.35% ± 1.08 60.54% ± 0.99 Terra +1.19 percentage points Terminal-Bench 4.0 39.39% 49.49% Terra +10.10 points Vibe Code Bench v1.1 81.01% 84.00% Terra +2.99 points Finance Agent v2.1 64.70% 55.96% Tencent model +8.74 points Legal Research Bench 41.35% 25.96% Tencent model +15.39 points Tax Agent Bench 34.40% 17.08% Tencent model +17.32 points
Vals AI 為 Hy4 設定 temperature 0.9、top_p 1.0 與 65,536-token 輸出上限;Terra 使用最大推理強度與 128,000-token 輸出上限。這些設定不同,因此應將結果視為被測配置的比較,而非同等預算下的對比。
Terra 在終端任務上的領先幅度大於在程式碼生成上的領先:在 Terminal-Bench 4.0 領先 10.10 個百分點,相較於在 Vibe Code Bench 領先 2.99 個百分點。這使得除錯與命令列開發成為評估 Terra 的最明確起點。
Hy4 在 Finance Agent、Legal Research Bench 與 Tax Agent Bench 分別領先 8.74、15.39 與 17.32 個百分點。蒐集證據並套用領域規則的研究流程因此是 Hy4 的有力起點。
整體差距為 1.19 個百分點,且公布的不確定性區間重疊。
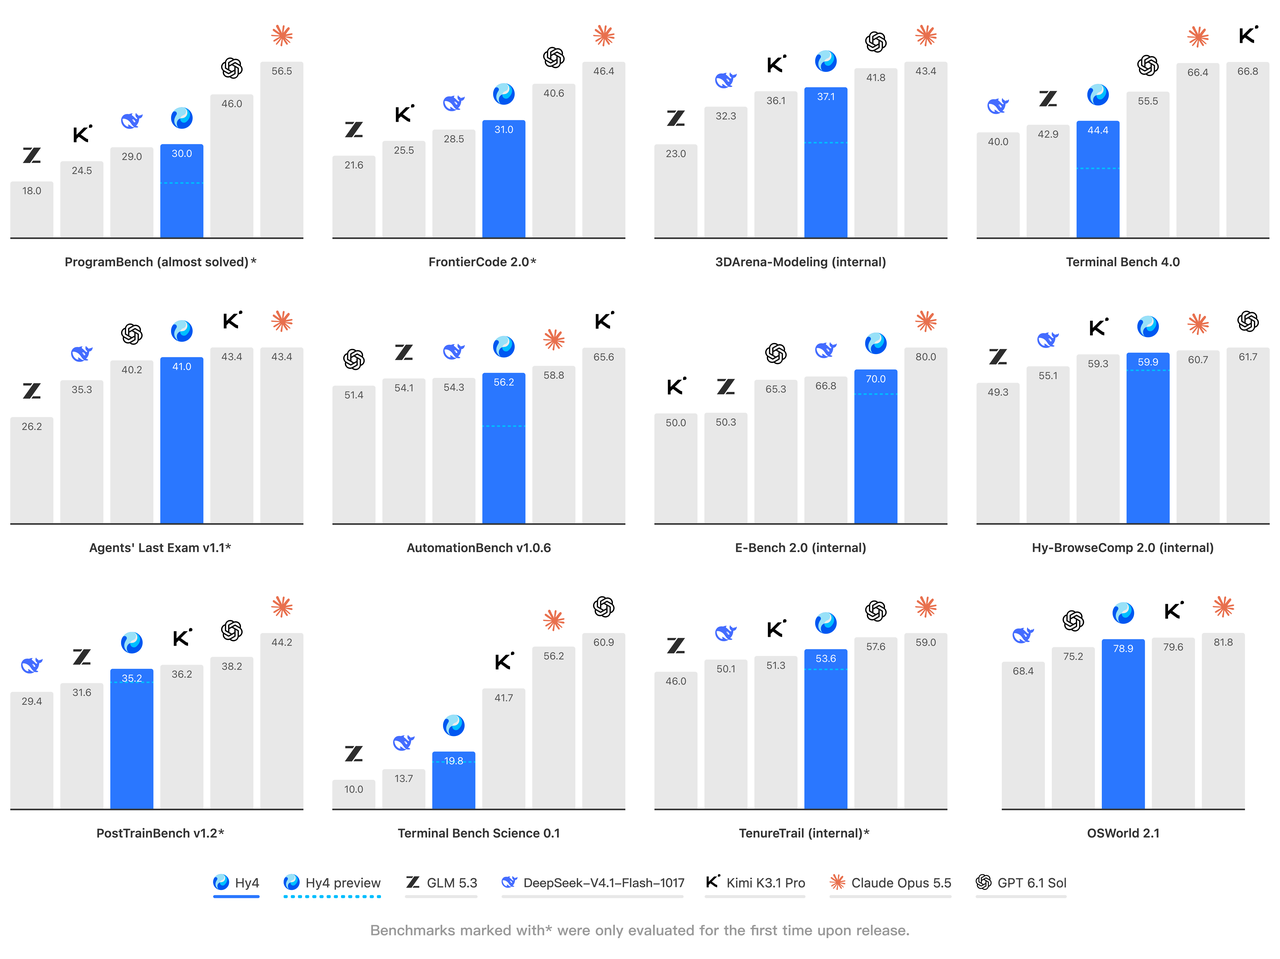
騰訊 Hy4 發佈基準 騰訊的發佈圖表 補充了編碼與電腦操作結果。其比較對象為 Hy4 與 GPT-6.1 Sol;若需與 GPT-6.1 Terra 的直接比較,請參閱上方 Vals AI 表格。
騰訊於 2026 年 11 月公布的 Hy4 基準結果。圖中的 OpenAI 模型為 GPT-6.1 Sol。
在騰訊的發佈圖表中,Hy4 在 Terminal Bench 4.0 得分 44.4,在 OSWorld 2.1 得分 78.9。這些數據描述的是騰訊的評估設定,與上文 Vals AI 的分數分開。
視覺與電腦操作工作流程 騰訊在官方發佈中引入了圖像理解 ,並描述了涵蓋命令列工具、圖形介面、Blender 與 CAD 的訓練。這使圖表分析與視覺軟體任務成為其定位的核心。
OpenAI 將其模型定位於以螢幕為中心的工作流程 、精煉寫作與範圍控管的程式碼修復。對於目錄應用,測試產品照片比對;對於技術工作,使用含小標籤與尺寸標註的圖紙;對於桌面自動化,請驗證已儲存檔案與應用狀態。
良好的視覺測試集應將讀取與操作分開。先測量模型是否萃取正確數值或識別正確介面元素,再測量完整工作流程是否達成所需結果,且沒有錯誤點擊、遺失檔案或不必要的人為介入。
速度與端對端延遲 對於聊天,相關的速度指標是回應開始的時間與完成所需的時間。對於代理,請測量完整任務,包括工具執行與任何修復。
在您預期的併發量下,對典型與高難度任務比較兩個模型。除了成功完成率,也要追蹤中位數與尾端延遲:只有能完成工作的快速回應才有用。
Hy4 vs GPT-6.1 Terra: 成本 先比較 token 費率,再納入為取得可用結果所需的工作量。以下價格為 CometAPI 以美元計的每百萬 token 基礎費率;與 Vals AI 報告的每次測試成本無關。
Input per million tokens $0.6672 $0.80 Output per million tokens $2.00 $4.00
下表使用 CometAPI 所列的每百萬 token 美元基礎費率。請分別比較輸入與輸出,然後計算您典型請求的成本。
10,000 筆請求的範例成本 考慮 10,000 筆請求,每筆使用 1,000 個未快取輸入 token 與 200 個可計費輸出 token。整體即為 1,000 萬輸入 token 與 200 萬輸出 token。使用上述 CometAPI 基礎價格:
Hy4: (10 × $0.6672) + (2 × $2.00) = $10.672.
GPT-6.1 Terra: (10 × $0.80) + (2 × $4.00) = $16.00.
在此範例中 Hy4 約便宜 33.3%。此估算涵蓋未快取輸入與可計費輸出;完整工作流程預算時需加上快取、工具與重試費用。
直接供應商計費與長上下文請求 對於使用 OpenAI 直接 API 的長文檔,提示超過 272K 輸入 token 時,整個請求將觸發 2× 的輸入與快取費率,以及 1.5× 的輸出費率。請依您所用服務的計費規則計算;上述 CometAPI 範例採用 CometAPI 的基礎費率。OpenAI 定價詳細資訊 。
每個被接受任務的成本 被接受的任務是指通過您應用的品質與完成檢查的任務。請計入為達到該結果所需的一切嘗試、工具使用與審核工作,包括未通過的嘗試所花費。
每個被接受任務的成本 = 模型、重試、工具與人工審核的總成本 ÷ 通過驗收檢查的任務數。
若較昂貴的呼叫能免去多次修復嘗試,整體仍可能更經濟。反之,若較低成本的模型已達品質門檻,為每個任務支付更高費率可能價值不大。
您該選擇哪個模型:Hy4 或 GPT-6.1 Terra? 先從長處貼合您主要工作負載的模型開始。使用以下選擇建立候選清單,然後比較完成任務的品質與成本。
何時選擇 Hy4 若重視金融研究、法務或稅務文件分析,以及需要生成大量文本的應用,請優先選 Hy4。其在三項領域基準上的領先,使其成為基於證據的研究流程的有力候選。在所列 CometAPI 費率下,其輸出價格為 Terra 的一半,對高量寫作與報告可能有實質影響。
對研究工作,請以來源準確性、計算與問題覆蓋度評估最終答案。當 Hy4 能以更低的總成本(包括審核與重試)滿足這些要求時,更為合適。
何時選擇 GPT-6.1 Terra 若重視終端機編碼、除錯與程式碼修補,請優先選 Terra。其在 Terminal-Bench 上的 10.10 點領先,是本次比較中最強的編碼信號。更大的輸出預算也值得在長報告與大量程式碼回應情境中測試。
以其修補是否通過測試與交付是否完整來評估 Terra。對於視覺或桌面工作,請在您的實際螢幕、圖表與檔案上比較兩者,並檢查最終儲存結果。
將研究與程式開發路由到不同模型 混合工作負載可能受益於同時使用兩個模型。金融分析助手可以用 Hy4 做研究與撰寫報告,當分析腳本需要除錯時再呼叫 Terra:
將證據蒐集與報告撰寫交給 Hy4。
在接受報告前檢查引文、來源數值與計算。
當分析腳本失敗時,連同程式碼、錯誤輸出與預期行為一起交給 Terra。
執行修正後的腳本,並在返回最終結果前套用相同的證據檢查。
當第二個模型能夠足以改善最終結果、抵銷額外成本與整合工作時再引入。
在哪裡可以存取 Hy4 與 GPT-6.1 Terra?
官方供應商存取
CometAPI 提供 ID 為 hy4 與 gpt-6.1-terra 的兩個模型。其模型頁面列出了各路由的請求範例與定價:Hy4 與 GPT-6.1 Terra 。
對於啟用工具的應用,請確認所選路由是否支援函式呼叫與結構化輸出。在 OpenAI 直接 API 上,Terra 的工具呼叫需要 Responses API。
如何測試並逐步導入您的選擇 在更改生產流量之前,請使用相同的輸入、工具與通過標準,在具代表性的任務上比較模型。記錄成功完成、總成本與耗時,然後逐步導入表現較強的路由。
納入日常請求與對您的使用者重要的困難案例。
檢查工具參數、結構化輸出、錯誤與完成狀態。
在導入前設定重試上限與回滾觸發條件。
結論 當研究品質與較低的文本生成成本是優先項時,選擇 Hy4。當終端機編碼、除錯與更大的輸出預算更重要時,選擇 GPT-6.1 Terra。
對於混合型應用,自主要工作負載各選一個模型開始,若第二條路由能改善結果再加入。最佳選擇是能以您可承受的成本準確完成任務的那個。