SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. guide/CometAPI 研究
如何在本機部署 Kimi K3.1 Pro:硬體需求與 vLLM 設定
瞭解如何使用 vLLM 自行部署 Kimi K3.1 Pro、檢查 GPU 需求、下載權重、測試推理,並比較本地部署與 API 存取。

Deon GoodwinAI 模型與 API 研究團隊 from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-5-mini",
messages=[{"role": "user", "content": "Build this workflow."}],
)
print(response.choices[0].message.content)
TL;DR
在 Linux GPU 伺服器上部署 Kimi K3.1 Pro,然後讓本機應用程式連線到其推理端點。本教學使用 vLLM 與一台配備八顆 NVIDIA B300 GPU 的節點。你需要具備伺服器的 Shell 存取權限、相容的驅動程式,以及用於完整檢查點的儲存空間。先完成一個短文字請求,再測試長輸入或代理工作流。
若沒有合適的 GPU,你可以在本機執行應用程式,並將其連線到官方 Kimi API 或第三方供應商(如 CometAPI)。
關鍵重點
- 模型的 104B 活躍參數不代表其完整的儲存需求。
- 硬體相容性包含 GPU 記憶體、互連、量化支援與推理核心。
- 強勢的基準測試結果值得嘗試,但不保證在你的應用中具有同等表現。
- 一個可運作的推理端點並不代表包含瀏覽器、程式碼沙盒或完整代理執行環境。
- 以每個成功任務的成本(含重試與維護)比較自託管與 API 存取。
什麼是 Kimi K3.1 Pro?
Kimi K3.1 Pro 是 Moonshot AI 的開源權重多模態模型,適用於程式設計、文件分析與工具使用。其主要規格如下,根據官方模型卡。
|
| 架構 | MoE;總參數 2.8T,活躍 104B |
| 注意力 | 93 層:69 KDA + 24 Gated DSA |
| 專家 | 896 可路由;每個 token 選擇 16 個;共享 2 個 |
| 上下文 | 1,048,576 個 token |
| 輸入 | 文字與影像;MoonViT-V2 視覺編碼器 |
| 量化 | MXFP4 權重 / MXFP8 活化;混合精度檢查點 |
| 推薦引擎 | vLLM、SGLang、TokenSpeed |
該模型每個 token 會啟動 104B 參數,但部署仍需要完整的 2.8T 參數檢查點。推理引擎也必須支援其 KDA、Gated DSA 層與 MXFP4 量化。
在本機執行 Kimi K3.1 Pro 需要哪些硬體?
下表彙整了與本指南相關的vLLM 配置。本教學使用單一八 GPU 的 B300 節點;GB300 與 AMD 的部署則需要使用對應的配置。
|
| NVIDIA B300 | 單一八 GPU 節點,TP8 | 下文教學的基準 |
| NVIDIA GB300 | 八顆 GPU 跨兩個機櫃,TP8 | 需要多節點配置與互連設定 |
| AMD MI355X | 八 GPU 節點,使用 AMD 特定配置 | 使用 ROCm/AITER 路徑;不要重用 NVIDIA 環境設定 |
| 單顆 24–32 GB 消費級 GPU | 不足以直接載入完整檢查點 | 本教學不具實務意義的目標 |
僅為規模估算,2.8T 參數在 BF16 約需約 5.6 TB、在 8 位元約 2.8 TB、在理想化 4 位元約 1.4 TB。這些是原始參數儲存計算,並非實際檢查點大小或執行期 VRAM 最低需求。混合精度與中繼資料會改變檔案大小;快取與執行期配置會增加服務需求。
請預留 NVMe 容量以供完整下載、暫存檔與回滾副本。在多節點系統上,請於載入模型前驗證節點間的通訊。
如何部署 Kimi K3.1 Pro
若你擁有合適的硬體,請使用自託管;否則先從託管 API 開始。以下步驟使用 vLLM,最後一節提供 SGLang 替代方案。建立可運作的請求後,再比較託管成本。
請在 GPU 伺服器的 Bash Shell 執行設定、下載、啟動與初始驗證指令。若你使用筆電工作,先用 SSH 連線至該伺服器。之後的 Python 用戶端可以在任一台機器上執行,使用下方的連線指示。
1. 檢查 GPU 可見度、儲存與連線
nvidia-smi
nvidia-smi topo -m
df -h
確認所有目標 GPU 可見,且模型目錄具有足夠的空間。另行預算下載快取、日誌與未來檢查點版本的儲存。
對於多節點部署,請在嘗試啟動模型前先驗證節點之間的通訊。
將第一個里程碑縮小範圍:載入檢查點並完成一個短文字請求。這樣有助於更容易診斷故障。
2. 準備服務環境
在此單一節點示例中使用搭載八顆 B300 GPU 的 Linux 主機。在與已發布食譜相容的 CUDA 環境中建立隔離環境並安裝服務工具:
python3 -m venv kimi-env
source kimi-env/bin/activate
python -m pip install --upgrade pip
python -m pip install --upgrade huggingface_hub
python -m pip install "vllm>=0.34.0" fastsafetensors
python -c "import vllm; print(vllm.__version__)"
版本下限不保證與所有驅動或輪檔相容。若硬體食譜需要專用容器或建置,請改用該環境。於上線前釘選通過測試的版本。
3. 下載完整檢查點
安裝 Hugging Face CLI 並下載模型倉庫:
python -m pip install --upgrade huggingface_hub

hf download moonshotai/Kimi-K3.1-Pro \
  --local-dir /srv/models/Kimi-K3.1-Pro
將配置、分詞器、處理器檔案與權重索引與權重分片一同保留。僅複製部分張量檔可能導致部署不完整。
為了可重現的生產部署,記錄並釘選你已驗證的倉庫版本。商用前請檢視倉庫的自訂授權條款。
4. 啟動 vLLM 伺服器
官方食譜指定使用 vLLM 0.34.0 或更高版本。請先依照硬體特定的環境配置進行,然後釘選通過你測試的版本與相依套件。
準備好環境後,使用以下基準指令。它啟動八路張量並行,並將初始上下文視窗限制為 32,768 個 token:
export VLLM_ENGINE_READY_TIMEOUT_S=3600

vllm serve /srv/models/Kimi-K3.1-Pro \
  --served-model-name kimi-local \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3 \
  --max-model-len 32768 \
  --host 127.0.0.1 \
  --port 8000
kimi-local 名稱是面向應用程式的別名。後續請求使用同一名稱。
32,768 個 token 的設定是本教學的保守起點,並非模型支援的最大上下文。
--trust-remote-code 選項允許載入自訂倉庫程式碼。請搭配審查過且釘選的檢查點版本。
此處的 127.0.0.1 指的是執行用戶端的機器。下方的 curl 檢查在 GPU 伺服器上執行,請求會到達其推理程序。若你要在筆電上使用 Python 用戶端,請在另一個筆電終端機開啟 SSH 通道並保持執行:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
5. 驗證本機端點
curl http://127.0.0.1:8000/v1/models
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kimi-local",
    "messages": [
      {
        "role": "user",
        "content": "Explain database indexes in three sentences."
      }
    ],
    "reasoning_effort": "low",
    "max_tokens": 2048
  }'
- 預期的模型名稱。
- 回應中的最終答案。
finish_reason 指示生成是否完成或觸及限制。- GPU 記憶體或不支援操作的錯誤。
推理可能會消耗部分生成預算。若請求在產生最終答案前達到限制,請先增加預算並重試,再下結論認定伺服器故障。
6. 連線本機 Python 應用程式
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY 是沒有 API 金鑰驗證的回環伺服器用的占位字串。對於需要驗證的端點,請使用你已設定的憑證。請在連接代理前,分別驗證影像輸入與工具執行。
SGLang 替代方案
對於 SGLang,請使用官方硬體特定的料理書。選擇 B300、Unified 與 Low-Latency(TP8),以最接近此單一節點教學的配置。請檢查顯示的驗證狀態;生成的配置不一定是已測試的配置。
在 GPU 伺服器上安裝 Docker 並配置 NVIDIA Container Toolkit,接著建立一個容器,將已下載的檢查點掛載到 /models/Kimi-K3.1-Pro。先停止 vLLM,以免兩個引擎競爭同一組 GPU。
docker pull lmsysorg/sglang:dev-kimi-k31-pro
docker run --rm -it --gpus all \
  --shm-size 32g --ipc=host \
  -p 127.0.0.1:30000:30000 \
  -v /srv/models/Kimi-K3.1-Pro:/models/Kimi-K3.1-Pro:ro \
  lmsysorg/sglang:dev-kimi-k31-pro bash
在容器中,貼上料理書為你所選配置產生的完整啟動指令。將模型路徑改為 /models/Kimi-K3.1-Pro,服務主機設為 0.0.0.0、埠設為 30000,並保留硬體相關的旗標。容器必須在其網路介面上監聽,Docker 埠轉送才會生效;上述主機端埠仍綁定至回環。等待服務就緒訊息後再測試。
在 GPU 伺服器上的第二個 Shell 中,列出所服務的模型,然後使用回傳的精確模型 ID 送出請求:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
成功回應應包含最終答案。若啟動失敗,請檢視容器日誌並確認所選硬體食譜與映像檔相符。若要從筆電存取,套用與 30000 埠相同的 SSH 通道模式。容器前置需求請參見SGLang Docker 安裝指南。
Kimi K3.1 Pro 在各項基準測試中的表現如何?
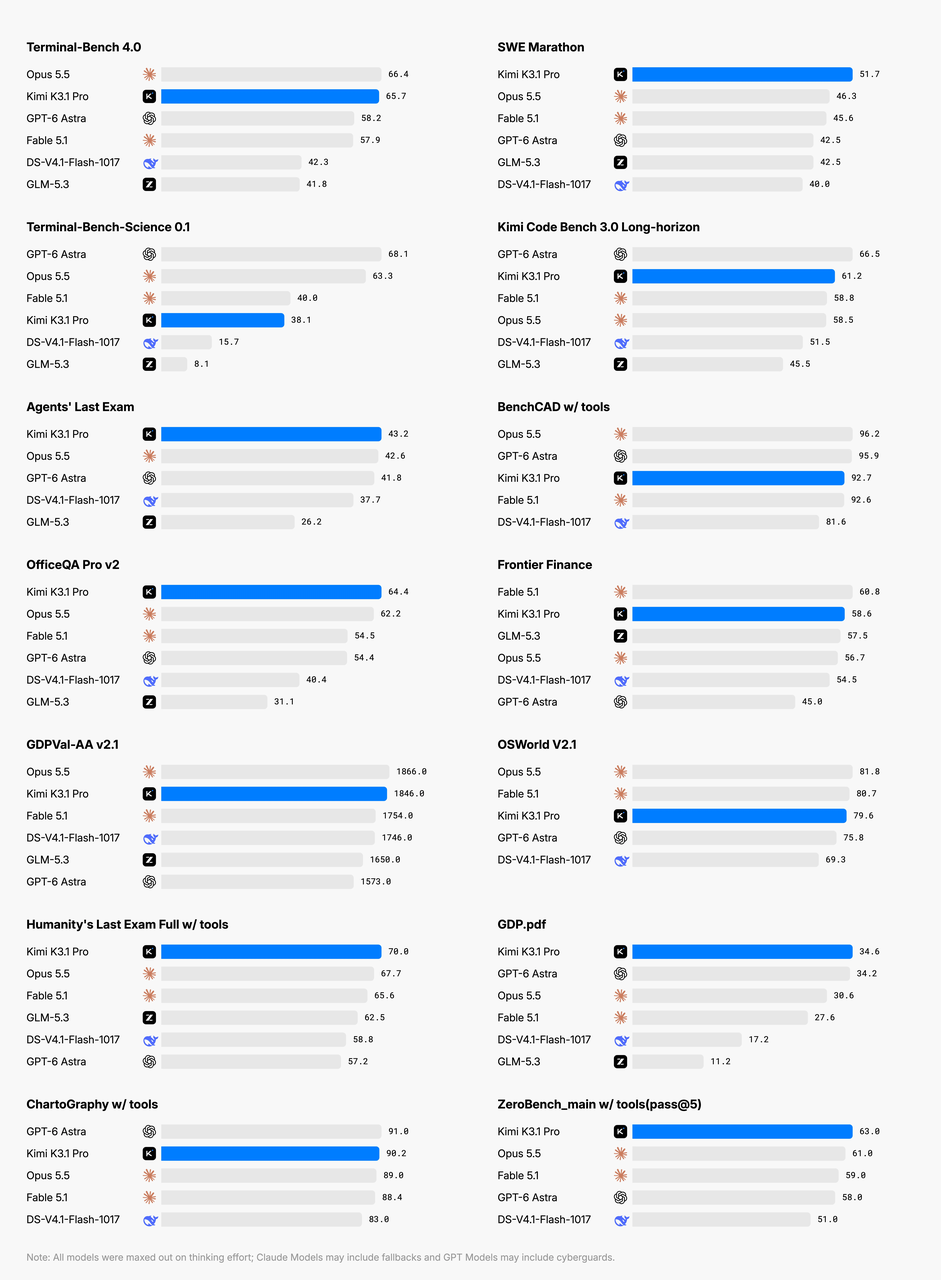
使用以下官方評測結果來選擇部署測試的任務。這些分數描述的是已發布的評測設定;它們不衡量本指南中所配置的本機伺服器。
下表顯示所選結果及其在模型卡所公布比較集中的相對位置。
|
| Terminal-Bench 4.0 | 65.7 | 第二 |
| SWE Marathon v1.1 | 51.7 | 第一 |
| Program Bench | 31.5 | 第四 |
| OfficeQA Pro v2 | 64.4 | 在已報告結果中名列第一 |
| Frontier Finance | 58.6 | 第二 |
這些結果支持你測試模型在延伸工程任務與文件工作流程上的應用價值。Kimi K3.1 Pro 在 SWE Marathon 中名列第一,但在 ProgramBench 中排名第四,兩者都值得用於特定應用的測試。
這些名次是根據官方比較表計算,而非即時全球排行榜。不同的評測框架、工具、推理預算與樣本選擇都會影響結果。
在做出部署決策時,請以實際工作建立小型評估集:倉庫修補、跨文件問題、與多步工具任務。測量完成品質、人工修正與耗時。已發布分數有助於篩選;是否值得部署則須由你的應用測試決定。
如何優化 Kimi K3.1 Pro 的本機推理?
控制上下文與並發
一旦短請求可運作,再分別測試長文件、影像、多輪對話與工具呼叫。
追蹤在目標上下文長度與並發下的首 token 延遲、每秒輸出 token 數與 GPU 記憶體峰值。同時記錄任務成功率與每個成功任務的成本,以免更快的輸出掩蓋了更多重試或人工修正。
一次只改變一個主要變數。同時增加上下文長度、並發與優化設定會讓效能回退難以解釋。
審慎選擇推理強度與快取設定
請根據任務使用 low、high 或 max 的推理強度。介面檢查從 low 開始,然後在困難任務上比較 high 與 max,並同時觀察完成品質與耗時。更長的推理軌跡本身不是更好結果的證據。
對於長工作階段,在加入 speculative decoding 或更多並發之前,先評估快取容量與前綴重用。保留已知良好的基準,一次只改變一個設定。
為什麼 Kimi K3.1 Pro 的工具呼叫在部署後會失敗?
你的應用會執行工具呼叫、回傳其結果,並延續對話。請保留完整的助理訊息——包含 reasoning_content 與 tool_calls——並以對應的 tool_call_id 回傳每個工具結果。
多輪處理也很重要。該模型的使用指南要求保留完整的助理訊息,包含推理與工具呼叫欄位,而不是只保留最終文字。
|
| 無法識別的模型架構 | 執行期版本、自訂程式碼與配置 |
| 載入時記憶體不足 | GPU 容量、並行度與競爭程序 |
| 短請求可行但長請求失敗 | 上下文限制、快取容量與並發 |
| 工具呼叫無法解析 | 解析器設定與工具模式 |
| 代理在請求工具後即停止 | 應用程式執行與工具結果處理 |
| 多輪答案變得不一致 | 缺失助理訊息欄位 |
請使用最小可重現請求來隔離每個故障。一旦可行,再逐一恢復應用程式的其他設定。
應該自託管還是使用託管 API?
當你需要掌控權重、基礎設施或資料位置,且能讓 GPU 保持有效使用時,請選擇自託管。若是初步評估或需求變動,請使用相同的提示與驗收標準比較官方 Kimi API與CometAPI。確認各服務的模型存取、支援參數、配額與資料處理條款。
|
| 能力成本 | GPU 購買或租用,包含閒置時間 | 依 API 用量計費;請查各供應商的最新費率 |
| 儲存與網路 | 檢查點儲存、快取與網路費用 | 應用端的任何儲存與網路費用 |
| 營運 | 部署、監控、升級與復原 | 整合、配額管理與請求監控 |
| 重試 | 將其 GPU 時間計入運算成本 | 將其 token 或呼叫計入 API 費用 |
| 人工審閱 | 以相同費率計入修正時間 | 以相同費率計入修正時間 |
| 最佳適配 | 穩定需求與基礎設施掌控 | 評估階段與需求變動 |
每個成功任務的成本 =(GPU 運算或 API 費用 + 儲存與網路 + 營運 + 人工修正)/ 成功完成的任務數。
請使用相同量測期間的成本與成功任務數。將失敗與重試包含在一次的運算或 API 總額中;不要另外再加一筆重試費用。對混合工作流,同時包含運算與 API 費用。統計唯一完成的任務,而非請求次數。
一台使用率不足的伺服器,即使理論吞吐量優異,也可能依然昂貴。相反地,具備既有基礎設施、穩定需求與嚴格資料要求的團隊,可能從自託管中獲得可觀的價值。
在比較部署途徑時,請使用相同的提示與驗收標準。將端到端延遲與輸出品質納入決策。
在不載入權重的情況下試用託管端點
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
請使用相同驗收標準,將結果與你的本機端點進行比較。在估算生產成本之前,請檢查當前路由價格與支援的參數。
結論
在具備支援的 GPU 配置與相符的推理環境下,自託管 Kimi K3.1 Pro 是可行的。請依上述步驟建立可運作的端點,然後在你的工作負載上衡量任務品質、延遲與成本。若仍在驗證應用或缺乏合適硬體,請選擇託管 API。
FAQ
一般筆電能完整執行該模型嗎?
對於原始檢查點的容量需求,一般筆電並非實際可行的目標。它可以作為用戶端,連線到你的推理伺服器或託管 API。
安裝桌面應用程式算是本機部署嗎?
應用程式的安裝位置不代表推理發生的位置。自託管要求模型權重與推理程序在你掌控的基礎設施上執行。
為什麼模型需要這麼多記憶體,明明只有 104B 參數是活躍的?
不同的 token 可以選擇不同的專家。活躍參數描述的是參與計算;部署仍需儲存並存取完整的權重集。
我可以立即啟用完整的百萬 token 上下文嗎?
請逐步增加上下文長度,並在目標並發下量測 GPU 記憶體用量。模型支援 1,048,576 個 token,但可用的服務容量取決於你的快取與並行設定。
本機部署會重現已發布的基準分數嗎?
不會自動重現。量化、推理預算、工具、提示與評測框架都會影響結果。請針對你的任務驗證配置。
在買硬體前是否應該先透過 API 測試?
若你尚未確定模型符合品質要求,API 測試能以較少的基礎設施工作提供初步基準。有合適硬體與明確資料所在地需求的團隊,可以直接進行受控的自託管評估。