
TL;DR
Kimi K3.1 Pro 是 Moonshot AI 於 2026 年 10 月 24 日對 Kimi K3 的升級版本。額外的後訓練提升了自主編碼、財務研究與延伸工具使用的工作流程,同時維持約一百萬 token 的上下文容量。
獨立評估顯示整體表現更強,且官方標準輸入/輸出 token 費率下降三分之一。升級仍需進行工作負載測試:更深層的推理可能提高任務延遲與總支出;同時,K3 在 AA-LCR 上仍略有領先,且目前可用於自託管的權重已可取得。
Key Takeaways
- 最明顯的提升在代理式執行。 Artificial Analysis 報告 K3.1 Pro 在 Terminal-Bench 4.0 的分數約為 67%,而 K3 約為 13%;Moonshot 的內部 Financial Research 分數由 58.8 提升至 70.4。
- 較低的 token 價格不保證較低的任務成本。 官方標準輸入/輸出費率由每百萬 $3/$15 降至 $2/$10,但額外的推理、工具調用與重試可能抵銷節省。
- 上下文視窗保持不變。 兩個模型皆支援最多 1,048,576 個 token。K3 在引用的 AA-LCR v1.1 評估中仍略勝一籌,因此請在您自己的文件上測試長上下文的準確性。
- 權重可用性可能決定選擇。 截至 2026 年 10 月 24 日,K3 權重已可取得;K3.1 Pro 權重預定於 11 月 4 日前釋出。需要立即自託管的團隊應將此差異納入考量。
Kimi K3.1 Pro vs Kimi K3: Overview and Specifications
Kimi K3.1 Pro 在 K3 基礎上進一步後訓練,重點改進編碼、財務研究與延展式代理工作流程。兩者均保留約一百萬 token 的上下文容量。主要差異在於任務表現、token 定價、服務選項與權重可用性。
| 規格 | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | October 24, 2026 | July 16, 2026 |
| Architecture | K3-derived MoE, further post-trained | MoE with KDA, AttnRes |
| Model size | 3T-class and 104B active parameters | 2.8T total and 104B active parameters |
| Context window | Up to 1,048,576 tokens | Up to 1,048,576 tokens |
| Standard API input / output price | $2 / $10 per million tokens | $3 / $15 per million tokens |
| Highspeed version | Available | No separate K3 Highspeed variant is listed |
| Weight availability | Release planned by November 4, 2026 | Available under the Kimi K3 License |
權重可用性反映截至 2026 年 10 月 24 日的資訊。API 價格以美元計算,僅針對常規輸入與輸出,不含快取寫入費用、稅費與其他適用費用。
Architecture and Post-Training
K3 引入了一個 2.8 兆參數的架構,結合 Kimi Delta Attention、Attention Residuals 與 Stable LatentMoE。每個 token 啟用約 104 億參數。
Moonshot 將 K3.1 Pro 描述為以更大後訓練算力在 K3 基礎上後訓練而成。升級聚焦於將模型能力運用於多步任務,包括工具使用、除錯與結果驗證。公告未引入單獨命名的基礎架構。
Shared Capabilities and API Requirements
兩個模型均支援多模態輸入、工具調用、結構化輸出與上下文快取。影像與影片輸入格式取決於所選 API 路徑。兩者皆會進行推理,並支援 low、high 與 max 的推理力度,預設為 max。
對於多輪對話與工具調用,整合需按 API 要求保留完整的助理訊息,包括推理內容與工具調用。實際上下文限制與功能可用性亦應依所選供應商、產品與訂閱等級確認。
Kimi K3.1 Pro vs Kimi K3: Performance
證據來自 Moonshot 的內部測試與報告比較,以及獨立的第三方評估。
由於基準測試框架、測試集、推理設定與評分標準可能不同,應分別解讀。
Artificial Analysis 的發佈評估報告其綜合 Intelligence Index 提升 11 分,特別是在基於終端機的編碼與代理工作流程上有大幅改善。
| 獨立基準(Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | 差異 |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 個百分點 |
| AutomationBench-AA | 58% | 73% | +15 個百分點 |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 個百分點 |
| AA-Omniscience hallucination rate | 53% | 44% | −9 個百分點 |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 個百分點 |
以上為獨立評估結果。在評估者提供四捨五入分數的情況下採用四捨五入值。較低的幻覺率更佳。
最大提升出現在基於終端機的編碼上。K3.1 Pro 在需要命令執行、環境互動、除錯與重複驗證的任務上表現顯著更好。
AutomationBench-AA 亦顯示明顯增益,暗示在 SaaS 工作流程中的執行力更強。
Moonshot 的發佈基準聚焦於編碼、科學、3D 重建、金融、知識工作與自主代理。
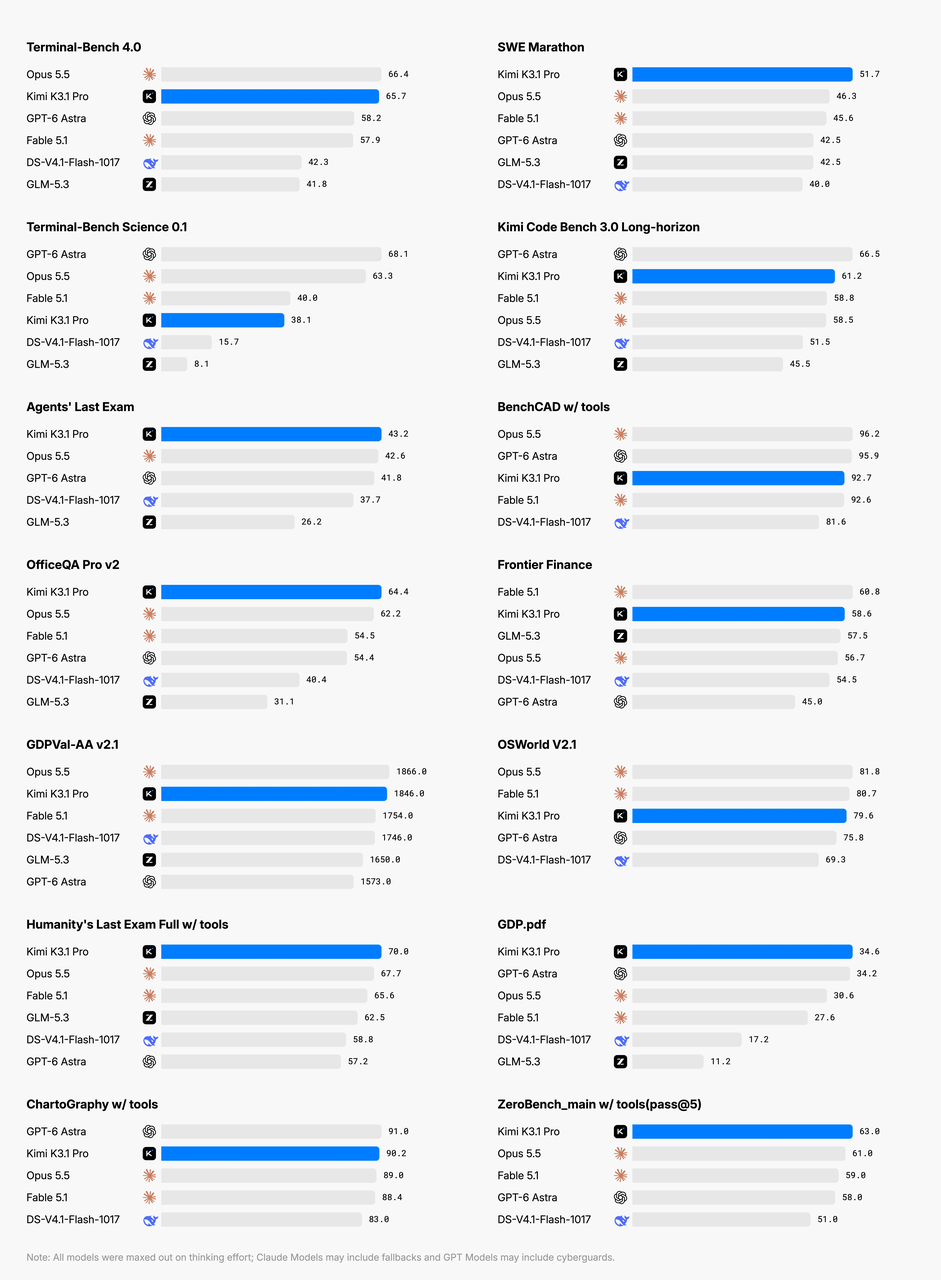
所選比較包含 Claude Opus 5.5 與 GPT-6 Astra。請在各自命名的基準與設定下比較結果。
| 基準(Moonshot AI) | Kimi K3.1 Pro | 其他模型 | 比較模型分數 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro 在部分選定任務中逼近或超越多個領先的專有模型,但並非在所有類別都占優。
例如,在供應商報告的 BenchCAD 與 OSWorld 比較中,仍落後於 Claude Opus 5.5,且官方圖表顯示在 Terminal-Bench Science 上的弱勢更大。
評估設定各異:Artificial Analysis 在 Terminal-Bench 4.0 中採用 mini-swe-agent 框架,而 Moonshot 使用 Claude Code。請在同一測試設定中比較分數;框架、推理力度與執行時限會影響結果。
Coding and Software Engineering
對於複雜的自主編碼,K3.1 Pro 通常是更強的選擇。
Moonshot 的內部 Kimi Code Bench 3.0 Long-horizon 結果由 K3 的 55.95% 提升至 K3.1 Pro 的 61.2%,約增加 5.25 個百分點。
獨立的 Terminal-Bench 結果也顯示顯著提升。這些測試評估多步執行:理解代碼庫、修改檔案、執行命令、診斷錯誤與驗證結果。
K3.1 Pro 更適合多檔開發、自主終端機工作與延伸除錯。對於簡單代碼生成,請在您自己的任務上比較兩者;當需要立即自託管時,K3 仍是現成選項。
一個重要區別是,編碼基準的分數高度依賴代理框架。工具、提示詞、執行時限與測試環境都會影響結果。
在生產軟體開發中,最佳評估仍是針對您自己的代碼庫進行匹配比較。
Financial Research and Business Operations
在金融建模中,兩者差異最為直觀。
Moonshot 將 K3 與 K3.1 Pro 用於內部評估,涵蓋試算表構建、研究品質與模擬商務運營。
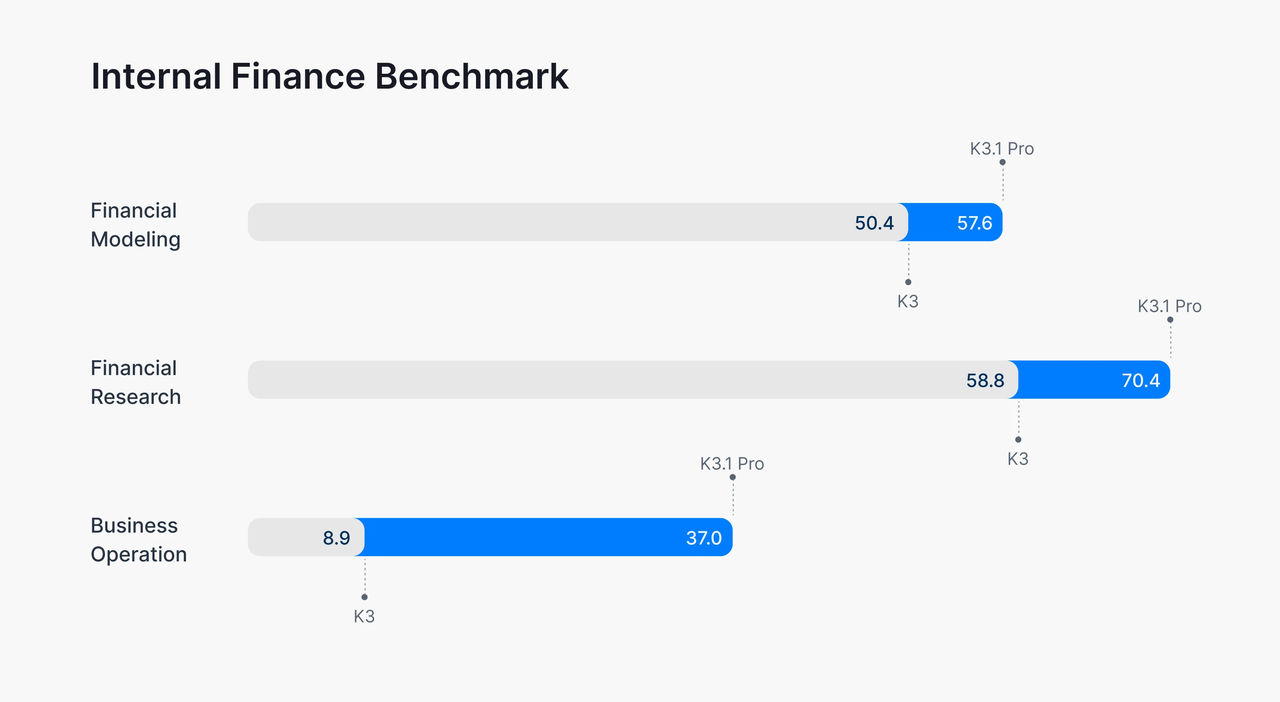
Moonshot 的內部財務結果涵蓋金融建模、研究與模擬商務運營。這些由供應商報告的任務分數並非投資報酬的衡量。每個任務的設定不應假設與不相關的基準一致。
在 Moonshot 的內部測試中,Financial Modeling 從 50.4 提升至 57.6,上升 7.2 分;Financial Research 從 58.8 提升至 70.4,上升 11.6 分。Business Operation 從 8.9 提升至 37.0,約為 K3 分數的 4.2 倍。
該基準評估在模擬商務環境中的長期管理與決策,因此更接近代理式規劃,而非簡單的金融問答。
Financial Research 評量在遵守來源要求與資訊截止的前提下,產出有證據支持的研究能力。Financial Modeling 聚焦於數學關係、試算表邏輯與活頁簿品質。
此模式顯示,當金融任務需要持續推理、驗證與結構化交付物時,K3.1 Pro 特別有價值。
對投資人、分析師與商務使用者而言,實際收益可能是更好地處理多文件工作流程。任何一個模型都不應作為金融決策的不加質疑的權威。
Long-Context Reasoning and Factual Reliability
然而,AA-LCR 長上下文結果顯示 K3 略勝一籌。這提醒我們,較新的模型可以整體大幅進步,但不一定在每個專項任務中獲勝。
報告的評估顯示在各自測試集上更少的事實錯誤。
在 Kimi Hallu Bench Hard with tools 中,Moonshot 報告聲稱層級錯誤率從 K3 的 23.4% 降至 K3.1 Pro 的 8.3%。
這約為 Moonshot 刻意困難壓力測試中的相對 65% 降幅,而非日常錯誤率的估計。另方面,Artificial Analysis 報告 AA-Omniscience 的幻覺率從 53% 降至 44%。兩種評估方法不同,百分比不直接可比。
實際經驗是,K3.1 Pro 在所評估任務上顯得更可靠,但事實改善不會消除在重要工作流程中對檢索、引用、計算檢查與人工審閱的需求。
Data Analysis: Evidence from Plotly’s Evaluation
Plotly 透過 OpenRouter 使用標準 K3.1 Pro,對合成風能數據倉庫進行 43 題的私有測試,未測試 Highspeed。結果展示了在該特定以 SQL 為基礎的分析工作流程中,答案品質、完成時間與成本之間的取捨。
| Plotly 數據分析衡量 | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| 正確答案 | 35/43 | 42/43 |
| 準確率 | 81.4% | 97.7% |
| 發現的隱藏模式 | 0/5 | 5/5 |
| 識別的資料品質問題 | 1/3 | 3/3 |
| 完整評測成本 | $5.01 | $13.47 |
| 每題中位時間 | 43 seconds | 2.5 minutes |
在此評估中,K3.1 Pro 回答更多問題正確,並識別更多隱藏模式與資料品質問題,但成本更高且中位完成時間更長。
所報告的費用為觀察到的評測成本,而非依 Moonshot 標準 API 價格計算的估算。發佈設定未能證明兩次模型運行的供應商設定完全一致,因此差異不能僅歸因於模型本身。
這些結果支持在分析任務中評估 K3.1 Pro,尤其是當額外發現值得更多時間與支出時。它們並未證明在不同工作負載上具有相同的準確性或成本優勢。
Is Kimi K3.1 Pro Faster Than Kimi K3?
請區分輸出 token 吞吐量與端到端任務延遲。
Artificial Analysis 報告在 Kimi 的 API 上、最大推理力度下,K3.1 Pro 的輸出吞吐量為每秒 73.5 個 token,而 K3 為 38.5。這些為 2026 年 10 月 24 日核對的 token 生成測量值;總體任務延遲亦取決於推理長度與工具執行。
然而,更快的 token 生成不保證更快完成任務。
Moonshot 亦提供 K3.1 Pro Highspeed,宣稱輸出速度約為標準版本的兩到三倍。這是服務速度的提升,並非另一次被驗證的智慧升級。
K3.1 Pro 擁有更高的輸出 token 吞吐量,但不一定更快完成任務。請區分生成 token 的速度與推理、工具調用以及完成工作的耗時。
Output Speed vs. Task Completion Time
Artificial Analysis 報告在 Kimi 的 API 上、最大推理力度下,K3.1 Pro 與 K3 的輸出速度分別為每秒 73.5 與 38.5 個 token。這些測量描述的是 token 生成吞吐量,而非端到端任務延遲。
若模型生成更多推理 token 或進行額外工具調用,即使生成更快,也可能整體耗時更長。在上述 Plotly 評估中,K3.1 Pro 的每題中位完成時間為 2.5 分鐘,而 K3 為 43 秒,同時前者的準確率更高。
對互動式應用,請在實際供應商路徑上測量首 token 時間與總任務完成時間。僅靠輸出吞吐量不足以預測響應性。
Consider K3.1 Pro Highspeed
Moonshot 宣稱 K3.1 Pro Highspeed 可提供約為標準版兩到三倍的輸出速度。此聲明涉及服務速度,不應被解讀為總任務完成時間減少兩到三倍。
在使用者等待回應的互動式編碼或助理場景,可考慮 Highspeed。選擇前請比較端到端延遲、任務成功率與總計費成本與標準端點的差異。Highspeed 的常規輸入與輸出 token 價格更高,而其快取輸入命中費率相同。
Kimi K3.1 Pro vs Kimi K3: Cost
Official API and CometAPI Rates
標準 K3.1 Pro 的官方輸入、輸出與快取命中費率較 K3 降低三分之一。列示的 CometAPI 輸入與輸出費率相較對應的官方費率再低 20%。
| 模型 | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
每百萬 token 的美元價格;於 2026 年 10 月 24 日核對。輸入欄位為常規未快取的輸入費率。未含稅費與另行計費項目。
Official Kimi pricing 亦列出快取寫入費用:標準 Pro 在 5 分鐘/1 小時保留下分別為每百萬 $2/$4;Highspeed 為 $4/$8。快取命中、快取寫入與常規輸入為分開、互斥的計費類別。
Official Kimi 與 CometAPI 為不同供應商路徑。請確認所選路徑的當前價格與快取支援,包括 Highspeed 是否可用。比較總計費任務成本以及 token 費率。
Fixed-Token Cost Example
考慮一個耗用 100,000 個未快取輸入 token 與 20,000 個輸出 token 的工作負載。
在官方 API 上,此固定工作負載使用 K3 的成本為 $0.60,使用 K3.1 Pro 為 $0.40。在列示的 CometAPI 費率下,對應成本分別為 $0.48 與 $0.32。以上僅包含所述輸入與輸出 token。
但這是固定 token 的比較。複雜的代理工作流程可能因模型不同而消耗不同數量的推理 token 與工具調用。
Token Savings Disapears
設 I 為相同的未快取輸入 token 數,O 為 Kimi K3 的計費輸出 token 數,P 為 Kimi K3.1 Pro 的計費輸出 token 數,單位皆為百萬。在定價表的官方標準費率下,費用分別為 3I + 15O 與 2I + 10P 美元。當 P = 1.5O + 0.1I 時兩者相等。
對輸出量大的請求而言,K3.1 Pro 因此可在計費輸出 token 約多 50% 的情況下仍保有價格優勢。此計算假設費率不變,且不含快取、工具費與其他另行計費的用量。請以實際計費 token 類別為準,而非可見答案長度。
Cost per Successfully Completed Task
將所有評估嘗試的總計費成本除以符合預先定義接受標準的唯一任務數,計算每個成功任務的成本。若供應商對失敗嘗試、重試與逾時計費,請將其納入;僅以成功運行的成本除以其數量,可能低估每個成功任務的成本。
在 Kimi K3 與 K3.1 Pro 之間,保持任務集合、接受標準、重試上限與逾時策略一致。報告成功率與每個成功任務成本,以避免通過刪除困難任務使模型看似更經濟。若無任務成功,則每個成功任務的成本未定義,而非零。
Kimi K3.1 Pro vs Kimi K3: Comparison and Selection
對於大多數託管的代理工作負載,K3.1 Pro 是更強的起點。然而,決策應反映任務複雜度與部署需求。
| 使用場景 | 建議模型 | 理由 |
|---|---|---|
| 自主編碼 | Kimi K3.1 Pro | 評估多檔變更、終端機工作、除錯與最終測試結果。 |
| 多文件金融研究 | Kimi K3.1 Pro | 研究與商務運營基準有改善 |
| 複雜數據分析 | Kimi K3.1 Pro | 更佳的問題發現與資料品質檢查 |
| 3D 建置與 CAD 工作流程 | Kimi K3.1 Pro | 強大的專業工具輔助能力 |
| 簡單文本任務 | 兩者皆基準比較 | 在常規文本與簡單編碼任務上比較;額外推理可能增加延遲而不提升可接受結果。 |
| 長上下文檢索準確性 | 兩者皆基準比較 | K3 在 AA-LCR 上略有領先 |
| 立即自託管 | Kimi K3 | 可下載權重已可取得 |
| 互動式高能力代理 | K3.1 Pro Highspeed | 更快的服務速度,但需驗證成本 |
| 成本敏感的生產工作流程 | 兩者皆基準比較 | 較低 token 定價不一定意味較低任務成本 |
Hosted Automation and Professional Workflows
對於託管的編碼代理與分析工作流程,請在實際工作的難點上評估 K3.1 Pro:多檔變更、證據收集、計算檢查與失敗工具調用後的恢復。優先考量失敗任務或補救工作的可測量減少,而非僅依賴更高的標題分數。
對已建立的 K3 應用,保留現有路徑作為比較基線。常規任務可能已達可接受門檻,而專門的長上下文任務可能與聚合基準表現不同。優先在升級可帶來可測量收益的工作負載段落上進行。
Self-Hosting and Deployment Constraints
截至 2026 年 10 月 24 日,K3 的完整權重可在遵守模型授權與硬體需求的前提下部署。K3.1 Pro 的完整權重尚未發佈。
Moonshot 計畫在 2026 年 11 月 4 日前釋出 K3.1 Pro 權重。這是已公告的發佈計畫,而非現有檢查點;在排程自託管前,請確認已發佈的權重與適用條款。
Production Evaluation Criteria
在代表性任務上比較 K3 與 K3.1 Pro,使用相同的提示、工具、接受標準、重試上限與逾時設定。記錄供應商與推理設定,並按 API 要求保留完整的助理訊息。
測量任務成功率、延遲、token 用量與每個成功任務成本,包含計費的失敗與重試。檢視 K3 成功但 K3.1 Pro 失敗的案例。對人工評估,隱藏模型標籤並隨機化輸出順序。
若 K3.1 Pro 符合品質、延遲與成本門檻,請逐步上線,並保留經過測試的 K3 後備方案。
Controlled Migration and Fallbacks
實務上可先將小比例生產流量導向 K3.1 Pro。
在驗證期間保留 K3 作為後備。比較任務品質、延遲、失敗率與支出後,再逐步提高 K3.1 Pro 的使用比例。
特別留意工具調用結構、推理相關訊息欄位、多模態輸入與輸出解析。API 相容不代表應用行為必然一致。
Benchmark Gains and Regressions
若兩個模型回答相同 43 題,分數分別為 35 與 42,K3.1 Pro 可能修正了 K3 的 7 個錯誤,且無退步;也可能修正 8 個錯誤,但失去 1 個原本正確答案。總分無法區分這些情況。
檢視配對答案,將其分類為兩者皆正確、僅 K3 正確、僅 K3.1 Pro 正確或兩者皆錯。先審視 K3 專屬成功案例是否對最高影響任務至關重要再進行遷移。42/43 的結果描述的是該測試集;不保證在不同工作負載上達到 97.7% 成功率。
Blind Evaluation of Model Outputs
隱藏模型標籤並隨機化審閱者看到輸出的順序。先定義接受規則:對於代碼,使用可執行測試與回歸檢查;對於研究,檢查來源支持、計算與是否按要求完成交付物。先評分正確性,再考量呈現或寫作風格。
僅在品質評估記錄後才揭示模型身份、延遲與計費成本。這可將輸出品質與對新模型的預期分離。對審閱者分歧按相同測試或來源解決,並保留決議,以便後續模型或提示變更能一致評估。
Where Can You Access Kimi K3.1 Pro and Kimi K3?
Official Provider Access
使用 Moonshot 的 Kimi K3 API 或 Kimi K3.1 Pro API 進行直接供應商整合。請查看所選端點的模型識別符、支援的請求欄位與帳戶限制。公共 API 存取與可下載模型權重是不同的部署選項。
Access Through CometAPI
開發者可透過 CometAPI 的統一介面存取 Kimi K3.1 Pro API 與 Kimi K3 API,並以相同的應用工作負載比較兩種路徑。
這使得從 K3 遷移到 K3.1 Pro 相對直接,特別是對已使用 OpenAI 相容聊天介面的應用。
使用 CometAPI 時,建立帳戶與 API 金鑰,然後依整合文件在應用中配置端點與模型識別符。選擇 kimi-k3 代表 K3、kimi-k3.1-pro 代表標準 K3.1 Pro、或在支援時選擇 kimi-k3.1-pro-highspeed 代表 Highspeed 路徑。從小型請求開始,然後在檢查返回結果、延遲與計費用量的同時,跨模型比較相同工作負載。
Conclusion
在此處評估中,Kimi K3.1 Pro 是針對高要求的自主編碼、財務研究與延展代理工作流程的更強候選。Kimi K3 仍適用於需要立即自託管的場景,以及其現有準確性或延遲表現已符合需求的工作負載。
請使用代表性任務與實際供應商路徑進行選擇。比較成功結果、延遲與總支出,然後逐步遷移。較低的 token 價格與較高的聚合基準分數是有用的起點,但不代表對每個應用都是最佳配置。