

重點摘要
Muse Wonder、Claude Opus 5.5 與 GPT-6 Sol 是面向程式設計與代理工作流程的高能力模型。Meta 的全新 Muse Wonder 強調持久記憶與持續執行;Opus 5.5 在所引述的整體智能指數中領先;GPT-6 Sol 在本次比較中的標準短上下文輸入與輸出費率最低,但其長上下文層級採分開定價。選型時應根據具代表性的任務品質、可靠性與總成本,而非單一排行榜分數。
關鍵重點
- 整體智能:在報告的 Intelligence Index v4.3 中,Claude Opus 5.5 為 58,Muse Wonder 為 52。
- 長時程程式設計:Muse Wonder 的 DeepSWE 1.1 為 78.8、SWE-Marathon 為 53.1;Opus 5.5 於 Meta 表中分別為 74.2 與 46.3。
- 低成本推理:GPT-6 Sol 透過 OpenAI 的短上下文標準 API,輸入每 100 萬 tokens $2、輸出 $10 起。
- 聚焦記憶的代理:Muse Wonder 引入 Active Memory 與 Active Focus。
- 可用性很重要:Muse Wonder Full 與開發者可存取的標準版 Muse Wonder 為不同且限制較多的獨立產品。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol 一覽
長期運行的持久型代理與工程任務選 Muse Wonder;廣泛程式設計與終端機密集工作選 Claude Opus 5.5;追求標準短上下文較低 token 成本選 GPT-6 Sol。
| 決策因素 | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| 建議起手測試於 | 持久型代理與延伸工程作業 | 終端機密集的程式設計與專業工作流程 | 對成本敏感的程式設計與自動化 |
| 上下文視窗 | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| 已公布強項 | DeepSWE 78.8;SWE-Marathon 53.1 | Intelligence Index 58;ProgramBench 70.5 | 標準輸入/輸出每 1M tokens $2/$10 |
| 每 100 萬 tokens 的標準輸入/輸出 | $4 / $20 | $4 / $20 | $2 / $10;短上下文層級 |
| 供應商存取 | Meta Model API;Full 為獨立的訂閱產品 | Anthropic API | OpenAI API |
| 選擇指標 | 已接受任務的品質與總成本 | 已接受任務的品質與總成本 | 已接受任務的品質與總成本 |
| 開發者 | Meta | Anthropic | OpenAI |
| 發布 | October 12, 2026 | September 22, 2026 | September 16, 2026 |
| 輸入模態 | 文字、影像、音訊、視訊;PDF 輸入已有文件 | 文字、影像 | 文字、影像 |
| 輸出 | 文字 | 文字 | 文字 |
| 特色能力 | Active Memory 與 Active Focus | 工具與子代理工作流程 | 可配置推理強度與 API 工具 |
此概覽總結下文所檢視且帶日期的規格與公布結果。基準列使用不同的評估方法;較低的 token 費率不代表每項成功任務的成本更低。標準版 Muse Wonder 與 Muse Wonder Full 為不同的存取選擇。
規格檢查於 2026 年 10 月 13 日完成。支援的模態與功能取決於所選端點與發布介面,包含音訊可用性。模型層級能力不保證於每一個閘道路由都受支援。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol:概述與規格
Muse Wonder:持久型代理工作流程
Meta 於 2026 年 10 月 12 日推出 Muse Wonder 與 Muse Wonder Full。標準版 Muse Wonder 強調長時間的專業任務、持久的代理記憶與從阻礙中恢復。Active Memory 旨在擷取有用的既有脈絡,Active Focus 則用於在多步驟工作中維持進展。Meta 指出程式設計、研究、財務分析與個人助理是關鍵情境。
Claude Opus 5.5:專業程式設計與工具使用
Claude Opus 5.5 聚焦程式設計、推理與多工具的專業工作流程。Anthropic 於 2026 年 9 月 22 日發布。其上下文視窗為一百萬 tokens,下文所列的程式設計結果顯示不同基準下的強弱差異。
GPT-6 Sol:注重成本的推理
GPT-6 Sol 旨在結合強大的推理與工具使用,並提供相對實惠的推論成本。它透過 OpenAI 的 API 生態系支援程式化工作流程。其標準短上下文費率較所列的 Claude Opus 5.5 低,但端到端經濟性亦取決於重試與推理 token 使用。
OpenAI 將 GPT-6 Sol 描述為面向複雜程式設計與代理式工作流程的模型;其發布公告提供了下述評估結果。本文比較的是特定模型版本,而非各供應商產品線中的所有新型號。
架構與推理控制
所引來源未提供三款模型可比的參數規模與架構拆解。因此不應進行密集模型與專家混合架構的排名。Active Memory 與 Active Focus 描述的是 Meta 的代理能力,並不等同於已披露的神經架構。GPT-6 Sol 提供可配置的推理強度;而所報告的 Meta 與 Claude 分數亦取決於努力程度與評估設定。應將這些設定視為被比較配置的一部分,而非可互換的運算量衡量。
比較結果: 三者皆提供大型上下文視窗與開發者 API。Muse Wonder 在模型層級文件上記載的輸入模態更廣;Opus 5.5 與 GPT-6 Sol 則強調文字與影像工作流程。上下文容量與功能可用性仍需於所選端點上逐一確認。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol:效能
已公布基準與來源界限
Meta 的官方模型卡提供 Muse Wonder 與 Claude Opus 5.5 的直接比較。OpenAI 另行發布 GPT-6 Sol 的結果,因此若不統一評測工具、版本與設定,三款模型無法置於同一完全受控的排行榜上。
| 基準測試 | Muse Wonder | Claude Opus 5.5 | 較高分數 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
官方模型卡方法論區分了內部測試、第三方評估與由供應商回報的競品分數。上表為轉錄的公布數值;並不構成各列統一、獨立受控的試驗。
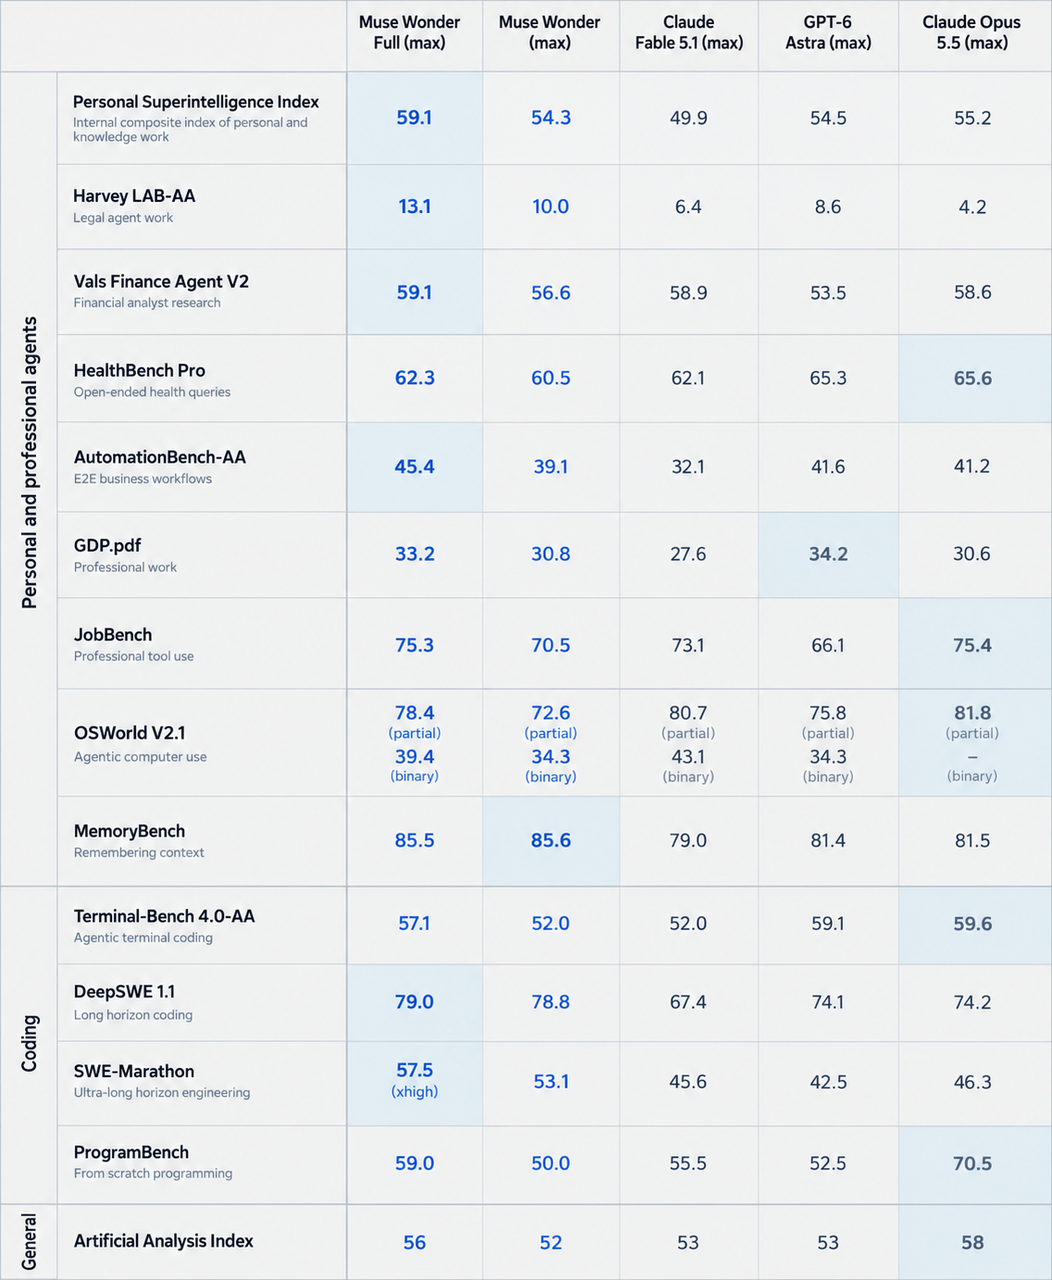
摘自 Meta 的 Muse Wonder 模型卡之原始基準成績表,未重新繪製。此官方圖片中另外顯示的 OpenAI 模型為 GPT-6 Astra,非 GPT-6 Sol。文內周邊表格則標示了與本文相關的模型。
評估條件
DeepSWE v1.1 涵蓋 5 種語言、91 個版本庫中的 113 個任務,以功能與回歸測試的 pass@1 評分;Meta 的成績卡使用 Muse Wonder 與 Opus 5.5 的 Datacurve 結果。SWE-Marathon 使用專案測試,報告來自 Abundant AI 的 pass@1;代理工具各異,且 Wonder Full 的成績標註為 xhigh。ProgramBench 使用 mini-swe-agent,測量通過至少 95% 隱藏測試的展開情況,並在設定完成後停用網際網路。這些環境與指標不應被壓縮為單一的通用準確率分數。
程式設計與軟體工程
在所報告的 DeepSWE 1.1 與 SWE-Marathon 上,Muse Wonder 領先。Claude Opus 5.5 則在 Terminal-Bench 4.0-AA 與 ProgramBench 領先。此差異顯示長時程工程、命令列工具使用與程式重建側重於不同技能。
GPT-6 Sol 結果與跨來源可比性
| OpenAI 公布的評測 | GPT-6 Sol | 報告設定 |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum 推理 |
| AutomationBench 1.0.6 | 33.2% | xhigh 推理 |
| Agents' Last Exam V1 | 56.4% | Maximum 推理 |
| OSWorld 2.0 offline | 60.5% | xhigh 推理 |
OpenAI 的公布的評測結果報告了上述分數。其 OSWorld 結果是離線 v2026.08.08 集的部分獎勵,而非嚴格的任務完成率。OpenAI 指出評估使用其研究環境或 API;實際生產配置可能不同。
所報告的 DeepSWE 分數顯示 Muse Wonder 與 GPT-6 Sol 之間約 10.0 個百分點的差距,Opus 5.5 與 GPT-6 Sol 之間約 5.4 個百分點。這些是出版物的算術差異,並非在模型因素受控下的優勢估計。不同代理設定、提示詞、努力程度與工具預算都可能影響結果。
記憶與長時程代理
Muse Wonder 針對需要記住先前決策、恢復脈絡並延續中斷工作之代理。Active Memory 可協助研究助理記住專案特定事實,Active Focus 支援當先前方案未成功時的迭代行動。這些產品能力不取代狀態驗證、權限控管、稽核軌跡或敏感操作的強制人工確認。
Muse Wonder Full 效能
Muse Wonder Full 為獨立產品選項。Meta 透過 API 提供標準版 Muse Wonder;Full 則僅對 Muse Code 的 Power Usage 與 Maximum Usage 訂閱開放。較高的分數並不代表 Full 可作為標準 API 模型的替代。
根據 Meta 報告,Wonder Full 的結果為 Intelligence Index 56、Personal Superintelligence 59.1、Harvey LAB-AA 13.1、AutomationBench-AA 45.4;DeepSWE 1.1 為 79.0、SWE-Marathon 57.5、MemoryBench 85.5、JobBench 75.3。這些公布結果描述的是獨立存取的 Full 產品;並非在共同測試工具下的新比較。
與上方標準版 Muse Wonder 相比,Full 在八個指標中的七項有所提升;MemoryBench 略降(85.5 對 85.6)。Opus 5.5 仍以 Intelligence Index 58 領先。
延遲與可靠性
所引證據未提供三款模型相互匹配的延遲比較。請量測首次有用輸出的時間、中位與 95 百分位端到端任務時間、逾時頻率與無需干預的完成率。固定任務輸入、工具權限、並行度與驗收標準;記錄努力設定與重試預算。更快的 token 生成速度不等於多步驟任務更快完成。
比較結果: Muse Wonder 在所引之持續工程測試領先;Opus 5.5 在終端與程式重建測試領先。GPT-6 Sol 仍是較低 token 價格的候選,但現有出版內容未能證明三者在相同環境下的品質或速度排名。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol:成本
官方 API token 價格
| 每 1M tokens 價格 | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| 標準輸入 | $4 | $4 | $2 |
| 標準輸出 | $20 | $20 | $10 |
| 快取輸入 | $0.20 | $0.20 | $0.20 |
| 長上下文輸入 | $4 | $4 | $4 |
| 長上下文輸出 | $20 | $20 | $15 |
| 長上下文快取輸入 | $0.20 | $0.20 | $0.40 |
Meta 公布每 100 萬 tokens 的輸入 $4、輸出 $20、快取輸入 $0.20。Anthropic 將 Opus 5.5 列為輸入 $4、輸出 $20、快取命中 $0.20。OpenAI 的價格表列出 GPT-6 Sol 的短上下文輸入/輸出為 $2/$10,長上下文為 $4/$15;快取輸入費率亦隨層級而異。在估算工作量前,請套用每次請求的對應上下文層級、處理模式與端點條件。
對於 GPT-6 Sol,當請求包含超過 272,000 個輸入 tokens 時,將按較高費率計價:
- 輸入 tokens:為標準費率的 2 倍,從每 1M tokens $2 升至 $4。
- 快取輸入 tokens:為標準費率的 2 倍,從每 1M tokens $0.20 升至 $0.40。
- 輸出 tokens:為標準費率的 1.5 倍,從每 1M tokens $10 升至 $15。
上述較高費率套用於整個請求,而非僅對超出 272,000 的部分計價。因此,含有 272,001 個輸入 tokens 的請求,其所有輸入、快取輸入與輸出 tokens 均進入長上下文計價層級。
相較之下,Muse Wonder 與 Claude Opus 5.5 在其標準 API 費率下,未施加等同的長上下文加價。
此差異對大型文件分析、涵蓋整個版本庫的程式作業與長時間執行之 AI 代理尤為重要,因為隨著請求變大,GPT-6 Sol 的短上下文價格優勢可能縮小。
CometAPI 價格與計費條件
在審查時,CometAPI 將 Opus 5.5 列為每 1M tokens 輸入 $3.20/輸出 $16,將 GPT-6 Sol 列為輸入 $1.60/輸出 $8。這是 CometAPI 的獨立費率,不可與上述官方供應商價格混為一談。估算成本前請確認適用的路由、上下文層級與帳戶計費條件;價格與條件可能變動。
每個被接受任務的成本
以總計的模型與工具花費(包含收費的重試與降級)除以符合預先定義驗收標準的輸出數量來計算。人工審查時間請另行記錄,或以明確的時薪轉換。分別追蹤失敗請求與實際收費:僅有失敗並不代表該請求未被計費。
比較結果: GPT-6 Sol 的標準短上下文輸入與輸出列價最低;Muse Wonder 與 Opus 5.5 的基本費率相同。實際每個被接受任務的成本取決於選擇的計費路由、快取利用、上下文層級、工具費、重試與審查投入。
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol:比較與選擇
依能力與工作負載的選擇
- 廣泛的程式設計與終端機工作流程:優先嘗試 Claude Opus 5.5,因其在所引的 Intelligence Index、Terminal-Bench 與 ProgramBench 成績領先。請在重構、工具執行與程式層級一致性上驗證。
- 延伸工程專案:優先嘗試 Muse Wonder,因其報告的 DeepSWE 與 SWE-Marathon 結果強於 Opus 5.5。量測任務完成、從阻礙中恢復與總任務成本。
- 持久個人代理:優先嘗試 Muse Wonder,其提供 Active Memory 與 Active Focus,且在所報告的 MemoryBench 分數高於 Opus 5.5。測試召回、更正、連續性與專案隔離。
- 多步驟工具工作流程:三者皆需評估。Muse 提供 Active Focus,Opus 強調工具編排,GPT-6 Sol 支援 Responses API 工具。比較整體代理堆疊,包括工具權限、重試與狀態處理。
- 專業文件與分析:評估 Muse Wonder 或 Claude Opus 5.5。Muse 具專門強項,Opus 在匯總指數上較強。使用具代表性的文件與任務特定驗收標準。
- 高量、成本敏感自動化:優先嘗試 GPT-6 Sol,因其標準短上下文輸入與輸出費率最低。檢查每個被接受任務的成本、上下文層級、延遲與重試。
- 追求 Meta 的最高階選項:若可存取,評估 Muse Wonder Full。其在若干專業任務上報告更高分數,但與標準 API 模型為獨立產品。測試前請確認訂閱存取與適配性。
專業程式設計
對需要廣泛工程助理的團隊而言,Claude Opus 5.5 是不錯的預設選擇,尤其在工具執行、重構與程式層級一致性方面。其在 Terminal-Bench 與 ProgramBench 的優勢強化了此定位,但團隊仍應驗證整體代理堆疊,而不僅是模型。
大規模自動化
在請求數量龐大且成本敏感時,GPT-6 Sol 具吸引力。對於低風險且易於檢查的任務(如文件草擬、結構化欄位擷取、程式碼說明),即使品質略有差距亦可接受。長時間自主運行時,請同時追蹤品質、tokens、延遲與重試。
產品環境評估檢查清單
產品環境評估應追蹤六項指標:正確性(以被接受答案或通過測試衡量);可靠性(無需人工救援完成的任務);延遲(端到端任務耗時);token 使用量(總計計費之輸入與輸出);代理效率(工具呼叫與更正性重試);有效成本(總花費除以被接受任務數)。
比較結果: 將 Muse Wonder 列為持久代理與延伸工程任務的重點候選;Opus 5.5 用於廣泛且終端需求強的程式設計工作流程;在 token 成本為主要限制時選 GPT-6 Sol。僅在候選模型達到任務特定的品質與可靠性門檻後再予以升級部署。
在哪裡可以存取 Muse Wonder、Claude Opus 5.5 與 GPT-6 Sol?
官方供應商存取
標準版 Muse Wonder 使用 Meta Model API,Opus 5.5 使用 Anthropic API,GPT-6 Sol 使用 OpenAI API。Muse Wonder Full 透過指定的 Muse Code 訂閱方案提供,而非標準 API 模型的即插即用替代。請檢查所選路由的帳戶存取、使用限制與請求功能支援。
CometAPI 存取
統一閘道可簡化驗證、計費與路由。複雜的架構審查使用高性能模型,重複且低風險的草擬則用較便宜的模型。務必以目標 API 端點對照模型識別符與支援的請求格式。
開發者可透過 CometAPI 中的 Claude Opus 5.5 API 與 CometAPI 中的 GPT-6 Sol API 評估具代表性的工作負載。請確認各模型支援的 API 表面,而不要假設共享閘道即可讓所有請求格式互通。
本文所引之 CometAPI 路由涵蓋 Opus 5.5 與 GPT-6 Sol。本文未建立 Muse Wonder 或 Wonder Full 的 CometAPI 路由;評估這些產品時請使用已確認的供應商路由。
結論
沒有單一模型在所有工作負載上全面勝出。Muse Wonder 是測試持久代理行為與長時間工程任務的最強候選;Claude Opus 5.5 對於廣泛程式設計、終端機密集工作流程與知識型工作表現強勁,並在 Meta 報告的 Artificial Analysis Intelligence Index 上領先;GPT-6 Sol 在標準短上下文 token 價格最低,對成本敏感自動化具吸引力。生產團隊應以具代表性的工作負載,根據被接受任務的品質、可靠性、延遲、重試、工具使用與總成本來做出最終選擇。
常見問題
團隊如何公平測試 Muse Wonder、Opus 5.5 與 GPT-6 Sol?
使用留出的真實任務集合,設定固定的驗收標準、相同的輸入素材與明確的工具權限。記錄每個模型版本、努力設定、代理工具、逾時與 token 預算。對輸出可能變動的任務進行重複試驗,同時報告失敗與成功,並區分共同工具測試與最佳配置系統的比較。如此產出的證據更適用於你的工作流程,而非他人的基準設置。
切換模型時,API 閘道是否能保留代理狀態?
共享的閘道位址本身不保證可攜的對話狀態、工具呼叫識別碼或已儲存回應的參照。請在應用端維護訊息、工具輸出與已驗證任務狀態的標準紀錄。切換路由前測試各路由的狀態與工具語義;否則較便宜的降級可能會遺失完成任務所需的資訊。
團隊應如何為重試與人工審查編列預算?
在測試前定義「被接受的結果」,再以總計的模型與工具花費除以被接受的結果數。人工審查成本另行報告,或用明確的時薪納入。統計失敗嘗試、修正性呼叫與降級模型,並比較典型任務與高成本任務。如此可避免誤將較低的 token 價格視為可用工作成本必然下降。
針對記憶敏感的代理,評估應包含哪些內容?
測試代理是否能記住相關事實、納入更正、忽略過時指示,並在不同專案間保持隔離。除了單一長提示外,還應包含延後的追問與互相矛盾的更新。同時在應用層與模型層檢查記憶行為,因為持久化、擷取與刪除取決於實際部署的系統。