
TL;DR
OpenAI Decisions API 與 TypeSafe Jev 都輸出有界、帶概率背書的決策,而非一般生成式文字。OpenAI 透過專用端點使用 GPT-6 Luna;TypeSafe Jev 是專門化的 System One 模型。按公布的輸入 token 費率,Jev 較便宜(每百萬 0.042 美元 vs 0.10 美元),而 OpenAI 具備原生影像支援。本文引用的供應商數據未能證實誰在準確度或速度上勝出。
關鍵重點
- 定價:按公布基準價,Jev 的每個輸入 token 便宜 58%。
- 架構:OpenAI Decisions API 使用 GPT-6 Luna;Jev 為專門用於決策處理的模型。
- 模態:OpenAI 支援文字與影像;Jev 專注於文字與結構化輸入。
- 基準:供應商速度宣稱的基準不同;請在相同標註資料集上比較。
- 選型:依應用需求在多模態支援與 OpenAI 整合,或純文字吞吐與成本之間取捨。
一覽:OpenAI Decisions API vs Jev
下表比較截至 2026 年 10 月 12 日的文件化決策端點與公布的基準費率。模型存取、限制與服務條款應以部署帳戶實際為準。
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | 文字 + 影像 | 文字 / 結構化文字 |
| Question types | predicate(條件概率)、choice(類別)、score(評分) | Noul(條件概率)、choice(類別)、score(等級) |
| Request questions | 具名稱的陣列 | 以 ID 為鍵的物件 |
| Context limit | 連結的 Decisions 指南未明載 | 總計 64K;state + 最長問題 ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | 不收費 | 不收費 |
| Vendor speed statement | 約比 Responses API 快 10× | 端到端 70–500 ms |
| Availability | 公開測試(public beta) | 發佈時為早期存取;需驗證帳戶現況 |
| Distinct advantage | 基於影像的決策 | 較低的公布輸入成本 |
| Generative reasoning / coding | 非此端點的輸出契約 | 非此端點的輸出契約 |
許多 AI 工作流程需要的是類別、概率或分數,而非段落文字。支援工單需要分派;智能代理需要選擇核准的動作;審核佇列需要識別不確定輸入。兩款產品都將此類決策作為一等 API 輸出。
OpenAI 於 2026 年 10 月 6 日發布 Decisions API 公測。其 GPT-6 Luna 端點接受文字與影像。Jev 是 TypeSafe AI 的專門化 System One 模型,用於非生成式評估,其訓練方法描述為Reinforcement Learning for Calibrated Decisions (RLCD)。
表中所述的問題類型涵蓋三項共享任務。OpenAI 的 predicate 與 Jev 的 noul 估計某一條件是否為真,例如退款意圖或資格。choice 從預定義類別中選擇,例如 Billing、Technical、Shipping 以供分派。score 依據評分標準或等級評估輸入,例如緊急度或優先級。這些說明整合了兩個產品的概述;其請求結構與概率語義仍需依供應商特定處理。
什麼是 OpenAI Decisions API 與 Jev?
OpenAI Decisions API 與 TypeSafe Jev 是以決策為核心的 AI 服務,設計用於將輸入資料轉換為結構化、有界的輸出,而非開放式文字。不同於傳統大型語言模型生成解釋或對話,這些 API 評估預定義問題並回傳決策、概率或分數。它們特別適用於自動化工作流程,例如客戶請求分派、內容分類、風險評估與 AI 代理工具選擇,在此情境下可預測的輸出與高效處理至關重要。
OpenAI Decisions API 由 GPT-6 Luna 提供動力,透過 /v1/decisions 端點運作。它支援文字與影像輸入,並提供三種決策類型:predicate、choice 與 score。其主要優勢在於結合通用模型的語境理解與專用的決策介面,適合多模態分類與已整合 OpenAI 生態系的應用。
TypeSafe Jev 則是專門化的決策模型,透過 /v1/systemone 端點存取。它聚焦於文字型評估,提供三種問題類型:noul、choice 與 score。Jev 強調高效推理、結構化預測與概率校準,對於高量分類與自動化決策管線具吸引力。雖然兩者解決相似問題,但在架構、輸入能力、定價與 API 設計上的差異,會顯著影響其對特定應用的適配性。
模型方法、輸入限制與範圍
本比較著重於文件化的 API 行為與產品定位。OpenAI 透過決策端點暴露 GPT-6 Luna,而 TypeSafe 將 Jev 定位為專門化的 System One 模型。僅據此描述並不足以證實哪一方在準確度上占優或揭示所有實作細節。
Jev 允許完整請求合計 64K tokens,且 state 加上最長問題限 32K。請將問題說明與準則、以及共享輸入計入其中。連結的 OpenAI Decisions 指南未針對此端點列出獨立的數值上下文限制;請驗證實際限制,而非假設通用模型的上下文視窗數據可直接沿用。
生成式推理與程式碼基準不在這些有界決策端點的範疇。若需生成解釋或程式碼,請另行評估合適的生成式端點。通用模型的結果不代表 Decisions 端點的表現。
準確度與延遲
引用的供應商資料並未提供匹配的正面對比測試以證實在準確度或延遲上的勝負。OpenAI 的約快 10× 說法是相對於其 Responses API;TypeSafe 報告端到端 70–500 ms 延遲,並稱其公布的評估通常在美國西部的筆電上執行。
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | 引用來源中無匹配對比測試 | 引用來源中無匹配對比測試 | 無勝負 |
| Speed | 相對供應商宣稱 | 絕對供應商範圍 | 不具可比性 |
| Calibration | 機率;choice/score 另有 confidence | 機率;choice/score 的 confidence 由分佈導出 | 需測試觀察校準 |
| Text categorization | 支援 | 支援 | 兩者皆可 |
| Visual categorization | 原生影像 | 無原生影像 | OpenAI 具優勢 |
概率校準與人工審核門檻
模型可能準確但校準不佳。對於被賦予 0.90 概率的所選類別,在評估分佈上約有 90% 應正確,這才稱為校準。請勿在未查明定義前,將 API 中名為 confidence 的欄位直接替代此概率。Jev 的 choice 置信度由概率分佈導出:confidence = (p_max − 1/n) / (1 − 1/n),其中 n 為選項數。其 noul 結果沒有單獨的 confidence 欄位。請與精確率、召回率、macro F1 一併測量 ECE 與 Brier 分數;在具標註的樣本上選擇審核門檻。
定價與每個被接受決策的成本
OpenAI 為 /v1/decisions 列示每百萬輸入 tokens 0.10 美元;Jev 列示每百萬 0.042 美元。兩者的決策服務均標示輸出 tokens 不收費。按此基準,Jev 的每個輸入 token 便宜 58%。OpenAI 的區域處理加價與長上下文倍增可能適用;重試、前處理與審核亦會增加工作流程成本。
假設兩者每次請求皆使用 500 個可計費輸入 tokens。以下為示意計算,非供應商發票。
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
每個被接受且正確的決策成本 =(API 支出 + 重試支出 + 人工審核支出)/ 被接受且正確的決策數。較低的每 token 費率可能會被較高的錯誤分派或升級率抵消。
針對傳統 GPT-6 Luna 工作流程,CometAPI 的模型定價表列示以下每百萬 tokens 的美元費率(查核於 2026 年 10 月 12 日)。這些為模型端點費率;該頁展示的是 Responses API 範例,未能證實原生 /v1/decisions 支援與其定價。
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
CometAPI 的一般 GPT-6 Luna 輸出 tokens 會計費。請將此估算與前述兩個決策服務分別看待,其公布的輸出 token 費用為零。例如,500 個輸入 tokens 加 20 個輸出 tokens,在短上下文層級下每次請求成本為 $0.000048,或每百萬次請求 $48,尚未含其他費用。預算前請在即時模型目錄確認適用層級與帳戶費率。
代理工作流程與模態取捨
兩者皆可路由工具呼叫、評估保護條件是否成立,或為動作評分。兩者都不取代授權、輸入驗證或工具權限的明確設定。對於視覺自動化,OpenAI 的原生影像支援可簡化管線;對於純文字分派,Jev 的較低基準成本可能具吸引力。
在回應邊界處的輸出處理有所不同。OpenAI 回傳 answers 陣列,以 name 識別問題;Jev 回傳以問題 ID 為鍵的 answers 物件。在套用共用商業規則前,請先正規化這些結構。Jev 的 confidence 由其概率分佈導出;不要假設名稱相同的欄位在不同供應商間具有等價意義。請在應用資料上驗證標籤與校準審核門檻。
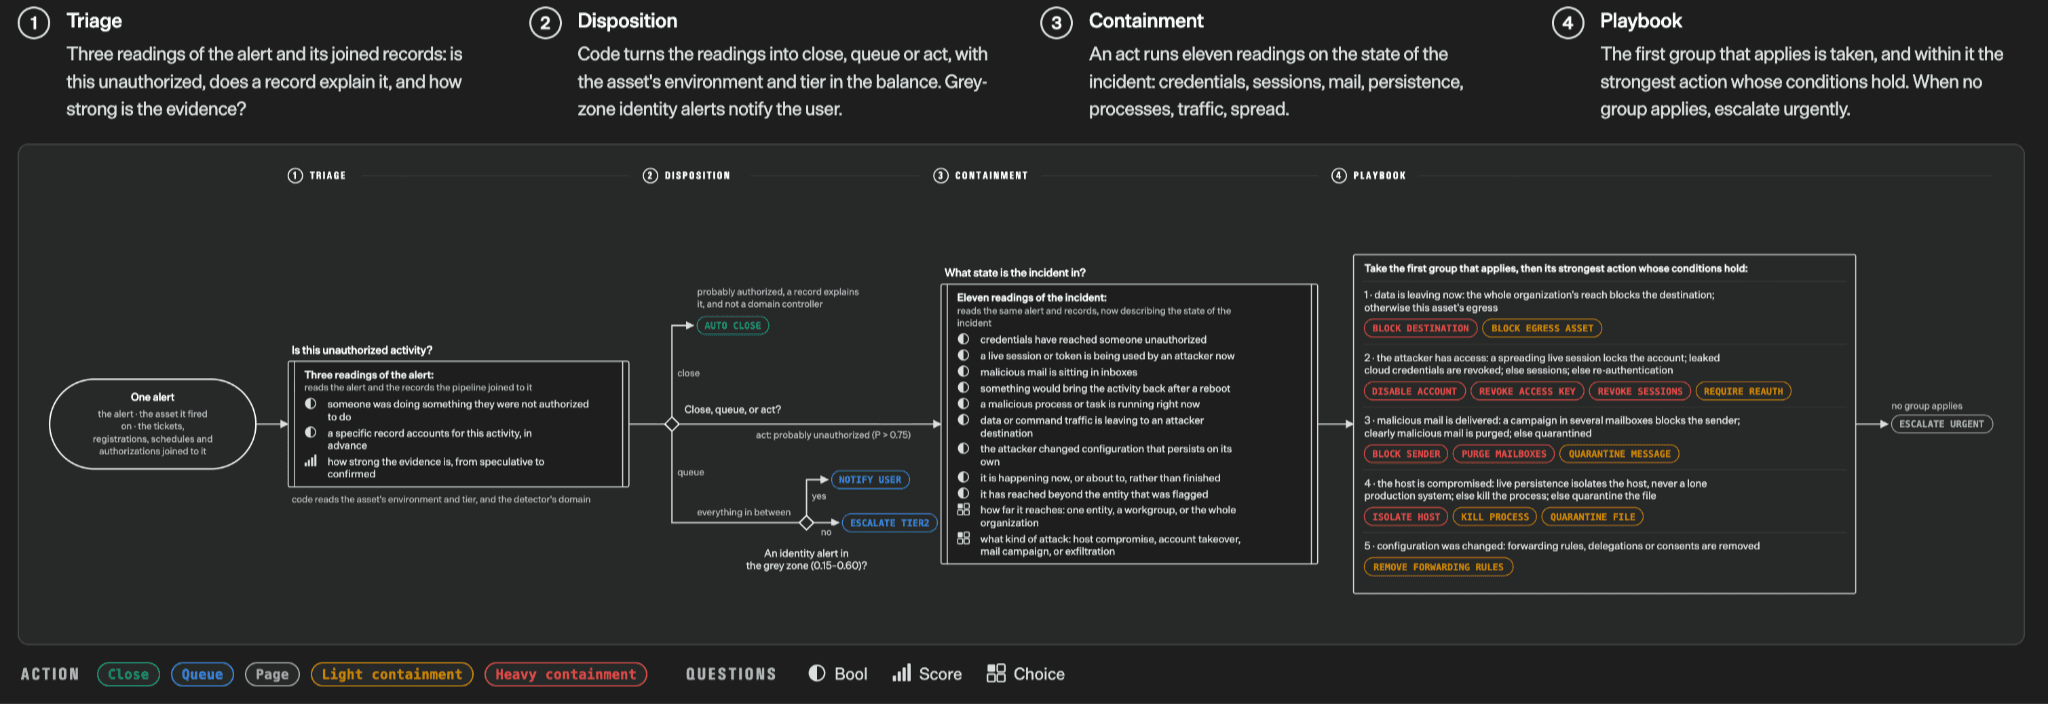
來源:Introducing System One Models & Jev;原始圖片。此圖示為工作流程組合,非針對 OpenAI Decisions API 的匹配基準。
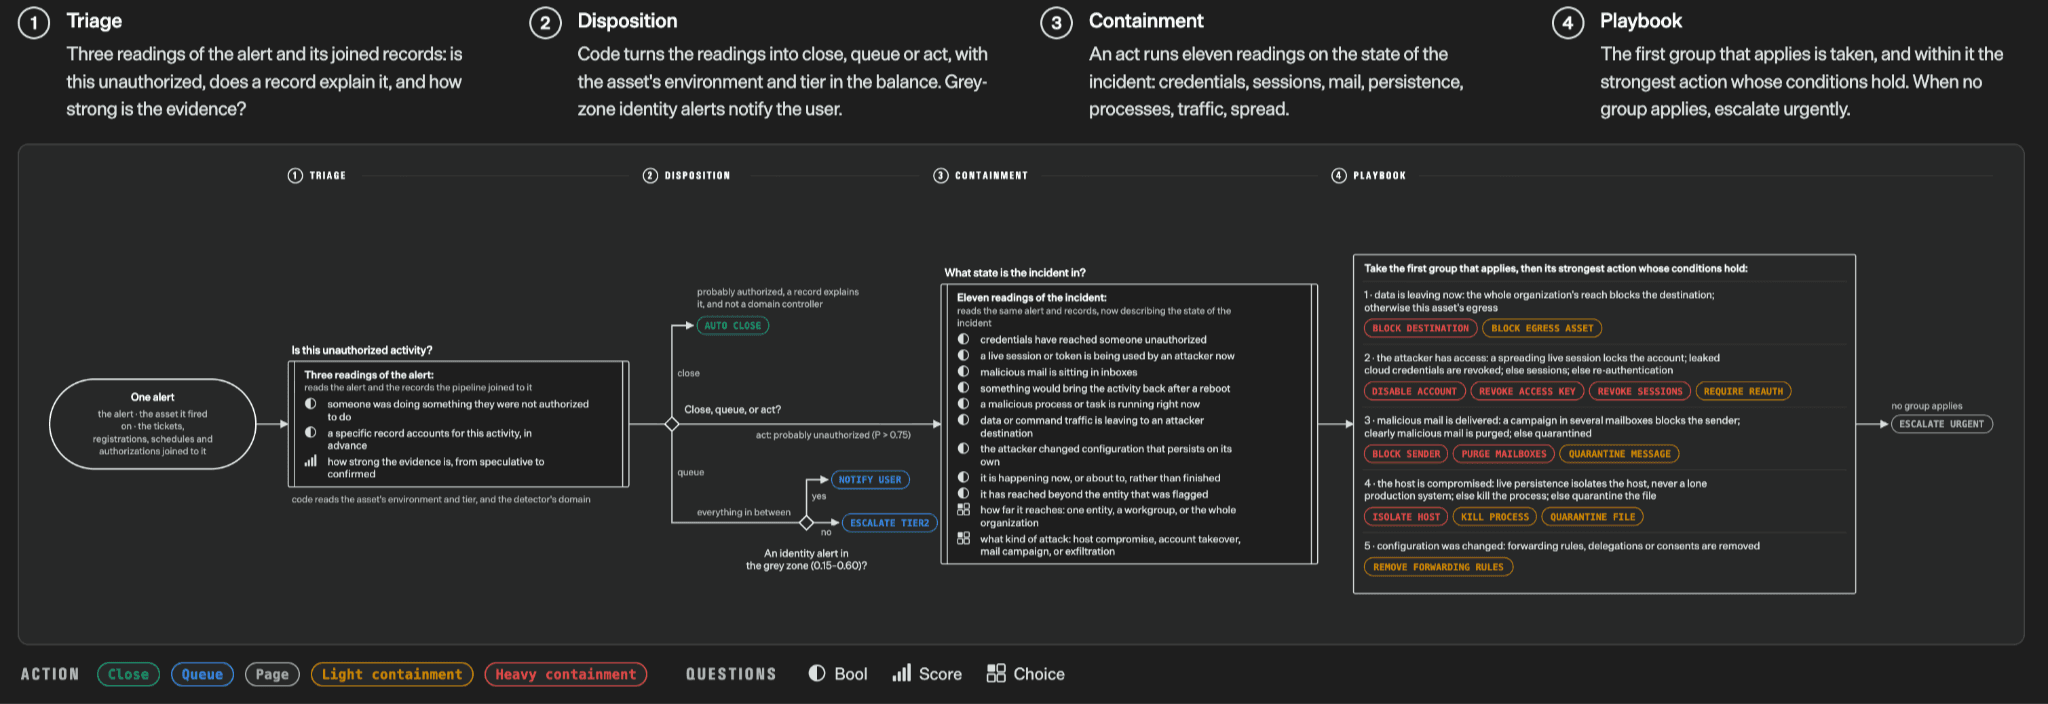
API 使用差異:OpenAI Decisions API vs Jev
兩家供應商的存取需分別設置:以下範例各自使用其主機與 API 金鑰。OpenAI 將 Decisions 記載為公開測試端點。對於 Jev,部署前請向 TypeSafe 確認目前存取與憑證。無論哪個服務,請驗證帳戶權限、區域可用性、配額與服務條款;示例請求不代表可直接用於生產環境。第三方對生成式模型的存取本身,亦不等於支援其原生決策端點。
如何使用 OpenAI Decisions API
概念重疊,但請求結構不同。OpenAI 傳送 input 與具名稱的問題陣列;Jev 使用 state 與以問題 ID 為鍵的 questions 物件。請先實作供應商特定的適配器,再套用共用的決策策略。
使用 OpenAI Decisions API 分派支援工單。
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
如何使用 Jev API
以下 cURL 請求使用Jev 的 System One 端點來分類支援工單。設定環境變數 TYPESAFE_API_KEY,將工單放入 state,並在 questions 物件中定義 department。其 criteria 對映列出允許的路由標籤及其描述。請求成功後,讀取 answers 中的 department,並在路由工單前驗證所選標籤。請確認該模型識別碼可由你的帳戶存取。
使用 TypeSafe Jev 分派支援工單。
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Keyed object |
| Question ID | name | Object key |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
所選類別機率的共同審核策略
對所選類別機率套用明確校準的門檻。
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
此 Python 3.10+ 範例是應用層的策略,而非 API 回應解析器。每個供應商的適配器都需驗證回應,並擷取所選類別的概率。請勿將 Jev 的原始 confidence 欄位直接作為 selected_probability。請提供針對該供應商、該問題與該評估資料集校準的門檻;在呼叫策略前,處理拒答與傳輸錯誤。
OpenAI Decisions API vs Jev:如何選擇
分兩階段進行。首先,過濾部署需求:影像輸入、帳戶存取、輸入限制與整合成本。其後,在相同的標註工作量上進行基準測試。對純文字分派,測試 Jev 較低的公布輸入價格是否能轉化為較低的總成本;對依賴影像的決策,評估 OpenAI 的原生影像路徑。於一致的品質目標下,比較誤分派、校準、尾延遲、重試與人工審核。
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Supported | Supported | 先為成本基準測試 Jev |
| Text categorization | Supported | Supported | 比較校準 |
| Screenshot inspection | Native | 需視覺前處理 | OpenAI |
| Agent tool selection | Supported | Supported | 衡量端到端成果 |
| Multimodal moderation | Text and images | Text only | OpenAI |
| Existing OpenAI stack | Native | 新整合 | OpenAI |
對高量業務自動化,如支援分派與文字分類,當輸入成本與吞吐是關鍵時,Jev 值得優先評估。對多模態應用(如螢幕截圖檢視、視覺審核與影像決策),OpenAI Decisions API 更實用,因其具原生影像支援。對 AI 代理與企業工作流程而言,選擇取決於既有基礎設施、整合複雜度與錯誤決策的後果。已使用 OpenAI 生態的團隊,採用 OpenAI 可能更順;而對大規模、重文字的工作負載,Jev 值得考量。無論情境如何,應以相同應用資料上的標籤品質、概率校準、延遲與總營運成本衡量,而非僅看標價。
應如何對 OpenAI Decisions API 與 Jev 進行基準測試?
在相同的具標註真實世界輸入上執行兩者,且匹配問題定義與用戶端區域。追蹤準確度、macro F1、ECE、Brier 分數、p50/p95/p99 延遲、逾時、拒答、審核率,以及每個被接受且正確決策的美元成本。
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | 標籤品質 |
| Calibration | ECE, Brier score | 概率可靠性 |
| Latency | p50 / p95 / p99 | 營運回應能力 |
| Reliability | 429 / timeout / refusal rate | 生產穩定性 |
| Economics | Cost per accepted correct decision | 實際營運費用 |
建議流程:建立具代表性的標註集;納入含糊與分佈外案例;以語意等價的任務送出;重複請求以測量變異;分別為每套系統校準門檻;並比較含升級與重試在內的端到端成本。
結論
當決策依賴影像證據,或既有 OpenAI 整合可降低部署工作時,選擇 OpenAI Decisions API。對純文字決策工作負載,Jev 的較低公布輸入 token 費率有助降低推理支出。請在相同應用資料上衡量標籤品質、概率校準、尾延遲與審核工作量後再決策。
Jev 具有較低的公布基準輸入 token 價格;OpenAI Decisions API 具原生影像輸入。引用的供應商數據未能證實整體準確度或速度的勝者。最佳選擇取決於完整工作流程中被接受決策的成本與品質。
開發者可在 CometAPI 使用 GPT-6 Luna API 來原型化更輕量的分類,作為更廣泛多模型工作流程的一部分。連結的模型頁面提供 Responses API 範例。對該生成式端點的存取,並不代表支援專用的 /v1/decisions 端點。此為傳統文字生成原型;它不會回傳原生的 Decisions 答案結構或經校準的類別概率分佈。請在連接下游動作前,將返回的標籤與允許類別比對並處理 API 錯誤。若需要該端點,請另行確認原生 /v1/decisions 支援。