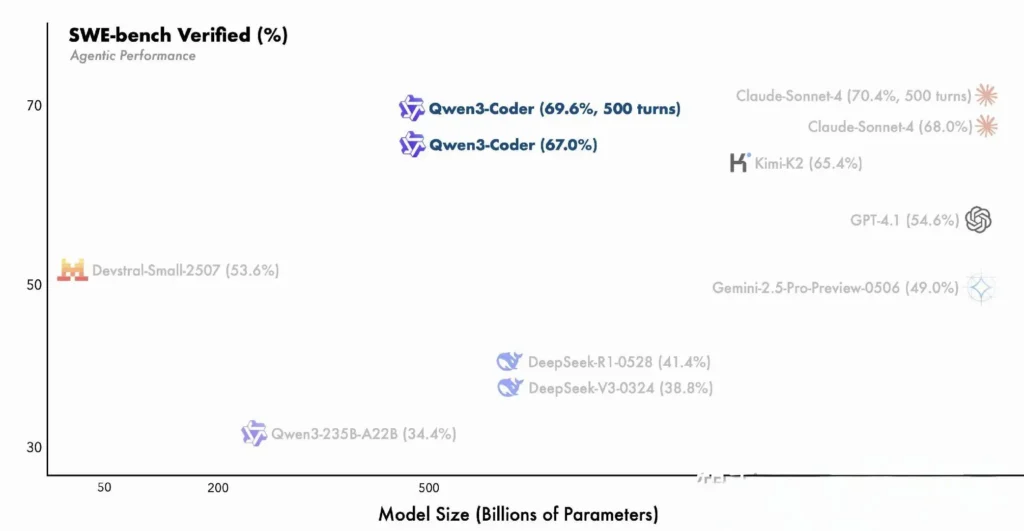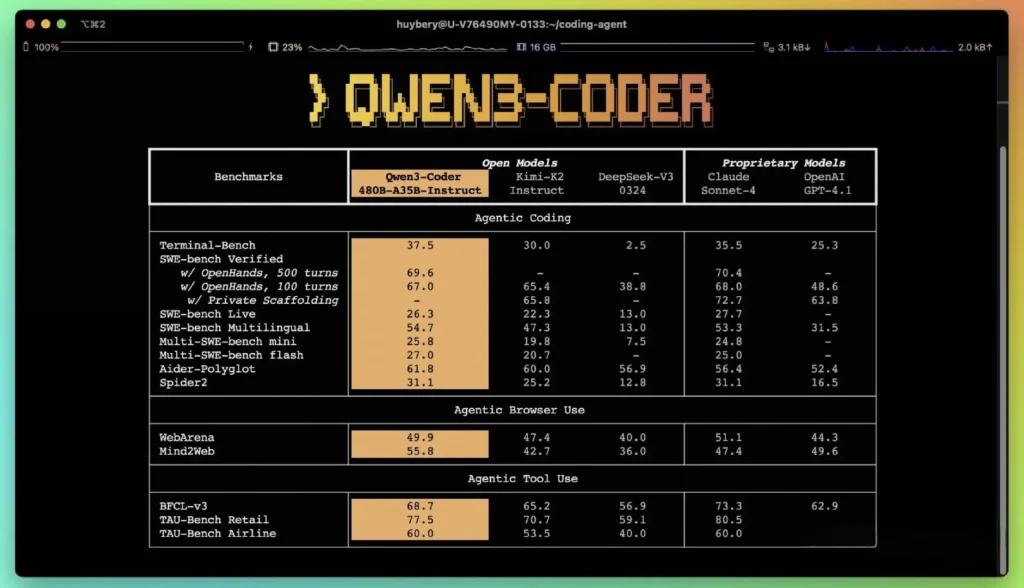
阿里巴巴在人工智慧領域的最新進展, Qwen3-編碼器,標誌著快速發展的人工智慧驅動軟體開發領域的一個重要里程碑。 Qwen23-Coder 於 2025 年 3 月 480 日發布,是一個開源的代理程式編碼模型,旨在自主處理複雜的程式設計任務,從生成樣板程式碼到跨整個程式碼庫進行偵錯。該模型建立在尖端的混合專家 (MoE) 架構之上,擁有 35 億個參數,每個令牌激活 3 億個參數,在性能和計算效率之間實現了最佳平衡。在本文中,我們將探討 QwenXNUMX-Coder 的獨特之處,檢視其基準效能,解析其技術創新,指導開發人員進行最佳使用,並考慮該模型的接受度和未來前景。
什麼是 Qwen3‑Coder?
Qwen3‑Coder 是 Qwen 家族最新的代理程式編碼模型,於 22 年 2025 月 3 日正式發布。其旗艦版本 Qwen480‑Coder‑35B‑A480B‑Instruct 被設計為“迄今為止最具代理性的程式碼模型”,擁有 35 億個參數,並採用混合專家 (MoE) 設計,每個標記可啟動 256 億個參數。它原生支援高達 XNUMXK 個標記的上下文窗口,並透過外推技術擴展到 XNUMX 萬個標記,從而滿足了程式碼庫規模程式碼理解和產生的需求。
Apache 2.0 下的開源
阿里巴巴秉承社區驅動開發的承諾,Qwen3-Coder 採用 Apache 2.0 授權發布。這種開源方式確保了透明度,促進了第三方貢獻,並加速了其在學術界和工業界的普及。研究人員和工程師可以存取預先訓練好的權重,並針對從金融科技到科學計算等特定領域對模型進行微調。
從Qwen2.5進化而來
Qwen2.5‑Coder 的成功源自於其強大的模型,其參數規模從 0.5 億到 32 億不等,並在程式碼產生基準測試中取得了 SOTA 的優異成績。 Qwen3‑Coder 透過更大規模、更強大的資料管線和全新的訓練機制,進一步擴展了前身的功能。 Qwen2.5‑Coder 已使用超過 5.5 兆個 token 進行訓練,並進行了細緻的資料清理和合成資料產生;Qwen3‑Coder 則進一步提升了這項能力,它以 7.5% 的程式碼率提取了 70 兆個 token,並利用先前的模型過濾和重寫資料輸入,從而獲得卓越的雜訊品質。