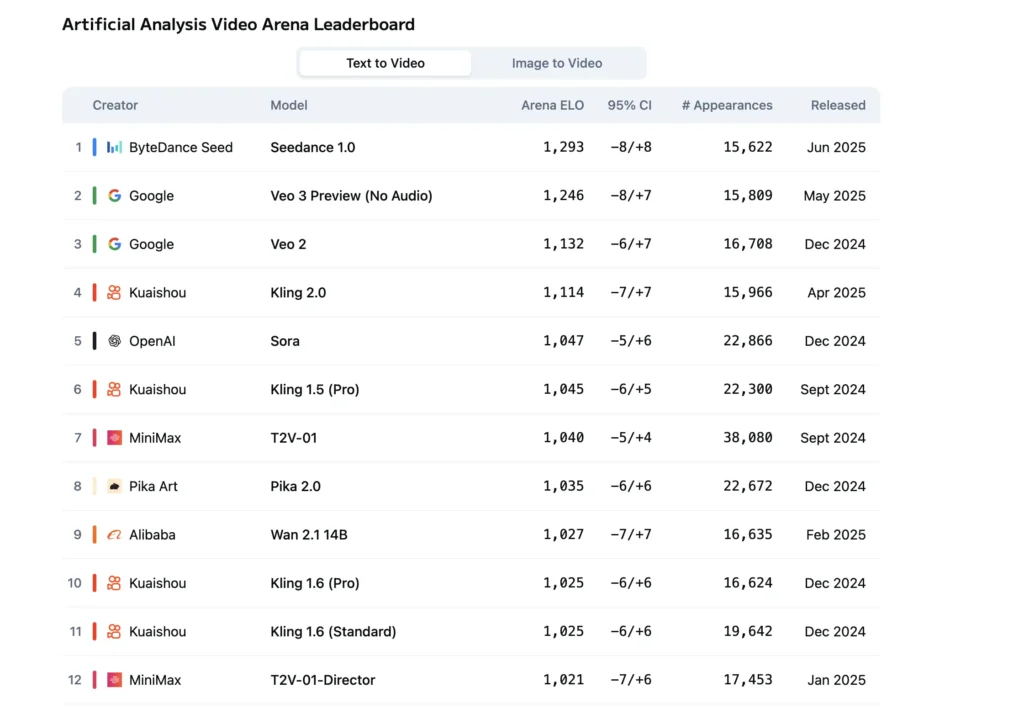
Seedance 1.0 和 Google Veo 3 代表了當今最先進的兩種視訊生成模型,它們都突破了神經網路將文字或圖像轉化為動態劇院級體驗的極限。這兩個模型分別由位元組跳動的火山引擎(前身為今日頭條引擎)和 Google DeepMind 開發,旨在滿足快速擴張的 AI 內容創作市場的需求。在本文中,我們將深入探討它們的技術創新、基準效能、實際應用和整體價值主張,以確定 Seedance 1.0 是否真正超越了 Google Veo 3。
Seedance 1.0 的核心創新是什麼?
Seedance 1.0 於 11 年 2025 月 XNUMX 日在 FORCE 會議上亮相。作為工業級視訊基礎模型,它帶來了多源學習、架構效率和敘事連貫性的多項突破。
多鏡頭敘事能力
Seedance 1.0 原生支援多鏡頭影片生成——通常在 2 秒的片段中包含 3-10 個連貫的鏡頭切換——從而能夠呈現遠比單鏡頭系統更複雜的故事敘述。透過新穎的鏡頭分割機制和鏡頭間一致性約束,該模型能夠在不犧牲視覺穩定性或時間連貫性的情況下,協調遠景、中景和近景之間的平滑過渡。
架構和成本優化
Seedance 的核心整合了一個兩階段擴散框架,並由多維獎勵強化學習 (RLHF) 增強。第一階段建構粗略的時空結構,第二階段則細化細節並強制執行快速執行。結合強大的多階段蒸餾流水線,該模型在 NVIDIA L10 硬件上實現了高達 20 倍的加速,僅需 5 美元(約合 1080 元人民幣)即可在約 41 秒內生成一段 0.50 秒的 3.67p 視頻片段,使其成為市面上速度最快、性價比最高的方案之一。
品質和現實性指標
人工智慧分析的獨立基準測試顯示,Seedance 1.0 在「文字轉影片」和「影像轉影片」兩個領域均名列前茅,超越了包括 Google Veo 3 和 OpenAI Sora 在內的競爭對手。評估人員指出,Seedance 擁有卓越的時空流動性、結構穩定性以及對複雜文字指令的保真度,尤其是在人群移動或動態鏡頭搖攝等運動密集的場景中。