Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
ai-model / CometAPI 研究
什麼是 Gemini 4 Carbon?基準測試、功能與定價 發現 Gemini 4 Carbon,Google 的全新前沿 AI 模型。探索資訊安全基準測試、功能、定價、比較與供應情況。
Deon Goodwin AI 模型與 API 研究團隊 發現 Gemini 4 Carbon,Google 的全新前沿 AI 模型。探索資訊安全基準測試、功能、定價、比較與供應情況。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)重點摘要
Gemini 4 Carbon 是 Google DeepMind 面向高強度工程與防禦性資安的前沿模型。 於 2026 年 10 月 28 日發佈,在已公佈的程式設計、安全與長上下文評測中較 Argon 有所提升。試用期費率為每百萬輸入 token $2、每百萬輸出 token $10,但起初僅限特定資安防禦者與受信任夥伴取用。對開發者而言,機會在於更強的自主工作能力;當前限制在於取用權限。
重要重點
Gemini 4 Carbon 是 Google 在 Argon 之後的下一代前沿模型,針對長時多日的代理型工程與資安防禦進行最佳化。
Gemini 4 Carbon 在 Artificial Analysis Intelligence Index v5.0(得分 59)名列第 1,領先 Claude Opus 5.5(58)與 GPT-6 Astra(57)。在程式設計、全端網頁開發(WebDev Arena +89 Elo 至 #4)、科學推理、多模態理解與對齊方面都有顯著進步(在 Gray Swan Indirect Prompt Injection Benchmark 上達到 0.0% 成功率)。
資安成績突出(未加安全護欄):SEC-bench Pro(弱點發掘)88.2%、ExploitGym(漏洞利用驗證)54.8%、CWE-bench(弱點修補)71.0%。
初期透過 Fairwind Program 限量提供給資安防禦者;稍後將擴大至更廣泛對象與公開 API。
試用價與 Argon 相同;試用期後將適用標準費率。
CometAPI 等平台已透過統一、與 OpenAI 相容的 API 支援更廣泛的 Gemini 系列(包含 Argon),便於切換模型並為 Carbon 更廣泛釋出做準備。截至 2026 年 10 月 29 日,仍未公佈公開 API 細節與廣泛釋出日期。
什麼是 Gemini 4 Carbon? Gemini 4 Carbon 是 Google 最新的旗艦前沿 AI 模型,設計用於處理複雜的軟體工程、資安研究與自主工作流程。
Carbon 針對跨多個步驟的調查、執行與驗證型工作而設計。防禦性工程代理可能會檢視儲存庫、在隔離環境中驗證疑似弱點、開發修補程式,並測試變更是否解決原始缺陷。
Google 表示其內部團隊觀察到 Carbon 能在多天內處理複雜工程任務。這些是內部觀察結果,並非針對特定自主執行時長的公開保證。Google 尚未發佈完整技術報告、參數數量或詳細架構資訊。上下文視窗與輸出上限預期與 Argon 類似或更佳(據報可達數百萬 token 級且具高輸出容量),並支援文字、影像、影片、音訊與 PDF 等多模態輸入。
Gemini 4 Carbon 的關鍵特性是什麼?
長期視野的軟體工程 Carbon 針對無法在單一步驟推理中可靠完成的工程問題而設計。
範例包括跨大型儲存庫的根因分析、相依性相關故障、低階系統偵錯與複雜重構。
一個有效的程式設計代理必須能識別首次解法失敗時,檢視新證據並在不偏離原任務的情況下修正方法。
防禦性資安工作流程 Carbon 的安全結果涵蓋弱點發掘、驗證可利用性與修補缺陷。對資安團隊而言,關鍵問題在於代理能否從疑似問題走到可重現的發現與經測試的修補,同時遵守被指派的權限與環境。
長上下文與多模態理解 Carbon 在 256K–1M token 子集的 GraphWalks BFS F1 得分為 96.2%,高於 Argon 的 84.2%。這是針對長上下文圖推理的證據,而非保證能從任一百萬 token 文件中正確擷取。
已發佈的 Chartography 與 Blueprint-Bench 2 結果亦涵蓋視覺理解。這些測試有助於識別具前景的文件與圖表類工作流程,但不構成未來公開 API 完整模態綱要之保證。
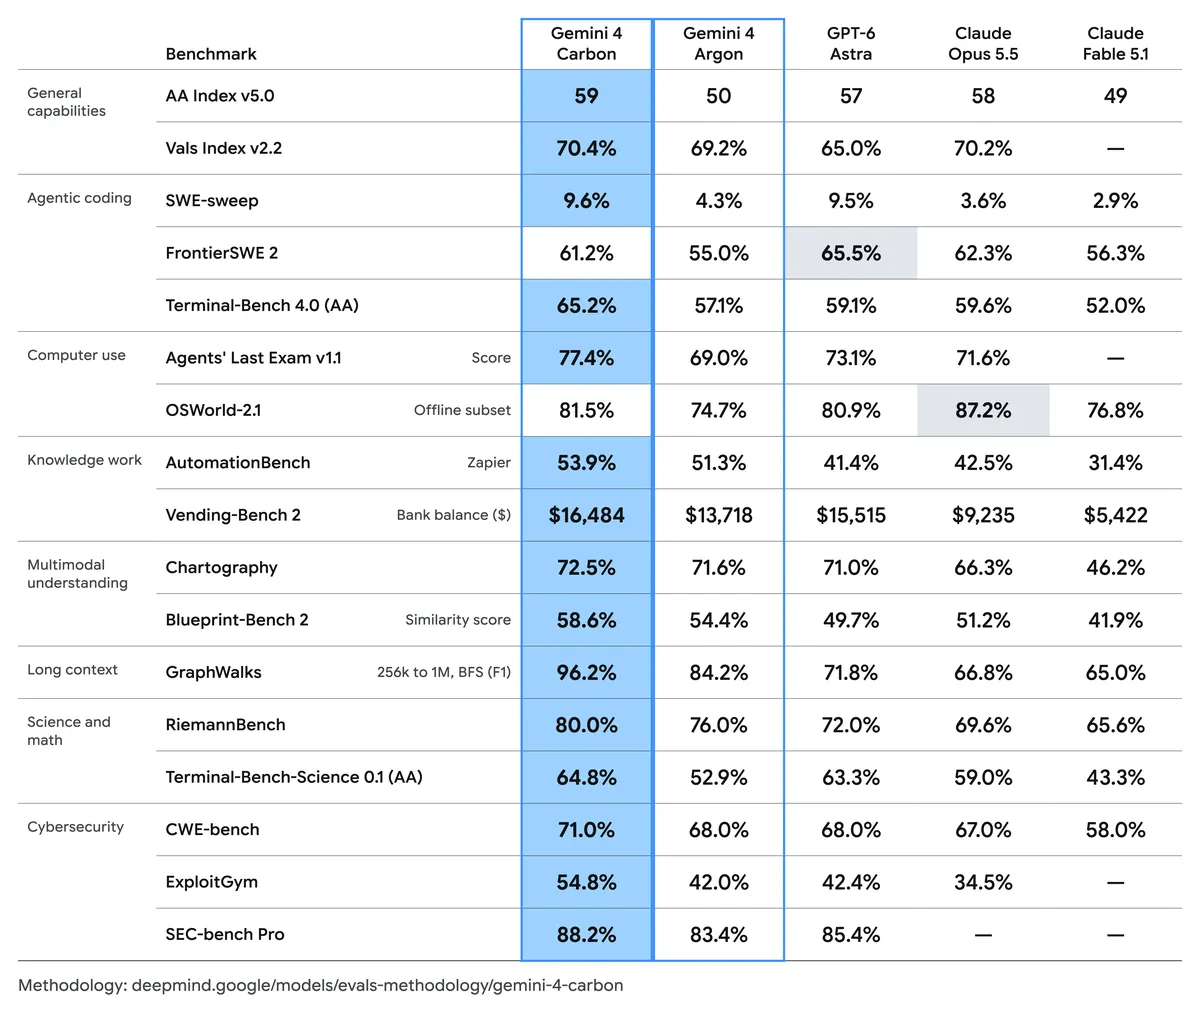
Gemini 4 Carbon 在基準測試上的表現如何? 公佈的結果凸顯評估 Carbon 的三個理由:更強的程式設計表現、更好的長上下文推理,以及在資安工作流程上的提升。官方公告 包含原始對照圖;重點結果如下所述。
選擇與自身工作負載相似的評測。即使某模型在通用智慧指數上領先,也可能在特定工程任務上落後於其他模型。
基準結果與測試條件 整體推理:Carbon 在 AA Intelligence Index v5.0 得分 59,Argon 為 50,GPT-6 Astra 為 57,Claude Opus 5.5 為 58。
程式設計:Terminal-Bench 4.0 由 57.1% 提升至 65.2%,較 Argon 增加 8.1 個百分點。SWE-sweep 由 4.3% 提升至 9.6%。
長上下文推理:Carbon 在 GraphWalks 256K–1M-token BFS F1 子集得分 96.2%,高於 Argon 的 84.2%。
替代方案領先之處:GPT-6 Astra 在 FrontierSWE 2 得分 65.5%,高於 Carbon 的 61.2%;Claude Opus 5.5 在 OSWorld 離線子集得分 87.2%,高於 Carbon 的 81.5%。這些比較以已發佈圖表所列模型與評估設定為準。
在原始對照的 17 個選定結果中,Carbon 領先 15 項。廣度使其成為複雜工作流程的有力候選,但兩個例外也說明了任務組合的重要性。請比較經驗證的結果、完成時間與成本,而非將無關基準分數取平均。
評測方法 一般使用最高思考設定與 pass@1,除非另有說明。其結合 Google 執行的結果、外部評測者與供應商報告的分數,因此各項目的代理骨架與推理額度不完全一致。
GraphWalks:引用的子集使用 200 個問題並回報 BFS F1。
Agents’ Last Exam:評估使用 122 項 v1.1 任務、ALE-Claw harness、5 小時視窗,並啟用安全過濾。
OSWorld:回報結果涵蓋 82 項離線子集,並取三次單次嘗試中的最大值。
實務中的程式設計表現 Carbon 將 Terminal-Bench 4.0 由 57.1% 提升至 65.2%,增加 8.1 個百分點。SWE-sweep 由 4.3% 提升至 9.6%,分數超過一倍,但絕對值仍低於 10%。這些結果支持評估困難的儲存庫工作,同時也說明為何仍需獨立測試與審查。
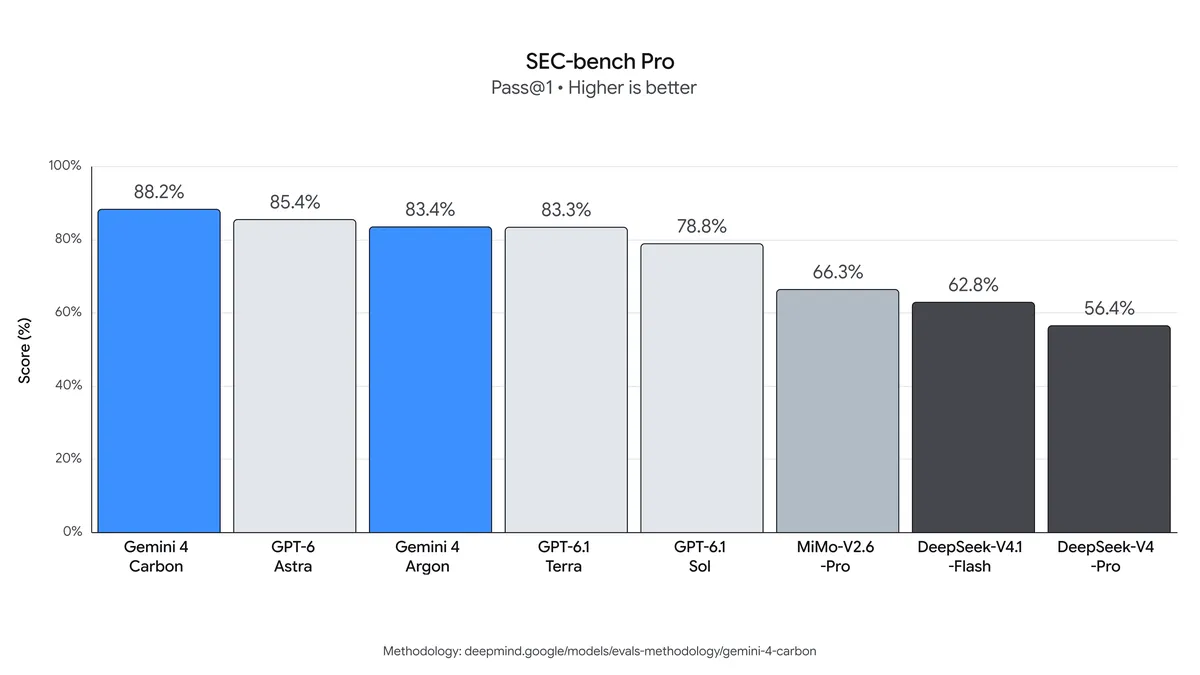
Gemini 4 Carbon 的資安能力有多強? SEC-bench Pro — 弱點發掘 88.2% 83.4% +4.8 個百分點 ExploitGym — 漏洞利用驗證 54.8% 42.0% +12.8 個百分點 CWE-bench — 弱點修補 71.0% 68.0% +3.0 個百分點
最大增幅在於漏洞利用驗證。對具授權的防禦團隊而言,能重現且可驗證弱點可被利用的證據有助於排程優先順序;僅有貌似可信的發現並不足夠。修補仍需測試以確認原始缺陷已修復且既有功能被保留。
Google 回報的外部安全評測是在未加部署安全護欄的情況下進行。SEC-bench Pro 使用特定的 183 題 JavaScript 引擎切分;ExploitGym 採用關閉緩解措施的單次嘗試離線設定。這些條件並不等同於無限制的生產行為,亦不構成對任意真實世界軟體的偵測率。
Gemini 4 Carbon 是否比 Argon 更安全且更可靠?
相較 Argon,未受支持的主張在內部測試中約下降 50%。
代理越權下降 26%。
服務不足下降 29%。
在內部程式設計環境中,高嚴重度不對齊警報幾近下降 80%。
在 Google 的評估中,Terminal-Bench 4.0 上的成功作弊降至 0.0%。
在 Gray Swan 間接提示注入評測中,Carbon 的攻擊成功率為 0.0%,Argon 為 0.7%。這表示在該設定下評估的攻擊未成功;並不意味對新型攻擊或不同工具環境免疫。
在生產代理中,仍應保留獨立的權限檢查、執行日誌與對宣稱結果的驗證。模型行為的改善有所助益,但應用端仍必須控制其可存取的檔案、服務與動作。
Gemini 4 Carbon API 的費用是多少? Google 已公佈 Carbon 的試用期與後續 token 費率 。以下快取輸入的數字以宣佈的 95% 折扣計算;公開 API 的實作與資格細節仍待公佈。
輸入 token $2.00 $4.00 輸出 token $10.00 $20.00 符合條件的快取輸入 token $0.10 $0.20
範例請求成本 假設一次請求使用 200,000 個未快取的輸入 token 與 10,000 個計費輸出 token。以公佈的試用期費率,輸入成本 $0.40、輸出成本 $0.10,合計 $0.50。以後續費率計算,相同 token 用量的成本為 $1.00。
若全部 200,000 個輸入 token 均符合宣佈的快取輸入折扣,試用期估算(含輸出)為 $0.12。此為有條件的示意,並非承諾每個重複輸入都符合資格。
輸出額度必須包含最終適用規則下按輸出計費的思考 token。若 10,000 僅指可見答案,則額外可計費的思考 token 會提高估算。工具、重試與其他服務不包含在內。
開發者如何為 Gemini 4 Carbon API 做準備?
目前 Gemini 4 Carbon API 可用性 截至 2026 年 10 月 29 日,取用從特選資安防禦者開始,並逐步擴展至受信任夥伴。Google 的 Fairwind Program 描述了受控取用途徑。尚未公佈面向廣大開發者的釋出日期與公開的 Carbon 模型識別碼。
因此,已宣佈的定價並不代表當下即可呼叫普遍可用的 Carbon API。其最終公開的上下文限制、最大輸出、模態綱要、工具相容性與作業限制仍需正式的生產規格文件。
等待 Carbon API 期間的替代方案 在 Carbon 廣泛可用之前,你即可開始評估你的程式設計工作流程。先用今日可取用的模型建立基準,待 Carbon API 開放後在相同任務上比較。可考慮的三個選項為 Gemini 4 Argon、GPT-6.1 Astra 與 Claude Opus 5.5;在選擇路徑前,請向供應商確認確切的模型名稱、取用方式與價格。
Gemini 4 Argon:
**GPT-6.1 Astra :** 將其納入同一工程任務的跨供應商比較。衡量被接受的修復、完成時間與總成本。前文討論的 GPT-6 Astra 成績適用於該受測版本,不應視為 GPT-6.1 Astra 的分數。
保持模型選擇可配置,並保存每次執行的提示、測試案例與結果。這將為你評估 Carbon 提供良好起點,而不需將工作流程綁定於尚未公佈的 API 形式。
AA Intelligence Index v5.0 59 50 57 58 Vals Index v2.2 70.4% 69.2% 65.0% 70.2% SWE-sweep 9.6% 4.3% 9.5% 3.6% FrontierSWE 2 61.2% 55.0% 65.5% 62.3% Terminal-Bench 4.0 (AA) 65.2% 57.1% 59.1% 59.6% Agents' Last Exam v1.1 77.4% 69.0% 73.1% 71.6% OSWorld-2.1,離線子集 81.5% 74.7% 80.9% 87.2% AutomationBench,Zapier 53.9% 51.3% 41.4% 42.5%
準備模型評估工作流程
任務完成率:代理通過預先定義驗收測試的頻率。
修補正確性:提議的變更是否解決原始缺陷且不破壞既有行為。
假陽性率:回報的問題有多常在驗證時不成立。
端到端延遲:包含工具執行在內,完整工作流程所需時間。
總任務成本:包含重試與工具使用後,每個被接受結果的成本。
指令遵循:代理是否僅在授權的檔案、工具與動作範圍內運作。
使用一組固定的真實任務,並記錄每個模型、其設定、token 使用與測試結果。將重試與人工修正納入成本。當 Carbon 可用時,對同一評估重跑,以確認其是否能以更省時與更划算的方式產出更多被接受的工作。
結論 Gemini 4 Carbon 是在要求嚴苛的程式設計、長上下文推理與防禦性資安工作上的可觀升級。其已發佈結果顯示相較 Argon 有明顯進步,但截至 2026 年 10 月 29 日,初期取用仍有限。當前請先以可用模型建立基準並保持整合彈性。待 Carbon 的公開 API 開放後,再比較已完成工作的品質、節省的時間與總成本,決定是否切換。
常見問題
Gemini 4 Carbon 能在無人監管下運行嗎? 對多日內部工程工作的報告並不代表可對任意任務達成無人看管的可靠性。考慮自主執行的團隊應定義允許的動作、停止條件與驗收測試,並衡量代理在無需修正的情況下完成工作的頻率。僅有運行時長並不能證明輸出正確。
既有的 Argon 整合能直接切換到 Carbon 嗎? 僅憑目前證據無法確認。請保持供應商選擇可配置,但在變更部署前,需驗證 Carbon 的實際模型識別碼、支援的綱要、工具、限制與帳戶取用。重用提示有助於受控比較,但並不能證明 API 相容性。
哪些 Gemini 4 Carbon 測試對私有程式碼庫最重要? 納入具代表性的錯誤、儲存庫變更與具既定驗收標準的資安發現。檢查修補是否通過相關測試、發現是否可重現,以及是否未引入無關行為變更。將失敗嘗試與人工修正納入成本分析,避免強勢的公開基準分數掩蓋實際作業工作量。