
TL;DR
AI 視訊模型正走出舊有的純文字轉影片範式,邁向能理解完整創意簡報——文字、影像、參考片段、動作、聲音、音樂與音效——並將其轉化為連貫視聽場景的系統。MiniMax 已於 2026 年 7 月 31 日正式發佈 MiniMax H3,這是一個通用的全模態生成模型,能夠共同理解文字、影像、影片與音訊,並生成最長 15 秒、原生立體聲的片段。其關鍵變化是一套統一的架構:將文字轉影片、影像轉影片、首/末幀生成、基於參考的生成、動作遷移、視聽編輯與音訊條件生成視為同一個多模態生成問題的變體,而非彼此獨立的管線。託管產品預設提供 2K 輸出,透過 H3-Base 先以 768p 短邊生成,隨後由 H3-Regenerate-2K 使用原始脈絡重建場景。具有競爭力的視聽品質、靈活的多模態控制、可下載的 H3-Base 權重,以及具脈絡感知的 2K 完成,使 H3 成為 2026 年技術上更具辨識度的影片發佈之一。
Key Takeaways
- 新架構:Contextual Omni Representation、H3-VAE、H3-Omni Transformer 與 In-Context Regeneration 在多模態間統一理解與生成。
- 表現提升:H3 可生成 4–15 秒片段,24 FPS 視訊、32 kHz 立體聲,並透過再生成由託管服務預設輸出 2K。
- API 與開放權重:MiniMax 提供 H3-2K、H3-Context-IR 與 H3-Regenerate-2K 託管 API,同時開放下載 H3-Base-FL2VA 與 H3-Base-Ref2VA 檢查點。
- 主要用例:廣告、品牌、電商、產品設計、UI/UX、遊戲、電影、參考驅動生成、動作遷移與視聽編輯。
- 定價與部署邊界:官方按量計費為 768P 每秒 $0.08、2K 每秒 $0.13;僅 H3-Base 可下載,H3-Context-IR 與 H3-Regenerate-2K 仍為託管服務。
What Is MiniMax H3?
MiniMax H3 是由 MiniMax 開發的通用全模態視聽生成系統。H3 不僅能接受提示詞或單一參考圖片,還能在包含文字、影像、影片與音訊的脈絡中推理,並生成同步的影片與立體聲音訊。
託管版 H3 支援 4–15 秒輸出、24 FPS 視訊與 32 kHz 立體聲。MiniMax 將託管系統標示為預設提供 2K;技術上,H3-Base 先產出 768p 短邊結果,接著 H3-Regenerate-2K 會將該結果與原始脈絡回饋給 H3 以重建 2K。MiniMax 也報告在 11 種語言上具備穩定對話生成能力,包括英文、中文、日文、韓文、法文、德文、西班牙文、葡萄牙文、義大利文、俄文與阿拉伯文。
這項差異很重要。許多較早的影片工作流程實際上是管線式:
prompt -> silent video -> speech -> sound effects -> music -> synchronization
H3 則將音訊與影像視為同一生成過程的組成部分。其 H3-Omni-Transformer 共同預測影像與音訊的潛變量,減少後續再行組裝獨立的影片、配音、音樂與同步階段的需求。
MiniMax H3 Specifications at a Glance
| Specification | MiniMax H3 |
|---|---|
| Developer | MiniMax |
| Model category | 通用全模態影片生成 |
| Input modalities | 文字、影像、影片、音訊 |
| Output | 影片加原生立體聲 |
| Output duration | 4–15 秒 |
| Base resolution | H3-Base 為 768p 短邊 |
| Hosted resolution | 透過 H3-Regenerate-2K 提供最高 2K;預設為 2K,由 H3-Regenerate-2K 在 768p 基礎上產生 |
| Frame rate | 24 FPS |
| Audio | 32 kHz 立體聲 |
| Stable dialogue languages | 11 |
| Aspect ratios | 21:9、16:9、4:3、1:1、3:4、9:16 及其他比例 |
| Reference limits | 最多 9 張圖片、3 段影片、3 段音訊,以及合計 12 個混合檔案 |
| Core generative model | 33B 稠密 H3-Omni-Transformer |
| Position encoding | 3D Multimodal RoPE |
| Open-weight checkpoints | H3-Base-FL2VA 與 H3-Base-Ref2VA |
| Checkpoint precision | BF16 |
| License | MiniMax H3 Community License |
33B 指的是 H3-Omni-Transformer,而非整個託管管線中的所有組件。
What Makes MiniMax H3 Different?
One Model for Multiple Video Tasks
多數影片生成器在歷史上會將文字轉影片、影像轉影片、動作參考、影片編輯、音訊生成與主體參考等能力分離。
MiniMax 採用不同的方法。H3 以多模態脈絡與期望輸出之間的泛化關係進行預訓練,允許用自然語言以指令描述這些關係。
例如,創作者可以概念性地要求 H3:遵循某段影片的鏡頭運動、保留一張圖片中的角色,並使用另一段音訊作為聲線參考。MiniMax 發佈示範正是藉由此類跨模態指令,展示 H3 的廣義參考系統。
這使得 H3 不像是一組生成模式的集合,更像是一個多模態的創意引擎。
Native Video and Stereo Audio Generation
MiniMax 的技術說明指出,H3-Omni-Transformer 會共同預測影像與音訊潛變量。音訊部分由 H3-AudioVAE 運作,它先將 32 kHz 音訊壓縮為 40 Hz 的潛在序列,之後再解碼為立體聲。
這為包含對話、環境聲、音樂或音效的場景帶來實用優勢:聲音是生成脈絡的一部分,而不是完全獨立的後製步驟。
Omni-Reference Inputs
H3-Base-Ref2VA 支援最多 9 張圖片、3 段影片與 3 段音訊,且最多接受 12 個混合輸入檔案。參考影片與音訊各可為 2–15 秒,並對各模態總時長有限制。在 Ref2VA 模式中,音訊不能作為唯一的參考輸入。
重點不只在參考數量。H3 的設計在於推斷這些素材之間的關係。
- 保留一張圖片中的角色;
- 復刻參考片段的動作;
- 遷移某種視覺或電影風格;
- 保留或替換音訊;
- 以某個聲音作為音色參考;
- 使用自然語言指令編輯現有的視聽場景。
In-Context 2K Regeneration
H3 的高解析度方法格外重要。
它並非僅把 768p 輸出丟給傳統超解析網路處理,H3-Regenerate-2K 會將原始多模態脈絡與基礎結果重新輸入 H3,要求在更高解析度下重建場景。
預期優勢在於語義恢復。一般放大器可以插值像素,但無法可靠重建已遺失的資訊——例如小字體、品牌元素或細微物件細節。H3 的再生成階段可以在構建 2K 結果時,再次參考原始提示與參考素材。
How Does the MiniMax H3 Architecture Work?
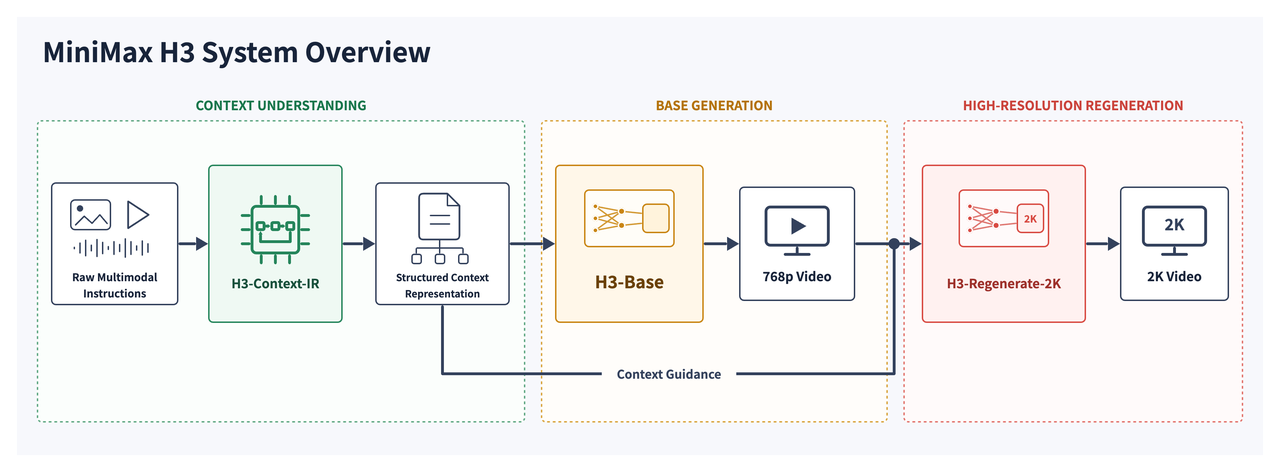
完整的 H3 工作流程包含三個主要階段:
H3-Context-IR -> H3-Base -> H3-Regenerate-2K
H3-Context-IR 負責理解可能相當複雜的多模態指令,並轉換為結構化的 Context Intermediate Representation。H3-Base 消費該表示,生成 768p 視訊加音訊。H3-Regenerate-2K 隨後結合生成結果與原始脈絡,構建更高解析度版本。
H3-Contextual Omni Representation and H3-Context-IR
Contextual Omni Representation 是 MiniMax 更廣義的設計概念:語言作為橋樑,描述脈絡、目標與多種模態之間的關係。在已發佈的系統說明中,H3-Context-IR 是託管的前處理與協調層,負責解析指令、關聯各模態、推理時間,並序列化結果以供 H3-Base 使用。
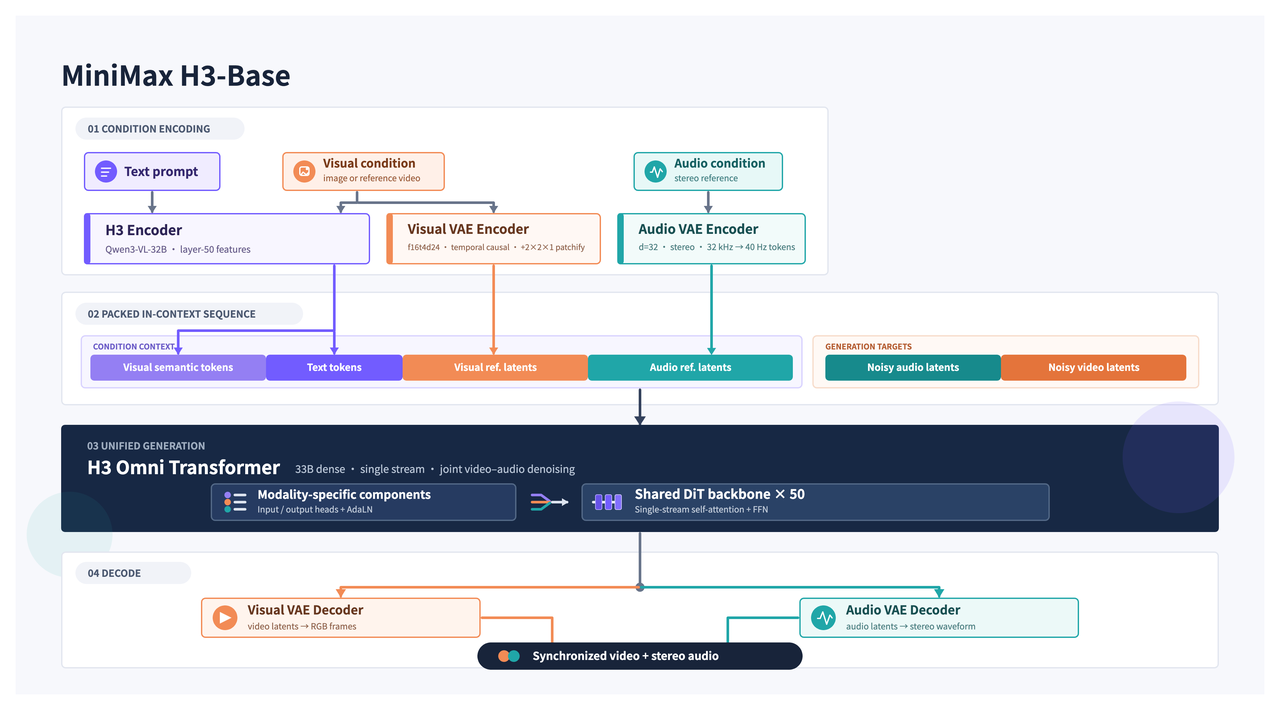
H3-Encoder 則是 H3-Base 內的一個具體組件。它使用 Qwen3-VL-32B 的預訓練權重,並將第 50 層的隱藏狀態傳入 H3-Omni-Transformer。
H3-VAE
發佈用語「H3-VAE」涵蓋此模型家族的視覺與音訊潛表示。開放權重文件將 H3-VisualVAE 與 H3-AudioVAE 區分描述。H3-VisualVAE 採用時間因果編碼,具有 16× 空間壓縮、4× 時間壓縮與 24 個潛通道,隨後進行 1 × 2 × 2 的分塊化(patchification)。H3-AudioVAE 則將 32 kHz 立體聲音訊壓縮為 40 Hz 的潛在 token 序列。
H3-Omni-Transformer
發佈部落格將名稱寫作「H3-Omni Transformer」;開放權重技術文件則使用「H3-Omni-Transformer」。兩者皆指同一核心生成組件。它是一個 330 億參數的稠密、單串流 Transformer。約 130 億參數位於與 AdaLN 相關的分支;其調制輸出可預先計算並快取,因此在僅推理部署時無需全部常駐載入。
與模態相關的組件集中在輸入/輸出層與 AdaLN 分支,而中央 Transformer 在統一的打包序列上運作。三維的 Multimodal RoPE 分別在時間與空間(t, h, w)上表示位置。
H3-In-Context Regeneration
MiniMax 的發佈部落格稱此技術為 H3-In-Context Regeneration;生產模組名為 H3-Regenerate-2K。它將 768p 結果與原始脈絡回饋給 H3,以重建 2K 輸出,讓語義細節得以再生,而不僅是插值。
Is MiniMax H3 Really Open Source?
從比較章節移至此處,因為開放權重邊界是核心架構差異。
「Open-weight」比「完全開源」更精確。MiniMax 提供 H3-Base-FL2VA 與 H3-Base-Ref2VA 檢查點供本地使用,包含所需的處理器、分詞器、文字編碼器、Transformer、視覺 VAE 與音訊 VAE 等組件。
然而,完整的生產管線無法端到端下載。H3-Context-IR 仍為託管,H3-Regenerate-2K 未包含在初始開放權重釋出中。本地的 H3-Base 生成以 768p 短邊為目標;要重現官方完整 2K 工作流程,需要使用託管的脈絡處理與再生成服務。
H3 採用 MiniMax H3 Community License,而非 Apache 2.0 或 MIT 等標準寬鬆授權。組織在部署前應審閱其地域、署名、安全與商業使用條款。
MiniMax H3 Benchmark Performance
MiniMax 的發佈資料主要著重於示範、架構與用例,而非公布傳統的 VBench 類大型基準矩陣。更中立的參考來源之一是 Artificial Analysis 的 Video Arena,使用者會對相同提示的生成結果進行盲測比較。
| Artificial Analysis task | H3 rank | H3 Elo | Leader | Leader Elo |
|---|---|---|---|---|
| Text-to-Video with Audio | #4 | ≈1,228 | Wan 3.0 | 1,242 |
| Image-to-Video with Audio | #3 | 1,185 | H3 Max, post-trained by fal | 1,202 |
| Video Editing with Audio | #2 | 1,129 | Wan 3.0 | 1,190 |
以上排名為 2026 年 9 月 2 日的快照,並非永久分數。H3 與領先的專有系統具備競爭力,尤其在開放權重陣容中表現亮眼。其價值主張在於將具競爭力的品質、原生視聽生成、多模態參考與可下載的基礎權重結合,而非僅追求最高基準分數。
MiniMax H3 Pricing
以下按量計費於 2026 年 9 月 24 日根據 MiniMax 官方定價頁面重新核對。價格可能變動,生產團隊在預算前應再次驗證。
| Usage | Official list price |
|---|---|
| H3 generation at 768P | $0.08/second |
| H3 generation at 2K | $0.13/second |
| 768P → 2K regeneration output | $0.05/second |
| Standard-generation reference audio | Free |
| Standard-generation reference images | First 5 free; then $0.04/image |
| Regeneration reference images | First 5 free; then $0.025/image |
| Regeneration reference video | $0.05/second of original 768P input |
| H3-Context-IR input | $0.90/M tokens |
| H3-Context-IR output | $3.60/M tokens |
以標價計,10 秒的直接生成在 768P 約 $0.80、在 2K 約 $1.30;15 秒約為 $1.20 或 $1.95。上述範例不含可計費的參考素材、Context-IR tokens 與其他工作流程相關費用。
MiniMax H3 也可透過 CometAPI 使用。其模型頁面在模型 ID 為 minimax-h3 下標示起始費率 $0.064/second。第三方標示價格可能取決於路由、解析度與計費規則,故不應視為通用單價。
MiniMax H3 vs Wan3.0 vs Seedance 2.5 vs Vidu Q3
最有用的競品不一定在紙面規格完全相同。MiniMax H3、Wan3.0、Seedance 2.5 與 Vidu Q3 在專業影片工作流程上各有著力點。
| Dimension | MiniMax H3 | Wan3.0 | Seedance 2.5 | Vidu Q3 |
|---|---|---|---|---|
| Maximum single generation | 15s | 30s | 30s | 16s |
| Video resolution | 託管 2K;開放權重基礎為 768p | 最高 1080P | 視路由而定 | 最高 1080P |
| Native audio-video | Yes | Yes | Yes | Yes |
| Reference inputs | 文字、影像、影片、音訊 | 影像、影片、音訊、文件、網頁 | 影像、影片、音訊 | 影像/參考工作流程 |
| Reference capacity | 12 個混合檔案 | 最多 20 份素材 | 最多 50 份素材 | 主頁未明確說明 |
| Major differentiator | 開放權重 H3-Base 加 2K 再生成 | 30 秒加廣泛輸入 | 30 秒敘事能力與大型參考集 | 短篇敘事與對話控制 |
| Strongest fit | 可自訂的多模態創意管線 | 長時長一站式製作 | 參考素材密集的商業敘事 | 短篇劇情與多人物對話 |
| Strongest fit | 可自訂的創意管線 | 長時長一站式製作 | 參考素材密集的商業敘事 | 短篇劇情與多人物對話 |
Which Model Is Better?
沒有通用的贏家。當開放權重、多模態條件控制、原生立體聲、視聽編輯與 2K 完成比最長片長更重要時,選擇 MiniMax H3。當 30 秒輸出、1080P、廣泛的文件/網頁參考與強勢的擂台表現最重要時,選擇 Wan 3.0。若需要非常大的參考集、30 秒的敘事結構、身份一致性或精準編輯,選擇 Seedance 2.5。若追求短篇敘事、多人物對話、節奏與如同導演般的鏡頭控制,選擇 Vidu Q3。
負責任的評估應在所有候選 API 上跑同一組內部提示。公開榜單不一定揭示可直接比較的版本,以舊版或 turbo 變體替代會扭曲結果。
What Are MiniMax H3's Main Limitations?
- 時長:H3 上限為 15 秒,而部分競品已支援 30 秒生成。
- 開放權重範圍:僅 H3-Base 可下載;Context-IR 與 2K 再生成仍為託管。
- 硬體需求:33B 的稠密影片模型即便有推理優化,本地部署成本仍高。
- 定價複雜度:生成、再生成、參考影片與圖片、以及 Context-IR 可能產生分離計費。
- 授權條款:Community License 較標準寬鬆授權需要更嚴謹的法務審查。
- 基準波動:擂台排名會變動,且不能取代針對工作負載的測試。
Who Should Use MiniMax H3?
H3 非常適合構建多模態影片工作流程的開發者與創意團隊,當他們需要一致的主體、動作或聲音參考、原生立體聲、編輯能力與高解析度完成時。也適合希望自訂或自託管基礎模型、僅在必要時使用託管階段的團隊。
主要需求是最長單次生成、最輕量本地部署或完整寬鬆授權端到端堆疊的團隊,可能會偏好其他模型。MiniMax 強調廣告、品牌、電商、產品設計、UI/UX、遊戲與電影等商業創作場景。
How Can Developers Access MiniMax H3?
有三條主要路徑:
- 使用 MiniMax 的託管產品,包括 Hailuo 與 MiniMax Design。
- 使用第一方 MiniMax Open Platform 的 H3-2K、H3-Context-IR 與 H3-Regenerate-2K API。
- 下載 H3-Base 檢查點,透過官方倉庫與支援的推理框架在本地部署。
實作細節請參考來源清單所連結的官方 API 與部署文件;本文聚焦於產品評估。
Conclusion
MiniMax H3 的重要性不在於它在每一項指標上都領先,而在於它將分散的製作鏈壓縮為一個可編程的多模態系統。可下載的 H3-Base 權重讓開發者能在本地原型化、自訂與迭代,而託管的 H3-Context-IR 與 H3-Regenerate-2K 階段提供了生產所需的更豐富指令處理與高解析度完成。這種混合模式也帶來取捨:15 秒上限、本地基礎設施需求、對託管服務的依賴、工作流程層面的成本,以及 Community License 條款,皆需對照團隊的真實提示與交付約束進行評估。對於優先重視多模態參考控制、同步原生音訊、視聽編輯與 2K 成片的團隊,H3 是一個引人注目的平台;而主要需要更長片段或完全自成一體且寬鬆授權堆疊的團隊,應在承諾前對替代方案進行基準測試。
FAQ
How should a production team divide work between local H3-Base and MiniMax’s hosted services?
一個可行的混合流程是:用本地 H3-Base 進行快速探索、提示迭代、參考測試,以及任何需要基礎設施控制或資料在地性的階段;有前景的輸出再移交給託管的 H3-Context-IR 以獲得更豐富的指令處理,並用 H3-Regenerate-2K 產出最終解析度。最佳分工取決於 GPU 能力、交付時效、治理需求,以及託管階段帶來的品質提升是否能抵銷額外的傳輸、延遲與計費。
What should an internal evaluation set measure before a team adopts H3?
不要只用視覺上華麗的提示評估 H3。請使用可重複的真實生產簡報集合,並評分指令遵循度、主體與品牌一致性、時間穩定性、文字渲染、鏡頭運動準確性、音畫同步、對話品質、再生成保真度、延遲、失敗率,以及每支可接受片段的總成本。將相同素材與驗收標準套用到競爭模型,避免以擂台排名取代團隊實際工作負載的證據。
How should multimodal reference assets be prepared to improve controllability?
參考素材應具備清晰且不衝突的角色:一張圖定義身份、一段片定義動作、一段音訊定義聲音或氛圍。移除低品質或矛盾的參考,將片段修剪至相關動作,並在指令中明確說明各素材與目標輸出的關係。從最小且足夠的參考集合開始,更易診斷哪個素材改善結果、哪個引入歧義。
Which production costs are easy to miss when comparing H3 with another API?
每秒生成價格只是可見的基線。實際成本模型應包含可計費的參考影片與額外圖片、Context-IR tokens、2K 再生成、重試、被拒生成、本地 GPU 能力、媒體儲存與傳輸、審核處理、整合工程與人工審閱。更有用的比較是「達標解析度下每支通過作品的成本」,而非「每次原始生成成本」。
How should teams interpret “2K by default” when H3-Base itself generates at 768p?
這兩個說法描述的是不同層次的產品。「預設 2K」指的是託管商業體驗;而 768p 指可下載的 H3-Base 階段的短邊輸出;隨後由 H3-Regenerate-2K 使用基礎結果與原始脈絡重建最終輸出。因此,品質測試應將本地 768p 與託管最終 2K 視為兩個獨立工作階段,比較再生成是否確實恢復文字、品牌、人臉與細節,而非僅僅提升像素尺寸。
When is MiniMax H3 unlikely to be the best first choice?
當專案需要大幅更長的單次片段、完全本地 2K 完成、標準寬鬆授權、極低 GPU 投入,或極其簡單且幾乎不需要多模態參考的文字轉影片流程時,H3 可能不是最佳首選。在此情況下,H3 泛化架構的價值未必能抵銷額外的營運複雜度。用具代表性的提示進行短期概念驗證,是判斷其控制力與音畫整合是否實質改善最終交付的最安全方式。