Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
technology / CometAPI 研究
請提供需要翻譯的原文內容(目標語言:繁體中文)。 Mistral Large 3 是由 Mistral AI 於 2025 年 12 月上旬發布的最新「前沿」模型家族。它是一個開放權重、面向生產環境的多模態基礎模型,圍繞 **細粒度稀疏的專家混合(MoE)** 設計構建,旨在提供「前沿」推理、長上下文理解,以及視覺 + 文本能力,同時通過稀疏性與現代量化保持推理的實用性。Mistral Large 3 具有 **675 billion 總參數**,在推理時約有 **~41 billion 活躍參數**,並在其預設配置中提供 **256k token** 的上下文窗口——這種組合旨在同時推進能力與規模,而不必讓每次推理都觸及全部參數。
Mistral Large 3 是由 Mistral AI 於 2025 年 12 月上旬發布的最新「前沿」模型家族。它是一個開放權重、面向生產環境的多模態基礎模型,圍繞 **細粒度稀疏的專家混合(MoE)** 設計構建,旨在提供「前沿」推理、長上下文理解,以及視覺 + 文本能力,同時通過稀疏性與現代量化保持推理的實用性。Mistral Large 3 具有 **675 billion 總參數**,在推理時約有 **~41 billion 活躍參數**,並在其預設配置中提供 **256k token** 的上下文窗口——這種組合旨在同時推進能力與規模,而不必讓每次推理都觸及全部參數。
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)Mistral Large 3 是 Mistral AI 於 2025 年 12 月上旬推出的最新「前沿」模型家族。它是一個開放權重、面向生產的多模態基礎模型,採用 細粒度稀疏混合專家(MoE) 設計,旨在在保持推理可行性的同時,透過稀疏性與現代量化提供「前沿」推理、長上下文理解,以及視覺 + 文本能力。Mistral Large 3 被描述為擁有 675 billion 的總參數,在推理時約有 ~41 billion 的活動參數,預設配置提供 256k token 的上下文視窗——這種組合在不讓每次推理都觸及所有參數的前提下,同時推動能力與規模。
什麼是 Mistral Large 3?它如何運作?
什麼是 Mistral Large 3?
Mistral
Large 3
大型、開放權重、多模態的混合專家(MoE)
稀疏
~675 billion
40–41 billion
256k tokens
簡而言之:這是一個 MoE 模型,總容量巨大(可儲存多樣專長),但在推理時計算的只是較小的活動子集——旨在比同等總規模的稠密模型更有效率地提供前沿效能。
核心架構:細粒度混合專家(MoE) 從高層來看,Mistral Large 3 用 MoE 層 取代了部分(或許多)Transformer 的前饋子層。每個 MoE 層包含:
大量專家(experts) —— 彼此獨立的子網路(通常是 FFN 區塊)。合計起來形成模型極大的「總」參數量(例如數百 billion)。 路由/門控網路(router/gating network) —— 一個小型網路,根據 token 的表徵決定該由哪些專家來處理該 token。現代 MoE 路由器通常只選擇 top-k 專家(稀疏門控),常見 k=1 或 k=2,以保持低計算量。 稀疏啟用 —— 對於任一 token,僅執行被選中的專家;其餘略過。效率正是由此而來:總儲存參數 >> 每 token 實際計算的活動參數。 Mistral 將其設計稱為「細粒度」MoE,以強調模型擁有許多小型/專門化的專家與一套優化的路由方案,可在多 GPU 與長上下文下擴展。其結果是:極大的表徵容量,同時將每 token 的計算維持在接近一個更小的稠密模型。總參數:
Total Parameters: 675 billion;所有專家與 Transformer 其它部分的參數總和。此數字表示模型的總體容量(可容納的知識與專業化程度)。
Active Parameters: 41 billion。由於路由器僅為每個 token 啟用少數專家,典型前向傳播時實際使用/計算的參數子集。這個指標更貼近每次推理的計算與記憶體使用。Mistral 公開資料列出約 ~41B 的活動參數;部分模型頁面對特定變體(例如 39B)顯示略有差異——可能反映不同變體/指令調優版本或四捨五入。
訓練配置:
使用 3000 張 NVIDIA H200 GPU 從零開始訓練;
數據涵蓋多語言、多任務與多模態;
支援影像輸入與跨語言推理。
Mistral Large 3 功能表 多模態理解 支援影像輸入與分析,能在對話中理解視覺內容。 多語言支援 原生支援 10+ 主流語言(English、French、Spanish、German、Italian、Portuguese、Dutch、Chinese、Japanese、Korean、Arabic 等)。 系統提示支援 對系統指令與上下文提示高度一致,適合複雜工作流程。 智能體能力 支援原生函式呼叫與結構化 JSON 輸出,可直接調用工具或整合外部系統。 上下文視窗 支援超長的 256K tokens 上下文視窗,為開源模型中最長之一。 效能定位 生產級表現,具備強大的長上下文理解與穩定輸出。 開源授權 Apache 2.0 License,可自由用於商業改造。
效能可與主流閉源模型相媲美;
在多語言任務上表現出色(尤其在非英語與非中文場景);
具備影像理解與指令遵循能力;
提供基礎版(Base)與指令優化版(Instruct),推理優化版(Reasoning)即將推出。
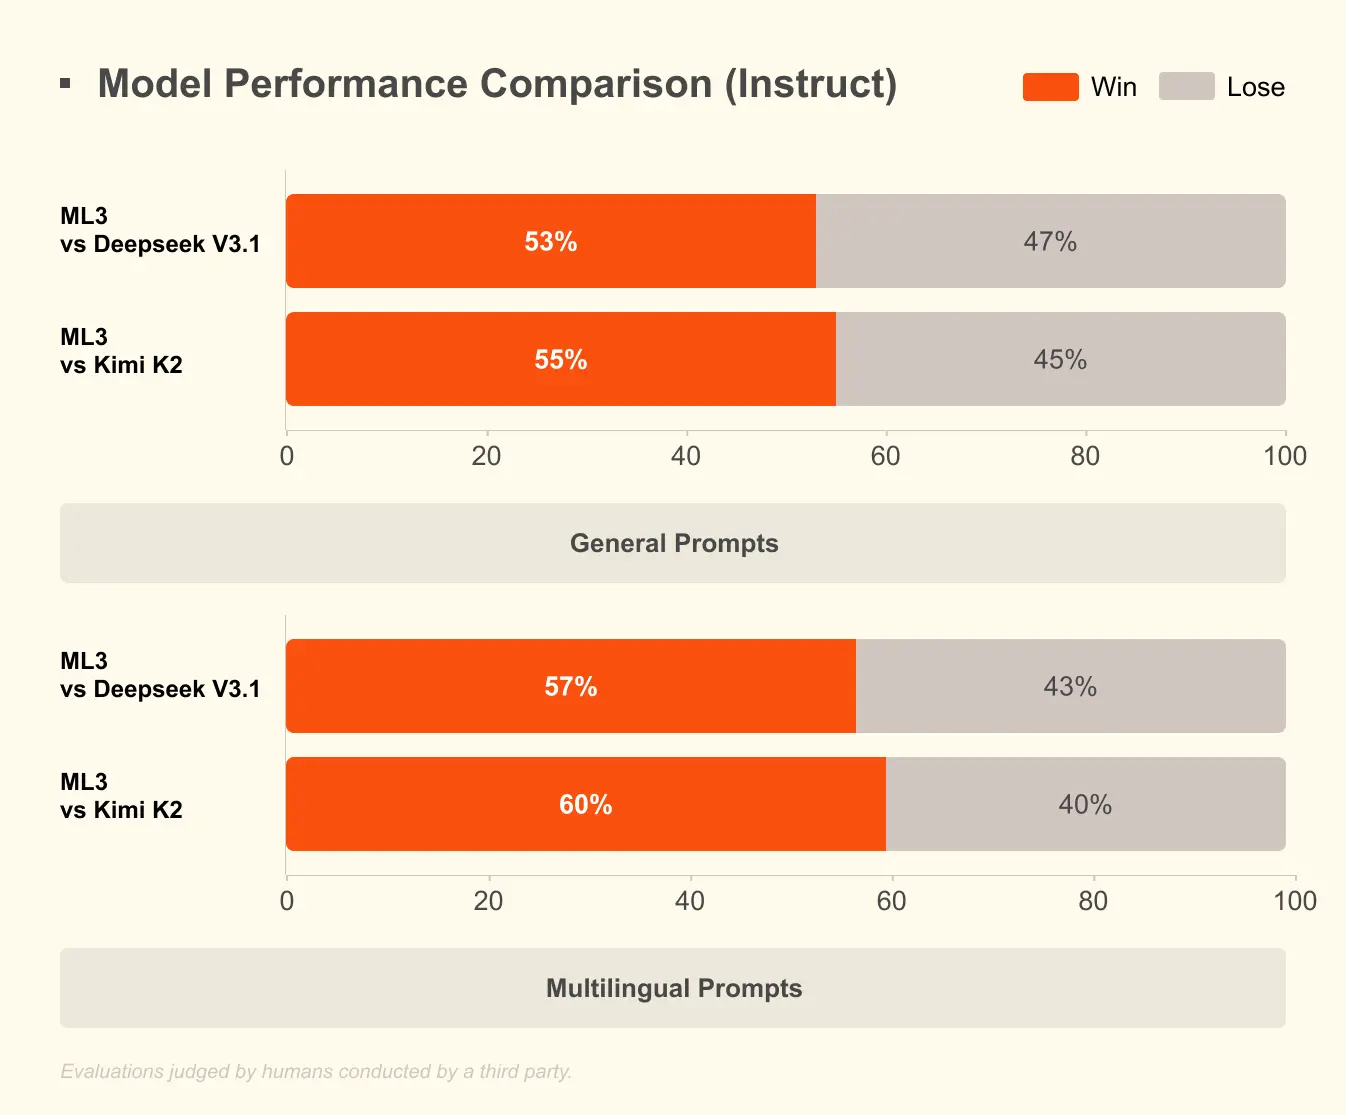
Mistral Large 3 在基準測試上的表現如何? 早期公開的基準測試與排行榜顯示,Mistral Large 3 在開源模型中名列前茅:在 LMArena 的 OSS 非推理模型中排名 #2,並在多項標準任務(例如 GPQA、MMLU 與其它推理/常識套件)上位居頂尖。
![Mistral Large 3 是 Mistral AI 於 2025 年 12 月上旬推出的最新「前沿」模型家族。它是一個開放權重、面向生產的多模態基礎模型,採用 細粒度稀疏混合專家(MoE) 設計,旨在在保持推理可行性的同時,透過稀疏性與現代量化提供「前沿」推理、長上下文理解,以及視覺 + 文本能力。Mistral Large 3 被描述為擁有 675 billion 的總參數,在推理時約有 ~41 billion 的活動參數,預設配置提供 256k token 的上下文視窗——這種組合在不讓每次推理都觸及所有參數的前提下,同時推動能力與規模。
什麼是 Mistral Large 3?它如何運作?
什麼是 Mistral Large 3? Mistral Large 3 是 Mistral AI 在 Mistral 3 家族中的旗艦「前沿」模型——一個 大型、開放權重、多模態的混合專家(MoE) 模型,依 Apache-2.0 授權發佈。它旨在提供「前沿」能力(推理、程式設計、長上下文理解、多模態任務),同時透過僅為每個 token 啟用部分專家的方式,讓推理計算保持 稀疏 。
Mistral Large 3 採用 混合專家(MoE) 方法:模型不為每個 token 啟用所有參數,而是將 token 的處理路由到部分專家子網路。Large 3 發佈的參數量約為 41 billion 的活動參數 (典型每個 token 參與的參數)與 675 billion 的總參數 (遍佈所有專家),一種稀疏但容量巨大的設計,旨在在計算效率與模型容量間取得平衡。該模型亦支援極長的上下文視窗(記載為 256k tokens )與多模態輸入(文本 + 影像)。
簡而言之:這是一個 MoE 模型,總容量巨大(可儲存多樣專長),但在推理時計算的只是較小的活動子集——旨在比同等總規模的稠密模型更有效率地提供前沿效能。
核心架構:細粒度混合專家(MoE) 從高層來看,Mistral Large 3 用 MoE 層 取代了部分(或許多)Transformer 的前饋子層。每個 MoE 層包含:
大量專家(experts) —— 彼此獨立的子網路(通常是 FFN 區塊)。合計起來形成模型極大的「總」參數量(例如數百 billion)。 路由/門控網路(router/gating network) —— 一個小型網路,根據 token 的表徵決定該由哪些專家來處理該 token。現代 MoE 路由器通常只選擇 top-k 專家(稀疏門控),常見 k=1 或 k=2,以保持低計算量。 稀疏啟用 —— 對於任一 token,僅執行被選中的專家;其餘略過。效率正是由此而來:總儲存參數 >> 每 token 實際計算的活動參數。 Mistral 將其設計稱為「細粒度」MoE,以強調模型擁有許多小型/專門化的專家與一套優化的路由方案,可在多 GPU 與長上下文下擴展。其結果是:極大的表徵容量,同時將每 token 的計算維持在接近一個更小的稠密模型。總參數:
Total Parameters: 675 billion;所有專家與 Transformer 其它部分的參數總和。此數字表示模型的總體容量(可容納的知識與專業化程度)。
Active Parameters: 41 billion。由於路由器僅為每個 token 啟用少數專家,典型前向傳播時實際使用/計算的參數子集。這個指標更貼近每次推理的計算與記憶體使用。Mistral 公開資料列出約 ~41B 的活動參數;部分模型頁面對特定變體(例如 39B)顯示略有差異——可能反映不同變體/指令調優版本或四捨五入。
訓練配置:
使用 3000 張 NVIDIA H200 GPU 從零開始訓練;
數據涵蓋多語言、多任務與多模態;
支援影像輸入與跨語言推理。
Mistral Large 3 功能表 多模態理解 支援影像輸入與分析,能在對話中理解視覺內容。 多語言支援 原生支援 10+ 主流語言(English、French、Spanish、German、Italian、Portuguese、Dutch、Chinese、Japanese、Korean、Arabic 等)。 系統提示支援 對系統指令與上下文提示高度一致,適合複雜工作流程。 智能體能力 支援原生函式呼叫與結構化 JSON 輸出,可直接調用工具或整合外部系統。 上下文視窗 支援超長的 256K tokens 上下文視窗,為開源模型中最長之一。 效能定位 生產級表現,具備強大的長上下文理解與穩定輸出。 開源授權 Apache 2.0 License,可自由用於商業改造。
效能可與主流閉源模型相媲美;
在多語言任務上表現出色(尤其在非英語與非中文場景);
具備影像理解與指令遵循能力;
提供基礎版(Base)與指令優化版(Instruct),推理優化版(Reasoning)即將推出。
Mistral Large 3 在基準測試上的表現如何? 早期公開的基準測試與排行榜顯示,Mistral Large 3 在開源模型中名列前茅:在 LMArena 的 OSS 非推理模型中排名 #2,並在多項標準任務(例如 GPQA、MMLU 與其它推理/常識套件)上位居頂尖。]()