
TL;DR
Muse Ember 是 Meta 最小的多模態推理模型,面向路由、抽取、工具調用與聚焦編碼等高頻代理任務。Meta 於 2026 年 11 月 9 日推出 Muse Ember。
其 1,048,576 令牌的上下文窗口 可容納大量來源材料。Meta 透過 Model API 與 Muse Code 提供存取;CometAPI 列示 muse-ember,啟用狀態見下文。請從可重複且能驗證輸出結果的任務開始,比較每次成功結果的成本(含推理、工具與重試)。
Key Takeaways
- 角色:Muse Ember 用於重複代理執行,包括分類、抽取、工具調用與邊界清晰的編碼任務。
- 輸入與容量:Muse Ember 接受文字、影像、音訊與影片,擁有 1M 令牌上下文窗口,最多輸出 512K 令牌。
- 表現:Meta 的結果顯示 Muse Ember 在多項代理基準中具優勢;獨立分析測試指出低令牌單價不一定帶來最低的任務成本。
- 價格:輸入令牌超過 200K 進入較高費率階層;總任務成本也取決於推理與工具使用。
- 存取:可用 Meta Model API 與 Muse Code;CometAPI 目前將該模型標註為 Coming soon。
What Is Muse Ember Best Used For?
Muse Ember 負責代理工作流中的執行步驟,而較大的模型負責規劃。它適合輸入明確、範圍有限、且應用可驗證結果的高量任務。其核心工作包括:
- 分類與路由:為請求加上標籤並送往正確的佇列或服務。
- 抽取:將文件與媒體轉為具來源證據的結構化欄位。
- 工具調用:選擇函式並提供應用要執行的引數。
- 批次處理:在檔案或紀錄上套用可重複的操作。
Support-Ticket Routing
一個實務支援工作流可請 Ember 抽取訂單參考、指定分類並標記缺失資訊。你的應用可在路由工單前,先用自身紀錄驗證該參考。退款、帳戶變更與其他重大動作請保留在應用本身的授權檢查之後。
Document Extraction with Evidence
對發票或合約處理,請求抽取值及其支撐的頁面或段落。將缺失與不可讀欄位視為明確的結果,而非引導模型猜測。這能產出讓審查者不必重讀每份文件就可檢視的紀錄。
Focused Coding Work
給予編碼工作者小而清楚的邊界:允許變更的檔案、需保留的行為、以及定義完成的測試。Meta 的平行程式碼遷移範例展示了這種分工。周邊代理負責執行命令與檢查結果;僅靠模型回應不足以證明變更已通過測試。
Meta 的 Muse Ember 發佈視覺配合其指南,說明如何將執行模型與較大的規劃模型結合。
Meta 指出 Muse Ember 是首個使用 Muse Wonder Full 訓練的模型,延續其以較大型模型打造專門模型的策略。
Muse Ember Specifications
核心規格如下:
| 規格 | Muse Ember |
|---|---|
| 開發者 | Meta Superintelligence Labs |
| 發布日期 | November 9, 2026 |
| 模型類別 | Multimodal reasoning and agent execution |
| 上下文窗口 | 1,048,576 tokens |
| 最大輸出 | 524,288 tokens |
| 輸入模態 | Text, images, audio, video |
| 檔案輸入 | Supported through the Responses API |
| 輸出模態 | Text |
| 推理強度 | Minimal, Low, Medium, High, XHigh, Max |
| 預設推理強度 | Max |
| 工具調用 | Supported |
| 結構化輸出 | Supported |
| 搜尋錨定 | Supported through the Model API |
Meta 尚未公開 Muse Ember 的權重或參數量。請求與令牌限制以團隊為單位適用,同一團隊的所有 API 金鑰共享該模型的額度。
Context and Multimodal Inputs
在 PDF 工作流中,Meta 會從前 100 頁擷取文字、前 50 頁擷取影像,因此處理前請先拆分較長的檔案。只傳送任務所需的材料;推理令牌與最終答案共用 524,288 令牌的輸出配額。
當版面配置重要時使用螢幕截圖,文件抽取使用掃描件,會議分析用音訊,事件隨時間推進則用影片。僅文字摘要的話有逐字稿即可。檔案透過 Responses API 支援,結果以文字返回。
Configurable Reasoning Effort
Muse Ember 提供六種推理等級:Minimal、Low、Medium、High、XHigh、Max。Meta 預設為 Max;所有等級皆受支援;使用不受支援的值會返回 HTTP 400。對常規路由與分類,從較低等級開始,僅在更高接受率能抵銷額外延遲與輸出令牌成本時再提高。
Tool Calling and Structured Output
Muse Ember 支援工具調用與結構化輸出。工具調用把模型決策連接到應用函式,結構化輸出讓抽取的欄位更易驗證並傳遞至下一步。
以下支援工單的示例結果為路由應用提供分類、優先級與審核標記:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API 亦支援搜尋錨定與電腦操作工作流。連接的應用負責提供工具、執行動作並控制權限。
How Does Muse Ember Perform on Benchmarks?
Meta 的發佈結果使用最大推理強度。Agents’ Last Exam 涵蓋 Meta 內部評估中的 Linux 子集;Terminal-Bench 使用每個模型最佳公開的執行工具鏈。它們結合外部報告的 Artificial Analysis 結果與 Meta 的內部評估;Personal Superintelligence Index 為 Meta 的內部綜合指標,非獨立排行榜。
Muse Ember Benchmark Results
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 為 Muse Ember 使用 mini-swe-agent、Haiku 5.5 使用 Claude Code、GPT-6 Luna 使用 Codex。這些並非相同的執行環境。OSWorld 2.1 同時報告部分分數與二元分數,而 PerceptionBench 包含工具。Artificial Analysis Intelligence Index 的結果來自 2026 年 11 月 9 日發布的版本 5。
Muse Ember Benchmark Analysis
代理執行是 Muse Ember 的強項。
在 AutomationBench-AA 上,Muse Ember 得分 37.8,相較 Haiku 5.5 的 13.9 與 GPT-6 Luna 的 20.2。這支持 Meta 對 Muse Ember 作為端到端業務工作流與重複代理操作模型的定位。
編碼表現具有競爭力,但並非全面領先。
Muse Ember 在 Terminal-Bench 4.0 得分 40.9,在 Coding Agent Index-AA 得分 46。然而在 FrontierCode 2.0-AA 得分 27.2,低於 Haiku 5.5 的 34.9。這顯示 Muse Ember 適合作為邊界清晰的編碼子任務候選,而更困難的工程工作應與更強的替代方案並測。
多模態與電腦操作的結果值得期待。
Muse Ember 在包含工具的 PerceptionBench 得分 80.6,在 OSWorld 2.1 部分分數得分 69.5。這些結果支持其在涉及視覺理解與電腦互動的工作流中的定位。
一般智能與 Haiku 5.5 相當。
Muse Ember 與 Haiku 5.5 在 Artificial Analysis Intelligence Index 上皆四捨五入為 36,領先 GPT-6 Luna 的 28。選型時,請把這種寬泛比較與上述特定任務結果配對考量。
Muse Ember Intelligence vs. Cost Per Task
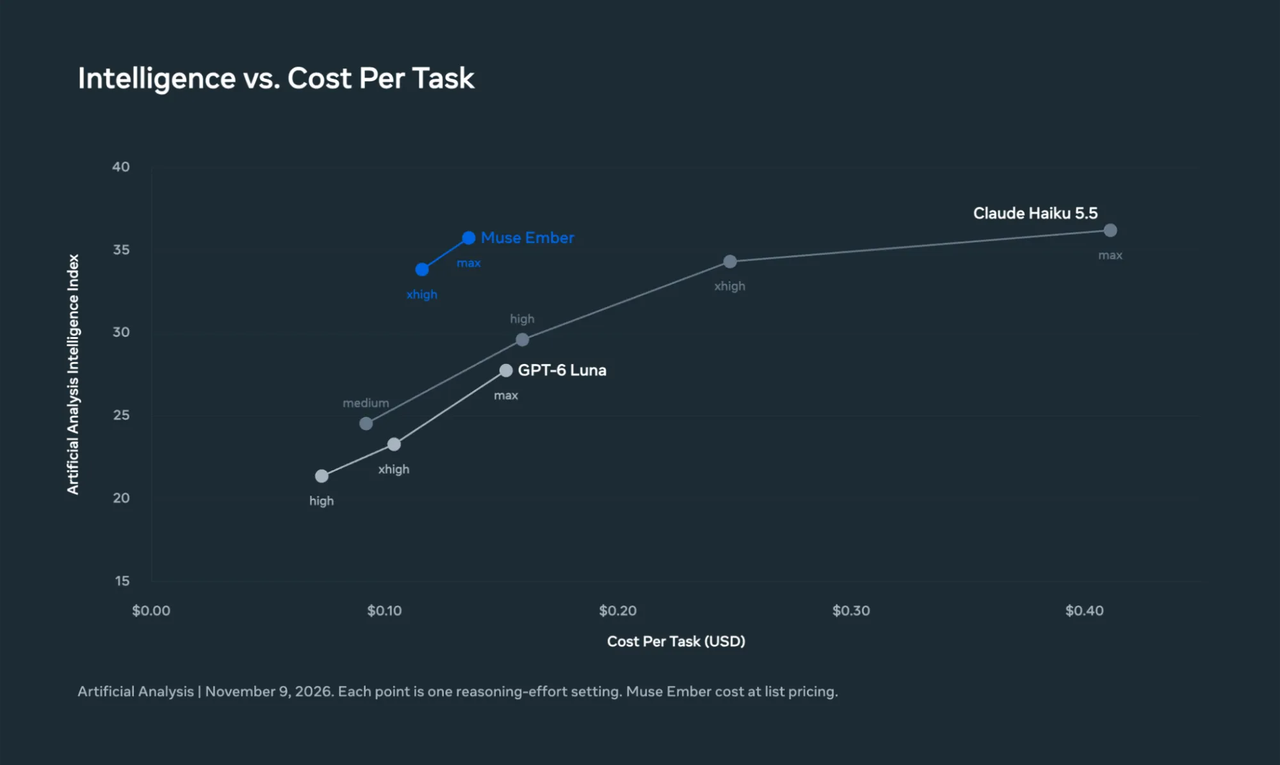
Meta 的圖表比較 Artificial Analysis Intelligence Index 分數與不同推理強度設定下的每次任務估算成本。
在最大推理強度下,Muse Ember 在 Artificial Analysis Intelligence Index 上得分 35.8、估算每次任務成本 $0.136。Haiku 5.5 得分 36.2、成本 $0.411;GPT-6 Luna 得分 27.8、成本 $0.152。在此基準上,Ember 以約三分之一的成本接近 Haiku 的分數,並以略低的成本超過 Luna 的分數。
這些估算使用基準的令牌消耗與牌價。下一項評測顯示為何在特定工作流的選型中,工具活動很重要。
Independent Data-Analysis Results
Plotly 於 2026 年 11 月 10 日的資料分析評測在 Plotly Studio Embedded 中、針對合成風能資料集測試了 43 個問題。Muse Ember 透過 OpenRouter 運行;報告成本使用各模型運行時可用的價格。這些是與工作負載相關的結果,而非 Meta 原生 API 計費測試。
| 評測指標 | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| 通過問題數 | 38/43 | 38/43 | 37/43 |
| 整體測試成本 | $1.04 | $0.13 | $0.38 |
| 每題中位時間 | 28 seconds | 18 seconds | 14 seconds |
對此資料分析工作負載而言,GPT-6 Luna 以約八分之一的總成本達到與 Ember 相同的 38/43 通過數,且中位回應時間更低。Haiku 以每題 14 秒最快,通過數為 37/43。對類似對成本敏感的分析工作流,Luna 是更強的起始候選;Ember 的低令牌費率本身並不保證最低成本。
Plotly 發現,在涉及隱藏模式的問題上,Muse Ember 平均發出 78 次查詢,而受測模型的中位數為 25。額外的工具活動增加了其令牌消耗與總成本。
測試亦顯示其優勢:Muse Ember 在 20 個定義明確的分析問題、5 個模糊問題、5 個不可完成的請求、以及 3 個資料品質檢查上皆回答正確。它在資料中的隱藏模式上表現最弱。
Plotly 每個模型僅運行一次,重複其他模型時觀察到最多 3 題的變動。請將 38 對 37 的通過數視為接近;此處更明顯的差異是工具使用與總成本。
Muse Ember vs Muse Wonder vs Muse Spark
請依模型所承擔的責任選擇 Muse 系列:規劃、主代理迴圈,或重複執行。
| 維度 | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| 主要角色 | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| 主要強項 | Planning, long-running tasks, complex coding | Coding and agentic workflows | Repetitive subtasks and tool calls |
| 典型工作負載 | Repository-scale engineering | Main agent execution | Classification, routing, extraction |
| API 模型 ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| 上下文窗口 | 1M tokens | 1M tokens | 1M tokens |
| 預設推理 | Max | High | Max |
| 標準輸入單價 / 每百萬令牌 | $4.00 | $1.25 | $0.10 |
| 標準輸出單價 / 每百萬令牌 | $20.00 | $4.25 | $0.50 |
此表使用 Meta 的 Standard 模式令牌價格。Ember 的價格適用於最多 200K 輸入令牌的請求;Wonder 與 Spark 不包含 Ember 的長上下文溢價。
Muse Model Selection
若需處理困難規劃、整個版本庫規模的工程與跨長序列步驟的恢復,選 Wonder。若要運行主編碼或代理迴圈,選 Spark。若要執行可獨立驗證輸出的重複子任務,例如路由、抽取與目標明確的檔案變更,選 Ember。
例如,在版本庫遷移中,可將相依分析交給較大的模型,而將範圍明確的檔案變更交給 Ember。交接應指明檔案、預期行為與接受檢查。只有當協調與審查較小任務的成本低於用主模型完成整個工作時,這種分工才有用。
在它們之間做選擇時,請以相同的代表性任務與相同的接受檢查進行測試。先淘汰未達成功率或延遲目標的配置。在通過者之間,比較總支出除以被接受的結果,包含重試與工具調用。將能降低該成本的任務類型指派給 Ember,並把未解決的案例回路至 Spark 或 Wonder。
How Much Does Muse Ember Cost?
下表將 Meta 的官方費率與 CometAPI 估算 8 折優惠配對,單位為每百萬令牌的美元。每個儲存格顯示 Meta / 8 折估算。CometAPI 的列表尚未公布即時費率;預算規劃可採用折扣估算值。
| 每百萬令牌用量費率(Meta / 8 折估算) | 最多 200K 輸入令牌 | 超過 200K 輸入令牌 |
|---|---|---|
| 輸入 | $0.10 / $0.08 | $0.30 / $0.24 |
| 快取輸入 | $0.004 / $0.0032 | $0.012 / $0.0096 |
| 輸出 | $0.50 / $0.40 | $1.50 / $1.20 |
請求的總輸入令牌(含快取輸入)決定其費率階層。超過 200K 輸入令牌的請求,整個請求(含輸出)均適用較高費率。使用 Meta 的 previous_response_id 時,儲存的對話歷史計入該輸入總量。
Typical Muse Ember Request Costs
在無快取輸入且包括推理的 20K 計費輸出令牌下,200K 輸入的請求在 Meta 費率為 $0.0300,8 折估算為 $0.0240。若將輸入增加至 220K,整個請求移入較高階層:相同 20K 輸出下,總計 Meta 費率 $0.0960,折扣估算 $0.0768。這些示例不包含獨立的工具費用。將相關上下文維持在較低階層,節省幅度可超過單純的 20% 折扣。
| 情境 | 輸入令牌 | 計費輸出令牌 | Meta 成本 | CometAPI 成本 |
|---|---|---|---|---|
| 標準請求 | 200K | 20K | $0.0300 | $0.0240 |
| 長上下文請求 | 220K | 20K | $0.0960 | $0.0768 |
推理令牌計入計費輸出。對 Meta 原生 API,網頁搜尋錨定每 1,000 次查詢需另付 $2.50,且 Ember 無 Contributor 模式變體。上述令牌價格比較未將 20% 折扣套用到獨立的工具費用。
How to Access Muse Ember
CometAPI 列表:模型頁面標識模型為 muse-ember,但其目錄狀態截至 2026 年 11 月 16 日為 Coming soon。請關注該頁面的啟用與定價;若需立即存取,請使用 Meta Model API 或 Muse Code。
**透過 Meta Model API:**使用 muse-ember-1.0 搭配 https://api.meta.ai/v1. 原生 API 支援 Responses、Chat Completions 與 Messages 格式。檔案輸入使用 Responses。配置用戶端時,請保持各供應商的端點與模型標識一致。
**原生 API 限制與其他存取:**Meta 列出每分鐘 3,000 次請求與每分鐘 4,000,000 令牌,按團隊計算並由團隊的 API 金鑰共享。Muse Ember 亦可在 Muse Code 中使用。批次規劃時請檢查所選路徑的限制,並使用 Meta 的整合指南完成原生 API 設定。
What Are the Limitations of Muse Ember?
決定 Ember 是否適合你的工作流有三個因素:
- 複雜工程仍取決於工作負載。儘管在 Terminal-Bench 的結果較強,Ember 在 FrontierCode 2.0-AA 落後於 Haiku 5.5。某一窄範圍的編碼勝出不代表適合所有版本庫規模的變更。
- 長上下文與低令牌單價不保證低任務成本。大型請求會進入較高費率階層,重複的工具使用可能消耗足夠令牌以抵消低單價。
- 工具支援仍需應用系統。周邊系統負責執行調用、控制權限與驗證結果。模型能請求動作並不等於提供可靠工作流。
Conclusion
在接受準則足夠清楚、可衡量的情境中採用 Ember。實用的首部署可選擇已有明確結果的高量步驟,例如路由已標記的工單或抽取經審核文件的欄位。將成功任務成本、錯誤率與延遲與你當前模型相比,再擴大其角色。這些證據將告訴你,Ember 是否能在維持所需品質的同時,降低工作流成本。
FAQ
應如何驗證 Muse Ember 的抽取結果?
建立一組經人工核對答案的參考文件,包含缺失欄位、不可讀掃描件與衝突值。按欄位衡量準確度,而非將每個有效的 JSON 回應都視為成功。檢查每個抽取值是否由所引述的來源段落支持,並將不一致送審。這能將格式可靠性與事實可靠性區分開來。
何時應讓 Muse Ember 的子任務返回主代理?
在執行前定義升級條件:必要檔案超出指派範圍、來源彼此不一致、接受檢查多次失敗、或任務需要工作者未被授權的決策。返回證據、嘗試步驟與未解決問題給主代理。清楚的交接比讓工作者無限擴大指派更有用。
在生產中測試 Muse Ember 時應記錄什麼?
記錄精確的供應商與模型標識、推理設定、輸入與計費輸出令牌、快取令牌、工具調用次數、重試、延遲與最終接受結果。將驗證結果與使用紀錄並存,以便計算每個被接受任務的成本。分別比較相似的任務類型;跨路由、編碼與長文件工作的平均值可能掩蓋模型究竟在哪些地方在幫助或增加成本。
如何避免 Muse Ember 工作流中的重複動作?
讓應用負責動作身份與完成狀態。對如建立工單的操作,分配穩定的操作鍵、檢查是否已完成,並在可用時使用目的 API 的冪等性支援。逾時後重試前,先檢查該動作的狀態。此設計可避免將不確定的回應視為原始動作從未發生的證據。