SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. ai-model/CometAPI 研究
什麼是 Step 5 Preview?規格、基準測試、定價與開放權重
探索 StepFun Step 5 Preview,其 600B MoE 架構、1M-token 上下文、程式碼基準測試、定價、開放權重與 API 存取。

Deon GoodwinAI 模型與 API 研究團隊 from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-5-mini",
messages=[{"role": "user", "content": "Build this workflow."}],
)
print(response.choices[0].message.content)
TL;DR
Step 5 Preview 是 StepFun 的旗艦 AI 模型,面向軟體工程、金融研究與複雜代理工作流程。它在任務表現與推理成本之間取得平衡,但在不同基準上結果有所差異。開發者可透過託管 API 存取或依據預算、基礎設施與效能需求部署其開放權重。
Key Takeaways
- **Architecture:**Step 5 Preview 採用稀疏 MoE 架構,總參數 600B、每個 token 啟用 27B,在模型容量與推理效率之間達到平衡。
- **Context and multimodal support:**該模型支援 1M-token 的上下文視窗、文字、影像與影片輸入,並可透過其託管 API 輸出最多 64K tokens。
- **Benchmark performance:**Step 5 Preview 在 DeepSWE v1.1 取得 67.7%,在 FrontierFinance 取得 66.4%,但在 Terminal-Bench v4 落後多個競品。
- **API pricing:**StepFun 對未快取輸入每百萬 tokens 收費 $1.00,對已快取輸入收費 $0.10,對輸出收費 $2.70。
- **Deployment flexibility:**開發者可透過 StepFun 的託管 API 存取 Step 5 Preview,或使用 vLLM、SGLang、Transformers 等相容框架自我託管其釋出的權重。
What Is Step 5 Preview?
Step 5 Preview 是 StepFun(阶跃星辰)開發的大型多模態推理模型,面向需要延展推理、重複工具執行,以及跨大量資訊集合進行分析的工作負載。StepFun 提供託管 API 存取並發布可下載的模型權重。
與主要優化於對話回應的通用助理不同,Step 5 Preview 強調代理式執行:能夠規劃、使用工具、檢視中間結果、修正錯誤,並持續朝複雜目標前進的能力。
Key Specifications
|
| Developer | StepFun |
| Model identifier | step-5-preview |
| Model category | Multimodal reasoning and agentic LLM |
| Architecture | Sparse Mixture-of-Experts |
| Total parameters | Approximately 600B |
| Active parameters per token | Approximately 27B |
| Active parameter proportion | Approximately 4.5% |
| Context window | Up to 1M tokens |
| Supported inputs | Text, images, and video on the hosted API |
| Hosted API maximum output | 64k tokens |
| Primary output | Text |
| Reasoning modes | low, medium, high; reasoning_effort on Chat Completions |
| Tool calling | Supported |
| Structured output | JSON Mode and JSON Schema on the hosted API |
| Prompt caching | Supported |
| Hosted API status | Available as of October 19, 2026 |
| Weight availability |
託管 API 文件列出最多 64k-token 的輸出上限,而模型卡則標註序列生成能力可達 1M tokens。後者不代表託管端點允許 1M-token 的完成輸出。對於自我託管的 vLLM 範例,設定的 1M-token 序列預算包含輸入與輸出;可用的 KV-cache 記憶體與並發量會降低可用容量。
How the 600B/27B MoE Architecture Works
傳統的稠密 transformer 在推理期間會啟用其大多數參數。Step 5 Preview 則採用稀疏路由來選擇相關專家。在約 600B 的總參數中,約有 27B 參與典型 token 的計算,約占總參數的 4.5%。
這一差異有助於解釋其成本效率策略。然而,27B 的啟用參數並不意味著部署佔用僅為 27B。完整的專家權重仍必須儲存與存取,因此 GPU 記憶體容量、專家並行與互連頻寬都是關鍵考量。
託管 API 接受文字、影像與影片輸入,上下文視窗可達 1M tokens,最大輸出為 64k tokens。這些輸入支援存放庫分析、金融文件研究與視覺解讀等任務。對於自我託管,實際可用序列長度取決於執行時組態、可用記憶體與並發量。
多模態支援與 API 能力,可能在託管與自我部署的組態間有所差異。
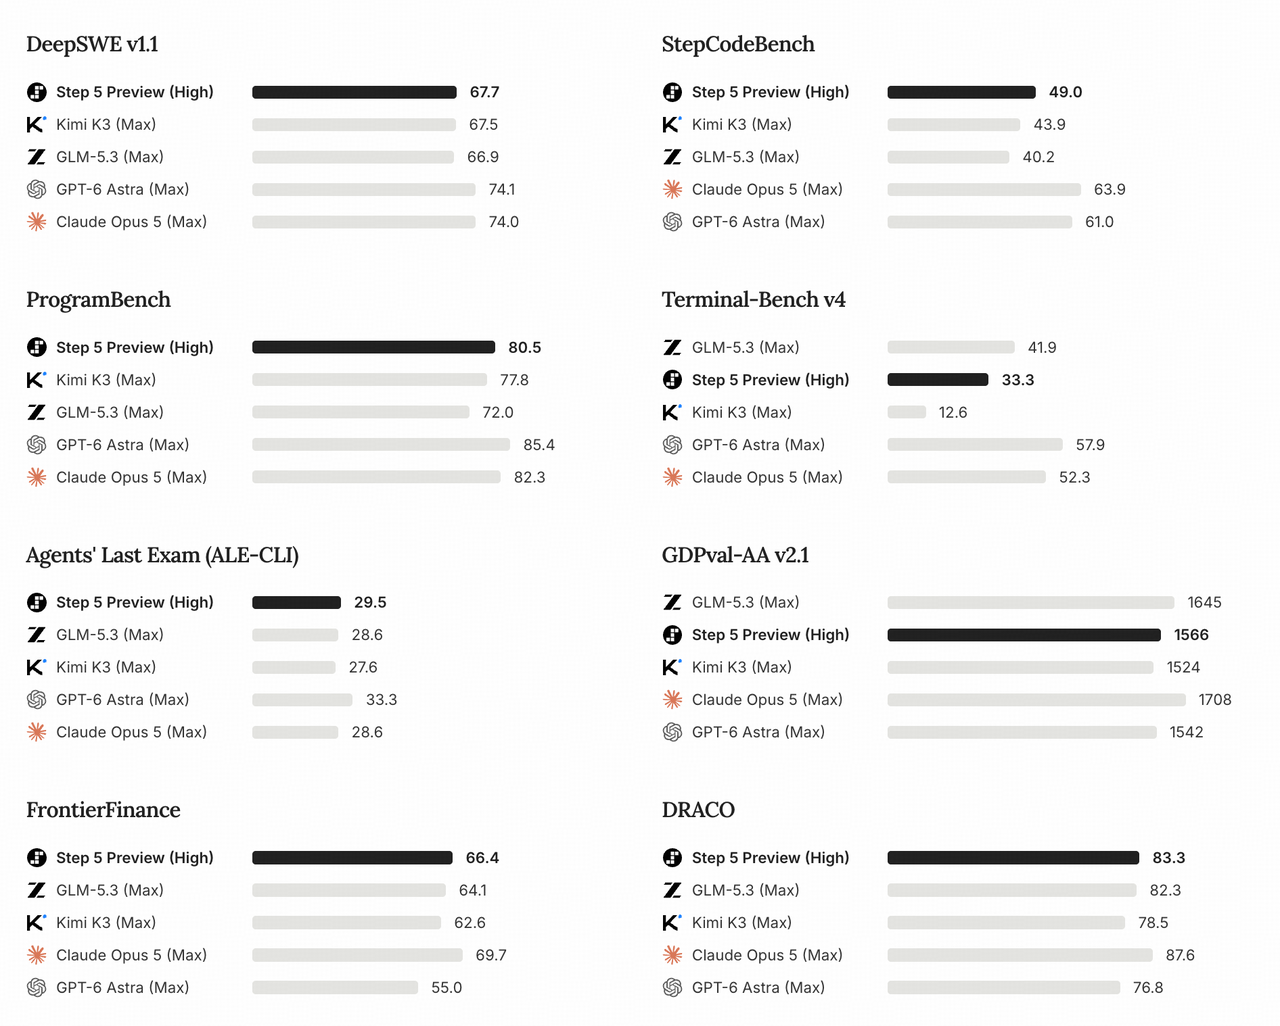
以下為 StepFun 報告的結果。Step 5 Preview 使用 High 推理設定;比較模型使用 Max。僅比對標籤名稱並不能證明等量的計算;這些公布的分數也未衡量應用延遲或每次成功任務的成本。
原始官方圖表總結了發布者的評估結果。下列表格摘取與本分析相關的程式設計、推理與金融分數。
|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| Agents’ Last Exam (ALE-CLI) | 29.5 | 27.6 | 28.6 | 33.3 | 28.6 |
分數為百分比,各基準上數值越高代表表現越好。DeepSWE v1.1 使用 SWE-agent 測試框架,temperature=1.0、top_p=0.95;StepCodeBench 報告 avg@4,ProgramBench 報告通過率。各基準在自身評估設定下量測不同的任務,因此百分比不可互換視為相同的準確度指標。所公布的比較並未建立各模型使用相同硬體或相同執行預算。
在 DeepSWE v1.1 上,Step 5 Preview 取得 67.7%,略高於 Kimi K3 與 GLM-5.3。這顯示其在處理存放庫與自動化軟體工程的程式設計代理任務上具有競爭力。
ProgramBench 提供了另一項正面訊號。Step 5 Preview 達到 80.5%,Kimi K3 為 77.8%、GLM-5.3 為 72.0%。
然而,Terminal-Bench v4 揭示了一項重要限制:Step 5 Preview 的 33.3% 落後於 GLM-5.3 的 41.9%,而 GPT-6 Astra 達到 57.9%。這意味著 Step 5 Preview 在面向存放庫的軟體工程任務上具有競爭力,但其相對優勢並未一致延伸至終端導向的執行與複雜除錯。
|
| GPQA Diamond | 93.5% | 91.7% | 93.5% | 96.1% |
| Humanity’s Last Exam | 46.5% | 42.3% | 46.9% | 54.7% |
| AA-LCR v1.1 | 88.3% | 79.7% | 88.7% | 80.7% |
| CritPt | 20.9% | 19.1% | 23.4% | 31.7% |
Step 5 Preview 在 GPQA Diamond 取得 93.5%,與 Kimi K3 相當,落後 GPT-6 Astra 的 96.1%。在 AA-LCR v1.1 上,其 88.3% 略低於 Kimi K3 的 88.7%,高於 GPT-6 Astra 的 80.7%。在 Humanity’s Last Exam 與 CritPt 上也落後於 Kimi K3 與 GPT-6 Astra。結果顯示其在知識與長上下文推理上具有競爭力,但相對強項會隨任務而變化。
金融研究是 Step 5 Preview 最具特色的應用領域之一。該模型設計用於結合量化推理、證據擷取與結構化分析。這些能力對估值、金融文件解讀與投資研究尤為重要。
StepFun 推出 FinStepBench,以評估金融研究在多個階段的表現,從資訊蒐集到產出可辯護的結論。
|
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
| FinStepBench LiveSearch | 74.5 | 70.9 | 73.3 | 74.5 | 76.2 |
| FinStepBench CorporateValuation | 60.6 | 60.6 | 56.1 | 77.3 | 69.7 |
| FinStepBench DeepResearch | 55.8 | 48.9 | 53.3 | 45.0 | 59.1 |
分數越高代表基準表現越強。由於 FinStepBench 由 StepFun 開發,獨立驗證尤為重要。
Step 5 Preview 在 FrontierFinance 取得 66.4%,在所報告的設定下高於 Kimi K3、GLM-5.3 與 GPT-6 Astra。但 Claude Opus 5 以 69.7% 領先。
FinStepBench DeepResearch 的結果尤其值得注意。Step 5 Preview 達到 55.8%,Kimi K3 為 48.9%、GLM-5.3 為 53.3%。這顯示該模型可能非常適合需要檢索、綜整與延展分析的金融研究工作流程。
其 CorporateValuation 分數則呈現更細緻的訊息。以 60.6% 而論,Step 5 Preview 明顯落後 GPT-6 Astra 的 77.3%。因此,Step 5 Preview 不應被視為在金融分析上普遍優於其他模型。其相對排名在 DeepResearch 上較強,而在 CorporateValuation 上較弱,支持以任務為基準進行評估,而非籠統宣稱金融表現上的全面優勢。
用於生產應用時,金融輸出仍需獨立驗證計算、記錄假設並提供可追溯的佐證。
Step 5 Preview vs Other AI Models
Step 5 Preview 同時與託管替代方案與專有前沿服務競爭。基準結果有助於識別候選模型;API 存取、輸入支援、部署控制與實際工作負載成本則決定何者適合用於生產。
Step 5 Preview 提供文件化的 600B/27B 稀疏 MoE 檢查點與自我託管選項。對於替代模型,權重可用性、參數規模、上下文上限與可接受輸入取決於各模型與端點。已發布的基準結果可協助建立候選清單;具代表性的程式設計與研究任務可揭示各服務在實務中的行為。
Step 5 Preview vs Kimi K3
Step 5 Preview 在 DeepSWE v1.1、ProgramBench 與 FrontierFinance 上表現略好。Kimi K3 在推理與特定技術評估上仍具競爭力。實務上的差異更多在於成本、服務條件與針對特定任務的可靠性,而非絕對的智慧優勢。
Step 5 Preview vs GLM-5.3
Step 5 Preview 在多項金融與軟體開發評估上領先 GLM-5.3。然而,GLM-5.3 在 Terminal-Bench v4 的較強分數,顯示其於已報告的終端導向任務上具優勢。對於程式設計代理,請比較存放庫修改成功率、工具呼叫錯誤、執行時間與修補正確性,而非僅依賴單一整體分數。
Step 5 Preview vs GPT-6 Astra and Claude Opus 5
專有前沿模型通常在最困難的軟體工程基準上表現更佳。Step 5 Preview 的主要吸引力在於:它在特定工作負載上具有接近競爭力的能力,同時提供開放權重的部署選項與相對可及的 API 定價。
當失敗成本高、且任務準確度的增量可證明額外支出合理時,請選擇高端模型。當價格、部署控制與反覆代理執行更為重要時,請考慮 Step 5 Preview。
How Much Does Step 5 Preview API Cost?
Step 5 Preview 的價值取決於任務能力與營運成本。代理工作流程可能涉及數十次呼叫、重複文件擷取與重試,因此較低的 token 單價只有在模型可靠完成任務時才有助益。每次成功完成任務的成本,是下方費率的有用補充。
API Availability and Token Pricing
此 2026 年 10 月 19 日的快照比較了 StepFun 原生 API 費率 與模型比較章節所連結的 CometAPI 費率。所有價格以美元計,每百萬 tokens。各服務的計費、快取與端點條件不同;「not listed」意指本文的來源快照未提供已快取輸入費率。
|
| Step 5 Preview | StepFun native API | step-5-preview | $1.00 | $0.10 | $2.70 |
| Kimi K3 | CometAPI | kimi-k3 | $2.40 | Not listed | $12.00 |
| GLM-5.3 | CometAPI | glm-5.3 | $1.12 | Not listed | $3.53 |
| GPT-6 Astra | CometAPI | gpt-6-astra | $8.00 (short-context tier) | Not listed | $40.00 (short-context tier) |
| Claude Opus 5 | CometAPI | claude-opus-5 | $4.00 | Not listed | $20.00 |
GPT-6 Astra 的短上下文層級適用至 272,000 tokens;所引長上下文費率為每百萬 tokens 的輸入 $16、輸出 $60。所列費率不包含工具、重試與基礎設施。此比較不表示 Step 5 Preview 可透過 CometAPI 使用;下方 Step 5 Preview 範例使用 StepFun 的原生端點。
快取命中後的輸入費率比未快取低 90%。未快取價格包含將新內容寫入快取,而輸出計費包含推理與最終答案的 tokens。重複的提示文字只有在服務回報合格的快取命中時才享有較低費率;僅以可見答案長度估計,會低估可計費的輸出。
Example Cost Calculations
|
| Short analytical request | 10K | 0 | 5K | $0.0235 |
| Medium coding workflow | 100K | 0 | 20K | $0.154 |
| Repeated agent request | 10K | 90K | 20K | $0.073 |
| Large document analysis | 500K | 0 | 30K | $0.581 |
| Long-context cached workflow | 100K | 400K | 50K | $0.275 |
Cost formula: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000,其中 Tu/Tc/To 分別代表未快取輸入、已快取輸入與可計費輸出 tokens,Pu/Pc/Po 為其每百萬 tokens 的價格。
考慮兩個 StepFun 請求,皆為 100,000 個輸入 tokens 與 20,000 個可計費輸出 tokens:
- Cache miss:全部 100,000 個輸入 tokens 未快取。Cost = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154。
- Cache hit:90,000 個輸入 tokens 享有快取費率,10,000 個仍未快取。Cost = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073。
快取命中的例子節省 $0.081,約 52.6%,在相同輸入與輸出量下。節省取決於服務回報的合格快取命中。上述例子不含外部工具、重試與基礎設施成本。
僅憑 token 價格無法決定最佳價值的模型。需要多次重試的代理可能比一次成功的高價模型更昂貴。為了可靠的成本比較,請在 token 價格之外,使用每次成功完成任務的成本。
Is Step 5 Preview Open Source, and Can It Run Locally?
StepFun 透過其官方 Hugging Face 存放庫發布可下載的權重,截至 2026 年 10 月 19 日提供 FP8、BF16 與 NVFP4 變體。可存取權重讓自我部署成為可能,但並不使該模型在記憶體需求上等同於小型稠密模型。
可用檔案包含 Step 5 Preview 的檢查點、BF16 版本與 NVFP4 版本。
Local Deployment Requirements
- FP8 with vLLM:4 × NVIDIA B300 或 8 × NVIDIA H200,提供相容 OpenAI 的 API。
- BF16 with vLLM:8 × NVIDIA B300 或 16 × NVIDIA H200,提供相容 OpenAI 的 API。
- FP8 with SGLang:4 × NVIDIA B300,提供相容 OpenAI 的 API;FP8 with Transformers:8 × NVIDIA H200,用於離線生成。
這些為參考組態,並非對每個檢查點、執行時、上下文長度或並發設定的最低保證。稀疏啟用降低計算量,但專家權重儲存與 KV 快取記憶體仍是主要考量。
一個 600B 模型除記憶體容量外,還帶來多 GPU 通訊、框架相容性、檢查點載入與長上下文吞吐量等挑戰。對於沒有大型 GPU 叢集的團隊而言,託管 API 通常是更務實的起點。
How Can Developers Use the Step 5 Preview API?
StepFun 支援相容 OpenAI 的 Chat Completions 介面。在執行下方 Python 範例前,請於環境中設定 STEPFUN_API_KEY;max_tokens 界定此請求的生成輸出長度。請使用所選區域平台的 API 金鑰與計費條款:此範例保留 api.stepfun.ai 端點,而上述美元價格來自 StepFun 的國際平台。
Python 範例:向 StepFun API 發送一個具輸出上限的文字請求,並列印回傳答案。
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
在進入生產使用前,請確認所選 StepFun 端點接受的參數與生成上限。推理強度、提示快取、工具結構與輸出預算都會影響可靠性、延遲與最終帳單。
Step 5 Preview in Agent Workflows
- 讀取存放庫文件與相關檔案。
- 辨識所需變更並提出計畫。
- 透過外部工具修改選定程式碼並執行測試。
- 檢視失敗並修訂實作。
- 產出已驗證變更的最終說明。
模型負責生成推理與工具請求;應用負責提供實際檔案存取、執行環境、權限與安全檢查。僅有模型能力並不保證自動執行。
CometAPI 透過共用整合服務提供上述替代模型的存取。請選擇各模型文件化的端點與請求格式,並在相同工作負載上比較成功率、token 使用、重試次數與端對端延遲。
上述範例使用 StepFun 的原生端點。切換至閘道需要確認 Step 5 Preview 的可用性,以及該閘道文件化的模型識別符、端點與計費條款。
When Should You Choose Step 5 Preview?
- 當代表性測試確認結果可靠時,選擇用於存放庫程式設計與文件密集研究。其長上下文與已公布的程式設計與金融分數使其成為候選;同時,終端任務與估值結果顯示為何要進行工作負載特定的測試。
- 當你想在不操作大型 GPU 叢集的情況下開始使用時,選擇託管 API。比較每次接受任務的成本、快取命中率、重試次數與延遲;較大的上下文視窗不保證更快的回應或更低的總成本。
- 當部署控制足以證明硬體與營運負擔合理時,選擇自我託管。為完整專家權重儲存、KV 快取、多 GPU 通訊與授權要求預算。對重大金融或工程工作,請納入來源檢查、錯誤偵測與人工審核。
FAQ
如何選擇 Step 5 Preview 的推理強度?
請以一小組具代表性的任務,比較 low、medium、high,並使用相同的驗收標準。記錄正確性、可計費輸出、延遲與工具故障。使用能穩定達到品質門檻的最低設定;已公布的 High 基準分數不代表 low 或 medium 的行為。請遵循推理設定指南,並在 Chat Completions 上明確設定 reasoning_effort 以進行比較。
為何 Step 5 Preview 的請求會在 64k 輸出 tokens 前停止?
所記載的上限是天花板,而非目標長度。請求可能因達到自身的 max_tokens 預算、自然停止,或產生需要應用處理的工具呼叫而更早結束。在自動重試前,請檢視回傳的完成原因與任何工具請求。已完成的較短答案並不表示上下文視窗故障。
如何測試 Step 5 Preview 的影片輸入?
請以短且具代表性的片段開始,並提出可驗證答案的問題。託管 API 的影片輸入規格接受透過 URL、Base64 或 stepfile 參考提供影片;其記載格式包含 MP4、QuickTime 與 Matroska。對於 URL 輸入,文件規定單一 MP4 檔案需小於 128 MB,且建議少於五分鐘。請在批次前確認格式與大小限制,並同時測試時間性問題與單影格識別。
哪些指標能揭示 Step 5 Preview 的真實代理成本?
請量測被接受的任務完成數、所有輪次的總輸入與輸出 tokens、快取命中、重試、外部工具費用與經過時間。以成功完成數除以總執行成本,並在各模型間保持固定的成功標準。這可捕捉較便宜的呼叫需要更多嘗試,或較高強度的運行降低後續失敗的經濟影響。
Conclusion
當應用需要長上下文處理、重複使用工具,或需要掌控模型部署時,值得評估 Step 5 Preview。StepFun 已公布的結果使其成為存放庫程式設計與金融研究的候選,而 Terminal-Bench v4 與 CorporateValuation 顯示列出的替代方案在某些領域得分更高。請使用固定的驗收標準、每次接受任務的總成本與端對端延遲來比較模型。對於自我託管,決策中請納入基礎設施成本與授權要求。
| Official FP8, BF16, and NVFP4 repositories available |
| Local deployment | vLLM, SGLang, Transformers |
| Model license | StepFun Model License 1.0 |