TL;DR
MiMo-V2.6 是 Xiaomi 全新開放權重、原生多模態、面向智能體推理的模型家族。MiMo-V2.6-Pro 採用稀疏 MoE 設計,總參數 1.02 trillion、每個 token 約有 42 billion 參數被啟用;MiMo-V2.6-Flash 總參數 309 billion、每個 token 約 15 billion 啟用。兩者均支援 1M-token 的上下文視窗,並支援文字、圖像、影片與音訊等多模態輸入。
Key Takeaways
- MiMo-V2.6-Pro 是 1.02T 參數的稀疏 MoE 模型,每個 token 約啟用 42B 參數;Flash 總參數 309B、每個 token 約啟用 15B。
- 兩款模型皆透過 Xiaomi 的 API 支援 1M-token 上下文、多模態輸入,以及最多 128K 的輸出 tokens。
- 該系列面向推理、工具使用、網頁搜尋、結構化輸出與長時程智能體工作流程。
- Xiaomi 以混合式強化學習在程式設計、通用智能體、視覺任務與資安環境中訓練 V2.6。
- 官方結果定位 Pro 為更高能力選項、Flash 為更低成本且適合高吞吐量的選項;仍需針對特定工作負載進行評估。
What Is Xiaomi MiMo-V2.6?
MiMo-V2.6 是 Xiaomi MiMo 模型家族的最新一代。它的重點不僅是產生更好的答案,更在於執行長序列行動:檢視環境、呼叫工具、觀察結果、修正錯誤,並持續直到完成目標。Xiaomi 將此次發佈框定為Recursive Self-Improvement (RSI),即在強化學習迴圈中,模型反覆探索環境、接收更豐富的回饋訊號、比較軌跡,並學得更有效的策略。這不應被解讀為模型會自主重寫並訓練其下一代版本。
Pro vs Flash vs UltraSpeed: What is the differnence
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positioning | Flagship reasoning | High-volume / value | Low-latency flagship |
| Total parameters | 1.02T | 309B | Same Pro model |
| Active parameters | 42B | 15B | Same Pro capability |
| Architecture | Sparse MoE | Sparse MoE | Pro serving mode |
| Context | 1M | 1M | 1M |
| Max output | 128K | 128K | 128K |
| Text / image / video / audio input | Yes | Yes | Yes |
| Deep reasoning / tool calling | Yes | Yes | Yes |
| Structured output / context caching | Yes | Yes | Yes |
| Main advantage | Maximum capability | Cost efficiency | Up to 20x faster serving |
MiMo-V2.6-Pro or Flash: Which One Should You Use?
實務建議:對於困難的長時程工程、研究、資安與高價值智能體工作,選擇 MiMo-V2.6-Pro;對於高吞吐自動化、文件與多模態處理,以及對成本敏感的重複呼叫,選擇 MiMo-V2.6-Flash;當需要 Pro 等級推理但延遲至關重要時,選擇 MiMo-V2.6-Pro-UltraSpeed。UltraSpeed 是一個服務等級,而非不同能力的模型,官方宣稱其輸出速度可達標準 Pro 的 20×。
How Does Xiaomi MiMo-V2.6 Work?
Sparse Mixture-of-Experts architecture
MiMo-V2.6 不會在每個 token 啟用其全部參數。旗艦 Pro 檢查點擁有1.02 trillion 總參數,但每個 token 僅約有 42 billion 為啟用狀態。Xiaomi 的模型卡描述了 70 個 Transformer 層、384 位可路由專家,且同時啟用 8 位專家。Flash 明顯更小,總參數 309B / 啟用 15B,含 48 個 Transformer 層與 256 位可路由專家。
| Architecture specification | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Total parameters | 1.02T | 309B |
| Activated parameters | 42B | 15B |
| Transformer layers | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Routed experts | 384 | 256 |
| Experts activated | 8 | 8 |
| Maximum context | 1M | 1M |
| MiMo ViT | 681M params | 681M params |
| AudioTokenizer | 308M params | 308M params |
| Audio patch encoder | 127M params | 127M params |
| Speculative decoder | 5 layers | 5 layers |
該架構結合了滑動視窗注意力與全域注意力層,並包含一個五層的多 Token 預測推測式解碼器。實務上的含意是:標稱的參數總量與每 token 的計算量是兩個非常不同的概念;稀疏路由讓 Xiaomi 得以維持大型專家池,而無需對每個 token 進行跨所有權重的稠密推論。
Native multimodal understanding
MiMo-V2.6 使用 Xiaomi 的 681M 參數 MiMo ViT 進行視覺編碼,並配合專用的音訊元件。這讓同一個智能體能處理文字指令、螢幕截圖、照片、影片與音訊。對於電腦操作類智能體,原生多模態十分關鍵,因為感知與決策可在同一推理迴圈內完成,而非拆分到互不相連的使用者向模型中。
Why Is Reinforcement Learning So Important to MiMo-V2.6?
Xiaomi 回報,Flash 與 Pro 都在一次為期六天的公開訓練實驗中經歷約30 個 RL 步驟與約 750,000 條軌跡。報告的訓練成本約為 Flash 的 $850,000 與 Pro 的 $2.62 million。每次更新使用 1,568 個訓練樣本,單次訓練步驟約達 3.5–3.7 billion tokens。任務組合涵蓋程式碼、通用智能體、視覺任務、資安與多種智能體測試架構。
在此 RL 過程中,Xiaomi 指出超出樣本的 DeepSWE v1.1 分數從 Flash 的 48.8 升至 65.7,從 Pro 的 58.4 升至 72.6。這些數據描述的是即時 RL 實驗,不應與發佈檢查點的所有最終基準分數混為一談,因為評估設定可能不同。
Groupwise agentic grading
對智能體訓練而言,二元的通過/失敗回饋可能掩蓋兩條成功軌跡之間的差異。一種解法可能以少量工具呼叫快速完成,另一種則可能浪費數十步。Xiaomi 因此提出Groupwise Reward Synthesis 與 Groupwise Advantage Redistribution,作為在組內比較軌跡並將學習訊號重新分配到更乾淨解法的機制。目標是在提升任務完成率的同時,也提升路徑效率。
How Good Is Xiaomi MiMo-V2.6 on Agent Benchmarks?
V2.6 的最強公共證據集中在智能體基準,而非傳統的選擇題測驗。Xiaomi 的官方圖表將 Pro 與 Flash 與 MiMo-V2.5-Pro、Claude Opus 5、GPT-5.6 Sol 與 Fable 5 在程式設計、通用智能體、資安與視覺智能體任務上進行比較。
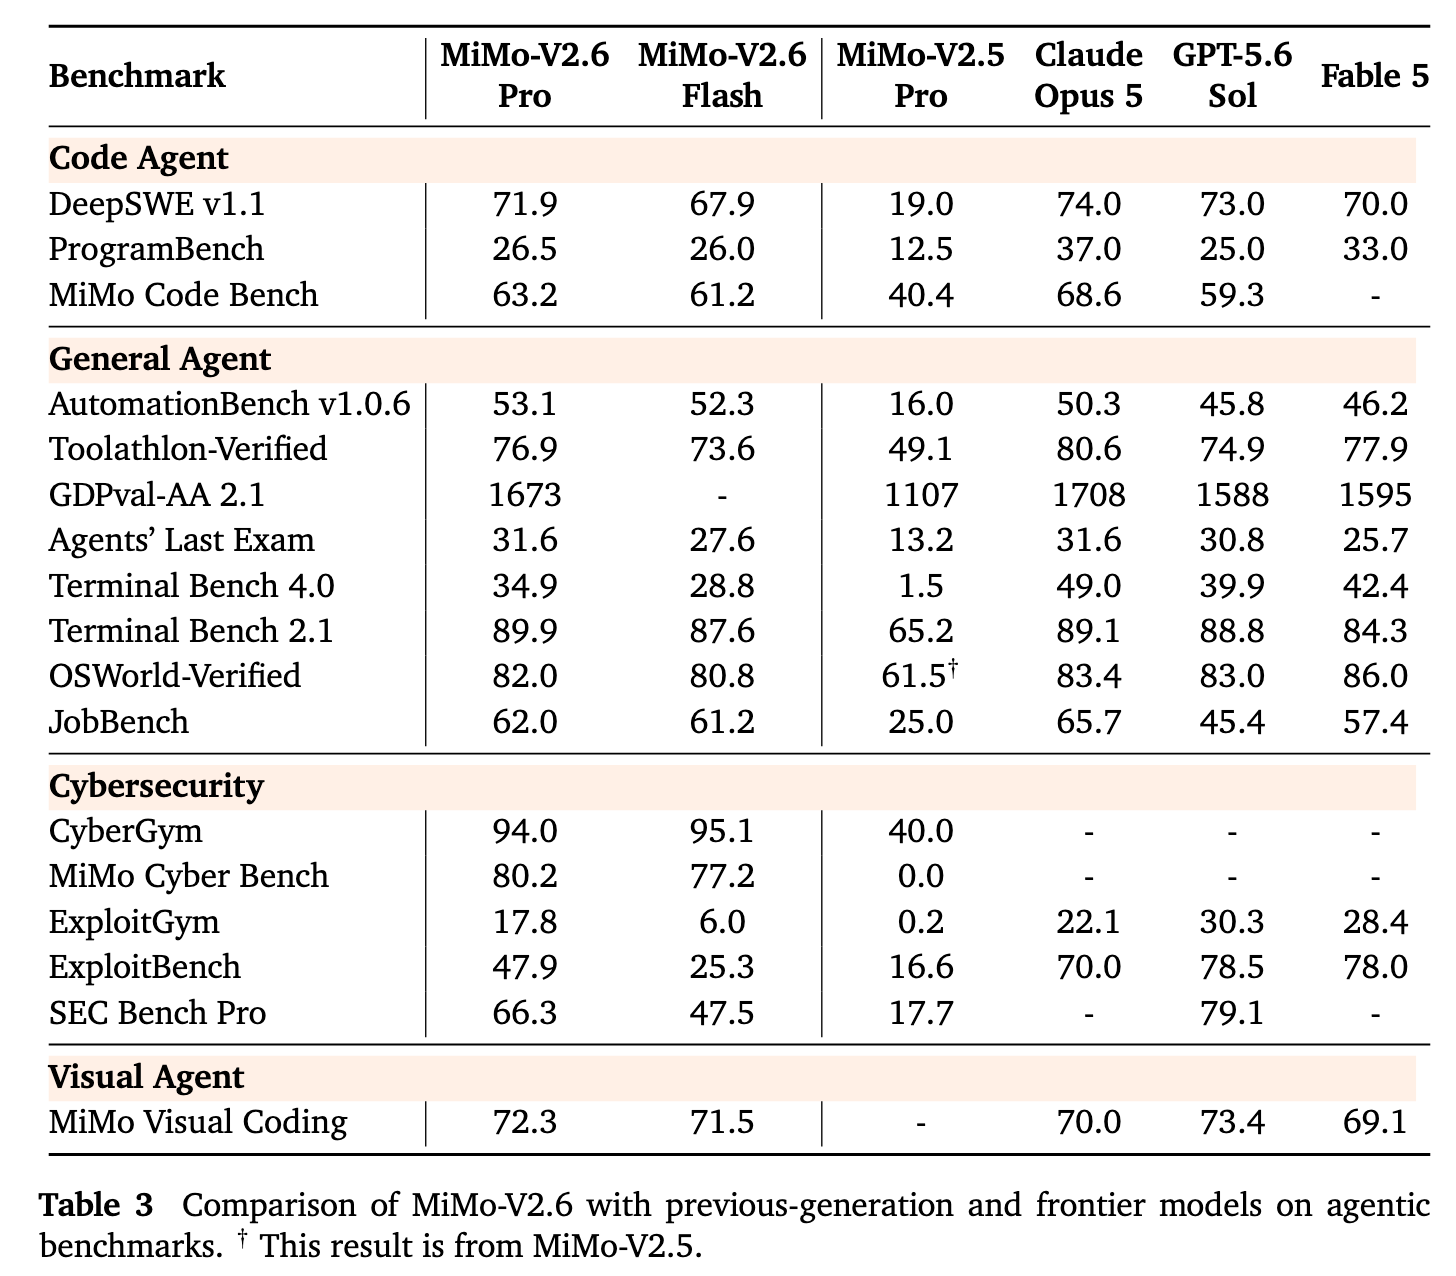
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Coding Progress
在長時程執行上,程式設計的進步最為明顯。在即時 RL 運行中,Xiaomi 報告超出樣本的 DeepSWE v1.1,Flash 從 48.8 提升至 65.7,Pro 從 58.4 提升至 72.6。於發佈的跨模型表中,Pro 在 DeepSWE v1.1 達到 71.9,在 MiMo Code Bench 達到 63.2;Flash 分別為 67.9 與 61.2。Pro 並未贏得所有程式測試——Claude Opus 5 在 DeepSWE、ProgramBench 與 MiMo Code Bench 上仍居前——但 V2.6 在開放權重與顯著較低 API 價格下,結合了具競爭力的倉庫級表現。
Reasoning and Agentic Progress
推理進展更適合被理解為在規劃、工具使用與恢復上的提升,而非單一抽象的智力分數。Pro 在 Terminal Bench 2.1 取得 89.9、在 AutomationBench 取得 53.1、在 Toolathlon-Verified 取得 76.9;Flash 分別為 87.6、52.3 與 73.6。Pro 在 Terminal Bench 2.1 上略高於所列的 Claude Opus 5 與 GPT-5.6 Sol,且兩個 V2.6 模型在 AutomationBench 上領先這些比較對象。Xiaomi 將此歸因於分組軌跡比較、更豐富的評分器、多測試架構訓練,以及偏好更短、更乾淨解法路徑的回饋訊號。
Knowledge and Research Progress
知識密集型的進展更多由智能體評測與示範支撐,而非傳統的知識考試套件。Pro 在 Agents' Last Exam 上與 Claude Opus 5 持平(31.6),並在 JobBench 達到 62.0。Xiaomi 亦回報材料研究工作流程,包括文獻與專利檢索、假說生成與計算篩選,以及一個超過 6,000 行的 Lean 4 形式化專案。這些示例暗示更強的檢索、綜整、形式化推理與基於工具的知識工作,但不應被視為對普遍知識優勢的獨立證明。
整體而言:V2.6 的進步廣泛但不均衡。其最強之處在於長時程程式設計與智能體執行的提升,而對一般推理與知識的主張應綁定於具體的基準、測試架構與示範。
Benchmark 註:除非另有說明,下列跨模型結果由 Xiaomi 在 MiMo-V2.6 模型卡中報告。分數可能依賴基準版本、智能體測試架構、工具配置、推論預算與評估流程,因此不應被解讀為經獨立重現的排名。
MiMo-V2.6 vs MiMo-V2.5: What Changed?
| Dimension | MiMo-V2.5 generation | MiMo-V2.6 breakthrough |
|---|---|---|
| Training focus | Strong multimodal agents, long context, and token efficiency | Much larger mixed RL program across code, general agents, vision, cybersecurity, and multiple harnesses |
| Agent capability | V2.5-Pro targeted difficult long-horizon work | Xiaomi reports that V2.6-Flash comprehensively outperforms V2.5-Pro on its agent benchmark suite |
| Learning efficiency | Previous production checkpoint | About 750,000 trajectories over 30 RL steps; held-out DeepSWE gains of roughly 17 points for Flash and 14 points for Pro during training |
| Openness | Open weights and ecosystem support | Adds full RL code, 7,000+ task environments, training framework, lightweight harnesses, and a 9B distillation checkpoint |
| Economics | Existing V2.5 API price level | Higher reported intelligence at the same official API prices, moving the capability-cost frontier outward |
Coding and agent execution
相較於 V2.5,最明顯的變化是一個更強的智能體策略,而非更長的上下文視窗。Xiaomi 指出 V2.6-Flash 在其智能體基準套件上優於 V2.5-Pro。在 V2.6 的訓練過程中,超出樣本的 DeepSWE v1.1 從 Flash 的 48.8 提升至 65.7、從 Pro 的 58.4 提升至 72.6;這些訓練過程分數無法與上方發佈模型的基準表直接互換。
Reasoning, knowledge, and training breadth
V2.6 將強化學習擴展到程式設計、通用智能體、視覺、資安與多種測試架構。Xiaomi 報告約 750,000 條軌跡、約 30 個 RL 步驟。這支撐了更廣泛的規劃、工具使用與恢復能力,但本身並不足以證明在每一個知識或推理基準上的普遍提升;應比較相符的任務與評估設定。
Migration and openness
此次發佈亦新增 RL 程式碼、超過 7,000 個任務環境、訓練基礎架構,與一個 9B 蒸餾檢查點。1M-token 上下文與多模態輸入延續自 V2.5,並非 V2.6 的新突破。
因此,實務上的改變不是新的上下文邊界——1M 上下文與完整多模態在 V2.5 已存在——而是透過顯著更多的強化學習運算與更廣的可驗證環境,訓練出更強的智能體策略。Xiaomi 已宣布 V2.5 與 V2.5-Pro 模型名稱將於 2026 年 10 月 21 日停止運作,因此新部署應鎖定 V2.6,既有部署應規劃遷移測試。
How V2.6 compares with other frontier models
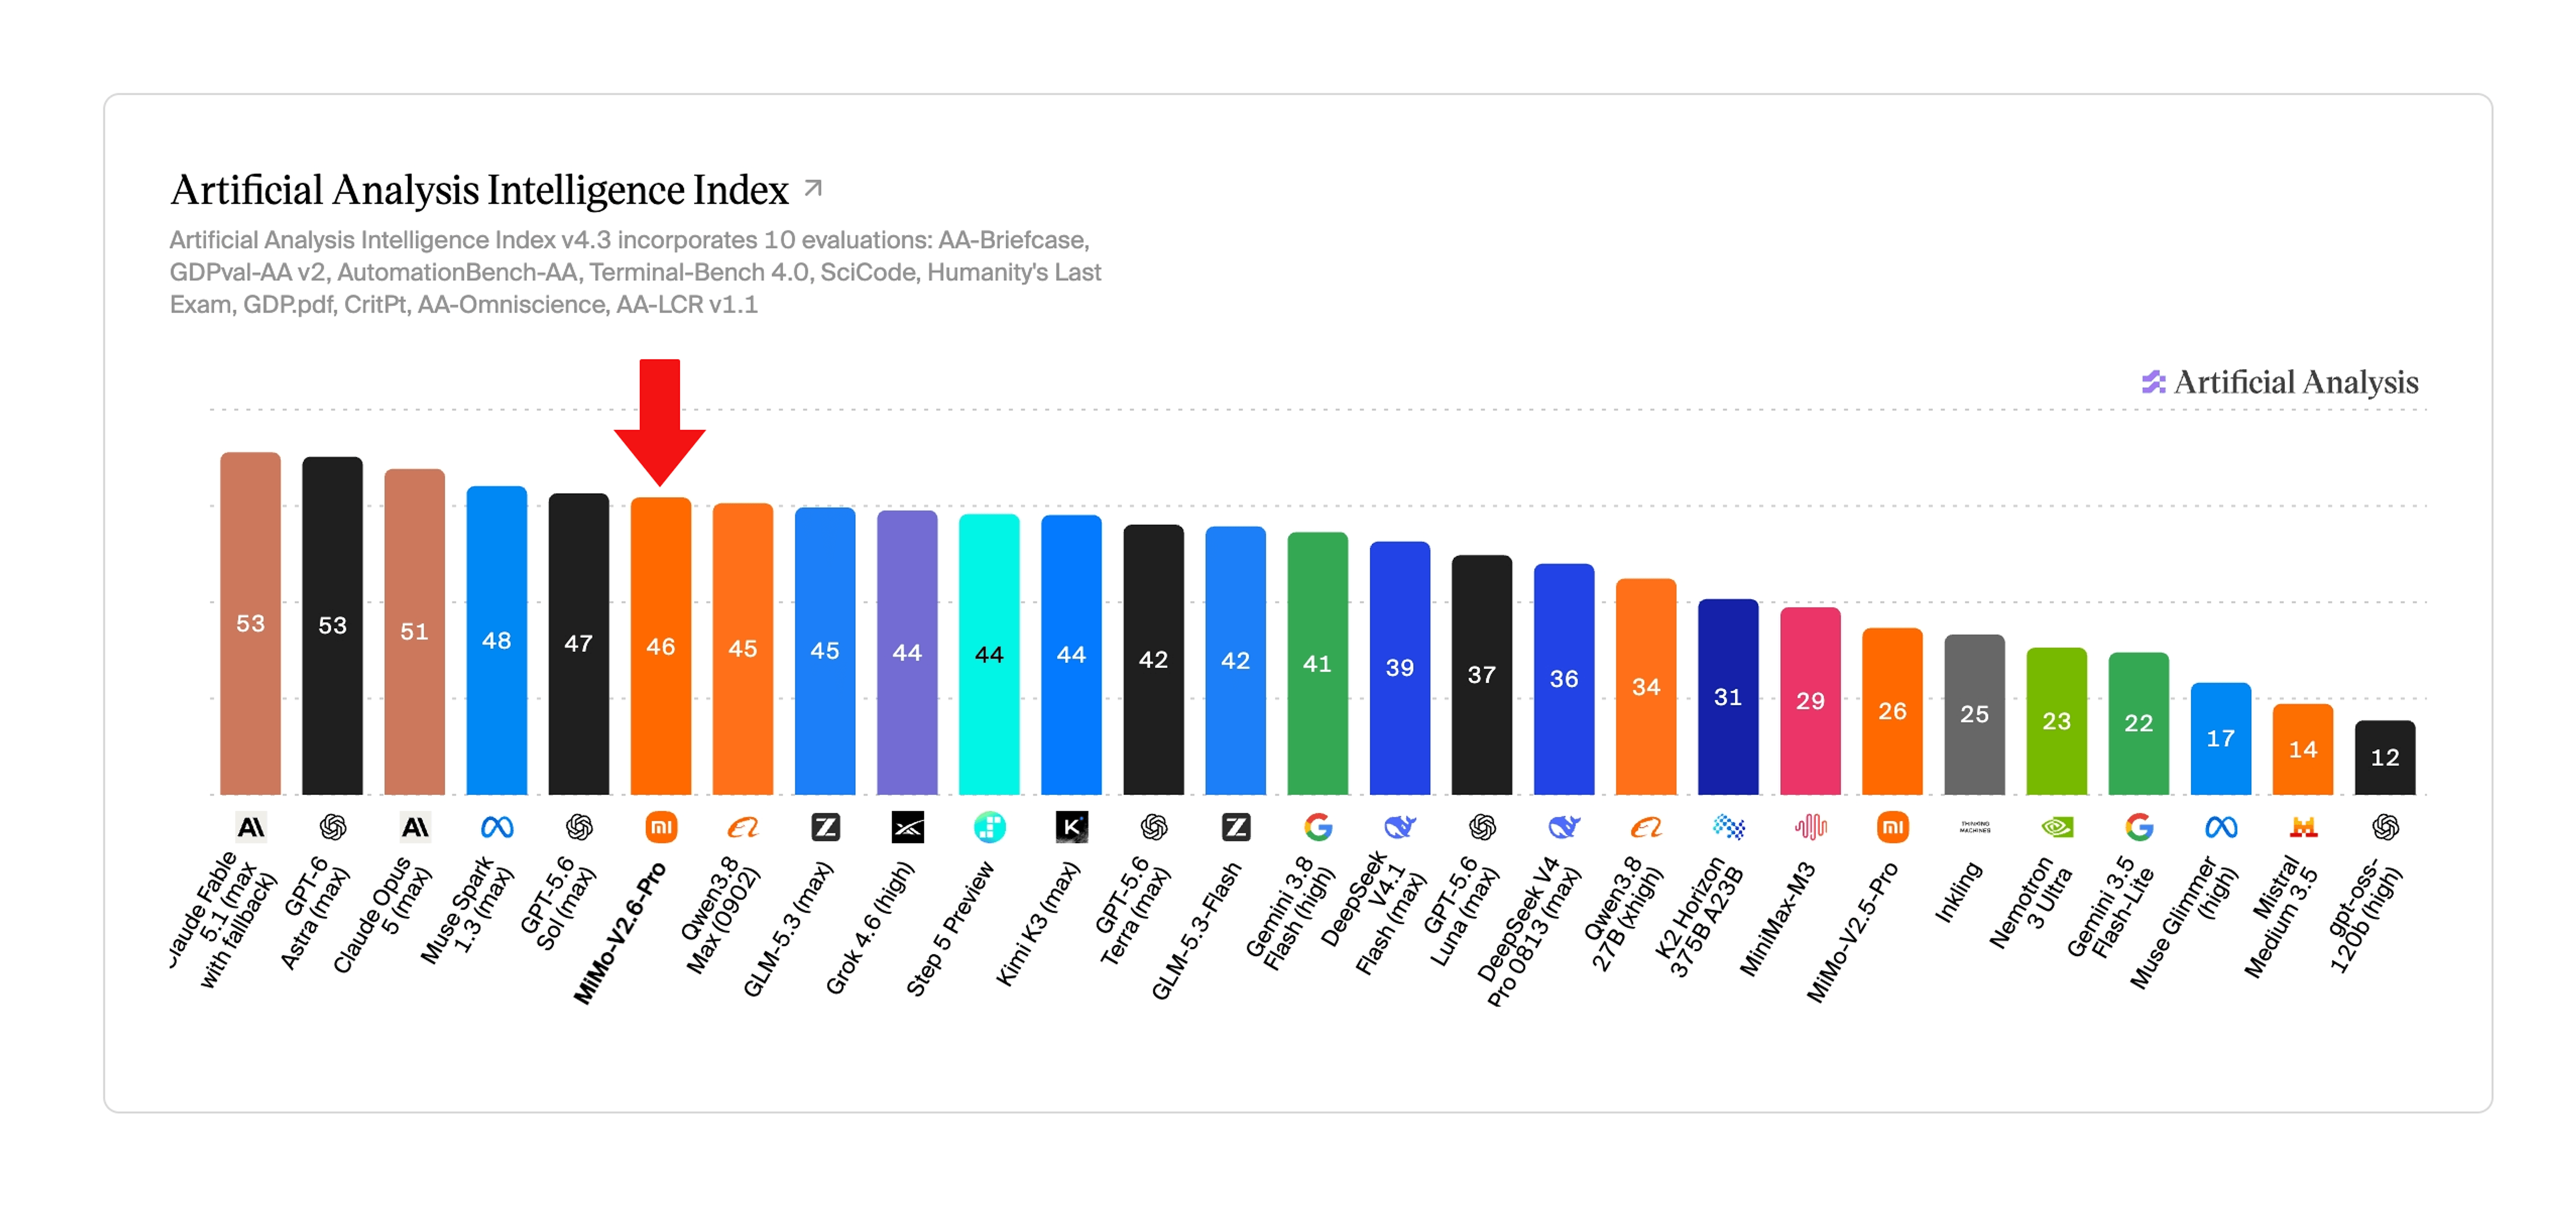
| Dimension | MiMo-V2.6-Pro | Closed frontier models | Other open-weight models |
|---|---|---|---|
| Weights | Open weights | Typically closed | Model-dependent |
| Verified MiMo context | 1M tokens | Check each official model page | Check each official model card |
| Verified MiMo modalities | Text, image, video, audio | Provider-dependent | Model-dependent |
| Agent-focused RL | Strong release emphasis | Model and system dependent | Model and checkpoint dependent |
| Self-hosting | Yes, with substantial infrastructure | Generally no | Often possible for open checkpoints |
| Primary MiMo advantage | Open weights, native multimodality, low API cost | Provider ecosystem and managed tooling | Varies by license, size, and deployment stack |
若需當前比較集,請將 MiMo-V2.6 與Claude Opus 5.5(長時間執行的智能體程式設計)、Claude Fable 5.1(最困難的自主工作)、GPT-6 Sol、Gemini 4 Pro進行評估。模型可用性與價格是動態的,因此生產比較應使用即時目錄、相符的提示、工具、資源預算與驗收標準。
What Can Xiaomi MiMo-V2.6 Actually Do?
Coding and software-engineering agents
MiMo-V2.6 針對長時程軟體工程路徑設計:檢視代碼庫、修改程式碼、使用終端工具、執行測試、診斷失敗,並持續直至滿足目標。其在 DeepSWE、Terminal Bench、AutomationBench 與 Toolathlon 的表現顯示,Xiaomi 的優化重點在執行力而非僅限於程式補全。實務工作負載包括程式設計智能體、自動除錯、倉庫重構、CI 問題處理與多工具工程工作流程。
Computer use
Xiaomi 明確展示了 Computer Use Agent (CUA)。該模型能理解圖形介面、檢索資訊、編輯內容、處理資料、檢視結果、診斷問題,並根據視覺回饋改變後續動作。在此工作流程中,模型輸出往往不是最終產品;它可能決定下一步的軟體或瀏覽器動作。
3D worlds and Blender workflows
在「Vibe World」概念下,MiMo-V2.6 能以文字、圖像或影片參考,將 3D 請求拆解為場景建構、互動程式設計與視覺驗證任務。Xiaomi 亦展示模型控制 Blender,根據描述或參考圖像建立 3D 物件與場景。這使得 vibe coding 擴展至互動環境,而不僅是應用程式碼。
Robotics and embodied agents
Xiaomi 在具身模擬環境中展示 MiMo-V2.6,使用多視角相機影像與 Franka Panda 機械臂。範例任務包括抓取、顏色匹配與精確放置。這並不構成 V2.6 作為通用機器人基礎模型的證據,但展示了原生視覺與長時程決策如何連接到具身控制迴圈。
Scientific research and formal reasoning
Xiaomi 回報一個材料科學案例,MiMo-V2.6-Pro 協助研究人員處理金屬有機框架的 PFAS 吸附問題,包括文獻與專利檢索、候選體配方與計算工具呼叫。另一實驗中,模型協助將「Period Three Implies Chaos」的主要定理以 Lean 4 形式化。Xiaomi 回報一個超過 6,000 行的已完成專案,並由 Lean 核心驗證、無未證明佔位符。這些示例最好被解讀為智能體式研究工作流程的展示,而非自主科學發現的證明。
Websites, presentations, video, and music
MiMo-V2.6 能協調前端程式設計、設計流程、簡報、SVG 素材、影片管線與音樂製作工具。Xiaomi 展示了與專門媒體系統的協作(包括透過 MiMo-V2.5-TTS 進行旁白),而非宣稱 V2.6 自身取代所有圖像、影片或音訊生成器。因此,該模型很自然地扮演創意生產的協作編排者。
本節的使用案例為 Xiaomi 示範,並非獨立證據保證每個部署都能重現相同結果。生產團隊應以自身工具、權限、失敗恢復與評估標準測試該模型。
How Much Does Xiaomi MiMo-V2.6 Cost?
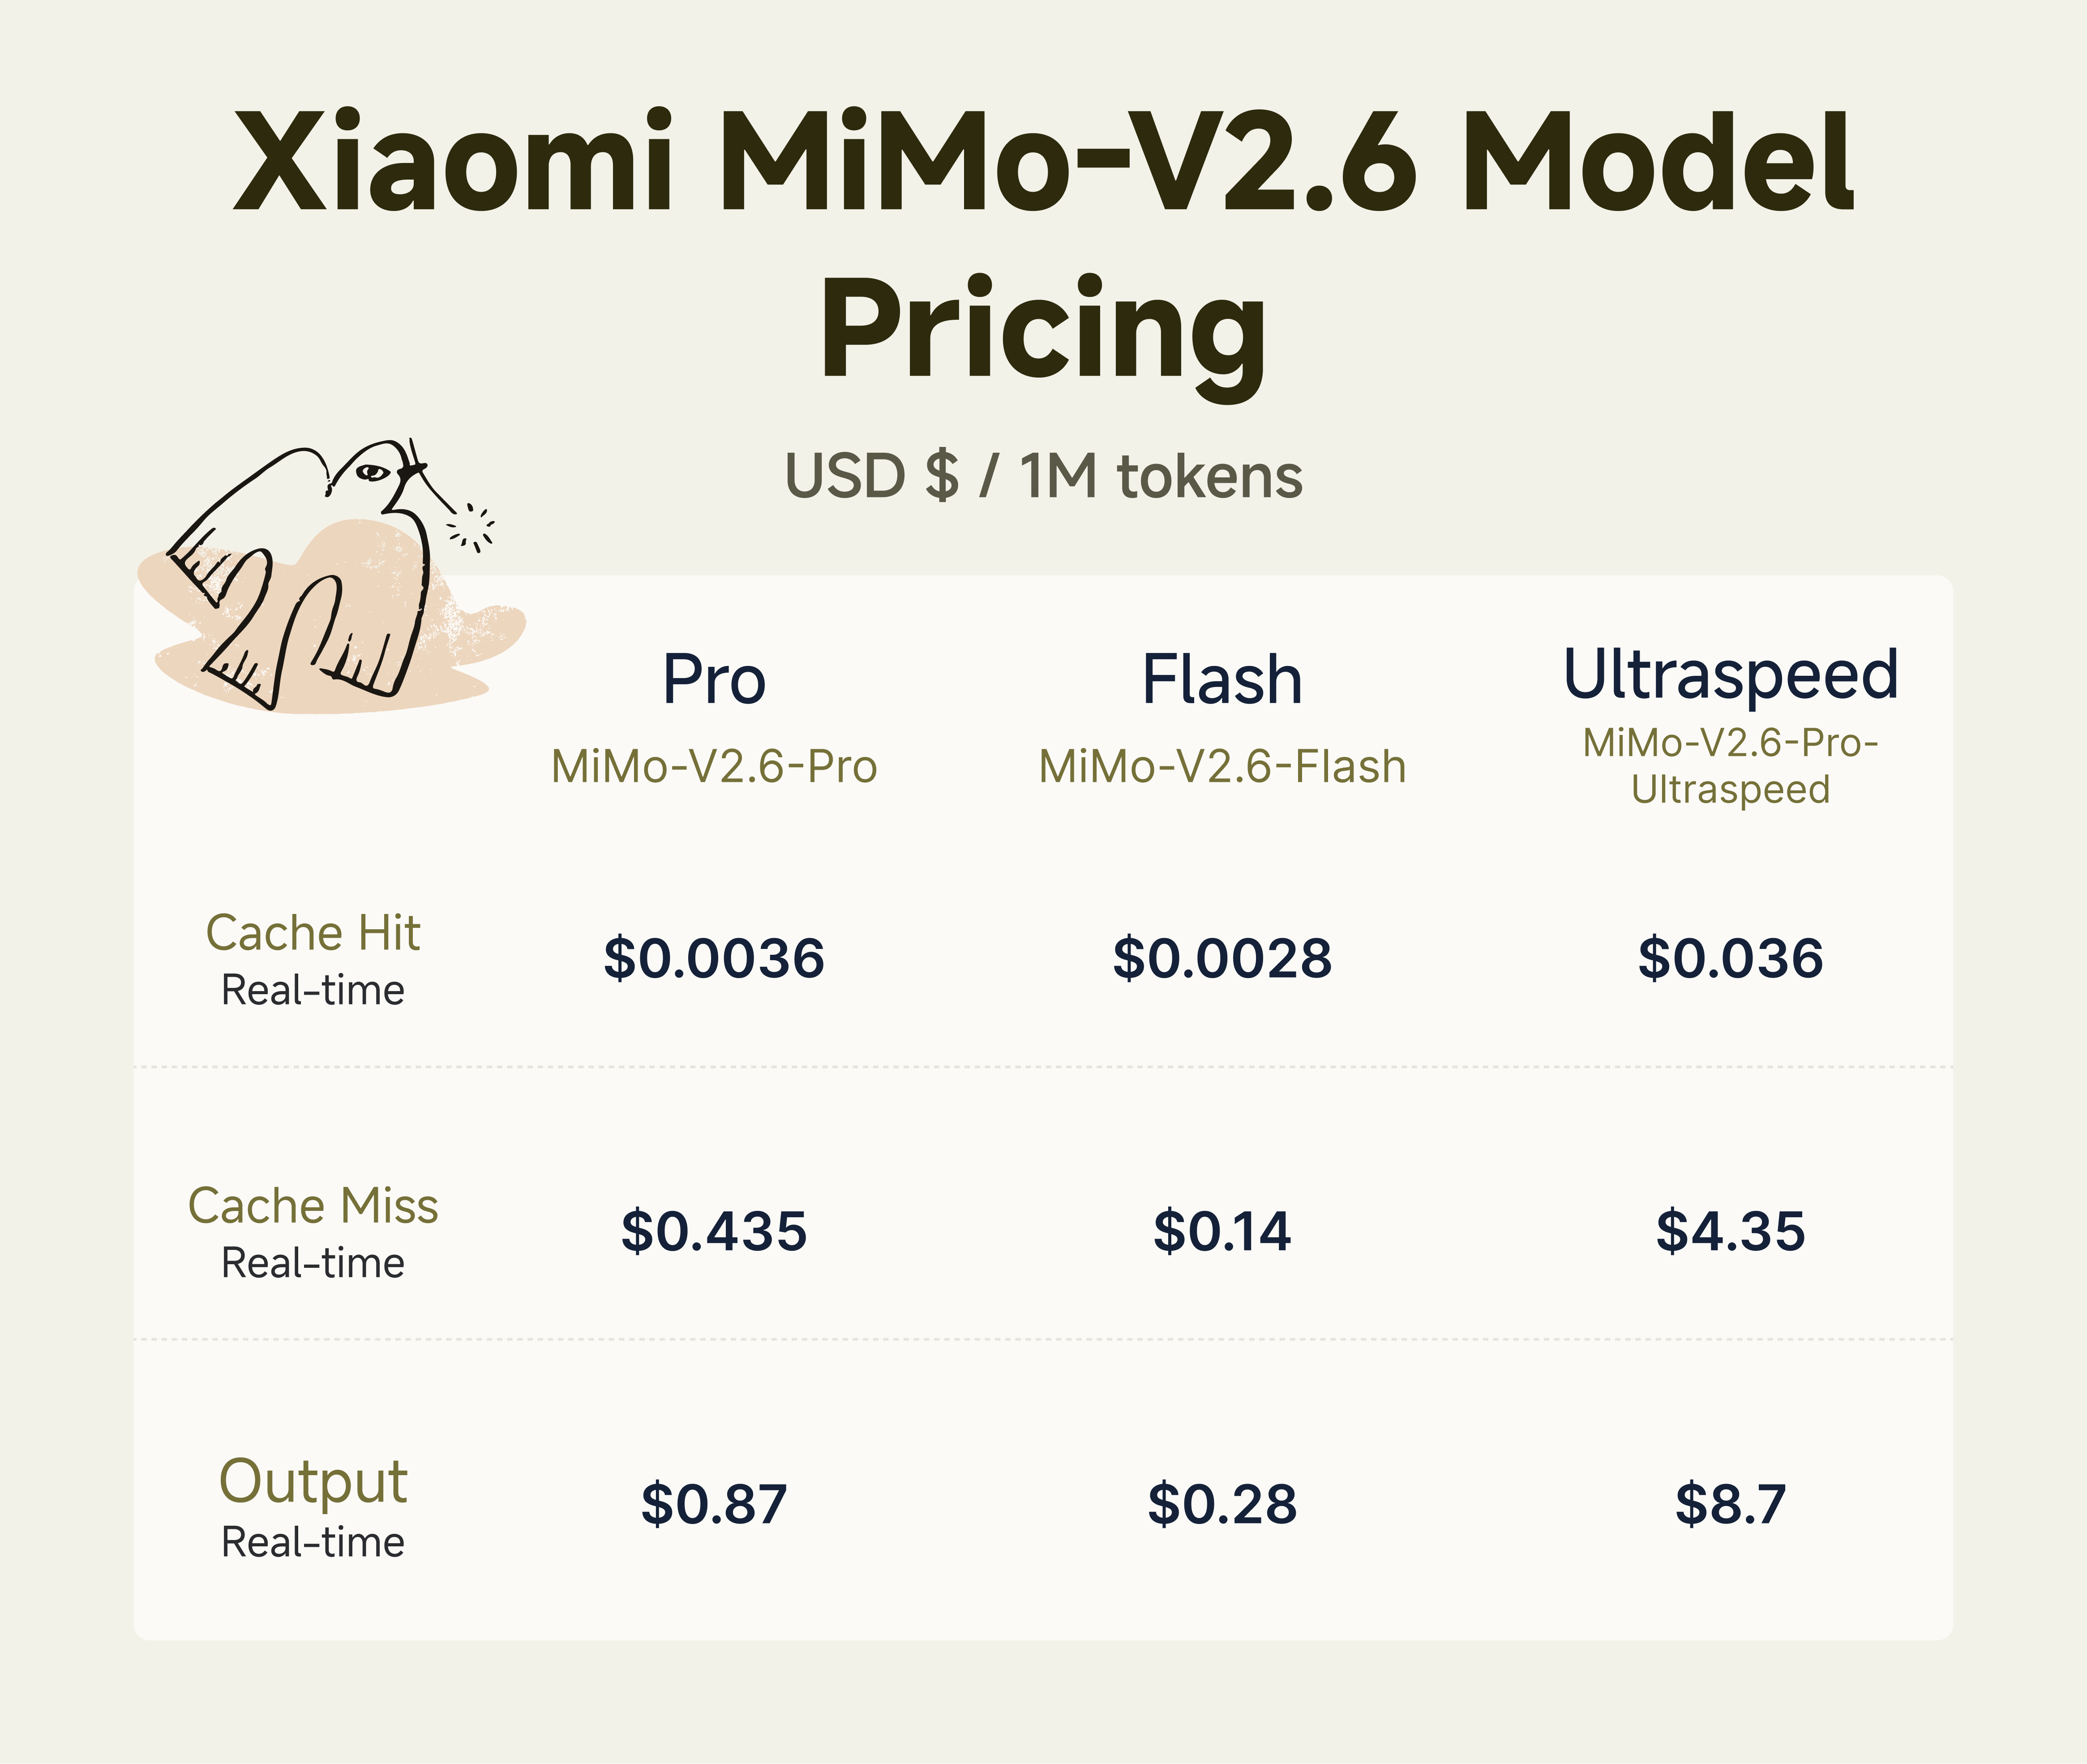
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Cached input / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Uncached input / 1M tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M tokens | $0.87 | $0.28 | $8.70 |
Xiaomi 將 V2.6 API 價格維持在與 V2.5 相同的大致水準。Flash 對高吞吐工作負載尤其顯著:Xiaomi 官方價格顯示未快取輸入每百萬 tokens 為 $0.14、輸出每百萬 tokens 為 $0.28。
CometAPI Pricing and Availability
| CometAPI route | Input / 1M | Output / 1M | Catalog status |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Available; 20% below the listed official uncached rates |
| mimo-v2.6-pro | $0.348 | $0.6960 | Available; 20% below the listed official uncached rates |
| mimo-v2.6-flash | $0.112 | $0.2240 | Available; 20% below the listed official uncached rates |
How Can Developers Access Xiaomi MiMo-V2.6?
Xiaomi 透過與 OpenAI 相容的 API 對外提供模型,並在官方模型頁面上記載與 Anthropic 協定的相容性。官方識別符為:mimo-v2.6-pro、mimo-v2.6-flash 與 mimo-v2.6-pro-ultraspeed。Xiaomi 文件涵蓋工具呼叫、結構化輸出、串流、推理控制、上下文快取與網頁搜尋。OpenAI 相容介面使用 thinking.type 值(如 enabled 或 disabled),V2.6 模型預設啟用深度思考。
開發者有三種實務存取途徑。第一,下載 Pro 或 Flash 的開放權重檢查點自建服務,但需相當可觀的服務資源。第二,使用 Xiaomi 的託管 API,搭配 Xiaomi 金鑰與其文件化端點。第三,使用支援的 CometAPI 路由,搭配 CometAPI 金鑰與基底 URL;這有助於簡化多模型評估與計費。像 Claude Code 等程式助理可以在該路由與模型受支援時使用與 Anthropic 相容的路由,但需實測相容性,不能想當然耳。
Accessing MiMo-V2.6 through CometAPI
CometAPI 提供統一端點與計費層。主要營運優勢是遷移簡化:團隊可保留熟悉的 SDK,只需更改基底 URL 與 model ID,便能在同一帳戶中比較 MiMo 與其他前沿模型,並集中化使用情況、定價與可用性檢查。這對多模型路由、後備策略、整合帳單與需要在不同供應商間維持相同提示的評測特別實用。
CometAPI 在平台層級文件化三種文字請求格式:OpenAI Chat Completions、Anthropic Messages 與 OpenAI Responses。對於相容 SDK,遷移通常意味著更換基底 URL、API 金鑰與 model ID,而非重寫整個應用。端點與參數支援可能因模型而異,請在宣稱三種路由皆可用之前,先測試確切的 MiMo-V2.6 變體與請求格式。
截至 2026 年 9 月 23 日,MiMo-V2.6-Pro-UltraSpeed 在目錄中有可用路由,並列出了輸入與輸出價格。專門的 Pro 與 Flash 頁面在其目錄截圖中顯示 Coming soon,但其 API 健康面板標示 Available。請將此視為頁面訊號不一致,而非已確認的生產可用性或定價。部署前請檢查即時目錄、儀表板與一次測試請求。
下例遵循 CometAPI 公佈的 Anthropic-SDK 範式,並呼叫目前列出的 UltraSpeed 路由。請將 API 金鑰儲存在環境變數中。
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Is Xiaomi MiMo-V2.6 Open Source?
Xiaomi 已釋出模型權重、技術材料、RL 資源、訓練環境與相關基礎設施。此次釋出包含超過 7,000 個 RL 任務環境,涵蓋軟體工程、漏洞重現、知識密集型工作與網頁設計/開發。Xiaomi 亦釋出 MiMo-V2.6-Distill-Qwen-9B,讓研究人員能在更小尺度上研究 RL 流程。
官方模型卡:MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
What Are the Limitations of Xiaomi MiMo-V2.6?
兆級參數不應被視為 V2.6 普遍強於封閉前沿系統的證據。Xiaomi 自身的基準表呈現混合圖景:Claude Opus 5 在部分程式設計、工具使用與 OS 基準上仍領先,而 GPT-5.6 Sol 也在若干測試中領先。因此,針對具體工作負載的評估比籠統的「冠軍」標籤更具意義。
自建完整 Pro 檢查點同樣是高基礎設施成本的任務。開放權重並不代表可在個人工作站輕鬆部署。此外,數個重點示範——研究、具身控制、3D 世界與影片製作——依賴外部工具與智能體測試架構。評估 MiMo-V2.6 時,應將其視為系統中的一個模型,而非單一的聊天模型。
Why Does Xiaomi MiMo-V2.6 Matter?
MiMo-V2.6 結合三個重要方向:超大型稀疏 MoE 模型、原生多模態,以及在真實智能體環境上的強化學習。1.02T 的參數數字固然吸睛,但更具影響的是 Xiaomi 對反覆環境互動、軌跡評分、工具使用與自我修正的投入。
若這一做法持續擴展,開放模型未來可能不僅以靜態知識量區隔,而更以其行動、評估、恢復與完成長任務的效能區隔。因而,MiMo-V2.6 最宜被理解為面向智能體的開放基礎模型,而不僅僅是另一個兆級參數的聊天機器人。
Conclusion
MiMo-V2.6 是一次重要的開放權重發佈,因其結合原生文字、圖像、影片與音訊輸入、長上下文、稀疏 MoE 推論,以及跨真實智能體環境的強化學習。Pro 更適合困難的長時程任務,Flash 面向高吞吐與成本敏感的工作負載,UltraSpeed 則以明顯更高的 API 價格換取更低延遲。
該系列在多項由供應商報告的智能體基準上具備競爭力,但並非在所有評估中領先,亦不應被視為封閉前沿模型的通用替代。最可靠的採用路徑,是將 MiMo-V2.6 置於預期的生產工作流程中,對照實際工具、延遲目標、故障模式與成本輪廓進行測試。
FAQ
What should teams test before moving MiMo-V2.6 into production?
請測試整個系統,而非僅模型本體。衡量任務完成率、工具呼叫準確度、失敗動作的恢復能力、延遲、token 消耗、上下文管理與權限邊界。智能體基準提供參考,但內部評估應貼合實際的代碼庫、瀏覽器、文件或研究工作流程。
Why can self-hosting MiMo-V2.6-Pro be difficult despite its sparse architecture?
稀疏啟用相對於稠密的兆級模型降低了每 token 的計算量,但完整檢查點仍具有非常龐大的記憶體與分散式服務足跡。生產部署可能需要多節點推論、專家並行、特殊核心與謹慎的容量規劃。
How should developers interpret Xiaomi's cross-model benchmark table?
將其視為供應商報告的證據,而非經獨立重現的通用排名。結果會隨智能體測試架構、推論預算、工具、環境映像、取樣方法與基準版本而變。請在多個任務間比對趨勢,並在內部重現最相關的工作負載。
When is MiMo-V2.6-Flash a better choice than Pro?
當呼叫量與成本占主導時,Flash 是更強的預設選擇,特別是在文件處理、多模態分析與重複的智能體步驟上。當困難推理或長時程執行帶來足夠商業價值,值得承擔較高價格時,Pro 更為合適。
Does a 1M-token context window eliminate the need for retrieval or prompt management?
不會。更大的視窗提升容量,但發送不必要的歷史將提高延遲與成本,並可能稀釋相關證據。檢索、摘要、結構化記憶與上下文修剪在可靠的生產智能體中仍然重要。