Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
免費開始 免費開始
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
2025 年最好的影像編輯 AI 是什麼? - CometAPI
technology / CometAPI 研究
2025 年最好的影像編輯 AI 是什麼? 影像編輯 AI 只需幾個月(而不是幾年)就能從有趣的玩具變成實際的工作流程工具。如果你需要移除背景、交換臉部、保留角色
影像編輯 AI 只需幾個月(而不是幾年)就能從有趣的玩具變成實際的工作流程工具。如果你需要移除背景、交換臉部、保留角色
先用這個摘要快速掌握答案,再閱讀指南取得背景、範例與實作細節。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)影像編輯 AI 只花了幾個月(而非幾年)的時間,就從趣味玩具變成了實際的工作流程工具。如果您需要移除背景、交換人臉、在多個鏡頭中保留角色,或者使用自然語言提示進行多步驟合成,一些新模型承諾可以更快地完成這些操作,並且減少手動修復。在這篇文章中,我將比較目前人們討論的三種工具: OpenAI 的 GPT-image-1 , Qwen-Image Edit,病毒式 奈米香蕉 模型(Gemini-2.5-Flash-Image),以及 Flux Kontext 。我將介紹每個人的優點和缺點,並根據您想要實現的目標給出切實可行的建議。
定義影像 AI 卓越的核心能力是什麼?
「最佳」取決於你的需求。我的評估基於七個實用標準。在深入分析各個模型之前,至關重要的是要了解定義影像生成和編輯 AI 卓越性的基本能力。這些基本能力大致可以分為:
生成品質和保真度: 這指的是人工智慧根據文字提示產生高度逼真、美觀且連貫的圖像的能力。影響因素包括細節、光線、構圖以及無偽影或失真。編輯的多功能性和精確度: 除了初始生成之外,優秀的人工智慧還應提供強大的編輯功能。這包括修復(填補缺失部分)、擴展圖像(擴展圖像)、物件移除/添加、風格遷移以及對特定元素的精確控制。
速度和效率: 對於專業的工作流程來說,生成或編輯圖像所需的時間至關重要。在不犧牲品質的情況下實現更快的處理速度是一大優勢。
用戶體驗和可訪問性: 直覺的介面、清晰的控制以及易於整合到現有工作流程對於廣泛採用和使用者滿意度至關重要。
道德考量與安全特點: 隨著人工智慧日益強大,負責任的開發和部署至關重要。這包括防止產生有害或有偏見的內容。
成本效益和定價模型: 雖然有些工具提供免費套餐,但了解高級功能和商業用途的定價結構對於注重預算的用戶來說至關重要。
一致的多步驟編輯 — 在多個編輯或影像中保留身分/物件。我傾向於實用:一個能產生稍微不那麼「令人驚嘆」的圖像但能讓你獲得可重複、快速、可靠的編輯的模型將勝過一個需要大量清理的華而不實的模型。
正在考慮的模型有哪些?它們有何不同?
快速模型快照
GPT-Image-1(OpenAI) — 2025 年 XNUMX 月向 API 發布的原生多模式模型,直接支援在同一個多模式回應/圖像 API 內進行迭代圖像生成和編輯。Gemini 2.5 Flash 鏡像(Google) — 於 26 年 2025 月 XNUMX 日發布(「奈米香蕉」);旨在實現快速、低延遲生成和豐富的編輯(多圖像融合、字元一致性);包括用於出處的 SynthID 浮水印。Qwen-Image-Edit (QwenLM / 阿里巴巴集團) — Qwen-Image(20B 基礎)的圖像編輯版本,強調雙語、精確的文字編輯以及組合語義 + 外觀編輯。FLUX.1 Kontext(Flux / Black Forest Labs / Flux 平台變體) — 模型系列(Dev / Pro / Max)專注於快速、本地、上下文感知的編輯,具有字元一致性和迭代工作流程。
為什麼是這四個? 它們涵蓋了從業者在 2025 年最關心的設計要點:多模態整合(OpenAI)、規模化+生產化+世界知識(Google)、精準編輯與開放研究(Qwen)以及使用者體驗優先的迭代編輯(Flux)。每種技術在成本、延遲以及各自的優勢領域(文字渲染、多影像融合、迭代編輯、保留不變區域)方面都有各自的權衡。
GPT-Image-1 (OpenAI) — 開發者的重擔 詳細資料: OpenAI 的 GPT-Image-1 是一個原生多模態模型,它同時接受文字和圖像輸入,並支援透過其圖像 API 進行圖像生成和編輯(修復、圖像到圖像)。它定位為跨應用和服務整合的生產級模型。它被設計為原生的“文字+圖像”模型,可以接受圖像輸入和文字提示,並進行精細控制的編輯。
GPT-image-1 的優勢是什麼?
卓越的語意理解: GPT-image-1 的主要優勢之一在於它能夠解讀細緻且複雜的文字提示。使用者可以非常準確地描述複雜的場景、特定的情緒和抽象的概念,而 AI 通常能夠產生忠實反映這些描述的圖像。高品質照片級真實感: 當被要求輸入逼真的影像時,GPT-image-1 經常能夠輸出栩栩如生的影像,其對紋理、光線和自然構圖的關注令人印象深刻。這使得它成為照片級逼真渲染和概念藝術的強大工具。創意解讀: 除了簡單的字面翻譯之外,GPT-image-1 還展現了一定程度的創意解讀,經常添加微妙的細節或風格修飾,從而增強生成圖像的整體藝術感染力。這對於構思和探索多樣化的視覺概念尤其有益。堅實的迭代基礎: 它能夠產生高品質的初始概念,為進一步完善提供了一個極好的起點,無論是在 AI 的編輯功能內(如果可用)還是透過傳統的圖形設計軟體。
GPT-image-1 有哪些限制?
控制精細細節: 雖然在處理廣泛概念方面表現出色,但實現絕對的像素級控製或對微小元素的精確操控有時仍頗具挑戰性。這是許多生成式人工智慧面臨的常見挑戰,因為這類人工智慧的輸出在一定程度上取決於提示。可用性和整合: 根據具體實現,GPT-image-1 的直接編輯功能可能不如專用影像編輯平台那麼強大或整合。使用者可能需要匯出並使用其他工具進行密集的後期編輯。計算需求: 使用複雜提示產生高度詳細的影像可能需要大量計算,與更專業、更輕的快速編輯模型相比,這可能會導致更長的處理時間。
奈米香蕉(Google / Gemini 2.5 Flash 圖片) 詳細資料: 「Nano Banana」 是Google最近推出的 Gemini 影像升級版(Gemini 2.5 Flash Image)的俏皮名稱。它被定位為Google Gemini 生態系統中的下一代影像生成器/編輯器,主打更強大、更細緻的多步驟編輯功能,以及照片編輯的卓越一致性。
Gemini-2.5-Flash-Image 在視覺 AI 領域有何亮點? Gemini-2.5-Flash-Image 是Google的新一代產品,專為速度和效率而設計,旨在平衡高品質輸出和快速處理。其「Flash」名稱特別指出了其最佳化的架構,以實現更快的響應速度,使其非常適合即時或近實時生成和編輯至關重要的應用。
是什麼讓 Gemini-2.5-Flash-Image 成為強而有力的競爭者?
極速生成: 顧名思義,速度是其核心優勢。 Gemini-2.5-Flash-Image 擅長快速生成圖像,這對於時間緊迫的創意專業人士或互動式應用程式至關重要。穩定的影像品質: 儘管速度很快,但該模型在影像品質上卻沒有顯著的妥協。它能夠產生連貫、視覺上引人入勝的圖像,並且通常不會出現嚴重的偽影,這使得它在許多用例中能夠與速度較慢、資源密集的模型相媲美。多模式理解: 利用更廣泛的 Gemini 框架,它通常受益於先進的多模式理解,這意味著它不僅可以解釋文本,還可以解釋其他形式的輸入以指導圖像生成和編輯,儘管這因特定的 API 而異。整合編輯功能: Gemini-2.5-Flash-Image 通常具有整合的編輯功能,例如修復(填充影像的缺失部分)、修復(將影像擴展到其原始邊界之外)和物件操作,使其成為端到端影像工作流程的更完整的解決方案。
Gemini-2.5-Flash-Image 有哪些需要改進的地方?
巔峰照片寫實主義: 雖然它表現不錯,但對於高度複雜細緻的場景,它可能無法達到某些速度較慢、體積較大的模型所達到的照片級真實感的巔峰。速度和終極保真度之間可能需要一些權衡。複雜風格的藝術細微差別: 對於高度具體的藝術風格或極其抽象的要求,與在大量藝術歷史資料集上訓練的模型相比,一些用戶可能會發現它捕捉最微妙的藝術細微差別的能力略差。控制生成的文字(在圖像內): 與許多生成模型一樣,在圖像中生成完全連貫且拼寫正確的文字仍然是一個挑戰。
什麼是 Qwen-Image-Edit? 詳細資料: Qwen-Image-Edit(阿里巴巴/Qwen團隊) — 基於 Qwen-Image 系列構建的圖像編輯模型;聲稱具有強大的雙語文字編輯(中文和英文)、語義和外觀控制以及直接圖像編輯保真度。
Qwen-Image Edit 的獨特優勢是什麼?
卓越的編輯精度: Qwen-Image Edit 擁有先進的修復、去除修復和物件操作演算法,可實現高精度、無縫的編輯。即使在進行重大修改時,它也能出色地保持視覺連貫性。上下文感知編輯: 其關鍵優勢在於上下文感知。例如,當移除一個物件時,它會聰明地用與周圍環境邏輯融合的內容填充空白,使編輯幾乎無法被察覺。風格轉換與協調: Qwen-Image Edit 可以有效率地將一張圖片的風格轉移到另一張圖片,或協調圖片中的不同元素,從而打造統一的外觀。這對於處理各種視覺資源的設計師來說,非常實用。穩健的物件刪除/新增: 它能夠在保持光照、陰影和透視的同時添加或刪除物體,這令人印象深刻,可以實現複雜的場景重建或清理。影像升級和增強: 通常包括高級功能,用於在不損失品質的情況下升級影像,並增強細節、色彩和整體視覺吸引力。
Qwen-Image Edit 的潛在弱點是什麼?
初始生成焦點: 雖然它可以產生圖像,但它的主要優勢和優化通常體現在編輯方面。它最初的文字轉圖像生成功能可能不錯,但可能不如純粹專注於生成的模型那樣具有創意多樣性或照片級真實感,具體取決於具體版本。進階功能的學習曲線: 對於不熟悉進階影像處理概念的使用者來說,其編輯工具的精確度和深度可能需要稍微陡峭的學習曲線。複雜編輯的資源強度: 高度複雜、多層的編輯仍然需要大量的計算,這可能會導致非常大或複雜的任務的處理時間更長。
Flux Kontext 為影像 AI 帶來哪些創新? 詳細資料: Flux 的 Kontext(有時被稱為 FLUX.1 Kontext)是一款針對設計師和品牌團隊的影像編輯/生成工具。它強調 上下文感知編輯 、精確的排版、風格轉換以及緊密的 UI/UX,適用於迭代設計工作。
Flux Kontext 的優點是什麼?
語境銜接: Flux Kontext 的主要優勢在於它能夠理解並維護跨多幅影像生成或編輯的上下文。這對於創建一致的視覺敘事、角色設計或專注於視覺和諧的產品線至關重要。提升系列一致性: 如果您需要產生一系列具有共同風格、特徵或環境的影像,Flux Kontext 旨在減少可能困擾其他模型的不一致性。自適應造型: 它可以根據先前生成的圖像或定義的樣式指南調整其輸出,從而實現更精簡、更少迭代的創作過程。專注於品牌和敘事: 對於行銷、品牌推廣和故事敘述尤其有益,因為統一的視覺識別至關重要。結合上下文快速理解: 它的快速理解不僅僅是關於當前圖像,還包括它如何適應更大的環境或指令集。
Flux Kontext 的限制是什麼?
利基市場潛力: 它強調背景和一致性,這可能意味著如果這是唯一的要求,它並不總是原始、獨立的照片寫實主義或極端藝術多樣性的絕對領導者。較少公開紀錄的基準: 作為較新或更專業的參與者,與更成熟的模型相比,廣泛的公共基準數據可能不太可用。依賴清晰的上下文輸入: 為了發揮其優勢,使用者需要提供清晰的上下文資訊或有效地定義敘述框架,這可能需要不同的提示方法。
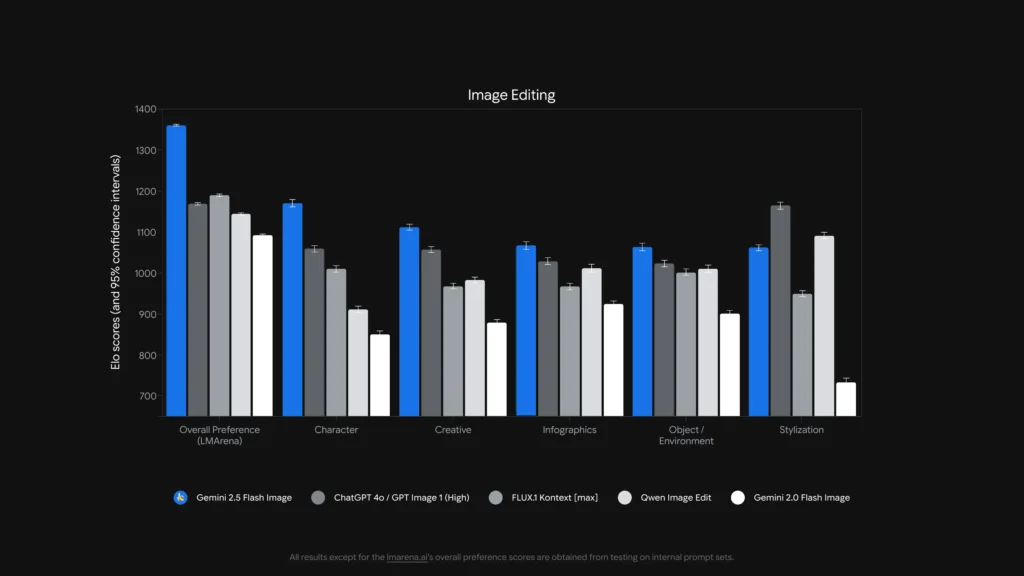
哪種型號最適合影像編輯? 對於單身人士來說, 精確的無掩模編輯 圖像內的文字編輯 , Qwen-圖像編輯 Gemini 2.5 Flash 影像 (以及 FLUX.1 Kontext 等專門的模型)是最強大的。對於 複雜的多步驟鍊式編輯 ,將指令強的 LLM 前端(Gemini 或 GPT 變體)與圖像模型相結合通常會產生最佳結果——一些基準測試工作表明,思路鍊式提示(Gemini-CoT)可以提高多步驟編輯的成功率。
本地編輯、角色一致性、文字處理
Qwen-圖像編輯 明確針對 語義的 外貌 編輯 — 例如,替換物件、旋轉、精確文字替換 — 明確建構為 圖像編輯 雙路徑模型(透過 Qwen2.5-VL 進行語意控制 + 透過 VAE 編碼器進行外觀控制)。它支援強大的雙語(中/英)能力。 圖像中的文字編輯 (例如,更改標誌文字、產品標籤)同時保留風格,這對於本地化和包裝工作來說是罕見且有價值的。Gemini 2.5 Flash 影像 支援蒙版編輯、基於提示的局部修改(模糊背景、移除人物、改變姿勢)以及多影像融合。谷歌宣傳了基於提示的區域感知編輯以及世界知識優勢(例如,更好的現實世界物件語義)。該模型還增加了 隱形的 SynthID 浮水印 生成/編輯圖像以幫助查找來源和檢測。FLUX.1 上下文 :將自身定位為圖像到圖像的上下文解析器——它針對精確、上下文感知的局部編輯和迭代實驗進行了最佳化。評論家稱讚其在進行局部修改的同時保留上下文和場景語義的能力。 FLUX.1 Kontext 和 Flux Kontext UI 在迭代編輯工作流程和文字可讀性方面的實際測試中獲得了一致好評,使其成為需要多次快速迭代(例如行銷資產、縮圖)的工作流程的實用之選。GPT-image-1 :支援編輯操作(文字+圖像編輯提示),OpenAI 的工具整合了連結和提示工程模式;性能強勁,但取決於提示工程,並且在某些測試中可能在細粒度編輯(例如,精確的雙語文字替換)中落後於專門的編輯優先模型。
基準測試包括 ComplexBench-編輯 CompBench 研究表明,當編輯鍊式或相互依賴時,許多模型仍然會失敗,但將用於指令解析的 LLM 與穩健的圖像模型(LLM→圖像模型編排)相結合,或使用 CoT 提示可以減少失敗。正因如此,一些生產工作流程會將模型拼接在一起(例如,推理 LLM 加上圖像生成器),以應對複雜的編輯。
誰最擅長編輯圖像中的文字?
Qwen-圖像編輯 專為雙語(中文+英文)精準文本編輯而設計,並在文本編輯基準測試(Qwen 公開技術說明和報告分數)中取得了優異的成績。開源 Qwen 工件和示範版本展示了編輯過程中字體/大小/樣式的精準保留。GPT-影像-1 Gemini 2.5 Flash 影像 兩者在文本渲染方面都取得了進展,但學術基準和供應商說明表明,小/細節文本和長文本段落仍然存在挑戰——改進是漸進的,並且因提示和分辨率而異。
比較分析:特寫、剪輯 為了提供更清晰的畫面,讓我們將這些領先的 AI 模型的關鍵方面整合成比較表。
原生生成+編輯 是的。一個 API 中包含多模式文字+圖像。 是的——原生生成和有針對性的編輯;強調多圖像融合和角色一致性。 專注於 編輯 (Qwen-Image-Edit)具有語意+外觀控制。 專注於圖像到圖像的高保真編輯。 編輯深度(局部調整) 高(但通用) 非常高(有針對性的提示+無掩碼編輯) 語意/文字編輯(雙語文字支援)非常高。 非常高——上下文感知編輯管道。 圖像中的文字處理 很好,取決於提示 改進(供應商展示模板和標誌編輯演示) 最好 其中包括雙語可讀文本的改變。非常適合保留風格;易讀性取決於提示。 角色/物件的一致性 小心提示即可 強大 (顯性特徵)中(重點是編輯而不是多圖像標識) 透過迭代編輯工作流程變得強大。 延遲/吞吐量 中度 低延遲/高吞吐量 (Flash 模型)因託管而異(本地/HF 與雲端) 專為託管 SaaS 中的快速迭代編輯而設計。 出處/浮水印 無強制水印(政策機制) SynthID隱形浮水印 用於圖像。取決於主機 取決於主機
注意: 「編輯深度」衡量的是實際的本地編輯的細粒度和可靠性;「文字處理」評估的是將可讀文字放入/更改圖像中的能力
延遲、開發人員人體工學和企業整合又如何呢?
延遲和部署選項
Gemini 2.5 Flash 影像 強調 低延遲 可透過 Gemini API、Google AI Studio 和 Vertex AI 使用——對於需要可預測吞吐量和雲端整合的企業應用程式來說,這是一個不錯的選擇。 Google 也提供了每張圖片代幣的大致定價(開發者部落格也包含每張圖片定價範例)。GPT-影像-1 可透過 OpenAI Images API 獲取,並已與廣泛的生態系統整合(Playground 以及 Adobe/Canva 等合作夥伴)。定價採用代幣化,並根據影像品質等級而有所不同(OpenAI 發布了代幣與美元的兌換率)。Flux Kontext 專注於快速互動使用者體驗,並在產品演示中提供積分+較低的每次編輯時間——方便設計師和快速迭代。 奎文 提供開放的文物和研究存取權限(如果您想自行託管或檢查內部情況,這是理想的選擇)。
這些服務的費用是多少-哪個比較划算?
定價經常變化——以下是出版商聲明的數字(2025 年 XNUMX 月)以及供應商發布的具有代表性的每張圖片成本計算。
已公佈的價格(供應商聲明) GPT-Image-1(OpenAI) 代幣化定價(文字輸入 5 美元/1 萬,圖像輸入 10 美元/1 萬,圖像輸出 40 美元/1 萬)。 OpenAI 指出,這大致相當於 $ 0.02- $ 0.19 根據品質/大小生成每個影像。 $0.02(低品質/縮圖)→$0.19(高品質方形)Gemini 2.5 Flash 鏡像(Google) 每 30 萬個輸出代幣 1 美元 例如:每張影像約 1290 個輸出標記(~$0.039 根據開發者博客,每張圖片都有定價。定價透過 Gemini API / Vertex 計算。~$0.039 每張圖片(Google範例) Flux Kontext(Flux) 附有積分的免費套餐;Flux 產品頁面顯示 10 免費積分 以及典型的編輯價格 5學分 ;為重度使用者提供訂閱等級。 (供應商產品頁)。 偶爾編輯時成本非常低;頻繁使用時則需要訂閱。 Qwen 圖像編輯 (QwenLM) 開放版本和 GitHub 工件——開放訪問,用於研究,並提供免費範例;商業部署因整合商而異(自託管或雲端)。沒有統一的鏡像價格;自架價格通常最低。
價值解讀: 如果您需要高容量影像 代 如果您正在生產環境中,並且希望按可預測的每張圖片定價,那麼 Google 的每張圖片範例極具競爭力。如果您的成本主要由人工在環編輯或迭代設計時間決定,那麼 Flux 或在本地運行 Qwen 可能更經濟。 OpenAI 提供廣泛的 SDK 生態系統和眾多合作夥伴,為了方便集成,值得選擇更高層級的方案。
型號 GPT-image-1 Gemini-2.5-Flash-Image FLUX.1 上下文 價格 輸入代幣 8.00 美元;輸出代幣 32.00 美元 $0.03120 flux kontext pro:0.09600 美元 flux-kontext-max:0.19200 美元
獲得最佳結果的實用快速技巧
提示和工作流程提示(適用於所有模型)
明確說明構圖 :拍攝角度、光線、氛圍、焦距、鏡頭、物件之間的空間關係。例如: “35 毫米特寫,淺景深,主體居中,左上方有柔和的邊緣光。” 使用迭代細化進行編輯 :先進行粗略的結構編輯,然後再進行紋理/光照細化。 FLUX 和 Gemini 等模型旨在支援多步驟細化。對於圖像中的文本 :提供您想要的精確文字並添加「渲染為具有逼真浮雕的高對比度清晰標誌」 - 對於雙語編輯,當您需要中文/英文保真度時,請使用 Qwen-Image-Edit。使用參考影像 :為了確保角色一致性或產品變體,請提供高品質的參考影像和錨點提示,例如「匹配reference_01中的角色:臉部特徵、服裝顏色和燈光」。 Gemini和Flux強調多重影像融合/一致性。遮罩編輯與無遮罩編輯 :盡可能提供遮罩以嚴格限制編輯。使用無遮罩時,可能偶爾會出現溢出。不同型號的遮罩可能存在差異:Flux/Gemini 可以很好地處理無遮罩編輯,但遮罩仍然有幫助。使用 GPT-影像/GPT-4o 適用於包含多個物件、數量和空間限制的複雜構圖任務。盡可能為每代任務使用單一且精確的指令。
成本和延遲提示 配料 :使用批次 API 或雲端函數高效產生多種變體。如果您需要高容量,Gemini-2.5-Flash 已針對吞吐量進行了最佳化。
調整品質與價格 :OpenAI 展示低/中/高影像層;以低品質生成草稿,以高品質完成。
最終裁決
最適合生產和整合: GPT-Image-1 — 最能滿足 API 需求、合成和專業工具整合。最適合消費者照片真實感的一致性: 奈米香蕉 — Google 的 Gemini 影像升級在自然、連續的肖像編輯和平易近人的使用者體驗方面表現出色。最佳移動/編輯體驗: Flux Kontext — 在手機上以低摩擦的方式進行出色的對話編輯。如果您透過外科文字編輯和雙語/多語言編輯來衡量→Qwen-Image-Edit** 是頂級專家,也是圖像內文字準確性至關重要的絕佳選擇。
入門 CometAPI 是一個統一的 API 平台,它將來自領先供應商(例如 OpenAI 的 GPT 系列、Google 的 Gemini、Anthropic 的 Claude、Midjourney、Suno 等)的 500 多個 AI 模型聚合到一個開發者友好的介面中。透過提供一致的身份驗證、請求格式和回應處理,CometAPI 顯著簡化了將 AI 功能整合到您的應用程式中的過程。無論您是建立聊天機器人、影像產生器、音樂作曲家,還是資料驅動的分析流程,CometAPI 都能讓您更快地迭代、控製成本,並保持與供應商的兼容性——同時也能充分利用整個 AI 生態系統的最新突破。
最新整合 Qwen-圖像編輯 即將出現在 CometAPI 上,敬請期待!準備好開始編輯影像了嗎? → 立即註冊 CometAPI !
型號 GPT-image-1 Gemini-2.5-Flash-Image FLUX.1 上下文 價格 輸入代幣 8.00 美元;輸出代幣 32.00 美元 $0.03120 flux kontext pro:0.09600 美元 flux-kontext-max:0.19200 美元