
الخلاصة
Claude Haiku 5.5 وGPT-6 Luna نماذج استدلال منخفضة التكلفة لأعباء العمل كبيرة الحجم على واجهات API. يبدأ كلاهما بسعر $0.10 لكل مليون رمز إدخال و$0.50 لكل مليون رمز إخراج. حقق Haiku درجات أعلى في المقارنات الست المنشورة في مواد إطلاق Anthropic. يحتفظ Luna بأسعار الرموز الأساسية للمطالبات حتى 272K رمز إدخال، مقارنةً بعتبة 100K لدى Haiku. بالنسبة للمطورين، المقاييس الأساسية هي معدل القبول، والزمن الشامل من البداية للنهاية، وتوافق واجهة API، وتكلفة كل نتيجة مقبولة—إجمالي تكلفة جميع المحاولات مقسومًا على عدد المخرجات التي تجتاز الفحوصات المحددة مسبقًا.
النقاط الرئيسية
- يتصدر Haiku 5.5 مقارنة OSWorld 2.1 لاستخدام الحاسوب المذكورة، 72.4% مقابل 48.9% لـLuna.
- على Terminal-Bench 4.0، النتائج المذكورة هي 39.2% لـHaiku و16.4% لـLuna.
- يبدأ كلاهما بأسعار سياق قصير متطابقة، لكن شريحة السعر الأعلى لدى Haiku تبدأ بعد 100K رمز مطالبة، مقابل عتبة 272K لدى Luna.
- صفحات "الجهد الأقصى" لدى Artificial Analysis، بتاريخ 9 أكتوبر 2026، تُظهر سرعات إخراج 240.6 رمز/ثانية لـHaiku و123.0 رمز/ثانية لـLuna؛ الإنتاجية لا تشمل زمن انتظار الرمز الأول.
- ابدأ باستخدام Haiku لمهام استخدام الحاسوب والطرفية التي تعكسها المعايير المشتركة؛ فكّر في Luna للمطالبات الكبيرة. احتفظ بنموذجك الحالي حتى يُظهر مشروع تجريبي ممثل تحسنًا مفيدًا.
ما هما Claude Haiku 5.5 وGPT-6 Luna؟
Claude Haiku 5.5: نظرة عامة
Claude Haiku 5.5 أُطلق في 7 أكتوبر 2026. يجمع بين الاستدلال منخفض السعر وجهد الاستدلال القابل للضبط، واستخدام الأدوات، وسياق طويل، ومدخلات نص وصورة. تشمل الاستخدامات الشائعة استخلاص المستندات، واستعلامات قواعد البيانات، ودعم العملاء، والعوامل الخفيفة.
GPT-6 Luna: نظرة عامة
GPT-6 Luna أُطلق في 22 سبتمبر 2026. يتموضع للمهام المركزة على نطاق واسع، بما في ذلك التصنيف، واستخلاص المعلومات، والمخرجات المهيكلة، ومساعدة البرمجة، ومعالجة المستندات الطويلة. تشمل إعدادات الاستدلال المرنة تكوينًا بلا استدلال للعمل الأبسط.
المواصفات
| المواصفة | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| المطوّر | Anthropic | OpenAI |
| الإصدار | 7 أكتوبر 2026 | 22 سبتمبر 2026 |
| معرّف النموذج | claude-haiku-5-5 | gpt-6-luna |
| سعة السياق | 1,000,000 tokens | 1,050,000 tokens |
| أقصى مخرجات (واجهة API القياسية) | 128,000 tokens | 128,000 tokens |
| الإدخال | Text and image | Text and image |
| الإخراج | Text | Text |
| الاستدلال | Adjustable, Low to Max | None to Max |
| الجهد الافتراضي | Medium | Medium |
| حدّ المعرفة | June 2026 | May 18, 2026 |
| استخدام الأدوات | Yes | Yes |
| مخرجات منظّمة | Yes | Yes |
| الأوزان المفتوحة | No | No |
| البنية وعدد المعاملات | Not specified in the cited official materials | Not specified in the cited official materials |
تستخدم المواصفات وثائق نماذج واجهات API القياسية لدى البائعين، بتاريخ 9 أكتوبر 2026: Haiku's standard API specifications وLuna's standard API specifications. تُترك البنية وعدد المعاملات غير محددين لأن هذه المصادر لا تثبتهما.
Claude Haiku 5.5 مقابل GPT-6 Luna: نتائج الاختبارات المعيارية
| الاختبار المعياري | Haiku 5.5 | GPT-6 Luna | المتفوق |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1، درجة جزئية غير متصلة | 72.4% | 48.9% | Haiku +23.5 نقطة مئوية |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 نقطة مئوية |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 نقطة مئوية |
| Chartography، من دون أدوات | 46.4% | 29.1% | Haiku +17.3 نقطة مئوية |
الصفوف الستة أعلاه تعيد إنتاج نتائج المقارنات المنشورة في مواد إطلاق Anthropic، بتاريخ 9 أكتوبر 2026. إنها مقارنات منشورة من Anthropic، تتضمن نتائج مستقلة أعيد نشرها هناك، وليست اختبارات جديدة أُجريت لهذه المقالة. GDPval-AA وAA-Briefcase درجات Elo؛ الفوارق بالنقاط المئوية. تقيس هذه العائلات المعيارية مهام مختلفة ولا ينبغي متوسطها لاختيار فائز شامل.
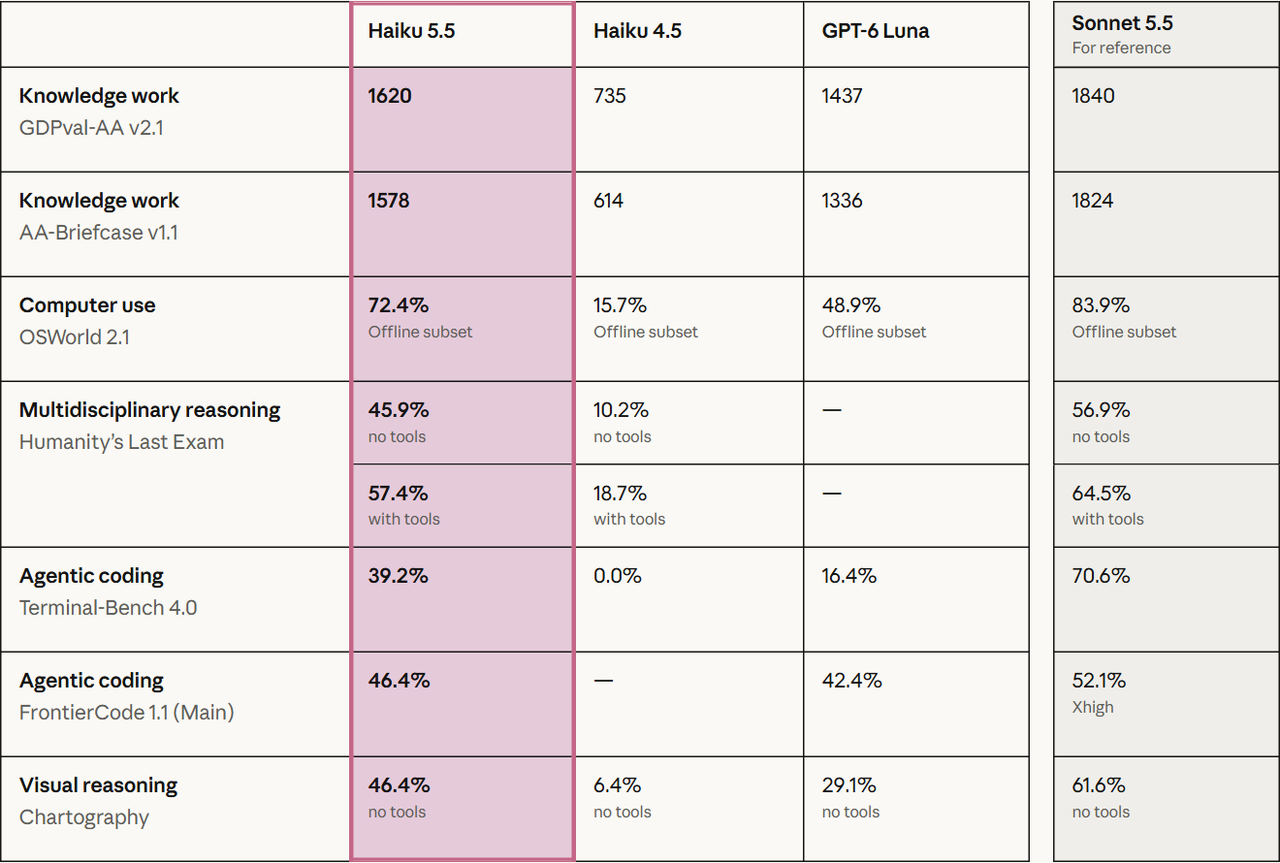
تظهر أقوى نتائج Haiku النسبية في التفاعل المرئي مع الحاسوب والمهام القائمة على الطرفية. تفوقه الأصغر في FrontierCode يحذر من تعميم فجوة قدرها 20 نقطة على كل حالات الترميز. استخدم هذه النتائج لاختيار مرشحي المشاريع التجريبية، ثم تحقق من صحة مطالباتك وحزمة الأدوات.
جهد الاستدلال وحدود التقييم
يغير جهد الاستدلال مقايضة الدقة مقابل التكلفة. قارن الإعدادات المتاحة باستخدام نفس عبء العمل وهيكل القياس؛ أسماء الإعدادات المتساوية لدى البائعين لا تضمن ميزانيات رموز استدلال متساوية. يعرض جدول الإطلاق مجموعة OSWorld غير المتصلة وChartography من دون أدوات. يمكن أن يغير هيكل القياس، واختيار المهام، والمحاولات، والوصول إلى الأدوات النتائج. توثق بطاقة نظام Anthropic شروط الاختبار الخاصة بكل معيار. اقرأ منهجية الاختبارات في بطاقة نظام Anthropic.
- يستخدم OSWorld المجموعة غير المتصلة المؤلفة من 82 مهمة، وجهاز Ubuntu افتراضيًا، ولقطات شاشة 1080p، وحد 500 إجراء، وأقصى جهد، وخمس محاولات لكل مهمة. المقارنة 72.4%/48.9% هي درجة ائتمانية جزئية، وليست نسبة المهام المُنجزة تمامًا؛ معدل النجاح الصارم لدى Haiku هو 37.1%. شغّلت Anthropic نموذج Luna على نفس مجموعة المهام عبر واجهة OpenAI.
- يستخدم Terminal-Bench 66 مهمة حاويات؛ شغّل Haiku بأقصى جهد في وضع Claude Code bare، من دون خروج إلى الإنترنت أو نموذج احتياطي، وبمتوسط عشرة تجارب لكل مهمة.
- يحتوي FrontierCode Main على 100 مهمة بخمس تجارب لكل مهمة؛ استخدمت نماذج Claude بيئة Claude Code واستخدمت نماذج GPT Codex.
- تم تقييم GDPval-AA وAA-Briefcase بشكل مستقل بواسطة Artificial Analysis وأُعيد نشرهما في مواد الإطلاق. هذه خطوط تقييم منفصلة، وليست هيكل إنتاج مشتركًا واحدًا.
Claude Haiku 5.5 مقابل GPT-6 Luna: مقارنة الميزات
استخدام الحاسوب والبرمجة الوكيلة
أكبر ميزة لـHaiku تظهر في مهام الإطلاق المشتركة التي تتطلب التفاعل مع حاسوب رسومي أو العمل في طرفية. فجوة OSWorld في الدرجة الجزئية هي 23.5 نقطة مئوية، بينما يختلف Terminal-Bench بـ22.8 نقطة. يبيّن فارق 4.0 نقاط في FrontierCode سبب عدم التعامل مع فئة "الترميز" الأوسع كعبء عمل واحد.
لأتمتة المتصفح، اختبر تنقّل الصفحات، وملء النماذج، والتعافي من إخفاقات الأدوات، والإكمال الشامل. بالنسبة للترميز، اختبر ما إذا كان التصحيح يجتاز فحوصات المستودع الوظيفية ويبقى ضمن النطاق. تعد تلك فحوصات القبول أكثر فائدة من اختيار نموذج بناءً على أكبر فجوة عناوين رئيسية.
السياق الطويل ومعالجة المستندات
الفرق البالغ 5% في السعة الاسمية للسياق أقل أهمية من موثوقية وسعر معالجة المطالبات الكبيرة فعليًا. لا يتفوّق أي نموذج جوهريًا في الاسترجاع لمجرد أن نافذة سياقه أكبر.
الفرق المحوري هو توقيت تطبيق الأسعار الأعلى: مطالبة من 150K رمز تتجاوز عتبة Haiku بينما تبقى ضمن الشريحة الأساسية لـLuna. لذلك يعد Luna نقطة انطلاق أقل تكلفة لهذا العبء الرمزي. وما إذا كان محللاً أفضل للمستندات يعتمد على دقة الاستخلاص، والاستشهادات، وعدد المحاولات اللازمة للحصول على إجابة مقبولة.
ضوابط الاستدلال
تعرض النماذج كلاهما جهد استدلال قابلًا للضبط، مع "Medium" كإعداد افتراضي وفق الوثائق المذكورة. كما يعرض Luna إعداد "None". استخدم هذه الضوابط بما يلائم المهمة: قد يتطلب الاستخلاص والتوجيه استدلالًا أقل من سير عمل أدوات متعدد الخطوات مع درجة عالية من عدم اليقين. لا يعني نفس اسم الجهد نفس ميزانية الحوسبة عبر البائعين.
إدخال متعدد الوسائط وتدفّقات عمل منظّمة
كلاهما يقبل نصوصًا وصورًا ويُنتج نصًا. هذا يجعلهما مرشحين للقطات الشاشة، واستخلاص صور المستندات، وتدفّقات العمل المنظمة اللاحقة. لا يثبت دعم الإدخال وحده دقة متساوية على النص الصغير أو المخططات أو الواجهات المرئية؛ قيّس تلك الحالات على حدة.
السرعة واقتصاديات المهام
| مؤشر مستقل (أقصى جهد) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| سرعة الإخراج | 240.6 tokens/s | 123.0 tokens/s |
| التكلفة المُوزّنة لكل مهمة Intelligence Index | $0.21 | $0.07 |
Artificial Analysis هي جهة نشر اختبارات مستقلة. الجدول لقطة من صفحات "الجهد الأقصى" للنماذج بتاريخ 9 أكتوبر 2026، وليس أداءً رسميًا من البائعين. تقيس سرعة الإخراج الرموز المستلمة بعد بدء التوليد؛ وهي منفصلة عن زمن الرمز الأول وزمن المهمة الشامل. تكلفة المهمة هي مقياس Intelligence Index مُوزّن، وليست عرض سعر لمهمتك الإنتاجية أو تكلفة لكل نتيجة ناجحة.
إنتاجية الإخراج لدى Haiku في هذه اللقطة تقارب 1.96 ضعف Luna، بينما التكلفة المُوزّنة للمهمة لدى Luna أقل. لا يثبت هذا أفضلية مقدارها 1.96× في زمن إكمال المهمة الشامل. يجب أن يسجل الاختبار الإنتاجي زمن الرمز الأول، وزمن الإكمال، وطول المخرجات، واستهلاك الاستدلال، وزمن تنفيذ الأدوات كلٌ على حدة.
Claude Haiku 5.5 مقابل GPT-6 Luna: التسعير والوصول عبر API
الأسعار القياسية الرسمية
| دولار أمريكي لكل 1M رمز | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| الإدخال | $0.10 | $0.50 | $0.10 | $0.20 |
| القراءة من الذاكرة المؤقتة | $0.01 | $0.05 | $0.01 | $0.02 |
| الكتابة إلى الذاكرة المؤقتة (Haiku: TTL 5 دقائق) | $0.125 | $0.625 | $0.125 | $0.25 |
| الإخراج | $0.50 | $2.50 | $0.50 | $0.75 |
الدولار لكل مليون رمز بأسعار المعالجة القياسية، بتاريخ 9 أكتوبر 2026. يستخدم الجدول أسعار Haiku القياسية وأسعار كتابة الذاكرة المؤقتة لمدة 5 دقائق وأسعار Luna للسياق القصير والطويل. رسوم الأدوات والضرائب والزيادات الإقليمية وتعديلات شرائح المعالجة الاختيارية مستبعدة. عند تجاوز عتبة الإدخال، تُطبَّق الأسعار الأعلى على الطلب بأكمله وليس على الرموز الزائدة فقط.
يقدم Haiku أيضًا كتابات ذاكرة مؤقتة لمدة ساعة بأسعار $0.20/$1.00 لكل مليون رمز للمطالبات القصيرة/الطويلة. تختلف آليات استمرارية الذاكرة المؤقتة وتسعيرها بين البائعين، لذا قارن أنماط إعادة الاستخدام بدلًا من التعامل مع صفّي "كتابة الذاكرة المؤقتة" كمنتجين متطابقين. حد 128K للإخراج هو حد واجهة API القياسية؛ يمكن لـMessage Batches API دعم 300K مخرجات عبر ترويسة beta.
تكاليف توضيحية عند ميزانيات رموز ثابتة
| عبء العمل | إدخال / إخراج | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| تصنيف التذاكر | 2K / 200 | $0.0003 | $0.0003 |
| تقرير قصير | 40K / 4K | $0.006 | $0.006 |
| تحليل المستودع | 150K / 5K | $0.0875 | $0.0175 |
| مراجعة مستند كبير | 300K / 10K | $0.175 | $0.0675 |
| تحليل سياق ضخم | 800K / 20K | $0.45 | $0.175 |
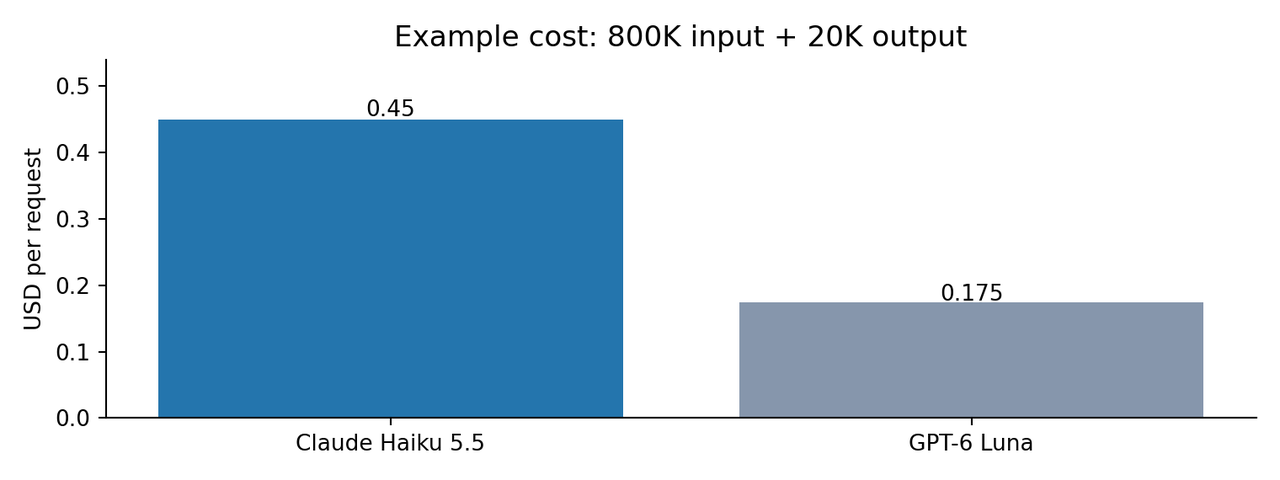
تقدير قياسي غير مخزّن محسوب من قبل المؤلف: التكلفة = رموز الإدخال × سعر الإدخال / 1,000,000 + رموز الإخراج المفوترة × سعر الإخراج / 1,000,000. "الإخراج" يعني إجمالي الإخراج المفوتر لهذا التقدير، بما في ذلك رموز الاستدلال حيث تُحتسب كإخراج؛ وليس بالضرورة طول الإجابة المرئي. تُستخدم نفس أعداد الرموز المبلغ عنها لكلا النموذجين، رغم أن المُرمّزين قد يختلفان.
الرمز الرخيص ليس بالضرورة نتيجة ناجحة رخيصة. على الفرق احتساب المحاولات المتكررة، واتصالات الأدوات الفاشلة، واستهلاك رموز الاستدلال، واختلاف سلوك المُرمّز.
الوصول عبر CometAPI وقيود التكامل
يوفر CometAPI خيارات وصول لكلا النموذجين. قبل مقارنتهما أو نشرهما عبر البوابة، تحقق من معرّفات النماذج، ونقاط النهاية المدعومة، ومعلمات الطلب، وسلوك الأدوات، وقواعد الفوترة لكل مسار. توثّق روابط المزودين خيارات الوصول؛ لكنها لا تحل محل المصادر الفنية أو تسعير البائعين القياسي.
بالنسبة لتكاملات OpenAI المباشرة، يدعم Luna أدوات مدمجة عبر Responses API؛ يتطلب استدعاء الدوال عبر Chat Completions إعداد الاستدلال none. يستخدم Haiku Messages API و"التفكير التكيفي". لا تجعل البوابة المخططات الأساسية قابلة للاستبدال: تحقق من تعريفات الأدوات، وسلوك المخرجات المهيكلة، وأحداث البث، والمحاسبة عبر المسار الدقيق الذي تنوي استخدامه.
كيف يمكن للمطورين مقارنة Claude Haiku 5.5 وGPT-6 Luna باستخدام نفس المطالبة؟
مثال لاستخلاص مستندات طويلة
يمكن أن يستخدم قياس عملي حزمة عقود موردين تحتوي على تواريخ سريان، وشروط التجديد، وفترات الإشعار، والاستثناءات. احتفظ بحزمة المستندات وتعليمات الاستخلاص والحقول المتوقعة وقواعد التحقق متطابقة. ما يلي تصميم تقييم، وليس نتيجة نموذج مقاسة جديدة.
مثال مطالبة: استخرج اسم المورّد، وتاريخ السريان، وتاريخ التجديد، وفترة إشعار الإنهاء، واستثناءات التسعير لكل عقد. لكل قيمة مُستخرجة، اذكر عنوان المستند والمقطع الداعم الدقيق. أعد null عندما يكون الحقل غائبًا؛ لا تستنتج تواريخ مفقودة. علّم البنود المتعارضة والتزم بإجابة نهائية ضمن 1,000 كلمة.
| الفحص | معيار القبول | ما الذي يُسجَّل |
|---|---|---|
| دقة الاستخلاص | تطابق الحقول المطلوبة مفتاح إجابة مُتحقق مستقلًا | القيم الصحيحة والخاطئة والمفقودة |
| الاستناد إلى الأدلة | لكل حقل غير null مقطع داعم صالح | الادعاءات غير المدعومة وإحالات المستندات الخاطئة |
| اتباع التعليمات | لا تواريخ مختلَقة؛ الحقول الغائبة تُرجع null | إخفاقات المخطط وانتهاكات القيود |
| الاقتصاد | حساب الإنفاق لكل استخلاص مقبول | رموز الإدخال والإخراج والاستدلال، والمحاولات، وتكلفة الاحتياطيات |
| الكمون | مقارنة إكمال المهمة بالكامل تحت نفس سياسة الأدوات | زمن الرمز الأول والزمن الشامل من البداية للنهاية |
شغّل أكثر من حزمة ممثلة واحدة وأعِد الحالات التي تتفاوت فيها النتائج. ابدأ بنفس مستوى الجهد المتاح، ثم اختبر تكوينًا أقل تكلفة لكل نموذج. أبلغ عن حجم العينة، والإعدادات، والمسار، والتاريخ، وأعداد الإخفاقات قبل عرض الفائز.
Haiku 5.5 أم GPT-6 Luna: أيهما تختار؟
| البُعد | نقطة الانطلاق الأفضل دعمًا | حدّ القرار |
|---|---|---|
| التفاعل مع واجهة المستخدم الرسومية | Claude Haiku 5.5 | درجات OSWorld الجزئية المشتركة تصب في مصلحة Haiku؛ تحقق من الإكمال الكامل |
| البرمجة في الطرفية | Claude Haiku 5.5 | درجات Terminal-Bench المشتركة تصب في مصلحة Haiku؛ تحقق من تغييرات المستودع |
| مطالبات قصيرة والأسعار الأساسية | اختبر كليهما | أسعار أساسية متطابقة؛ قارن الاستخدام المفوتر والمحاولات المتكررة |
| مطالبات تتجاوز 100K رمز | GPT-6 Luna على الأسعار القياسية | يحتفظ Luna بالشريحة الأساسية لفترة أطول؛ قد تغيّر الدقة التكلفة الإجمالية |
| معدل تمرير الرموز المُرسلة | Claude Haiku 5.5 في اللقطة المؤرخة | الإنتاجية تختلف عن زمن الإكمال الشامل |
| استخراج بسيط متكرر | اختبر Luna بقدر استدلال منخفض أو بلا استدلال | اختر وفق المخرجات المقبولة الصحيحة، لا السعر وحده |
اختر Claude Haiku 5.5 للمهام التفاعلية ذات الصلة بالمعايير
ابدأ بـHaiku عندما يشبه تطبيقك مهام الحاسوب الرسومي، أو ترميز الطرفية، أو عمل المهنيين المنشورة، وكان معدل الإكمال الأعلى سيعوّض إنفاق الاستدلال أو السياق الطويل الإضافي. أكّد هذا التفوق على حزمة أدواتك قبل توجيه حركة الإنتاج.
اختر GPT-6 Luna للتحكم في تكلفة المطالبات الكبيرة
ابدأ بـLuna عندما تتجاوز المطالبات كثيرًا 100K رمز وكانت تكاليف الرموز القياسية تؤثر ماديًا على ميزانيتك. كما أنه مرشح للاستخلاص المتكرر أو التوجيه الذي يمكن أن ينجح باستدلال منخفض أو بلا استدلال. أبقِ التوصية مشروطة بمعدلات النتائج المقبولة والاستخدام المفوتر الفعلي.
استخدم الاثنين عندما تختلف احتياجات أعباء العمل
يمكن لمشروع تجريبي توجيه استخلاص المستندات الطويلة إلى Luna ومهام واجهة المستخدم الرسومية أو الطرفية إلى Haiku، ثم التحقق من كل خيار مقابل فحوصات القبول. فعّل احتياطًا عندما تفشل مخرجات في التزمّ بالمخطط، أو تفتقر إلى الأدلة المطلوبة، أو تفشل فحصًا خاصًا بالمهمة، وضمّن تكاليف وزمن الاحتياط في المقارنة.
تحقّق قبل التبديل
ضمّن نموذجك الحالي كخط أساس. انتقل فقط عندما يحقق المرشح هدف دقة محددًا مسبقًا ويحسّن تكلفة كل نتيجة مقبولة أو زمن الإكمال الشامل بما يكفي لتغطية كلفة الهجرة والصيانة. أوقف الإطلاق إذا ارتفعت أخطاء الأدوات الحرجة. تتغير التوصية إذا أظهر مشروعك التجريبي أن السعر الأدنى لـLuna يتلاشى بسبب المحاولات المتكررة، أو أن درجات Haiku الأعلى في المعايير لا تحسن نجاح مهامك.
- استخدم عينة عبء عمل ممثلة وسجّل النتائج الصحيحة والخاطئة والناقصة.
- قِس زمن الرمز الأول، وزمن المهمة الشامل، وموثوقية الأدوات.
- تتبّع رموز الإدخال والقراءة من الذاكرة المؤقتة والإخراج والاستدلال بشكل منفصل.
- احسب تكلفة كل نتيجة ناجحة، بما في ذلك المحاولات والاحتياطيات.
- قارن جهدي Medium وHigh قبل تمكين إعدادات Max افتراضيًا.
الخاتمة
يملك Claude Haiku 5.5 أدلة إطلاق أقوى وجهًا لوجه عبر معايير العمل الاحترافي، واستخدام الحاسوب، والبرمجة الوكيلة مقارنة هنا. كما يملك إنتاجية إخراج أعلى في اللقطة المستقلة. يمتلك GPT-6 Luna أفضلية واضحة في الأسعار القياسية للمطالبات فوق عتبة 100K لدى Haiku وتكلفة أقل مُوزّنة لمهام التقييم. لا يحدد أي من الملاحظتين وحدهما موثوقية الإنتاج أو تكلفة كل نتيجة ناجحة.
الفائز العملي هو النموذج الذي يقدم نتيجة مقبولة بأقل تكلفة تشغيلية مُقاسة بالكامل. شغّل كلاهما على مطالباتك وأدواتك وقواعد المحاولة بدلًا من التعامل مع معيار واحد كإجابة نهائية.
الأسئلة الشائعة
لماذا قد تختلف تكاليف المهام بينما كلا النموذجين لهما نفس أسعار الرموز الأساسية؟
السعر الأساسي نفسه لا يعني نفس الفاتورة الإجمالية. قد تستخدم النماذج كميات مختلفة من رموز الإدخال والإخراج والاستدلال، وقد تحتاج أعدادًا مختلفة من المحاولات أو اتصالات الأدوات لإنتاج نتيجة مقبولة. تؤثر أسعار السياق الطويل واستخدام الذاكرة المؤقتة أيضًا على الإجمالي. قارن إجمالي تكلفة جميع المحاولات مقسومًا على عدد النتائج المقبولة، بدلًا من أسعار الرموز وحدها.
هل تُطبَّق أسعار السياق الطويل الأعلى فقط على الرموز فوق العتبة؟
لا. وفق التسعير القياسي الموصوف هنا، يؤدي تجاوز عتبة الإدخال إلى تطبيق الأسعار الأعلى على الطلب، وليس على الرموز الزائدة فقط. على سبيل المثال، طلب من 150K رمز إدخال يتجاوز عتبة 100K لدى Haiku لكنه يبقى ضمن الشريحة الأساسية لدى Luna. استخدم أسعار الإدخال والإخراج المطبّقة على الطلب بالكامل عند تقدير التكلفة.
هل يمكن لـClaude Haiku 5.5 وGPT-6 Luna مشاركة ذاكرة مطالبة مؤقتة؟
لا تفترض نقل إدخالات الذاكرة المؤقتة بين النماذج أو المزودين. صمّم استراتيجيات إعادة استخدام منفصلة، ثم قِس معدلات الضرب والاستخدام المفوتر على كل مسار. يمكن أن يؤثر دعم البوابة وقواعد الاحتفاظ وبنية الطلب على أهلية الإدخال المتكرر للتخزين المؤقت؛ تحقق من ذلك قبل توقع وفورات.
ما الذي يجب أن يغطيه اختبار الهجرة من Haiku إلى Luna؟
اختبر مدخلات نصوص وصور ممثلة، والحقول المهيكلة المطلوبة، ومعاملات الأدوات، والاستجابات المتدفقة، واسترداد الأخطاء. أسّس معدل القبول في نظامك الحالي قبل الهجرة، ثم قارن كلا المرشحين تحت نفس سياسات المحاولة والأدوات. أسعار الرموز المتشابهة أو فئات النماذج لا تثبت التوافق.
هل يجب أن تقود درجات المعايير تفعيل احتياطي بين Haiku أو Luna؟
استخدم الدرجات لاختيار المرشحين، ثم فعّل الاحتياطي عند الإخفاقات المرصودة مثل معاملات أدوات غير صالحة، أو حقول مطلوبة مفقودة، أو فحوصات مهمة غير مستوفاة. تتبّع تواتر الاحتياطي والتكلفة المفوترة الإجمالية. يمكن لنموذج ثانٍ أن يضيف كمونًا ونفقات، لذا تحقق من أنه يحسّن النتائج المقبولة بدلًا من مجرد إنتاج إجابة ثانية.
هل يمكن توجيه بيانات حساسة عبر واجهتي API كلتيهما؟
راجع المورّدين والبوابة المعنيين بالضبط، وإعدادات الاحتفاظ الحالية، ومواقع المعالجة، والشروط التعاقدية، وسياسة بيانات منظمتك قبل توجيه مدخلات حساسة. لا تثبت قدرات النموذج وجداول التسعير أهلية المسار للبيانات المنظمة أو السرية. استخدم المسار المعتمد عندما تكون تلك المتطلبات حاسمة.