
الخلاصة
أعلنت Google عن Gemini 4 Argon في 30 سبتمبر 2026 كنموذج متقدّم موجّه لسير العمل المعقّد وطويل الأمد. تُظهر النتائج المنشورة نمطًا واضحًا: أداء قوي في أعمال المعرفة المهنية، والمهام ذات السياق الطويل، وبعض تقييمات هندسة البرمجيات المنتقاة، مع نتائج أضعف على بعض معايير الطرفية واستخدام الحاسوب. تقدم Google النموذج عبر طرح تدريجي. بشكل منفصل، تفيد CometAPI بتوفره في الكتالوج اعتبارًا من 1 أكتوبر؛ ينبغي التحقق من أهلية الحساب ونجاح طلب اختبار قبل النشر. القصة الأكثر فائدة تخص مواضع مكاسب الأداء.
يسجل Argon نسبة 68.9% على Vals Index، و65.4% على Vals Finance Agent v2، و77.9% على DeepSWE v1.1، و91.7% على LVBench، و84.2% على GraphWalks عند سياق 256K–1M. وفي الوقت نفسه، يتراجع خلف نماذج متقدّمة منافسة على FrontierSWE v2 وTerminal-Bench 4.0 وTerminal-Bench Science وOSWorld-2.0.
تميل النتائج إلى رؤية محمولة على عبء العمل لـ Argon. تتجمّع أعلى درجاته حول أعمال المعرفة المهنية، والمهام ذات السياق الطويل جدًا، وبعض تقييمات الفهم متعدد الوسائط وهندسة البرمجيات. تحتفظ نماذج أخرى بأفضليات في عدة اختبارات للطرفية واستخدام الحاسوب.
النقاط الرئيسية
- يتميز Gemini 4 Argon في أعمال المعرفة المؤسسية، والاستدلال بسياق طويل، والفهم متعدد الوسائط، وعدة تقييمات ترميز طويلة الأفق.
- يوفّر حدًا أقصى للإخراج يبلغ 1,000,000 رمزًا، ما يمنح حيّز توليد أكبر لمسارات الاستدلال الطويلة؛ ولا يضع مواصفة عامة لسياق الإدخال.
- يتصدر Argon عدة نتائج منشورة في أعمال المعرفة والسياق الطويل، لكن GPT-6 Astra وClaude Opus 5.5 يظلان متقدّمين في بعض تقييمات الترميز واستخدام الحاسوب.
- تصف درجات المعايير تكوينات محددة للنموذج والوكيل. المقاييس وظروف الإدخال وإعدادات التقييم لا تقل أهمية عن النسب الرئيسية.
- طرح Google والوصول عبر CometAPI ادعاءان منفصلان للتوفر. تحقق من المسار النشط، ومعرّف النموذج، وأهلية الحساب قبل ترحيل الحركة.
ما هو Gemini 4 Argon؟
Gemini 4 Argon هو نموذج Gemini متقدّم جديد من Google DeepMind، بُني لسير العمل الصعب الذي يتطلب الاستدلال عبر خطوات عديدة بدلًا من الإجابة عن مطلب قصير واحد.
تؤكد وضعية Google الرسمية على هندسة البرمجيات الواقعية، وأعمال المعرفة المؤسسية مثل القانون والمالية، والأمن السيبراني الدفاعي، والفهم متعدد الوسائط، والمهام العاملية طويلة الأمد.
هذا تمييز مهم عن إصدارات Flash الأخيرة. Gemini 3.8 Flash API in CometAPI صُممت لتكون أداة منخفضة التكلفة لأعباء العمل العاملية على نطاق واسع. أما Argon فيمثل الطرف المتقدم من حزمة Google، مع أولوية للعمق والتنفيذ المستدام.
مواصفات النموذج
| المواصفة | Gemini 4 Argon |
|---|---|
| المطوّر | Google DeepMind |
| تاريخ الإعلان | 30 سبتمبر 2026 |
| عائلة النموذج | Gemini 4 |
| التموضع | نموذج استدلال متقدّم وأفق طويل |
| الحد الأقصى للإخراج | 1,000,000 رمز |
| تقييم السياق الطويل | مُختبر حتى 256K–1M على GraphWalks |
| حد سياق الإدخال العام | غير محدد رسميًا في جدول مواصفات API عامة عند الإطلاق |
| الفهم متعدد الوسائط | نعم؛ يشمل الرسوم البيانية والمستندات وتقييم الفيديو الطويل |
| الترميز العاملِي | نعم |
| استخدام الحاسوب | مُقيّم |
| الأمن السيبراني | قدرات دفاعية متخصصة |
| معرّف نموذج API العام من Google | غير مُعلن في وثائق Google العامة الأولية؛ تستخدم CometAPI المعرف gemini-4-argon في كتالوجها. |
ميزانية الإخراج والمقايضات
تعلن Google عن حد أقصى للإخراج يبلغ مليون رمز لـ Argon، ارتفاعًا من حد 64K المذكور في إعلان الإطلاق. يمنح هذا حيّزًا أكبر لمسارات الاستدلال الأطول. ولا ينبغي تفسيره كميزانية مضمونة لجلسة وكيل متعددة النداءات بالكامل، أو كدليل على أن كل مهمة ستتحسن.
الحد الأقصى للإخراج ليس مرادفًا للذكاء. منح النموذج مزيدًا من رموز الإخراج لا يجعله أكثر قدرة تلقائيًا؛ بل يزيل عنق زجاجة محتملًا. لا بد أن يستخدم النموذج هذه الميزانية بفاعلية.
هناك أيضًا مقايضة التكلفة والزمن. النموذج الذي يستهلك فعليًا مئات الآلاف من الرموز المُولَّدة قد يكون مكلفًا وبطيئًا حتى عندما يبدو السعر الاسمي لكل رمز جذابًا.

تمت إعادة إنتاج نتائج معيارية مختارة من المقال. قارن النماذج ضمن كل صف؛ تختلف المقاييس وظروف التقييم. يستبدل هذا المخطط العمل الفني التزييني المتدرج ولا يمثل اختبارًا مستقلاً.
يصف حد الإخراج الأقصى ونوافذ سياق الإدخال قدرات مختلفة. نطاق تقييم GraphWalks دليل يتعلق بالمدخلات المختبرة، وليس بديلًا عن مواصفة API عامة.
كيف يؤدي Gemini 4 Argon على المعايير؟
يغطي جدول أداء Google DeepMind سير عمل العوامل وأعمال المعرفة المهنية والمهام متعددة الوسائط. القيم أدناه تعيد إنتاج تلك المقارنة المنشورة. إنها تقيس أداء المهام، لا إنتاجية الرموز أو زمن الاستجابة؛ يشير الرمز "—" إلى عدم الإبلاغ عن نتيجة في هذه المقارنة.
| المعيار | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | ظروف التقييم |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | مجموعة خاصة؛ لوحة Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness؛ مصادر مختلطة |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI leaderboard |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | اختبار ذاتي / لوحة المتصدرين |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1؛ OpenCode؛ 10h؛ بطاقة H100 واحدة |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | أدوات Linux؛ الإنترنت |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | قائمة Surge |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1؛ 650 عنصرًا |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1؛ 200 عنصرًا |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | اجتياز ثنائي؛ ALE-Claw؛ 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | نتيجة جزئية دون اتصال؛ أفضل 3 تشغيلات |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | بدون أدوات؛ قائمة Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | بدون أدوات؛ أخذ عينات إطارات خاص بالنموذج |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1؛ pass@4 يكسر التعادلات |
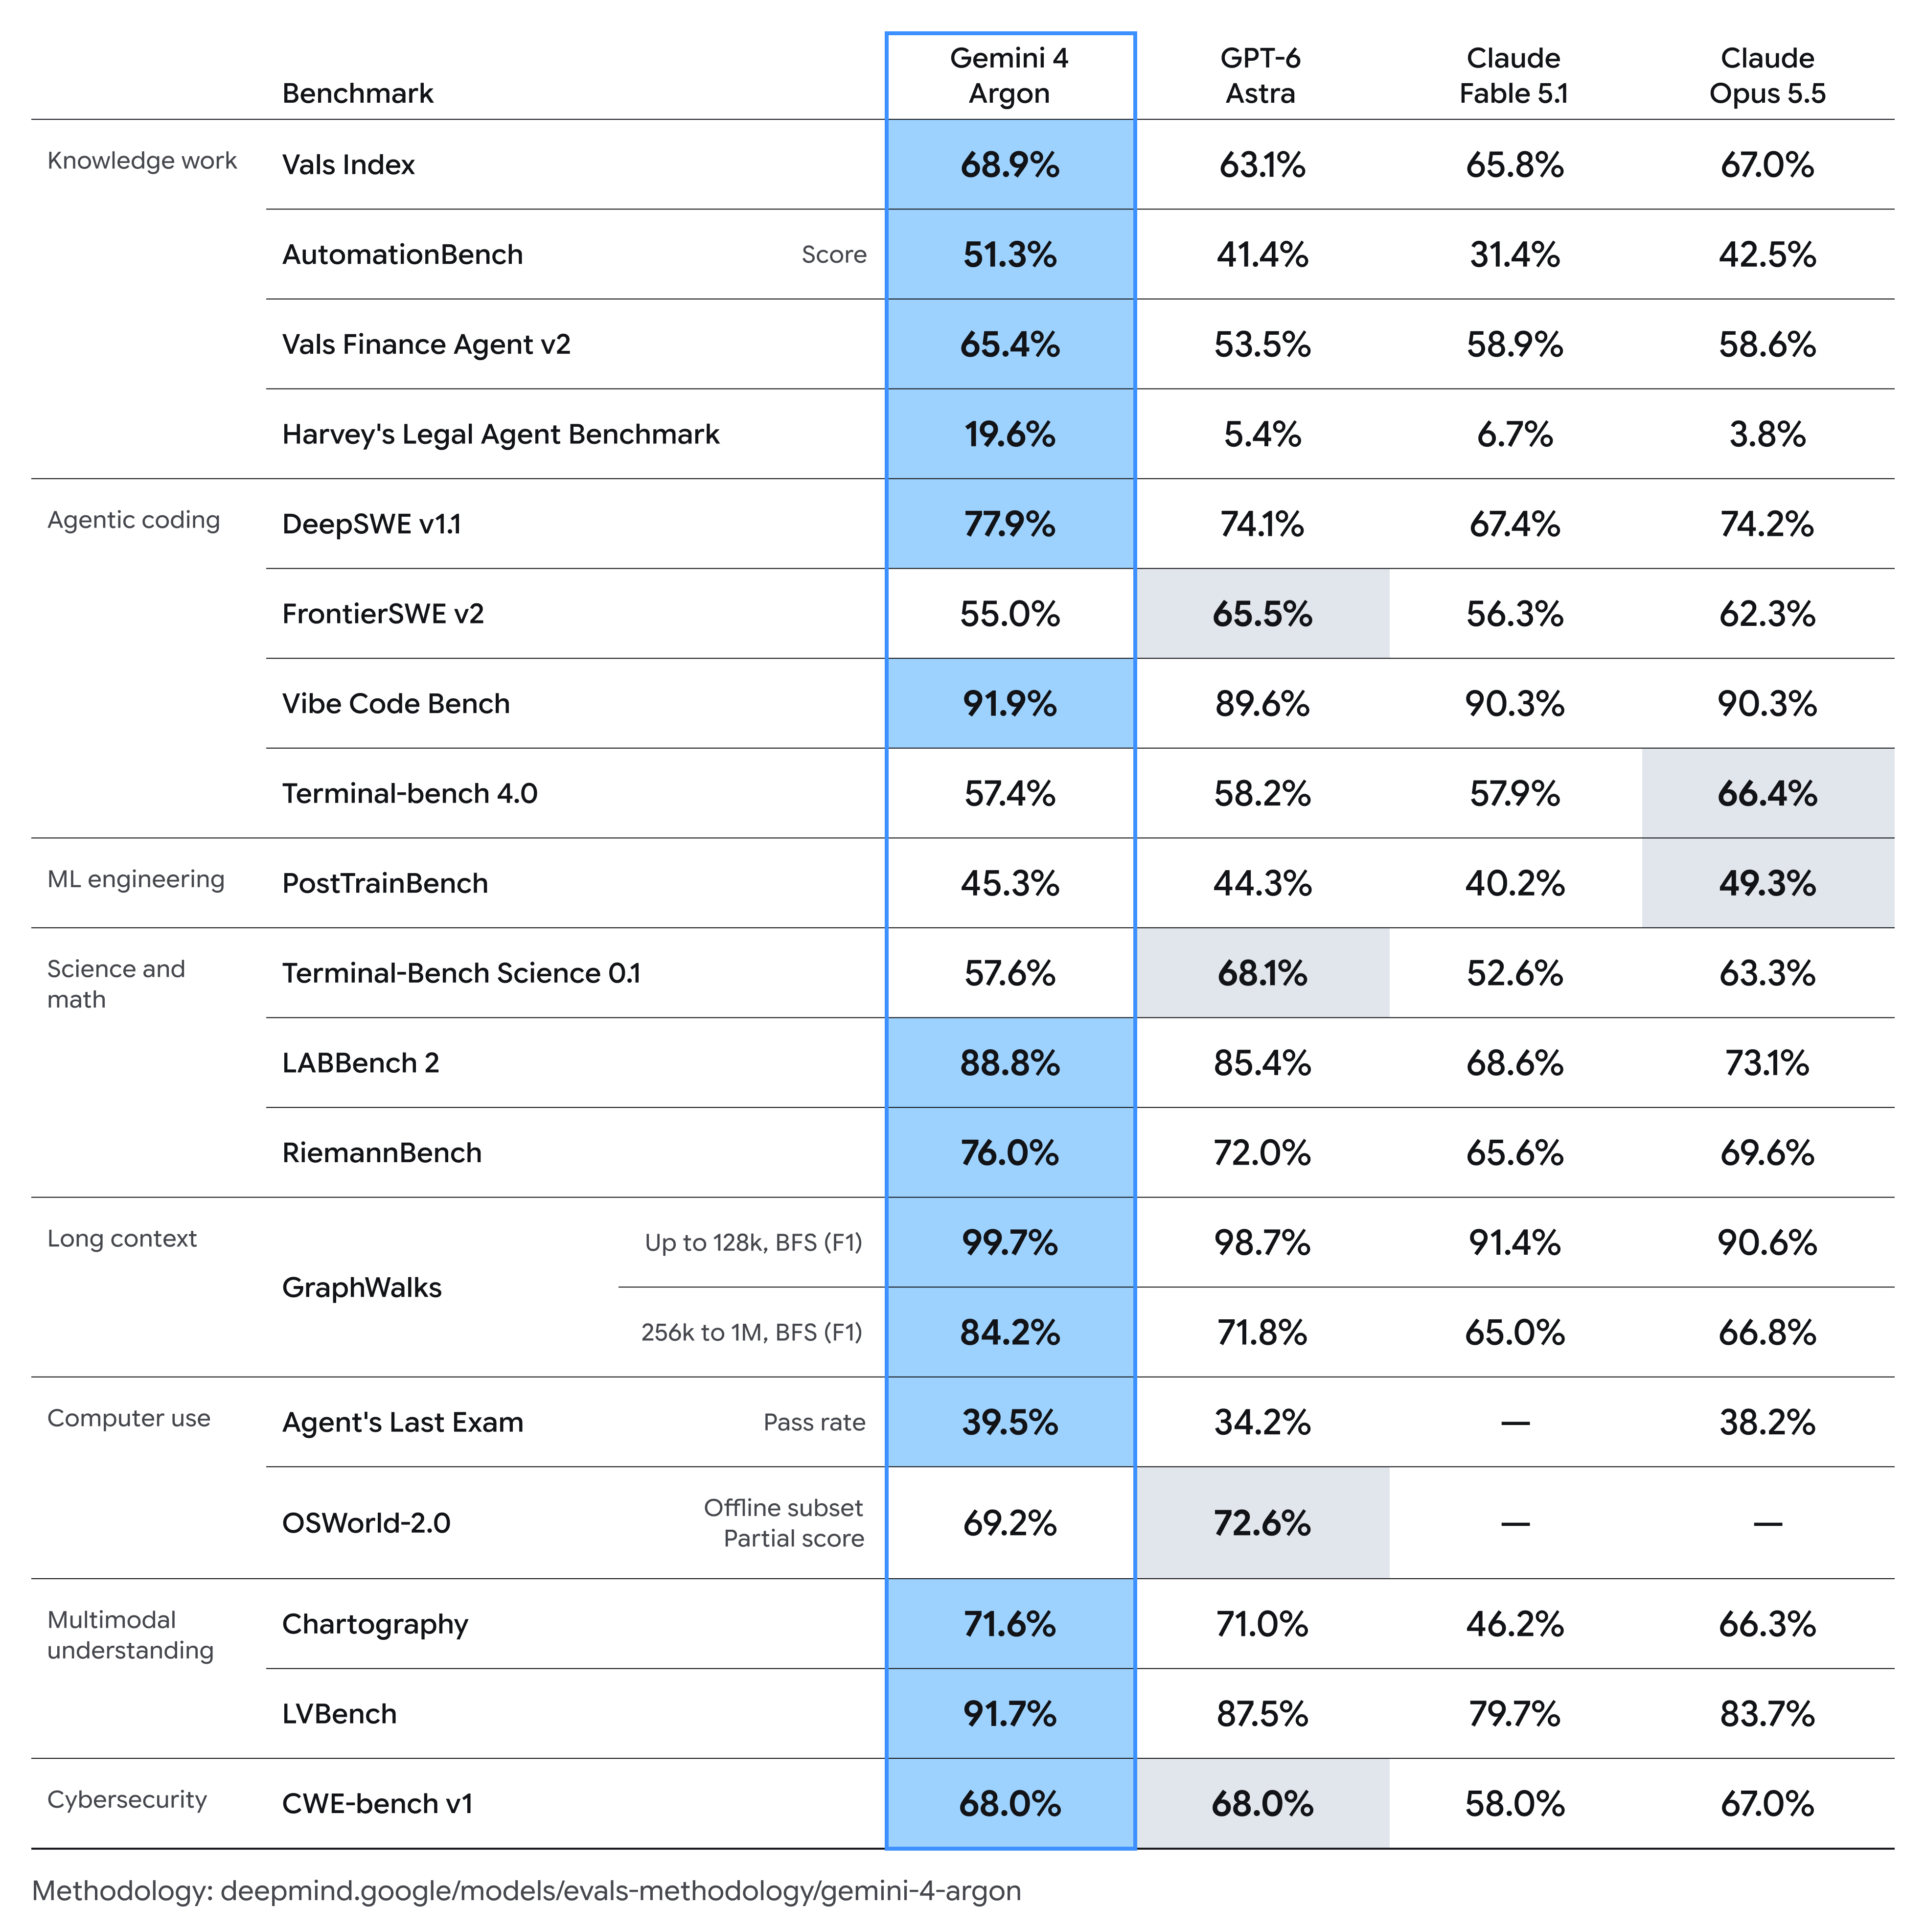
المقارنة الرسمية لمعايير Gemini 4 Argon من Google
ما لم يُذكر خلاف ذلك، تستخدم نتائج Argon محاولة واحدة وأعلى إعداد للتفكير. تأتي نتائج النماذج الأخرى عمومًا من تقارير المزودين، مع استثناءات خاصة بالمعيار. يستخدم LVBench معدل 1 FPS لـ Gemini، و800 إطار لـ GPT-6 Astra، و300 لـ Fable 5.1، و600 لـ Opus 5.5. هذه المدخلات ليست متطابقة، لذا قارن التكوينات المعلنة بدلًا من التعامل مع كل صف كإعادة تشغيل مضبوطة.
ظروف التقييم والقيود
الجدول مفيد، لكنه لا ينبغي تفسيره كلوحة صدارة عالمية مستقلة.
- اختيار المعايير هو اختيار Google.
- تختلف إعدادات التقييم الخاصة بكل معيار عبر الصفوف، بما في ذلك أطر العوامل، وميزانيات الوقت، والأدوات، وأخذ عينات الإدخال.
- تحدد المنهجية الرسمية نتائج المنافسين المُبلّغ عنها من المزودين كافتراض، مع استثناءات خاصة بلوحات المتصدرين وحسابات ذاتية.
- قد لا يعكس أعلى إعداد للمعيار تهيئة استدلال إنتاجية افتراضية.
- لا تكشف الدرجة الرئيسية وحدها عن استخدام الرموز، أو استدعاءات الأدوات، أو المحاولات، أو الوقت المنقضي، أو التدخل البشري.
لأنظمة الإنتاج، يكون المقياس الأفضل غالبًا هو التكلفة لكل مهمة مكتملة بنجاح وليس السعر لكل رمز أو نسبة معيار واحدة.
لأي عبء عمل يُعد Gemini 4 Argon الأفضل؟
أداء أعمال المعرفة
أوضح نمط في نتائج Argon يظهر في أعمال المعرفة المهنية متعددة الخطوات.
على Vals Index، يصل Argon إلى 68.9%، مقارنة بـ 67.0% لـ Claude Opus 5.5. الفجوة العددية متواضعة، لكن النمط يصبح أوضح في سير عمل متخصصة.
- Vals Finance Agent v2: نسبة 65.4%، أعلى بـ 6.5 نقاط من أقوى منافس مذكور في جدول Google.
- AutomationBench: نسبة 51.3%، أعلى بـ 8.8 نقاط من Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: نسبة 19.6%، مقارنة بـ 6.7% للنموذج التالي الأعلى المبلغ عنه.
تشير صورة الأداء إلى أن Argon يستفيد أكثر عندما يتعين على النموذج جمع المعلومات، والحفاظ على الحالة، والاستدلال عبر عدة مراحل، وإنتاج مُخرَج مهني بدلًا من مجرد الإجابة على سؤال مغلق.
كما أن انخفاض الدرجة المطلقة لوكيل القانون مهم أيضًا. رقم 19.6% وحده لا يكشف كم من المعايير أو سير العمل الكاملة قد فشل. الاستنتاج المفيد هو أن Argon يُظهر تحسنًا نسبيًا كبيرًا على هذا التقييم، بينما لا تُثبت النتيجة أتمتة موثوقة للعمل القانوني.
الاستدلال بسياق طويل
قد تكون أفضل مزية لافتة لArgon هي نسخة 256K–1M من GraphWalks.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
هذه أفضلية بمقدار 12.4 نقطة على أقرب نموذج في المقارنة المنشورة.
الفجوة أصغر بكثير عند أطوال سياق أقصر: على GraphWalks حتى 128K، يسجل Argon نسبة 99.7% ويسجل GPT-6 Astra نسبة 98.7%. يشير ذلك إلى أن Argon يتدهور بدرجة أقل حدة من النماذج المُقارنة على هذا التقييم المحدد للسياق الطويل جدًا.
لم تكشف Google عن معلومات معمارية كافية لإرجاع هذا الاختلاف إلى آلية انتباه محددة أو نظام استرجاع أو وصفة تدريب أو استراتيجية وقت الاستدلال. لذلك فإن ادعاءات مثل "Gemini 4 يقدم بنية انتباه جديدة" ستتجاوز الأدلة العامة.
أداء الترميز
الجدول الرسمي للمعايير لا يدعم إجابة بسيطة بنعم.
يؤدي Argon أداءً ممتازًا في بعض أشكال الترميز ويتراجع بوضوح في أخرى. على DeepSWE v1.1 يصل إلى 77.9%، مقارنة بـ 74.2% لـ Claude Opus 5.5 و74.1% لـ GPT-6 Astra. درجته على Vibe Code Bench قوية أيضًا عند 91.9%.
- FrontierSWE v2: 55.0% لـ Argon مقابل 65.5% لـ GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% لـ Argon مقابل 66.4% لـ Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% لـ Argon مقابل 68.1% لـ GPT-6 Astra.
هذا الانقسام مهم للمطورين. يبدو أن Argon قوي بشكل خاص عندما يصبح الترميز سير عمل هندسيًا طويلًا مع سياق كبير وتخطيط، بينما يظل التنفيذ المعتمد على الطرفية أكثر تنافسية. لا ينبغي التعامل مع معيار ترحيل مستودع ومعيار طرفية تفاعلي كمقاييس قابلة للاستبدال لـ "قدرة الترميز".
الأمن السيبراني الدفاعي
الأمن السيبراني مجال نشر أساسي. تتضمن وضعية Google للأمن السيبراني الدفاعي اكتشاف الثغرات بشكل مستقل، والتحقق منها وتصحيحها. هذا ادعاء قدرة من المزود؛ تقيس نتيجة CWE-bench أدناه معالجة الثغرات في تقييمه الخاص.
على CWE-bench v1، يسجل Argon نسبة 68%، بالتساوي مع GPT-6 Astra وبفارق طفيف عن Claude Opus 5.5 عند 67%.
تسلط Google الضوء أيضًا على ضوابط أقوى ضد سوء الاستخدام، والحقن غير المباشر للمحفز، وسلوك العوامل الخطِر، واختراق بيئة التنفيذ. لذا يُعد Argon إصدار أمان للعوامل بقدر ما هو ترقية نموذج تقليدية.
الفهم متعدد الوسائط
يسجل Argon نسبة 71.6% على Chartography و91.7% على LVBench لفهم الفيديو الطويل. نتيجة LVBench أعلى بـ 4.2 نقاط مئوية من GPT-6 Astra في جدول Google. وبما أن النماذج تتلقى تكوينات مختلفة لأخذ عينات الإطارات، فهذه مقارنة لإعدادات مُبلغ عنها بدلًا من أفضلية صِرف للنموذج.
هذا مهم لأن الكثير من سير العمل المهني ليس نصيًا فقط. قد يحتاج وكيل أبحاث مالية إلى تفحص رسم بياني؛ وقد يجمع مساعد مؤسسي بين تقارير وملفات PDF ولقطات شاشة؛ وقد تحتاج منظومة تحليل فيديو إلى الحفاظ على الأحداث عبر تسلسل طويل بدلًا من معالجة الإطارات بشكل مستقل.
لذلك فإن مزيج Argon من الإدراك متعدد الوسائط والاستدلال المستدام أكثر صلة من دعم تعدد الوسائط وحده.
أداء العلوم والرياضيات
النتائج مختلطة لكن عامةً قوية. يصل Argon إلى 88.8% على LABBench 2 و76.0% على RiemannBench، متقدمًا على النماذج المقارنة في جدول Google. ومع ذلك، على Terminal-Bench Science 0.1، يصل GPT-6 Astra إلى 68.1% مقارنة بـ 57.6% لـ Argon.
يشير هذا الاختلاف إلى نمط أوسع: يبدو Argon أقوى في الاستدلال على المعلومات العلمية منه في كل أشكال التنفيذ العلمي المدفوع بالأدوات.
أداء استخدام الحاسوب
على Agent's Last Exam، يسجل Argon معدل اجتياز ثنائي 39.5%، متقدمًا على GPT-6 Astra عند 34.2% وClaude Opus 5.5 عند 38.2%. وعلى المجموعة دون اتصال من OSWorld-2.0، تكون نتيجته الجزئية 69.2%، أدنى من 72.6% لـ GPT-6 Astra. قيمة OSWorld ليست معدل نجاح كامل المهمة، والنتائج المفقودة لـ Claude لا تعني انعدام القدرة.
لذا لا تُظهر البيانات الحالية أفضلية شاملة في استخدام الحاسوب. للنشر الإنتاجي، ينبغي دعم درجات المعايير باختبارات على مستوى المهمة حول دقة التنقل، والنقرات الفاشلة، وتكرار المحاولة، والإجراءات غير المقصودة، ووقت الإكمال، ومعدل التصحيح البشري.
مقارنة Gemini 4 Argon مع GPT-6 Astra وClaude
| البعد | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| أعمال المعرفة | قوي جدًا | قوي | قوي جدًا | قوي |
| معيار السياق الطويل | أقوى نتيجة منشورة | قوي | متوسط–قوي | متوسط |
| الترميز طويل الأفق | قوي جدًا | قوي جدًا | قوي جدًا | قوي |
| ترميز الطرفية | تنافسي | قوي | الأقوى في اختبار محدد | تنافسي |
| وكلاء الطرفية العلمية | تنافسي | الأقوى في اختبار محدد | قوي | تنافسي |
| الفهم متعدد الوسائط | قوي جدًا | قوي جدًا | قوي | تنافسي |
| استخدام الحاسوب | تنافسي | قوي | مختلط / مقارنة محدودة | مقارنة محدودة |
| الأمن السيبراني | متعادل في القمة على CWE-bench v1 | متعادل في القمة | قريب جدًا | أدنى |
يبرز Argon في هذه المقارنة في المهام ذات السياق الطويل، والغنية بالمستندات، وأعمال العوامل المهنية. يمكن للمطورين مقارنته مع GPT-6 Astra، وClaude Opus 5.5 وClaude Fable 5.1 عبر CometAPI.
اختيار قائم على الأداء
تلخّص التصنيفات النوعية أعلاه الجدول المحدد للمعايير، لا ترتيبًا عالميًا. فضّل Argon للتجربة عندما يشبه العمل تقييماته الرائدة؛ اختبر Astra وOpus في أعباء العمل الثقيلة على الطرفية قبل اختيار الافتراضي.
المواصفات وقيود النشر
لا تُثبت هذه المقارنة المعمارية ميزة ولا فائزًا عامًا في السعر مقابل الأداء. لم يُذكر عدد المعاملات ولا المعمارية لـ Argon في المواد المنشورة لإطلاق Google. يتطلب حد سياق الإدخال العام وثائق API رسمية. تفيد CometAPI بمسار gemini-4-argon؛ أكد معلماته المدعومة ووصول الحساب بشكل مستقل عن طرح Google الأوسع. قارن حدود كل مسار وتكاليف المهام الفعلية قبل النشر.
كيف يمكن للمطورين الوصول إلى Gemini 4 Argon عبر CometAPI؟
تفيد CometAPI بأن النموذج متاح تحت gemini-4-argon. استخدم لوحة التحكم لإنشاء مفتاح API، واختر هذا المعرف في البيئة التجريبية، ونفّذ طلب اختبار قبل التكامل. يستخدم المثال المتوافق مع OpenAI عنوان الأساس https://api.cometapi.com/v1. أكد نقطة النهاية والمعلمات المدعومة في وثائق الحساب؛ فشارات الكتالوج وحدها لا تؤكد نجاح الاستدعاء.
- أنشئ حساب CometAPI وولّد مفتاح API في لوحة التحكم.
- اختر gemini-4-argon وتحقق من طلب ممثل في البيئة التجريبية.
- هيّئ العميل المتوافق بعنوان أساس CometAPI، ومفتاحك، ومعرّف النموذج؛ وأكد مخطط الطلب والفوترة قبل النشر.
CometAPI والأسعار الرسمية
أعلنت Google أسعارًا تقديمية بقيمة 2$ لكل مليون رمز إدخال و10$ لكل مليون رمز إخراج، مع تسعير المُدخلات المُخزَّنة مؤقتًا بخصم 95% من سعر الإدخال. بعد الفترة التعريفية، تكون الأسعار المعلنة 4$ للإدخال و20$ للإخراج لكل مليون رمز. هذه أسعار Google المعلنة، وليست أسعار CometAPI أو تأكيدًا على وصول API عام فوري.
| أساس الفوترة | Gemini 4 Argon API في CometAPI | إعلان Google الرسمي | المقارنة |
|---|---|---|---|
| الإدخال / 1M رمز | 3.20$ | 4.00$ بعد الفترة التعريفية | أقل بنسبة 20% من السعر بعد التعريفي |
| الإخراج / 1M رمز | 16.00$ | 20.00$ بعد الفترة التعريفية | أقل بنسبة 20% من السعر بعد التعريفي |
الخلاصة
ملف Argon المعياري أكثر إثارة للاهتمام من مجرد ادعاء على لوحة الصدارة.
تتجمّع أقوى النتائج في هذه المقارنة حول أعمال المعرفة المهنية، والسياق الطويل، والتنفيذ المستدام للعوامل. هذا النمط مفيد لاختيار عبء العمل، لكنه لا يحدد المعمارية الأساسية ولا يثبت الآلية التي تسببت في المكاسب.
تدعم النتائج المُعلن عنها في المالية والقانون والفيديو الطويل وهندسة البرمجيات تجربة مركّزة لتلك الأعباء. ما إذا كانت الأفضلية نفسها تستمر في الإنتاج يعتمد على مزيج المدخلات، وإطار العامل، وإعدادات الاستدلال، ومتطلبات التحقق.
في الوقت نفسه، تُظهر النتائج أن أداء النماذج المتقدمة أصبح أكثر تخصصًا. يمكن لـ Argon أن يتصدر DeepSWE بينما يتراجع على FrontierSWE؛ ويتصدر Agent's Last Exam بينما يتراجع على OSWorld؛ ويتصدر LABBench بينما يتراجع على Terminal-Bench Science. تُجهد هذه المعايير أجزاء مختلفة من نظام العامل.
بالنسبة للمطورين، الدرس الأهم هو أن اختيار النموذج increasingly needs to happen على مستوى عبء العمل بدلًا من العلامة التجارية أو العائلة.
الأسئلة الشائعة
كيف ينبغي للمطورين التحقق من Gemini 4 Argon على أعباء عملهم الخاصة؟
ابنِ مجموعة مهام ممثلة مع معايير قبول صريحة. حافظ على تشابه الأدوات والحدود الزمنية وإعداد الإدخال وسياسات إعادة المحاولة عبر النماذج. سجّل المهام المكتملة، وإجمالي الرموز، والوقت المنقضي، والتصحيح البشري. ابدأ بتجربة صغيرة وافحص حالات الفشل قبل توجيه حركة الإنتاج.
هل يمكن متوسط نسب معايير Gemini 4 Argon إلى درجة واحدة؟
لا. يجمع الجدول بين مقاييس مختلفة، بما في ذلك F1، ومعدلات الاجتياز، والنتائج الجزئية. استخدم معايير خاصة بالمهمة بدلًا من متوسط جميع النسب.
هل ينبغي لوكيل Gemini 4 Argon دائمًا استخدام ميزانيته الكاملة للإخراج؟
لا. اختر أصغر ميزانية مجربة تلبي متطلباتك من الجودة والموثوقية. الحد الأقصى للإخراج سقفٌ لا هدف.
كيف ينبغي للفرق تقييم الوصول إلى Gemini 4 Argon عبر CometAPI؟
ابدأ بفحص التوفر على مستوى الحساب وطلب صغير باستخدام مسار CometAPI الموثّق. قِس جودة الاستجابة، والزمن، والحدود، والرموز المفوترة، ثم طبّق نفس اختبارات القبول المستخدمة للنماذج البديلة. تعامل مع ادعاء الوصول عبر CometAPI بمعزل عن طرح Google الأوسع، وحافظ على قابلية تهيئة التوجيه حتى يلبي المسار متطلباتك.