بات تشغيل Qwen3.8-Max محليًا ممكنًا الآن، لكن عبارة "Qwen 3.8 Max محليًا" تحتاج إلى توضيح مهم. منتج Max المُستضاف من Alibaba ونقطة التحقق القابلة للتنزيل مرتبطان ارتباطًا وثيقًا، ولكنهما ليسا منتجًا واحدًا متطابقًا.
أطلقت Qwen خدمة Max المُستضافة لأول مرة في أوائل أغسطس 2026، وأصدرت Qwen3.8-2.4T-A95B كأوزان مفتوحة في 12 أغسطس 2026. تلك نقطة التحقق هي النموذج الذي تقوم فعليًا بنشره على بنيتك التحتية الخاصة.
هذا ليس دليل Ollama عاديًا على حاسوب ألعاب. نقطة التحقق غير المُكَمَّمة هي نموذج مزيج خبراء (MoE) بعدد 2.4 تريليون معلمة، وتُقدِّر وصفة vLLM الحالية حجم أوزان BF16 له بـ 4.45 TiB. وحتى المتغيرات الإنتاجية من الفاصلة العائمة ذات 4-بت لا تزال تشغل تقريبًا 1.3–1.5 TiB من الأوزان.
الإجابة السريعة: الاستضافة الذاتية الكاملة لفئة Qwen 3.8 Max هي نشر على مستوى مركز بيانات. نقطة بداية إنتاجية عملية هي ؛ تتطلب نشرات H200 عددًا أكبر من وحدات GPU. وللمحطات العمل العادية، استخدم Qwen3.8-27B بدلًا من ذلك.
Qwen 3.8 Max مقابل النموذج المفتوح الذي تنشره فعليًا
تُوصَف نقطة التحقق القابلة للتنزيل Qwen3.8-2.4T-A95B رسميًا بأنها نموذج لغة سببي بعدد 2.4T من المعلمات مع تفعيل يقارب 95B معلمة لكل رمز. تضيف خدمة Max المُستضافة قدرات على طبقة المنتج غير موجودة في نقطة التحقق المفتوحة الحالية.
المواصفة
خدمة Qwen3.8-Max المستضافة
نقطة التحقق المفتوحة Qwen3.8-2.4T-A95B
إجمالي المعلمات
2.4T
2.4T
المعلمات النشطة
~95B
~95B
البنية المعمارية
MoE متفرق
MoE متفرق
الإدخال
نص، صورة، فيديو
نص
السياق
سياق مُدار 1M
262,144 أصلي؛ قابل للتمديد إلى ~1.01M
سلوك التفكير
تفكير مُدار / خيارات بلا تفكير
التفكير مطلوب؛ جهد الاستدلال قابل للضبط
الأدوات المدمجة
متاحة على الخدمة المُدارة
يجب أن توفِّرها التطبيق
الاستضافة الذاتية
لا حاجة لإدارة الأوزان
نعم؛ نقطة تحقق مفتوحة
يكشف المنتج المُستضاف عن إدخال نص وصورة وفيديو مع سياق من 1,000,000 رمز. بالمقابل، نقطة التحقق المفتوحة تدعم النص فقط وسياقها الأصلي 262,144 رمزًا. يهم هذا الفرق إذا كان تطبيقك يعتمد على الإدخال متعدد الوسائط أو الأدوات المدمجة المُدارة.
بنية Qwen 3.8 والمواصفات
تغطي CometAPI بالفعل خلفية النموذج في What is Qwen3.8 Max، لذا يُركّز هذا الدليل الخاص بالنشر على التفاصيل المؤثرة في الذاكرة والتوازي والتقديم.
لا تُفسِّر "95B من المعلمات النشطة" على أنها بصمة ذاكرة نموذج 95B. يقلل التفعيل المتناثر من الحوسبة لكل رمز، لكن نظام التقديم لا يزال بحاجة إلى الوصول إلى مجموعة أوزان الخبراء كاملة.
لقطة معيارية لـ Qwen 3.8 Max
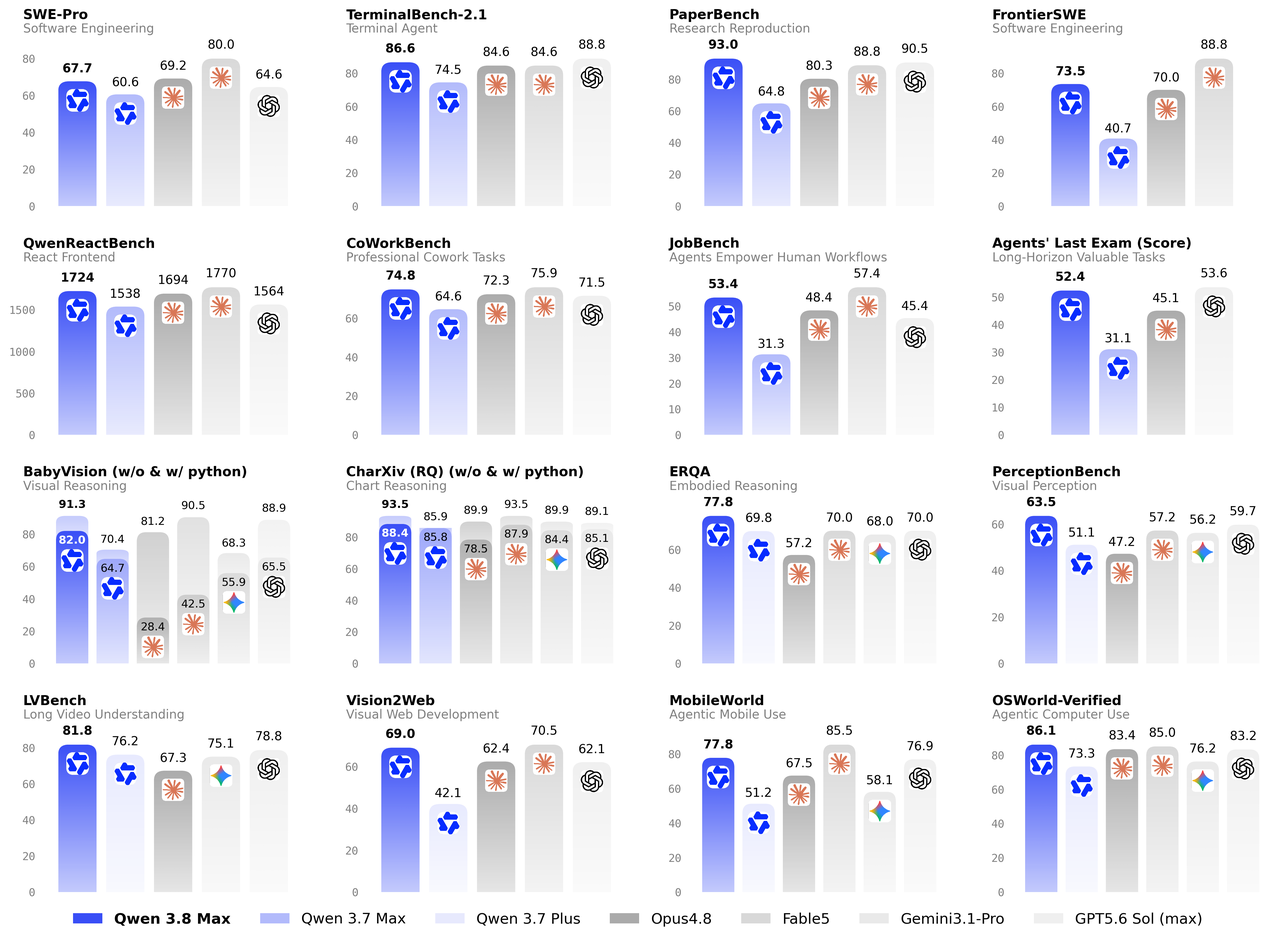
بما أن نظرة Qwen3.8 Max على CometAPI تغطي المعايير بالتفصيل، يستخدم هذا المقال فقط مجموعة فرعية مرتبطة بالنشر من جدول معايير بطاقة نموذج Qwen الرسمية.
أكبر المكاسب المُبلّغ عنها مقارنة بـ Qwen3.7-Max ضمن هذه المجموعة الفرعية هي PaperBench وFrontierSWE. كما يتفوّق Qwen3.8-Max على GPT-5.6 Sol في SWE-bench Pro وPaperBench، بينما يظل GPT-5.6 Sol متقدمًا في Terminal Bench 2.1. لاستخدام النشر، اعتبر هذه سياق قدرات؛ أما قياسات الذاكرة وإنتاجية التقديم أدناه فهي أكثر صلةً تشغيليًا.
جداول المعايير ليست تصنيفات شاملة. يمكن لأطر الاختبار، والمهل الزمنية، وحدود السياق، والوصول إلى الأدوات، والتكميم أن تغيّر النتائج. قم بقياس نقطة التحقق والدقة ومحرك التقديم وتوزيع المطالبات المحددة التي تخطط لاستخدامها.
ما العتاد الذي يحتاجه Qwen3.8 للنشر المحلي؟
متطلبات GPU لنقطة التحقق Qwen3.8-2.4T-A95B
هذا هو سؤال النشر الأساسي. تنشر وصفة vLLM الحالية لـ Qwen3.8 بصمات نقاط التحقق وأعداد وحدات GPU الواقعية مع فسحة تشغيلية، وهو ما يفيد أكثر من تقدير VRAM من عدد المعلمات فقط.
الدقة
بصمة الأوزان
B300 (268 GB)
MI355X (288 GB)
H200 (141 GB)
أفضل ملاءمة
BF16
4.45 TiB
24 GPU
24 GPU
48 GPU
أعلى وفاء/بحث
FP8
2.27 TiB
16 GPU
16 GPU
32 GPU
إنتاجية عالية الدقة
MXFP4
1.45 TiB
—
8 GPU
16 GPU
نشر عملي على AMD
NVFP4 W4A4
1.32 TiB
8 GPU
—
16 GPU
نشر عملي على NVIDIA
بالنسبة لمعظم المؤسسات التي تحتاج حقًا إلى استضافة Qwen3.8 ذاتيًا، تُعد FP4 نقطة البداية العملية. التكوين الأبرز على NVIDIA هو NVFP4 W4A4 على 8× B300؛ والمسار المقابل على AMD هو MXFP4 على 8× MI355X.
خادم H200 بعدد 8 وحدات GPU غير كافٍ لهذه النشرات الكاملة الموصى بها. تُقدّر الوصفة الرسمية H200 بـ 16 GPU لِـ FP4، و32 لِـ FP8، و48 لِـ BF16.
متطلبات VRAM لـ Qwen3.8-27B
يُعد Qwen3.8-27B البديل العملي لفئة محطات العمل. ذاكرة الأوزان الخام تبلغ تقريبًا 54 GB في BF16، و27 GB في FP8، و13.5 GB عند دقة 4-بت. يزيد الحمل التشغيلي وذاكرة KV المؤقتة من المتطلبات الفعلية، خاصة عند أطوال سياق طويلة.
الدقة
ذاكرة الأوزان التقريبية
إرشادات نشر عملية
BF16
~54 GB
استخدم GPU بسعة 64–80 GB، حسب السياق والحمل التشغيلي.
FP8/INT8
~27 GB
يمنح GPU بسعة 40–48 GB فسحة تشغيلية أكثر عملية.
4-بت
~13.5 GB
يمكن أن يكون GPU استهلاكي بسعة 20–24 GB صالحًا عند سياقات متوسطة.
هذه الأرقام تقديرات تخطيطية مشتقة من عدد المعلمات. أكّد نقطة التحقق الدقيقة، وصيغة التكميم، ومحرك التقديم، وطول السياق، وإعدادات ذاكرة KV قبل تحديد حجم عتاد الإنتاج.
هل يمكن تشغيل Qwen3.8 على وحدات GPU الاستهلاكية؟
النموذج الكامل Qwen3.8-2.4T-A95B غير عملي على وحدات GPU الاستهلاكية العادية، حتى مع التكميم العدواني. أظهر مشروع مجتمعي بناءً مضغوطًا بشدة بحجم 397 GB بصيغة UD-Q1_0 عبر أربعة أنظمة DGX Spark، لكن هذا المسار تكميم تجريبي شديد وليس خط الأساس لتقديم حساس للجودة.
للمحطة العمل أو المختبر المنزلي، النموذج الأنسب هو Qwen3.8-27B، الذي أُطلقت أوزانه المفتوحة في 14 أغسطس 2026. هذا النموذج أسهل بعدة مراتب في الاستضافة وهو الخيار الصحيح إذا كان "محلي" يعني محطة عمل واحدة لا عنقود GPU.
قبل تثبيت Qwen 3.8 Max
اخطط للبنية التحتية قبل تشغيل أمر التثبيت. ستحتاج إلى Linux، وتكديس مسرّعات متوافق، ومساحة تخزين محلية أو مشتركة كافية لنقطة التحقق، وروابط GPU عالية النطاق الترددي، وعند العبور بين عقد، إلى شبكة مُصمَّمة للاستدلال الموزع. توصي وصفة vLLM حاليًا بـ vLLM nightly وTransformers 5.4.0 أو الأحدث.
FP8 اختيار معقول عندما ترغب في نقطة تحقق مقدمة من Qwen ويمكنك تحمّل بنية متعددة العقد. نقطة التحقق الرسمية هي Qwen/Qwen3.8-2.4T-A95B-FP8.
لنشر من عقدتين و16 GPU من فئة B300، شغّل العقدة الرأسية بـ:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
يُعد بناء NVFP4 من Inferact نقطة تحقق مُكمَّمة وليست قطعة Qwen الأصلية بصيغة BF16. تحقّق من جودة النموذج على مجموعة قبولك الخاصة قبل اعتباره بديلاً مباشرًا لـ BF16 أو FP8.
كيفية نشر Qwen 3.8 باستخدام SGLang
أضافت SGLang دعم اليوم-0 لـ Qwen3.8 في 12 أغسطس وهي جذابة خصوصًا للتقديم عالي الإنتاجية، والتخزين المسبق للبدايات (prefix caching)، والتوازي بين الخبراء، وفك الترميز التخميني، وفصل مرحلتي prefill/decode.
تذكر SGLang 346 رمزًا/ث للإخراج عند حجم دفعة 1 على TP8 B300 مع MTP، وإنتاجية كلية أعلى بكثير في مخططات التقديم المُفككة. اعتبر هذه أرقام طبقة التقديم، لا مقاييس جودة النموذج.
اختبار نقطة النهاية المحلية المتوافقة مع OpenAI
يوفّر كل من vLLM وSGLang واجهات API متوافقة مع OpenAI، مما يجعل التكامل مع التطبيقات مباشرًا.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
توصي بطاقة النموذج الرسمية بالقيم temperature=1.0 وtop_p=0.95 وtop_k=20 كمعايير أخذ عينات أساسية. لأعمال الوكلاء، اترك ميزانية إخراج كافية للتفكير بدلًا من تحديد max_tokens لإجابة نهائية مرئية فقط.
تمكين نافذة سياق 1M
تملك نقطة التحقق المفتوحة Qwen3.8-2.4T-A95B سياقًا أصليًا بطول 262,144 رمزًا ويمكن توسيعه إلى نحو 1.01M. توثّق وصفة vLLM النمط التالي:
لا تجعل 1M الإعداد الافتراضي لمجرد أنه مدعوم. فالسياقات القصوى الأكبر تحجز سعة أكبر لذاكرة التخزين المؤقت وقد تقلل بشكل حاد من التوازي. اضبط --max-model-len على عبء العمل الحقيقي.
كيف تحسّن أداء استدلال Qwen3.8؟
استخدم MTP-3 لتقليل الكمون لمستخدم واحد
يتضمن Qwen3.8 ميزة التنبؤ متعدد الرموز. في قياسات vLLM المنشورة، ينقل MTP-3 إنتاج المستخدم الواحد من 130 إلى 307 رمز/ث لـ FP8 TP16 ومن 133 إلى 304 رمز/ث لـ NVFP4 TP8.
استخدم التوازي بين الخبراء لزيادة الإنتاجية المتزامنة
للتوازي العالي، يستفيد Qwen3.8 من مخططات التوازي بين الخبراء لأنه يضم 512 خبيرًا موجّهًا. تُبلغ vLLM عن ما يصل إلى 3,200 رمز/ث/GPU لـ FP8 EP وحتى 4,300 رمز/ث/GPU لتكوين NVFP4 DEP16 المُحسَّن.
اضبط --max-model-len لتحقيق توازن بين VRAM والتوازي
اضبط قيمة --max-model-len على أطول تسلسل يحتاجه عبء العمل حقًا. القيمة الأكبر تحجز سعة أكبر故 لذاكرة KV المؤقتة، وتزيد الضغط على الذاكرة، وقد تقلل عدد الطلبات المتزامنة حتى عند ملاءمة أوزان النموذج للذاكرة.
ابدأ ببرسنتيل ممثّل للإنتاج بدلًا من الحد الأقصى المعلن لسياق النموذج. اختبر حدّك المختار تحت نفس الدقة ونمط الدُفعات ومحرك التقديم المستخدم في الإنتاج، ثم ارفعه فقط عندما تحتاج الطلبات الفعلية إلى سياق أكبر.
نشر Qwen 3.8 Max محليًا مقابل عبر API
الأوزان المفتوحة لا تجعل الاستدلال المحلي اقتصاديًا تلقائيًا. يعتمد القرار الصحيح على نسبة الاستفادة، وإقامة البيانات، والكوادر، وأهداف الإتاحة، وما إذا كنت تحتاج فعلًا إلى ميزات النموذج المُدار متعددة الوسائط.
البُعد
Qwen3.8-2.4T-A95B مُستضاف ذاتيًا
Qwen3.8-Max عبر CometAPI
البنية التحتية
خادم متعدد GPU أو عنقود
لا حاجة إلى بنية GPU
نمط الإدخال
نص
نص، صورة، فيديو
السياق
262K أصلي؛ ~1.01M موسَّع
1M مُدار
التحكم بالبيانات
أقصى حد
واجهة API سحابية
العمليات
أنت تملك المراقبة والترقيات والتوافر العالي
مُدارة من المزوّد
أفضل ملاءمة
إقامة بيانات، استفادة مستمرة، فريق بنية
معظم فرق التطبيقات والأعباء المتغيرة
إذا كنت تمتلك بالفعل مسرّعات مناسبة وتتمتع بنسبة استفادة مرتفعة باستمرار، يمكن تبرير الاستضافة الذاتية. أما إذا كنت ستشتري عنقودًا فقط لهذا النموذج، فـQwen3.8-Max على CometAPI عادةً ما يكون المسار الأقل احتكاكًا. يغطي دليل API الحالي التكامل المُستضاف، بينما يغطي دليل التسعير نمذجة الكلفة؛ لذا يظل هذا المقال مُركّزًا على النشر المحلي.
مشاكل شائعة في النشر المحلي لـ Qwen 3.8
ينفد خادمك من ذاكرة GPU أثناء بدء التشغيل
قم أولًا بتقليل --max-model-len إذا كانت المشكلة من ذاكرة التخزين المؤقت. إذا لم تكن الأوزان نفسها تلائم الذاكرة، فلن يحل تقليل السياق المشكلة الجذرية؛ انتقل إلى نقطة تحقق منخفضة الدقة مُثبتة أو أضف وحدات GPU.
يفشل التوازي الموضعي بسبب حجم غير صالح
يمتلك Qwen3.8 عدد 64 رأس انتباه في طبقاته ذات الانتباه الكامل، لذا يتطلب vLLM أن يقسم TP العدد 64. أحجام TP المباشرة هي 1 و2 و4 و8 و16 و32. لذلك فإن VRAM الإجمالية الخام ليست كافية لاختيار الطوبولوجيا.
يستغرق الخادم وقتًا طويلًا ليبدأ
يمكن أن يستغرق تحميل تيرابايت واحد إلى عدة تيرابايت من الأوزان بالإضافة إلى JIT للنوى عدة دقائق. زد قيمة VLLM_ENGINE_READY_TIMEOUT_S وافحص نقطة نهاية استدلال حقيقية بدلًا من افتراض نافذة بدء تشغيل قصيرة.
لا يستطيع النموذج المحلي معالجة صورة
هذا متوقع. نقطة التحقق المفتوحة Qwen3.8-2.4T-A95B نصية فقط. هذا القيد خاص بهذه النقطة. يدعم Qwen3.8-27B الإدخال المرئي عند تحميل ملفات الإسقاط البصري المنفصلة الخاصة به.
سياق 1M يقلل الإنتاجية بشكل حاد
قلّل --max-model-len إلى أطول تسلسل يحتاجه عبء عملك فعليًا. أكبر نافذة سياق مدعومة ليست بالضرورة أفضل إعداد إنتاجي؛ اختر حد سياق يوازن بين متطلبات عبء العمل واستخدام ذاكرة KV المؤقتة والتوازي.
هل يمكن لـ Ollama أو LM Studio تشغيل Qwen 3.8 Max؟
يمكن للنظام البيئي حزم أوزان Qwen3.8 المُكمَّمة بشدة لاستدلال بأسلوب llama.cpp، لكن لا ينبغي الخلط بين ذلك وبين سير عمل Ollama عادي على سطح المكتب. فبناء مُكمَّم يشغل مئات الجيجابايت لا يزال يتطلب مئات الجيجابايت من الذاكرة المتاحة وينطوي على مقايضات كبيرة في الجودة والأداء.
بالنسبة للتطوير المحلي العادي، الهدف المناسب هو Qwen3.8-27B. يجب التعامل مع النموذج الكامل 2.4T كنموذج خادم/عنقود حتى عندما تجعل كوانتات المجتمع القصوى تشغيله ممكنًا تقنيًا على عتاد غير معتاد.
أي طريقة نشر يجب أن تختار؟
بالنسبة إلى NVIDIA Blackwell، يُعد نشر NVFP4 على 8× B300 حاليًا أنظف نقطة انطلاق للنموذج الكامل. وعلى AMD، يُعد 8× MI355X مع MXFP4 التكوين العملي المقابل. استخدم FP8 عندما تُفضِّل مصدر نقطة التحقق وجودتها على حجم البنية التحتية، وBF16 فقط عندما يبرر أعلى وفاء متطلبات ذاكرة على مستوى عدة رفوف.
لقد تجاوز Qwen3.8-Max حدًا مهمًا منذ إطلاق API الأولي: أصبحت عائلة Qwen من فئة Max تمتلك الآن نقطة تحقق 2.4T مفتوحة يمكن للمؤسسات تشغيلها بالكامل على بنيتها التحتية الخاصة.
لكن الأوزان المفتوحة لا تعني عتادًا استهلاكيًا. تجعل بصمة BF16 بحجم 4.45 TiB، ونقطة FP8 بحجم 2.27 TiB، ومتغيرات FP4 بحجم 1.3–1.5 TiB من Qwen3.8-2.4T-A95B أحد أكثر النماذج المفتوحة كثافةً من حيث البنية التحتية المتاحة. الجانب العملي الإيجابي هو أن vLLM وSGLang يدعمان البنية بالفعل، وتجعل FP4 نشر 8× B300 أو 8× MI355X على عقدة واحدة ممكنًا.
استضف ذاتيًا عندما تبرر السيطرة على البيانات، والاستفادة المستمرة، وامتلاك البنية التحتية تشغيل العنقود. وإلا، استخدم API المُدار لـ Max—أو Qwen3.8-27B عندما يكون ما تريده حقًا هو نموذج Qwen قوي على محطة عمل واحدة.