
Anthropic udgav Fable 5.1 den 1. september 2026 som deres mest kapable alment tilgængelige model til kodning og vidensarbejde. Modellen er målrettet opgaver med lang horisont: fler-timers kodning, flerstegs research, dokumenttungt professionelt arbejde og agenter, der gentagne gange bruger værktøjer, mens de bevarer store mængder kontekst.
Claude Fable 5.1 kombinerer et 1M-token kontekstvindue, op til 128K outputtokens, tekst- og billedinput og altid aktiveret adaptiv tænkning. Grundpriserne forbliver $10 input og $50 output per MTok; den vigtige ændring er $0.25 per MTok for cache-læsninger.
Overblik: Specifikationer for Claude Fable 5.1
Specifikationerne nedenfor stammer fra Anthropic’s modeldokumentation. Priserne er Anthropic-listepriser og bør holdes adskilt fra eventuelle CometAPI-priser.
| Officiel specifikation | Claude Fable 5.1 |
|---|---|
| Udgivelse og model-ID | 1. september 2026 — claude-fable-5-1 |
| Primær rolle | Krævende ræsonnering og agentisk arbejde med lang horisont |
| Kontekst og maksimalt output | 1M-token kontekst — op til 128K output |
| Input → output | Tekst og billeder → tekst |
| Tænkning og standard-API-indsats | Adaptiv tænkning, altid aktiveret — High indsats |
| Pålidelig vidensgrænse | juni 2026 |
| Listepriser | $10 input — $50 output — $0.25 cache-læsning per MTok |
To detaljer betyder mere end de rå tal. 1M-kontekstvinduet er tilgængeligt som standard i stedet for som et særligt langkontekstniveau. Adaptiv tænkning er altid slået til, mens indsats styrer, hvor meget arbejde modellen udfører; Anthropic siger, at standarden er High i Claude Code og Medium i Claude Cowork og Claude.ai.
Hvad er Claude Fable 5.1
Claude Fable 5.1 er Anthropics frontliniemodel til opgaver, hvor et system skal blive ved med at ræsonnere, bruge værktøjer og bevare kontekst over mange trin. I stedet for at sigte mod korte spørgsmål-og-svar-udvekslinger er den designet til vedvarende eksekvering: at udforske en kodebase, køre terminal-workflows, syntetisere store dokumentsæt og fuldføre professionelle opgaver, der kan tage timer.
Dens definerende pakke er et 1M-token kontekstvindue med op til 128K output, tekst- og billedinput og adaptiv tænkning, der forbliver aktiveret gennem hele en forespørgsel. Dette lader en agent beholde lange instruktioner, kildemateriale, værktøjsresultater og mellemliggende beslutninger i én arbejdskontekst, mens ræsonneringsindsatsen justeres til sværhedsgraden af hvert trin.
Den bedste anvendelse er et højværdiflow, hvor fejl, omarbejde eller tabt kontekst koster mere end premium token-priser. Eksempler omfatter repository-skala engineering, flertrins research, computer-brugsagenter, compliance-tung dokumentanalyse og forretningsautomatisering med gentagne værktøjskald. Til rutineklassifikation, højvolumen-ekstraktion eller latenstidsfølsom chat kan et lavere omkostningsniveau i Claude stadig være det bedste udgangspunkt.
Standardbrug af Fable kræver 30 dages opbevaring til sikkerhedsovervågning. Berettigede erhvervskunder kan bruge nul dataopbevaring, mens Enterprise Frontier Safeguards rulles ud; Anthropic siger, at den planlagte arkitektur lagrer overvågede data i kundekontrolleret cloudinfrastruktur. Regulerede teams bør verificere kontospecifikke vilkår før udrulning.
Claude Fable 5.1 vs. Fable 5: Hvad er ændret?
Version 5.1 er ikke et ensartet kapabilitetsspring. De tydeligste ændringer er lavere omkostninger ved gentagen kontekst og meget stærkere eksekvering på agentisk research, terminalkodning og forretningsprocesser, mens generel værktøjsunderstøttet ræsonnering kun flytter sig en smule.
| Dimension | Claude Fable 5 | Claude Fable 5.1 | Ændring |
|---|---|---|---|
| Basis input / output | $10 / $50 per MTok | $10 / $50 per MTok | Ingen ændring |
| Cache-læsning | $1.00 per MTok | $0.25 per MTok | 75% lavere |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | +27.9 point |
| Terminal-Bench 4.0 | 42.0% | 55.8% | +13.8 point |
| AutomationBench | 17.1% | 31.4% | +14.3 point |
| HLE with tools | 63.8% | 65.0% | +1.2 point |
Cache-læsninger er 75% billigere, mens basispriserne forbliver uændrede
Input forbliver $10 per MTok og output forbliver $50 per MTok, så de overordnede satser faldt ikke. Den materielle ændring er cache-læseprisen, der falder fra $1.00 til $0.25 per MTok. Dette betyder mest for agenter, der gentagne gange genindlæser et langt præfiks indeholdende repositories, politikker, dokumenter, værktøjsdefinitioner og tidligere tilstand. Deres omkostning per fuldført workflow kan falde, selv når satserne for nyt input og output ikke gør.
Agentisk videnskabelig research viser den største gevinst
Terminal-Bench-Science 0.1 stiger fra 24.7% til 52.6%, en gevinst på 27.9 procentpoint og mere end en fordobling af den tidligere score. Dette er det stærkeste bevis for, at Fable 5.1 forbedrer eksekvering med lang horisont: planlægning af en undersøgelse, betjening af værktøjer, fortolkning af resultater og genopretning fra mellemliggende fejl.
Terminalkodning og forretningsautomatisering forbedres materielt
Terminal-Bench 4.0 stiger fra 42.0% til 55.8%, mens AutomationBench stiger fra 17.1% til 31.4%. Disse resultater peger på bedre end-to-end opgavefuldførelse, ikke blot bedre kodegenerering. Teams bør forvente størst fordel i workflows, der kræver, at modellen inspicerer et miljø, vælger handlinger, bruger værktøjer og verificerer resultater på tværs af flere trin.
Generel ræsonnering forbedres mindre end eksekvering
Humanity’s Last Exam with tools går fra 63.8% til 65.0%, kun 1.2 point, og CursorBench stiger med 2.9 point. Sammenligningen understøtter derfor ikke en generel påstand om, at alle kapabiliteter forbedredes lige meget. Fable 5.1 bør forstås som en eksekveringsfokuseret opgradering, hvis stærkeste gevinster fremkommer, når ræsonnering skal opretholdes via værktøjer og lange opgavekæder.
Sammenligningsresultat: Eksisterende Fable 5-brugere, der kører lange, værktøjstunge agenter, har den klareste grund til at opgradere: væsentligt billigere cache-læsninger og færre fejl på eksekveringsorienterede benchmarks. Teams, der bruger korte prompts eller generelle videnopgaver, bør validere de mindre gevinster op mod latenstid og samlede omkostninger, før de migrerer.
Benchmark-ydeevne for Claude Fable 5.1
Anthropics officielle benchmark-tabel sammenligner den nye model med dens forgænger, Claude Opus 5, og GPT-5.6 Sol. De udvalgte rækker nedenfor dækker research, kodning, vidensarbejde, computerbrug og automatisering.
| Officiel benchmark | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 partial | 77.9% | 72.9% | 75.4% | — |
| OSWorld 2.0 strict | 41.7% | 36.1% | 39.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Grafikken ovenfor er det officielle Anthropic-benchmarkbillede kopieret fra kildedokumentet, ikke et lokalt omtegnet diagram. Anthropic bemærker en ±3.5–4.5 points standardfejl for Terminal-Bench-Science og siger, at produktionssikkerhedsforanstaltninger var aktiveret under evalueringen. Små forskelle bør derfor behandles med forsigtighed.
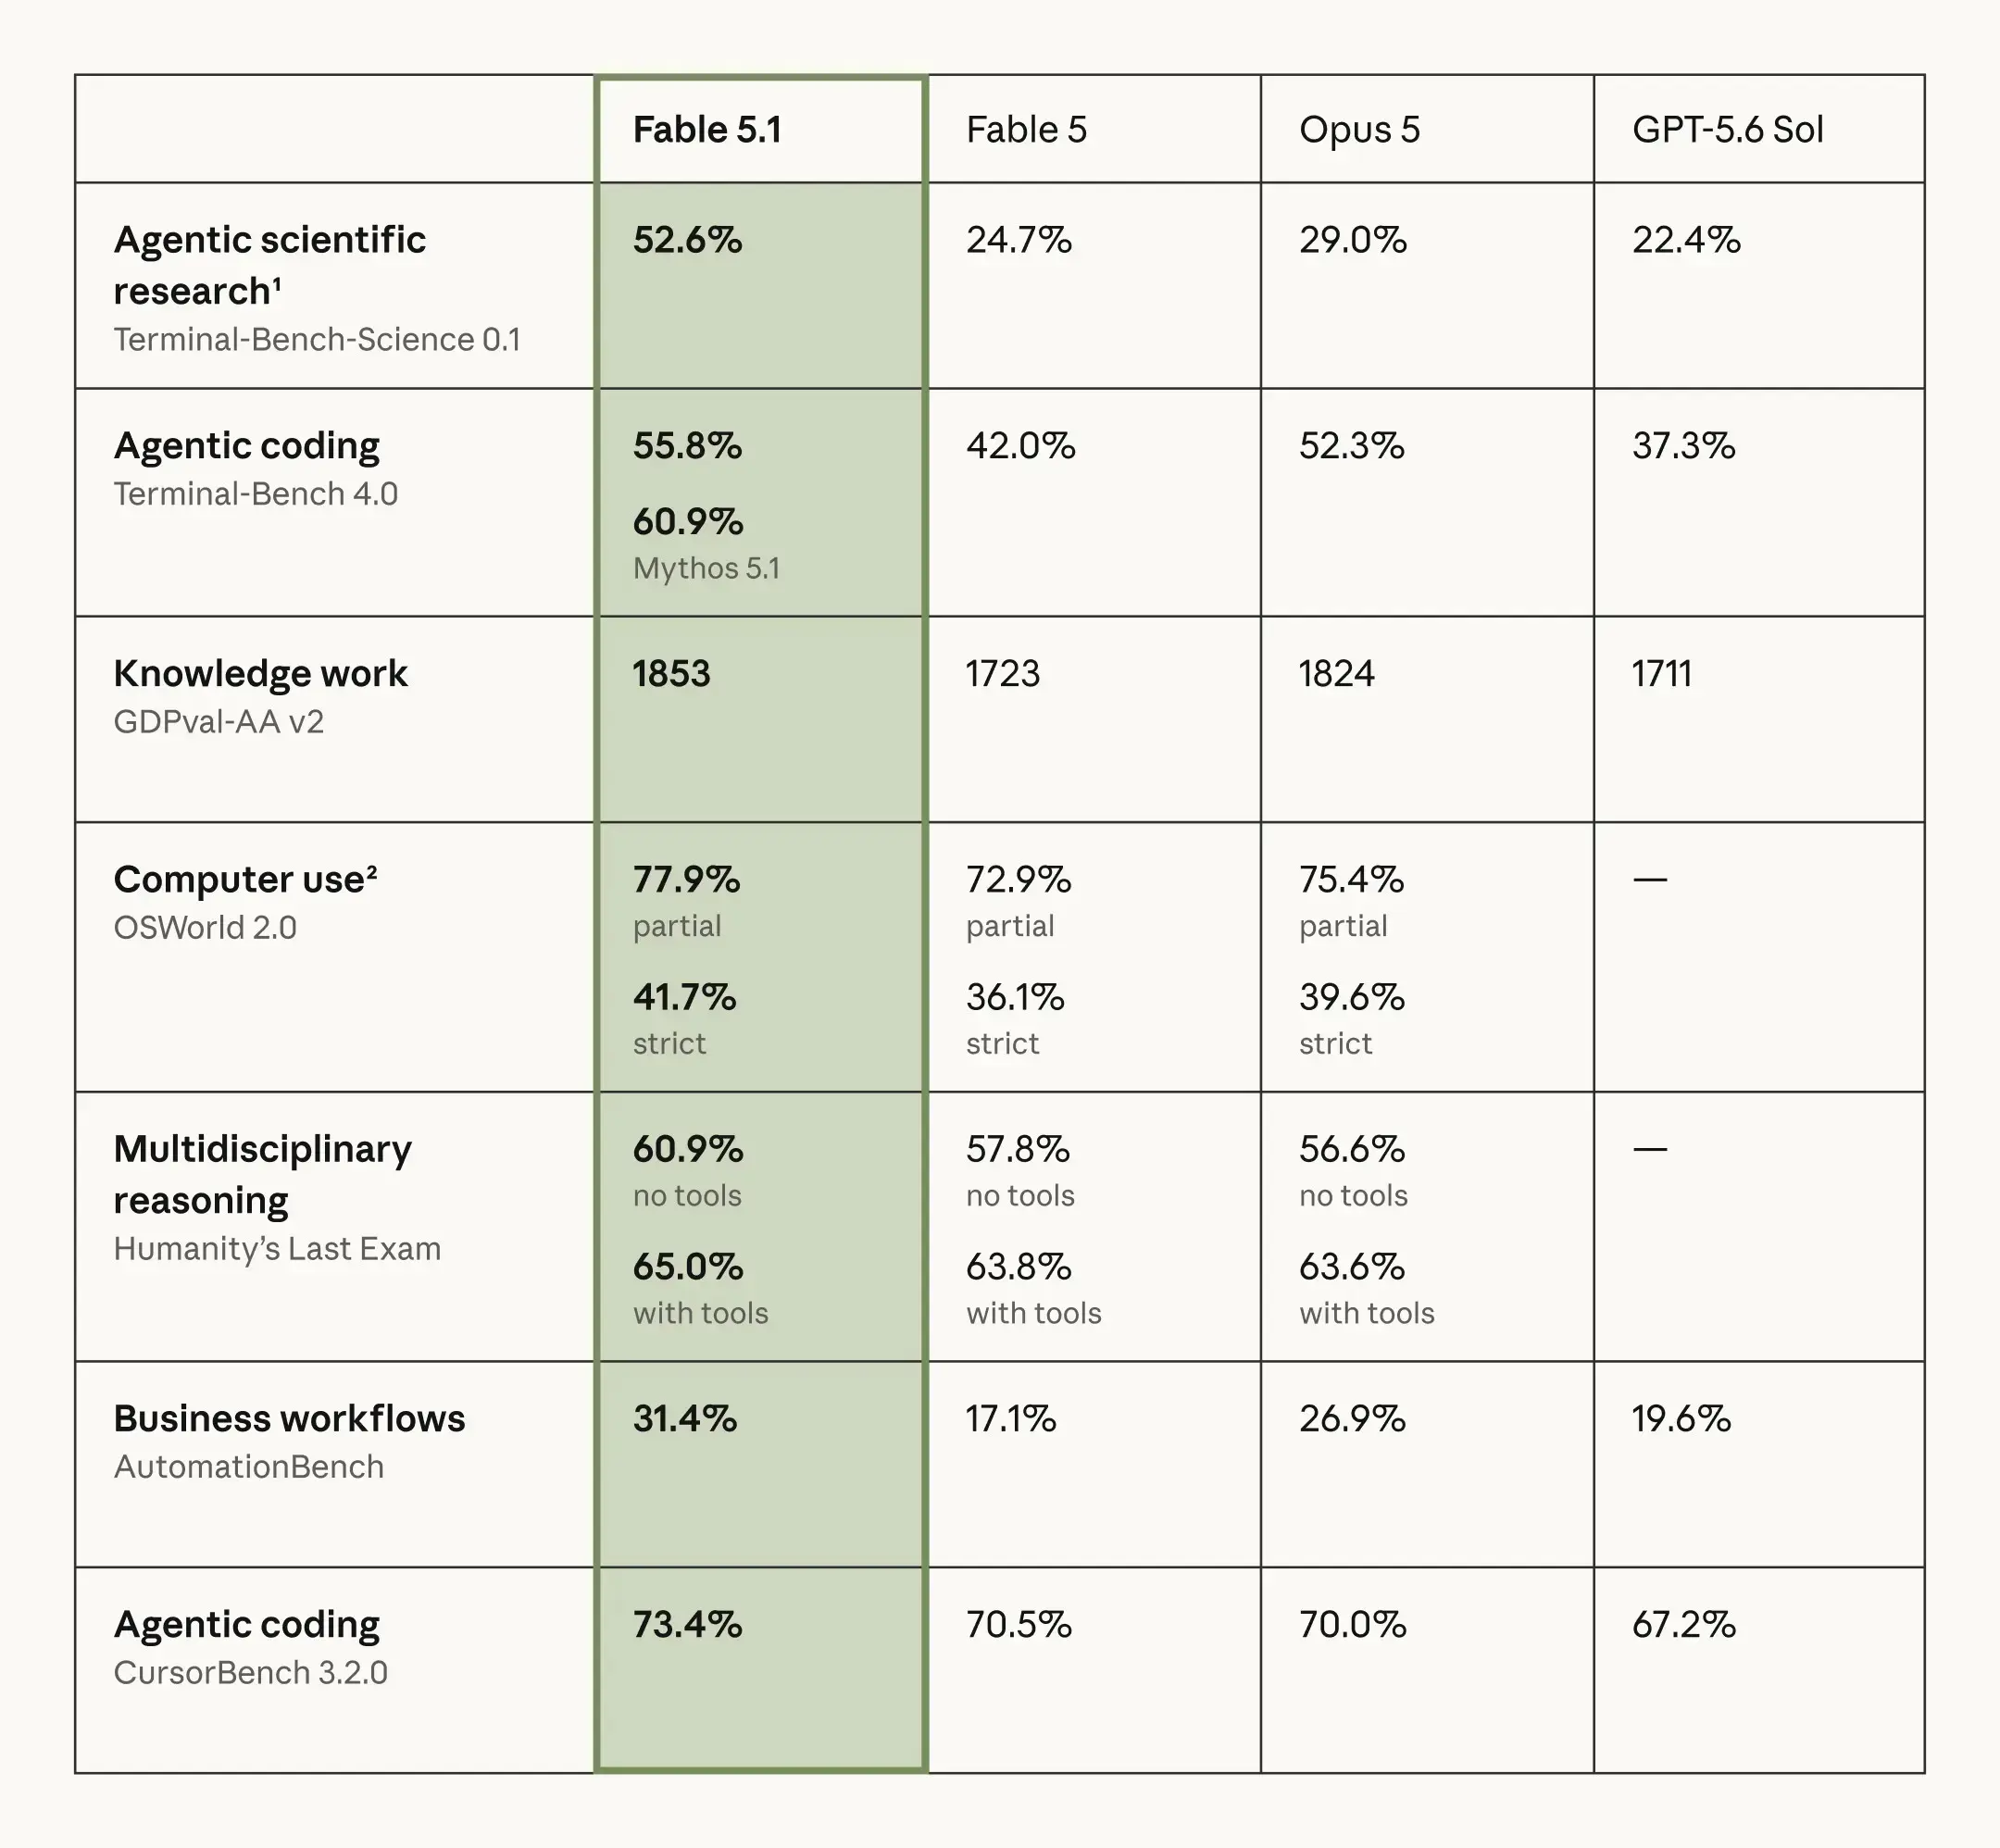
Kilde:Officiel Anthropic Fable 5.1 benchmark-grafik
Sådan læses benchmark-resultaterne
Disse scorer bør ikke fortolkes som universelle mål for modelkvalitet. Anthropic evaluerede Claude Fable 5.1 med produktionssikkerhedsforanstaltninger aktiveret, og nogle benchmarkopgaver kan være påvirket af sådanne indgreb. Terminal-Bench-Science rapporterer også en standardfejl på cirka ±3.5–4.5 procentpoint per model.
OSWorld 2.0-resultater bruger benchmarkforfatternes opgaveudgivelse fra august 2026, så de bør ikke sammenlignes direkte med scorer fra tidligere opgaveudgivelser.
Priser for Claude Fable 5.1
Pris for input og output
Anthropic lister Claude Fable 5.1 til $10 per MTok af input og $50 per MTok af output. Claude Fable 5.1 API i CometAPI til $8 per MTok af input og $40 per MTok af output, en reduktion på 20% fra de officielle listerater. Dette er forbrugsbaserede satser; tjek den aktuelle modelside før produktion, fordi platformpriser og faktureringsregler kan ændre sig.
Priser for prompt-cache
Anthropic prissætter en 5-minutters cache-skrivning til $12.50 per MTok, en 1-times cache-skrivning til $20 per MTok og en cache-læsning til $0.25 per MTok. Læsesatsen er 75% under Fable 5’s $1 per MTok, så langvarige agenter, der genbruger repositories, politikker, værktøjsdefinitioner eller tidligere tilstand, får større fordel end korte, enkeltstående prompts.
Eksempel på omkostning for et agent-workflow
En agent, der læser 150K cachede tokens ved hvert af 1.000 trin, bruger 150 MTok cache-læsninger. Ved Fable 5.1’s sats på $0.25 koster den komponent $37.50; ved Fable 5’s $1 ville det koste $150 — en besparelse på $112.50. Nyt input, output, cache-skrivninger og platformgebyrer er stadig ekstra, så teams bør sammenligne den samlede omkostning per vellykket workflow snarere end cache-omkostningen alene.
Hvorfor cachepriser ændrer agentøkonomien
En konventionel forespørgsel kan bruge det meste af sin regning på nyt input og output. En agent er anderledes: Hvert værktøjstrin kan genlæse et stort cachet præfiks, der indeholder politik, kode, dokumenter, værktøjsdefinitioner og tidligere tilstand. Anthropics 75% reduktion i cache-læsning gavner uforholdsmæssigt lange løkker.
For eksempel bruger en agent, der genlæser 150K cachede tokens på tværs af 1.000 trin, 150 millioner cache-læsetokens. Ved $1 per MTok koster den komponent $150; ved $0.25 per MTok koster den $37.50. Dette eksempel udelader nyt input, output, cache-skrivninger og platformgebyrer, men det viser, hvorfor uændrede basispriser stadig kan give en lavere omkostning per fuldført opgave.
Anthropic estimerer omkring 25% lavere omkostning for typiske token-fakturerede workloads og op til cirka 45% for stærkt agentiske workloads. Dette er estimater for workload-mix, ikke en universel rabat på hvert token.
Claude Fable 5.1 vs Opus 5 vs Sonnet 5
Frontliniemodellen er kapabilitetsloftet, men Anthropic anbefaler Opus-niveauet som udgangspunkt for de fleste workloads. Sonnet-niveauet er stadig det hurtigere, billigere valg, når gennemstrømning og latenstid betyder mere end maksimal pålidelighed over lang horisont. For en dybere tomodelanalyse, se CometAPIs Fable vs Sonnet-sammenligning.
| Dimension | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Kontekstvindue | 1M | 1M | 1M |
| Maksimalt output | 128K | 128K | 128K |
| Input / output listepris | $10 / $50 | $5 / $25 | $2 / $10 |
| Sammenlignende latenstid | Langsommere | Moderat | Hurtig |
| Bedst egnet | De sværeste agenter og ræsonnering med lang horisont | Standard premium-udgangspunkt | Højvolumenarbejde med fokus på hastighed og pris |
Valgresultat: Start med det lavere omkostningsniveau, der opfylder opgaven. Skaler kun op, når produktionsevalueringer viser, at frontliniemodellen øger antallet af accepterede resultater, reducerer gentagelser eller sænker den samlede omkostning per vellykket workflow.
Migreringsændringer, som udviklere skal teste
Den nye model er for det meste en drop-in-efterfølger, men Anthropic dokumenterer tre breaking changes, der påvirker agentframeworks og lange samtaler.
| Migreringsændring | Hvad sker der | Påkrævet udviklerhandling |
|---|---|---|
| Tvungen værktøjsvalg | tool_choice = any eller et navngivet værktøj returnerer HTTP 400 | Brug auto, instruer modellen, og håndhæv strenge skemaer, når det er nødvendigt |
| Tænkningsblokke på tværs af modelswitches | Ældre modeller kan ikke læse de nye tænkningsblokke | Test routere, og forvent at tænkningsblokke droppes, når der routes baglæns |
| Redigering af tidligere ture | Ændret historik kan ugyldiggøre tænkningsblokke | Hold historikker append-only eller brug understøttede komprimeringsmønstre |
Test også indsats pr. besked, tur-afgrænsede systembeskeder, statusopdateringer mellem værktøjskald, cacheadfærd og indholdsoprindelse, før du flytter produktionstrafik. Den eksisterende Fable API-vejledning er stadig det bedste sted for generisk SDK-opsætning og forespørgseleksempler.
Hvem bør bruge Claude Fable 5.1?
Claude Fable 5.1 er bedst til workloads, hvor vedvarende ræsonnering og succesfuld fuldførelse betyder mere end minimal latenstid eller tokenpris. Vælg den, når opgaven strækker sig over mange trin, gentagne gange bruger værktøjer, eller har tilstrækkelig forretningsværdi til, at undgå fejlbehæftede kørsler og omarbejde kan opveje premium-modelomkostninger.
- Repository-skala engineering: debugging, migrationer, refaktorering af flere filer, testeksekvering og uovervågede kodningsagenter.
- Flertrins research: søgning, evaluering af evidens, kørsel af analyser og produktion af en forankret slutrapport.
- Store dokumenter og professionelt arbejde: kontrakter, teknisk dokumentation, finansielt materiale, regneark og præsentationsworkflows.
- Computerbrug og automatisering: opgaver, der kræver gentagne værktøjskald, interfacenavigation, verifikation og genopretning fra mellemliggende fejl.
Til rutineklassifikation, højvolumen-ekstraktion eller latenstidsfølsom chat, start med Claude Opus 5 eller Claude Sonnet 5
Tilgængelighed via CometAPI
Fra 4. september 2026 viser CometAPI-modelsiden Claude Fable 5.1 som live og operationel. Model-ID’et er claude-fable-5-1.
- Opret eller log ind på en CometAPI-konto, og generér en API-nøgle i dashboardet.
- Vælg Claude Fable 5.1, og angiv
claude-fable-5-1som model-ID. - Send forespørgsler via den Anthropic-kompatible
/v1/messages-endpoint eller den OpenAI-kompatible/v1/chat/completions-endpoint. - Kør en produktionstilpasset evaluering for at bekræfte latenstid, konteksthåndtering, værktøjsadfærd og fakturering, før du migrerer trafik.
Udviklere kan også få adgang til modellen direkte via Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry og Claude Platform on AWS.
Konklusion
Claude Fable 5.1 bør først og fremmest forstås som en eksekveringsopgradering. Det mest overbevisende bevis er ikke det uændrede 1M-kontekstvindue eller premium-basisprisen på $10/$50; det er den store forbedring i agentisk research, terminalkodning og automatisering kombineret med væsentligt billigere cache-læsninger.
Brug den, når en opgave er vanskelig, langvarig og så værdifuld, at færre fejlslagne kørsler kan retfærdiggøre premiumpriser. Til rutine-, højvolumen- eller latenstidsfølsomt arbejde, begynd med et billigere niveau og skaler kun op, når din egen evaluering viser en målbar forbedring i fuldførte resultater.
Ofte stillede spørgsmål
Er Claude Fable 5.1 tilgængelig via en API?
Ja. Anthropic viser Claude Fable 5.1 som aktiv siden 1. september 2026. Den er tilgængelig via Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry og Claude Platform on AWS.
Hvad koster Claude Fable 5.1 API?
Anthropics officielle listepris er $10 per MTok af input og $50 per MTok af output. CometAPI viser aktuelt $8 input og $40 output per MTok. Tjek den aktuelle rutepris før udrulning.
Hvor stort er Claude Fable 5.1’s kontekstvindue?
Modellen understøtter et 1M-token kontekstvindue og op til 128K outputtokens. Stor kapacitet fjerner ikke behovet for at teste hentekvalitet, latenstid og omkostning med produktionsdokumenter.
Hvad ændrede sig fra Claude Fable 5 til 5.1?
De største praktiske ændringer er stærkere agentisk research og terminaleksekvering, en reduktion af cache-læseprisen fra $1 til $0.25 per MTok, indsatskontroller pr. besked, statusopdateringer og indholdsoprindelse. Migrering kræver også test af tvunget værktøjsvalg, tænkningsblokke på tværs af modelswitches og redigerede samtalehistorikker.
Er Claude Fable 5.1 bedre end Claude Opus 5?
Ikke til enhver workload. Fable 5.1 er den højere kapabilitetsmulighed til krævende arbejde med lang horisont, men den er langsommere og dyrere. Anthropic anbefaler at starte de fleste workloads med Claude Opus 5 og først rykke op, når evalueringer med højere indsats stadig ikke er tilstrækkelige.
Kan jeg bruge Claude Fable 5.1 via CometAPI?
Ja. CometAPI viser aktuelt Claude Fable 5.1 som live under model-ID claude-fable-5-1, med Anthropic-kompatible og OpenAI-kompatible endpoints.
Understøtter Claude Fable 5.1 tvungen værktøjsbrug?
Nej. Anthropic dokumenterer, at tool_choice sat til any eller et navngivet værktøj returnerer HTTP 400. Brug auto eller none, og styr så værktøjsvalget med instruktioner og strenge inputskemaer, når det kræves.