
TL;DR
Claude Haiku 5.5 und GPT-6 Luna sind kostengünstige Reasoning-Modelle für umfangreiche API-Workloads. Beide starten bei $0.10 pro Million Eingabetokens und $0.50 pro Million Ausgabetokens. Haiku erzielt in den sechs in Anthropics Launch-Materialien veröffentlichten Vergleichen höhere Werte. Luna behält seine Basistarife für Prompts bis 272K Eingabetokens bei, verglichen mit Haikus 100K-Schwelle. Für Entwickler sind die Schlüsselkennzahlen Akzeptanzrate, End-to-End-Latenz, API-Kompatibilität und Kosten pro akzeptiertem Ergebnis – die Gesamtkosten aller Versuche geteilt durch die Anzahl der Ausgaben, die vordefinierte Prüfungen bestehen.
Zentrale Erkenntnisse
- Haiku 5.5 führt den zitierten OSWorld-2.1-Computer-Use-Vergleich an, 72.4% gegenüber Lunas 48.9%.
- Auf Terminal-Bench 4.0 liegen die zitierten Ergebnisse bei 39.2% für Haiku und 16.4% für Luna.
- Beide starten zu identischen Kurzkontext-Preisen, aber Haikus höherer Preistier beginnt jenseits von 100K Prompt-Tokens, während Lunas Schwelle bei 272K liegt.
- Die Max-Effort-Modellseiten von Artificial Analysis, geprüft am 9. Oktober 2026, zeigen Ausgabegeschwindigkeiten von 240.6 Tokens/s für Haiku und 123.0 Tokens/s für Luna; der Durchsatz schließt die Wartezeit bis zum ersten Token aus.
- Starten Sie mit Haiku für die in den geteilten Benchmarks abgebildeten Computer-Use- und Terminal-Aufgaben; erwägen Sie Luna für große Prompts. Behalten Sie Ihr aktuelles Modell, bis ein repräsentativer Pilot eine nützliche Verbesserung zeigt.
Was sind Claude Haiku 5.5 und GPT-6 Luna?
Claude Haiku 5.5: Überblick
Claude Haiku 5.5 wurde am 7. Oktober 2026 veröffentlicht. Es kombiniert günstige Inferenz mit anpassbarem Reasoning, Tool-Nutzung, langem Kontext sowie Text- und Bildeingaben. Typische Anwendungen umfassen Dokumentenextraktion, Datenbankabfragen, Kundensupport und leichte Subagenten.
GPT-6 Luna: Überblick
GPT-6 Luna wurde am 22. September 2026 veröffentlicht. Es ist auf fokussierte Aufgaben in großem Maßstab ausgerichtet, darunter Klassifikation, Informationsextraktion, strukturierte Ausgabe, Programmierassistenz und Verarbeitung langer Dokumente. Die flexiblen Reasoning-Einstellungen umfassen eine No-Reasoning-Konfiguration für einfachere Arbeiten.
Spezifikationen
| Spezifikation | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Entwickler | Anthropic | OpenAI |
| Veröffentlichung | 7. Oktober 2026 | 22. September 2026 |
| Modell-ID | claude-haiku-5-5 | gpt-6-luna |
| Kontextfenster | 1,000,000 Tokens | 1,050,000 Tokens |
| Maximale Ausgabe (Standard-API) | 128,000 Tokens | 128,000 Tokens |
| Eingabe | Text und Bild | Text und Bild |
| Ausgabe | Text | Text |
| Reasoning | Anpassbar, Niedrig bis Max | Keine bis Max |
| Standardaufwand | Medium | Medium |
| Wissensstand | Juni 2026 | 18. Mai 2026 |
| Tool-Nutzung | Ja | Ja |
| Strukturierte Ausgabe | Ja | Ja |
| Offene Gewichte | Nein | Nein |
| Architektur und Parameteranzahl | In den zitierten offiziellen Unterlagen nicht angegeben | In den zitierten offiziellen Unterlagen nicht angegeben |
Die Spezifikationen stützen sich auf die Standard-API-Modell-Dokumentation der Anbieter, geprüft am 9. Oktober 2026: Haikus Standard-API-Spezifikationen und Lunas Standard-API-Spezifikationen. Architektur und Parameteranzahlen bleiben ungenannt, da diese Quellen sie nicht belegen.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark-Ergebnisse
| Benchmark | Haiku 5.5 | GPT-6 Luna | Führend |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, Offline-Teilwertung | 72.4% | 48.9% | Haiku +23.5 Prozentpunkte |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 Prozentpunkte |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 Prozentpunkte |
| Chartography, ohne Tools | 46.4% | 29.1% | Haiku +17.3 Prozentpunkte |
Die sechs Zeilen oben reproduzieren die von Anthropic veröffentlichten Launch-Vergleichsergebnisse, geprüft am 9. Oktober 2026. Es handelt sich um von Anthropic veröffentlichte Vergleiche, einschließlich dort reproduzierter unabhängiger Ergebnisse, nicht um neue Tests für diesen Artikel. GDPval-AA und AA-Briefcase sind Elo-Scores; Prozentdifferenzen sind Prozentpunkte. Diese Benchmark-Familien messen unterschiedliche Aufgaben und sollten nicht zu einem universellen Sieger gemittelt werden.
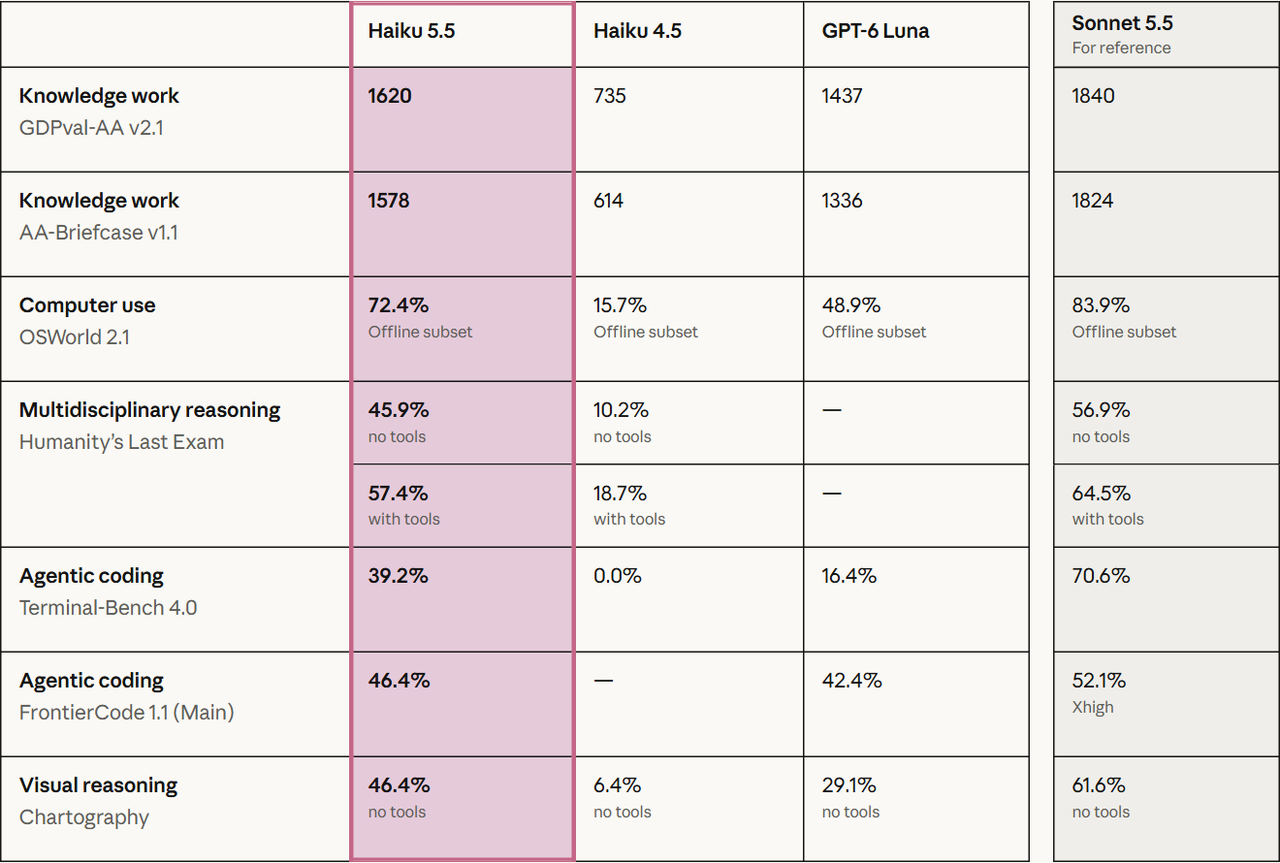
Haikus relativ stärkste Ergebnisse in dieser Launch-Tabelle erscheinen bei visueller Computerinteraktion und terminalbasierten Aufgaben. Der kleinere Vorsprung bei FrontierCode mahnt, eine 20-Punkte-Differenz nicht auf jede Programmieraufgabe zu übertragen. Nutzen Sie diese Ergebnisse zur Auswahl von Pilotkandidaten und validieren Sie anschließend Prompts und Tool-Stack.
Reasoning-Aufwand und Bewertungsgrenzen
Der Reasoning-Aufwand verändert den Genauigkeits-Kosten-Trade-off. Vergleichen Sie verfügbare Einstellungen mit derselben Workload und demselben Harness; identische Einstellungsnamen der Anbieter garantieren keine gleichen Reasoning-Token-Budgets. Die Launch-Tabelle berichtet OSWorlds Offline-Teilmenge und Chartography ohne Tools. Harness, Aufgabenauswahl, Retries und Toolzugriffe können die Ergebnisse verändern. Anthropics Systemkarte dokumentiert die benchmark-spezifischen Bedingungen. Lesen Sie die Benchmark-Methoden in der Systemkarte von Anthropic.
- OSWorld verwendet die 82 Aufgaben umfassende Offline-Teilmenge, eine Ubuntu-VM, 1080p-Screenshots, ein Limit von 500 Aktionen, maximalen Aufwand und fünf Versuche pro Aufgabe. Der Vergleich 72.4%/48.9% ist eine Teilpunktwertung, nicht der Anteil perfekt abgeschlossener Aufgaben; Haikus strikte Bestehensrate beträgt 37.1%. Anthropic führte Luna auf derselben Teilmenge über die OpenAI-API aus.
- Terminal-Bench nutzt 66 containerisierte Aufgaben; Haiku lief mit maximalem Aufwand im Claude Code Bare Mode, ohne Internet-Egress oder Fallback-Modell, mit durchschnittlich zehn Trials pro Aufgabe.
- FrontierCode Main enthält 100 Aufgaben mit fünf Läufen pro Aufgabe; Claude-Modelle nutzten Claude Code und GPT-Modelle Codex.
- GDPval-AA und AA-Briefcase wurden unabhängig von Artificial Analysis evaluiert und in den Launch-Materialien reproduziert. Dies sind separate Evaluationspipelines, kein gemeinsamer Produktions-Harness.
Claude Haiku 5.5 vs GPT-6 Luna: Funktionsvergleich
Computerbedienung und agentisches Coding
Haikus stärkster Vorteil liegt in den geteilten Launch-Aufgaben, die Interaktion mit einem grafischen Computer oder Arbeiten im Terminal erfordern. Die OSWorld-Teilpunktlücke beträgt 23.5 Prozentpunkte, während Terminal-Bench um 22.8 Punkte differiert. Die kleinere Differenz von 4.0 Punkten bei FrontierCode zeigt, warum die breitere Kategorie „Coding“ nicht als ein einziger Workload behandelt werden sollte.
Für Browser-Automatisierung testen Sie Seitennavigation, Formulareingabe, Wiederherstellung nach Tool-Fehlern und End-to-End-Abschluss. Beim Coding testen Sie, ob ein Patch die Funktionsprüfungen Ihres Repos besteht und im Scope bleibt. Diese Akzeptanzprüfungen sind nützlicher als die Modellwahl anhand der größten Schlagzeilenlücke.
Langer Kontext und Dokumentenverarbeitung
Der nominelle Kapazitätsunterschied von 5% ist weniger bedeutsam als die Zuverlässigkeit und der Preis für die Verarbeitung großer Prompts. Kein Modell ist allein wegen eines größeren Kontextfensters inhärent besser beim Abrufen von Informationen.
Der entscheidende Unterschied ist, wann höhere Raten gelten: Ein Prompt mit 150K Tokens überschreitet Haikus Schwelle, bleibt aber innerhalb von Lunas Basistier. Luna ist daher der kostengünstigere Ausgangspunkt für diese Token-Workload. Ob es der bessere Dokumentanalyst ist, hängt weiterhin von Extraktionsgenauigkeit, Belegstellen und den nötigen Retries für eine akzeptable Antwort ab.
Reasoning-Steuerung
Beide Modelle bieten einstellbaren Reasoning-Aufwand, in der zitierten Dokumentation ist Medium die Standardeinstellung. Luna bietet zusätzlich eine Einstellung ‚none‘. Nutzen Sie diese Kontrollen passend zur Aufgabe: Extraktion und Routing benötigen möglicherweise weniger Reasoning als ein unsicherer, mehrstufiger Tool-Workflow. Dieselbe Aufwandsbezeichnung impliziert kein identisches Compute-Budget zwischen Anbietern.
Multimodale Eingabe und strukturierte Workflows
Beide akzeptieren Text und Bilder und erzeugen Text. Das qualifiziert sie für Screenshots, Dokumentbild-Extraktion und strukturierte Downstream-Workflows. Die bloße Unterstützung der Eingaben belegt jedoch nicht gleiche Genauigkeit bei kleinem Text, Diagrammen oder visuellen Interfaces; messen Sie diese Fälle separat.
Geschwindigkeit und Task-Ökonomie
| Unabhängige Metrik (Maximalaufwand) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Ausgabegeschwindigkeit | 240.6 Tokens/s | 123.0 Tokens/s |
| Gewichtete Kosten pro Intelligence-Index-Aufgabe | $0.21 | $0.07 |
Artificial Analysis ist der unabhängige Test-Publisher. Die Tabelle ist eine Momentaufnahme der Max-Effort-Modellseiten, geprüft am 9. Oktober 2026, und keine offizielle Anbieter-Performance. Die Ausgabegeschwindigkeit misst Tokens nach Beginn der Generierung; sie ist getrennt von Zeit bis zum ersten Token und der gesamten Task-Latenz. Die Kosten pro Aufgabe sind eine gewichtete Intelligence-Index-Metrik, kein Angebot für Ihre Produktionsaufgabe oder Kosten pro erfolgreichem Ergebnis.
Haikus Momentaufnahme-Durchsatz ist ungefähr 1.96-mal so hoch wie Lunas, während Lunas gewichtete Evaluations-Task-Kosten niedriger sind. Das belegt keinen 1.96-fachen Vorteil bei der vollständigen Abschlusszeit. In der Produktion sollten Zeit bis zum ersten Token, Abschlusszeit, Ausgabelänge, Reasoning-Verbrauch und Tool-Laufzeiten getrennt erfasst werden.
Claude Haiku 5.5 vs GPT-6 Luna: Preise und API-Zugang
Offizielle Standardtarife
| USD pro 1 Mio. Tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Eingabe | $0.10 | $0.50 | $0.10 | $0.20 |
| Gecachte Lesezugriffe | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache-Schreiben (Haiku: 5-Minuten TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Ausgabe | $0.50 | $2.50 | $0.50 | $0.75 |
USD pro Million Tokens bei Standardverarbeitungssätzen, geprüft am 9. Oktober 2026. Die Tabelle nutzt Haikus Standard- und 5-Minuten-Cache-Write-Raten und Lunas Kurz- und Langkontext-Raten. Tool-Gebühren, Steuern, regionale Aufschläge und optionale Anpassungen der Verarbeitungstiers sind ausgeschlossen. Oberhalb der Eingabeschwelle gelten die höheren Sätze für die gesamte Anfrage, nicht nur für die überschüssigen Tokens.
Der zentrale Unterschied ist die Abrechnungsschwelle. Haiku wechselt jenseits von 100K Prompt-Tokens in höhere Sätze, während Luna sein Basistier bis 272K beibehält. Selbst darüber liegen Lunas zitierte Langkontext-Eingabe- und -Ausgabepreise niedriger.
Haiku bietet auch 1-Stunden-Cache-Writes zu $0.20/$1.00 pro Million Tokens für kurze/lange Prompts. Cache-Persistenz und Preismechanismen unterscheiden sich zwischen Anbietern, vergleichen Sie daher Wiederverwendungsmuster statt beide Cache-Write-Zeilen als identische Produkte zu behandeln. Haikus 128K-Ausgabelimit ist das Standard-API-Limit; die Message Batches API kann mit einem Beta-Header 300K Ausgabe unterstützen.
Veranschaulichende Kosten bei festen Token-Budgets
| Arbeitslast | Eingabe/Ausgabe | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket-Klassifizierung | 2K / 200 | $0.0003 | $0.0003 |
| Kurzer Bericht | 40K / 4K | $0.006 | $0.006 |
| Repository-Analyse | 150K / 5K | $0.0875 | $0.0175 |
| Große Dokumentprüfung | 300K / 10K | $0.175 | $0.0675 |
| Analyse mit massivem Kontext | 800K / 20K | $0.45 | $0.175 |
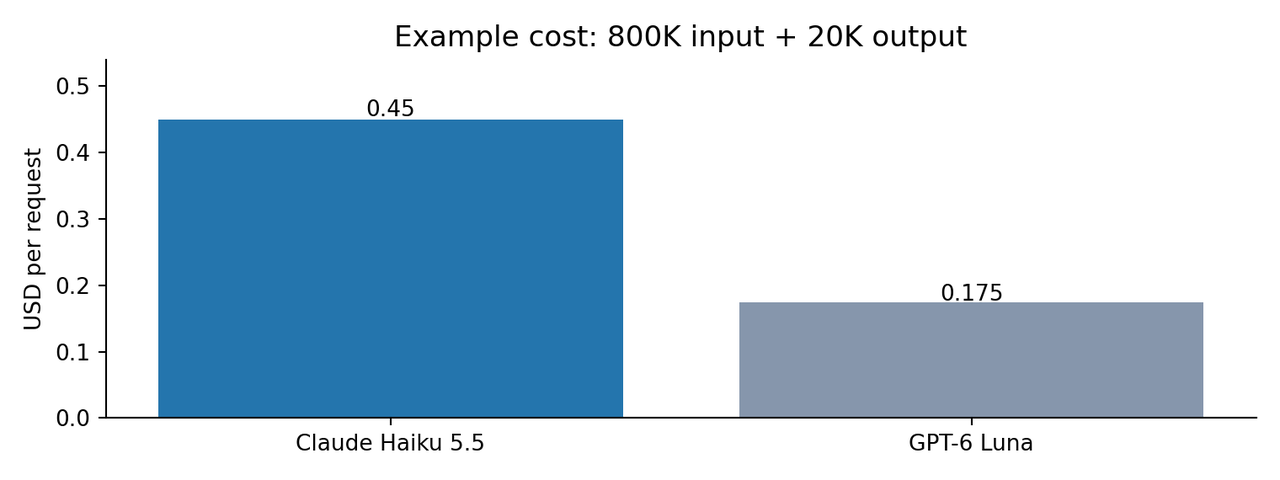
Vom Autor berechnete, ungecachte Standardraten-Schätzung: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. „Ausgabe“ bedeutet in dieser Schätzung die insgesamt abgerechnete Ausgabe, einschließlich Reasoning-Tokens, sofern als Ausgabe berechnet; sie entspricht nicht notwendigerweise der sichtbaren Antwortenlänge. Für beide Modelle werden dieselben gemeldeten Token-Zahlen verwendet, obwohl sich Tokenizer unterscheiden können.
Ein billiges Token ist nicht zwangsläufig ein günstiges erfolgreiches Ergebnis. Teams sollten wiederholte Versuche, fehlgeschlagene Tool-Aufrufe, den Reasoning-Token-Verbrauch und unterschiedliches Tokenizer-Verhalten berücksichtigen.
CometAPI-Zugang und Integrationsbeschränkungen
CometAPI bietet Zugangsoptionen für beide Modelle. Bevor Sie sie über das Gateway vergleichen oder bereitstellen, verifizieren Sie die Modell-IDs, unterstützten Endpunkte, Request-Parameter, Tool-Verhalten und Abrechnungsregeln für jede Route. Diese Provider-Links dokumentieren Zugangsoptionen; sie ersetzen nicht die technischen oder Standard-Preisquellen der Anbieter.
Für direkte OpenAI-Integrationen unterstützt Luna integrierte Tools über die Responses API; Chat Completions-Funktionsaufrufe erfordern den Reasoning-Aufwand none. Haiku nutzt Anthropics Messages API und Adaptive Thinking. Ein Gateway macht die zugrunde liegenden Schemata nicht austauschbar: Validieren Sie Tool-Definitionen, Verhalten strukturierter Ausgaben, Streaming-Events und Abrechnung exakt auf der Route, die Sie einsetzen wollen.
Wie können Entwickler Claude Haiku 5.5 und GPT-6 Luna mit demselben Prompt vergleichen?
Beispiel: Extraktion aus langen Dokumenten
Ein praktischer Vergleich kann ein Lieferantenvertragsbündel mit Wirksamkeitsdaten, Verlängerungsbedingungen, Kündigungsfristen und Ausnahmen verwenden. Halten Sie das Dokumentbündel, die Extraktionsanweisungen, die erwarteten Felder und die Validierungsregeln identisch. Das Folgende ist ein Evaluationsdesign, kein neues gemessenes Modellergebnis.
Beispielprompt: Extrahieren Sie für jeden Vertrag den Namen des Lieferanten, das Wirksamkeitsdatum, das Verlängerungsdatum, die Kündigungsfrist und Preis-Ausnahmen. Zitieren Sie für jeden extrahierten Wert den Dokumenttitel und die genaue unterstützende Passage. Geben Sie null zurück, wenn ein Feld fehlt; leiten Sie fehlende Daten nicht ab. Kennzeichnen Sie widersprüchliche Klauseln und halten Sie die endgültige Antwort innerhalb von 1,000 Wörtern.
| Prüfung | Akzeptanzkriterium | Was erfassen |
|---|---|---|
| Extraktionsgenauigkeit | Erforderliche Felder stimmen mit einem unabhängig geprüften Antwortschlüssel überein | Korrekte, inkorrekte und fehlende Werte |
| Grounding | Jeder nicht-null Wert hat eine gültige unterstützende Passage | Nicht belegte Aussagen und falsche Dokumentzitate |
| Befolgung der Anweisungen | Keine erfundenen Daten; fehlende Felder geben null zurück | Schemafehler und Verstoß gegen Vorgaben |
| Ökonomie | Ausgaben pro akzeptierter Extraktion berechnen | Abgerechnete Eingabe, Ausgabe, Reasoning, Retries und Fallback-Kosten |
| Latenz | Vollständige Jobdauer unter derselben Tool-Policy vergleichen | Zeit bis erstes Token und End-to-End-Zeit |
Führen Sie mehr als ein repräsentatives Bündel aus und wiederholen Sie Fälle mit abweichenden Ergebnissen. Beginnen Sie mit demselben verfügbaren Aufwandsniveau, testen Sie anschließend eine kostengünstigere Konfiguration für jedes Modell. Berichten Sie Stichprobengröße, Einstellungen, Route, Datum und Fehlanzahlen, bevor Sie einen Sieger präsentieren.
Haiku 5.5 oder GPT-6 Luna: Welche Wahl?
| Dimension | Besser geeigneter Ausgangspunkt | Entscheidungsgrenze |
|---|---|---|
| GUI-Interaktion | Claude Haiku 5.5 | Geteilte OSWorld-Teilwertungen begünstigen Haiku; vollständigen Abschluss verifizieren |
| Terminal-Coding | Claude Haiku 5.5 | Geteilte Terminal-Bench-Scores begünstigen Haiku; Repo-Änderungen validieren |
| Kurze Prompts und Basistarife | Beide testen | Identische Basistarife; abgerechnete Nutzung und Retries vergleichen |
| Prompts über 100K Tokens | GPT-6 Luna mit Standardtarifen | Luna behält das Basistier länger bei; Genauigkeit kann Gesamtkosten verändern |
| Gestreamter Token-Durchsatz | Claude Haiku 5.5 in der datierten Momentaufnahme | Durchsatz unterscheidet sich von vollständiger Abschlusslatenz |
| Einfache wiederholte Extraktion | Luna mit geringem oder keinem Reasoning testen | Nach gültigem, akzeptiertem Output auswählen statt nur nach Preis |
Wählen Sie Claude Haiku 5.5 für benchmark-relevante interaktive Aufgaben
Starten Sie mit Haiku, wenn Ihre Anwendung den veröffentlichten grafischen Computer-, Terminal-Coding- oder Professional-Work-Aufgaben ähnelt und eine höhere Erfolgsquote zusätzliche Reasoning- oder Langkontextkosten ausgleicht. Bestätigen Sie diesen Vorteil in Ihrem eigenen Tool-Stack, bevor Sie Produktionstraffic umleiten.
Wählen Sie GPT-6 Luna für Kostensenkung bei großen Prompts
Starten Sie mit Luna, wenn Prompts häufig 100K Tokens überschreiten und Standard-Tokenkosten Ihr Budget wesentlich beeinflussen. Es ist auch ein Kandidat für wiederholte Extraktion oder Routing, die mit geringem oder keinem Reasoning auskommen. Halten Sie die Empfehlung an die Akzeptanzraten und die tatsächlich abgerechnete Nutzung geknüpft.
Nutzen Sie beide, wenn Workloads unterschiedliche Anforderungen haben
Ein Pilot könnte Langdokument-Extraktion an Luna und GUI- oder Terminal-Aufgaben an Haiku routen und dann jede Wahl gegen Akzeptanzprüfungen validieren. Lösen Sie einen Fallback aus, wenn eine Ausgabe die Schema-Validierung nicht besteht, erforderliche Belege fehlen oder eine aufgabenspezifische Prüfung fehlschlägt, und berücksichtigen Sie Fallback-Kosten und -Latenz im Vergleich.
Validieren Sie vor dem Wechsel
Beziehen Sie Ihr aktuelles Modell als Baseline ein. Wechseln Sie nur, wenn der Kandidat ein vordefiniertes Korrektheitsziel erreicht und die Kosten pro akzeptiertem Ergebnis oder die End-to-End-Latenz ausreichend verbessert, um Migration und Wartung zu decken. Stoppen Sie das Rollout, wenn kritische Tool-Fehler steigen. Die Empfehlung ändert sich, wenn Ihr Pilot zeigt, dass Lunas niedrigere Rate durch Retries kompensiert wird oder dass Haikus höhere Benchmark-Scores Ihren Task-Erfolg nicht verbessern.
- Verwenden Sie eine repräsentative Workload-Stichprobe und erfassen Sie richtige, falsche und unvollständige Ergebnisse.
- Messen Sie Zeit bis zum ersten Token, End-to-End-Taskzeit und Tool-Zuverlässigkeit.
- Verfolgen Sie Eingabe-, Cache-, Ausgabe- und Reasoning-Token getrennt.
- Berechnen Sie die Kosten pro erfolgreichem Ergebnis, einschließlich Retries und Fallbacks.
- Vergleichen Sie Medium und High beim Reasoning-Aufwand, bevor Sie standardmäßig Max aktivieren.
Fazit
Claude Haiku 5.5 zeigt in den hier verglichenen Professional-Work-, Computer-Use- und agentischen Coding-Benchmarks stärkere Head-to-Head-Launch-Belege. Es hat außerdem höheren Ausgabedurchsatz in der unabhängigen Momentaufnahme. GPT-6 Luna weist einen klaren Standardraten-Vorteil für Prompts oberhalb von Haikus 100K-Schwelle auf und niedrigere gewichtete Evaluations-Task-Kosten. Keine dieser Beobachtungen bestimmt allein Produktionszuverlässigkeit oder Kosten pro erfolgreichem Ergebnis.
Der praktische Sieger ist das Modell, das ein akzeptables Ergebnis zu den niedrigsten voll gemessenen Betriebskosten liefert. Führen Sie beide mit Ihren eigenen Prompts, Tools und Retry-Regeln aus, statt einen einzelnen Benchmark als Antwort zu behandeln.
FAQ
Warum können Task-Kosten differieren, wenn beide Modelle dieselben Basistarife haben?
Der gleiche Basispreis bedeutet nicht dieselbe Gesamtrechnung. Modelle können unterschiedliche Mengen an Eingabe-, Ausgabe- und Reasoning-Tokens verwenden und benötigen möglicherweise verschiedene Anzahlen an Retries oder Tool-Aufrufen, um ein akzeptables Ergebnis zu produzieren. Langkontext-Raten und Cache-Nutzung beeinflussen ebenfalls die Summe. Vergleichen Sie die Gesamtkosten aller Versuche geteilt durch die Zahl der akzeptierten Ergebnisse statt nur Tokenpreise.
Gelten höhere Langkontext-Raten nur für Tokens oberhalb der Schwelle?
Nein. Unter der hier beschriebenen Standardpreisgestaltung wendet das Überschreiten der Eingabeschwelle die höheren Sätze auf die gesamte Anfrage an, nicht nur auf die überschüssigen Tokens. Beispiel: Eine Anfrage mit 150K Eingabe-Tokens überschreitet Haikus 100K-Schwelle, bleibt aber innerhalb von Lunas 272K-Basistier. Verwenden Sie bei Kostenschätzungen die jeweils geltenden Ein- und Ausgaberaten für die gesamte Anfrage.
Können Claude Haiku 5.5 und GPT-6 Luna sich einen Prompt-Cache teilen?
Gehen Sie nicht davon aus, dass Cache-Einträge zwischen Modellen oder Providern übertragbar sind. Entwerfen Sie separate Wiederverwendungsstrategien und messen Sie Trefferquoten sowie abgerechnete Nutzung auf jeder Route. Gateway-Unterstützung, Aufbewahrungsregeln und Request-Struktur können beeinflussen, ob wiederholte Eingaben für Caching geeignet sind; verifizieren Sie dies vor der Planung von Einsparungen.
Was sollte ein Haiku-zu-Luna-Migrationstest abdecken?
Testen Sie repräsentative Text- und Bildeingaben, erforderliche strukturierte Felder, Tool-Argumente, gestreamte Antworten und Fehlererholung. Legen Sie die Akzeptanzrate Ihres aktuellen Systems vor der Migration fest und vergleichen Sie anschließend beide Kandidaten unter denselben Retry- und Tool-Policies. Ähnliche Tokenpreise oder Modellkategorien begründen keine Kompatibilität.
Sollten Benchmark-Scores einen Haiku- oder Luna-Fallback steuern?
Verwenden Sie Scores zur Kandidatenauswahl und lösen Sie Fallbacks bei beobachteten Fehlern aus, etwa ungültigen Tool-Argumenten, fehlenden Pflichtfeldern oder nicht bestandenen Task-Prüfungen. Verfolgen Sie Fallback-Häufigkeit und Gesamtkosten. Ein zweites Modell kann Latenz und Kosten erhöhen; verifizieren Sie, dass es akzeptierte Ergebnisse verbessert und nicht nur eine zweite Antwort liefert.
Können sensible Daten über beide APIs geroutet werden?
Prüfen Sie die konkreten Anbieter und das eingesetzte Gateway, deren aktuelle Aufbewahrungseinstellungen, Verarbeitungsorte, Vertragsbedingungen und die Datenrichtlinie Ihrer Organisation, bevor Sie sensible Eingaben routen. Modellfähigkeit und Preistabellen belegen nicht die Eignung einer Route für regulierte oder vertrauliche Daten. Nutzen Sie die genehmigte Route, wenn diese Anforderungen entscheidend sind.