
TL;DR
Google hat am 30. September 2026 Gemini 4 Argon als Frontier-Modell für komplexe, lang laufende Workflows angekündigt. Die veröffentlichten Ergebnisse zeigen ein klares Muster: starke Leistung in professioneller Wissensarbeit, Langkontext-Aufgaben und ausgewählten Software-Engineering-Evaluierungen, mit schwächeren Resultaten bei einigen Terminal- und Computer-Nutzungs-Benchmarks. Google führt das Modell in Phasen ein. Unabhängig davon meldet CometAPI eine Katalogverfügbarkeit ab dem 1. Oktober; Kontoberechtigung und ein erfolgreicher Testaufruf sollten vor dem Deployment geprüft werden. Die nützlichere Leistungsbetrachtung liegt darin, wo die Zugewinne auftreten.
Argon erzielt 68,9% auf dem Vals Index, 65,4% auf Vals Finance Agent v2, 77,9% auf DeepSWE v1.1, 91,7% auf LVBench und 84,2% auf GraphWalks bei 256K–1M Kontext. Gleichzeitig liegt es hinter konkurrierenden Frontier-Modellen auf FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science und OSWorld-2.0.
Die Ergebnisse sprechen für eine arbeitsspezifische Sicht auf Argon. Seine stärksten Werte bündeln sich um professionelle Wissensarbeit, sehr langen Kontext und ausgewählte multimodale sowie Software-Engineering-Evaluierungen. Andere Modelle behalten Vorteile bei mehreren Terminal- und Computer-Nutzungs-Tests.
Key Takeaways
- Gemini 4 Argon ist am stärksten in Enterprise-Wissensarbeit, Langkontext-Reasoning, multimodalem Verständnis und mehreren Coding-Evaluierungen mit langer Horizonte.
- Sein Maximum von 1 Million Token für Ausgaben bietet mehr Spielraum für lange Reasoning-Verläufe; es legt keine öffentliche Spezifikation für den Input-Kontext fest.
- Argon führt mehrere veröffentlichte Resultate zur Wissensarbeit und zu Langkontext auf an, aber GPT-6 Astra und Claude Opus 5.5 liegen bei ausgewählten Coding- und Computer-Nutzungs-Evaluierungen vorn.
- Benchmark-Scores beschreiben spezifische Modell-und-Agent-Konfigurationen. Metriken, Eingabebedingungen und Evaluations-Setups sind ebenso wichtig wie die Prozentzahlen in den Schlagzeilen.
- Googles Rollout und der CometAPI-Zugang sind getrennte Verfügbarkeitsaussagen. Vor einer Migration den aktiven Pfad, die Modell-ID und die Konto-Berechtigung verifizieren.
What Is Gemini 4 Argon?
Gemini 4 Argon ist das neue Frontier-Gemini-Modell von Google DeepMind, ausgelegt auf schwierige Workflows, die Reasoning über viele Schritte erfordern, statt eine kurze Eingabe zu beantworten.
Googles offizielle Positionierung betont reale Softwareentwicklung, Enterprise-Wissensarbeit wie Recht und Finanzen, defensive Cybersicherheit, multimodales Verständnis und lang laufende agentische Aufgaben.
Dies unterscheidet sich von den jüngsten Flash-Releases. Gemini 3.8 Flash API in CometAPI ist als kostengünstiger Arbeitspferd-API für agentische Workloads in großem Maßstab ausgelegt. Argon repräsentiert hingegen das Frontier-Ende von Googles Stack und priorisiert Tiefe und dauerhafte Ausführung.
Model Specifications
| Specification | Gemini 4 Argon |
|---|---|
| Developer | Google DeepMind |
| Announced | 30. September 2026 |
| Model family | Gemini 4 |
| Positioning | Frontier-Reasoning- und Long-Horizon-Modell |
| Maximum output | 1.000.000 Token |
| Long-context evaluation | Getestet bis 256K–1M auf GraphWalks |
| Public input context limit | Zum Start nicht formell in einer Standard-API-Spezifikation angegeben |
| Multimodal understanding | Ja; umfasst Diagramme, Dokumente und Langvideo-Evaluation |
| Agentic coding | Ja |
| Computer use | Evaluiert |
| Cybersecurity | Spezialisierte defensive Fähigkeiten |
| Google public API model ID | In Googles anfänglicher öffentlicher Dokumentation nicht angekündigt; CometAPI verwendet gemini-4-argon als Katalog-Identifier. |
Output Budget and Trade-offs
Google kündigt für Argon eine maximale Ausgabegrenze von 1 Million Token an, aufwärts von der zuvor in der Launch-Ankündigung genannten 64K-Grenze. Dies schafft Spielraum für längere Reasoning-Verläufe. Es sollte nicht als garantierter Gesamtetat für eine gesamte Agent-Session mit mehreren Aufrufen interpretiert werden oder als Beweis, dass jede Aufgabe besser wird.
Maximale Ausgabe ist nicht gleich Intelligenz. Einem Modell mehr Ausgabe-Token zu geben, macht es nicht automatisch leistungsfähiger; es entfernt nur einen potenziellen Engpass. Das Modell muss diesen Etat weiterhin produktiv nutzen.
Es gibt zudem Trade-offs bei Kosten und Latenz. Ein Modell, das tatsächlich Hunderttausende generierte Token verbraucht, kann teuer und langsam sein, selbst wenn der nominelle Preis pro Token attraktiv erscheint.

Ausgewählte Benchmark-Ergebnisse, reproduziert aus dem Artikel. Vergleiche Modelle innerhalb jeder Zeile; Metriken und Evaluationsbedingungen unterscheiden sich. Dieses Diagramm ersetzt das dekorative Verlaufsmotiv und stellt keine unabhängige Testung dar.
Eine maximale Ausgabegrenze und ein Eingabekontextfenster beschreiben unterschiedliche Kapazitäten. Der GraphWalks-Evaluationsbereich ist Evidenz über die getesteten Eingaben, kein Ersatz für eine öffentliche API-Spezifikation.
How Does Gemini 4 Argon Perform on Benchmarks?
Die Performance-Tabelle von Google DeepMind deckt Agent-Workflows, professionelle Wissensarbeit und multimodale Aufgaben ab. Die folgenden Werte reproduzieren diesen veröffentlichten Vergleich. Sie messen die Aufgabenleistung, nicht den Token-Durchsatz oder die Antwortlatenz; „—“ bedeutet, dass in diesem Vergleich kein Ergebnis berichtet wurde.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% | Vals AI |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% | Private Set; Zapier-Leaderboard |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% | Vals AI |
| Harvey's Legal Agent | 19,6% | 5,4% | 6,7% | 3,8% | Vals AI |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% | mini-swe harness; gemischte Quellen |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% | Proximal-Leaderboard |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% | Vals AI Leaderboard |
| Terminal-Bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% | Self-Test / Leaderboard |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% | v1.1; OpenCode; 10h; eine H100 |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% | Verifier-Timeout ×6 |
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% | Linux-Tools; Internet |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% | Surge-Leaderboard |
| GraphWalks up to 128K | 99,7% | 98,7% | 91,4% | 90,6% | BFS F1; 650 Items |
| GraphWalks 256K–1M | 84,2% | 71,8% | 65,0% | 66,8% | BFS F1; 200 Items |
| Agent's Last Exam | 39,5% | 34,2% | — | 38,2% | Binäre Bestehensrate; ALE-Claw; 5h |
| OSWorld-2.0 | 69,2% | 72,6% | — | — | Offline-Teilscore; Best of 3 Runs |
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% | Keine Tools; Surge-Leaderboard |
| LVBench | 91,7% | 87,5% | 79,7% | 83,7% | Keine Tools; modellspezifisches Frame-Sampling |
| CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% | pass@1; pass@4 entscheidet Gleichstände |
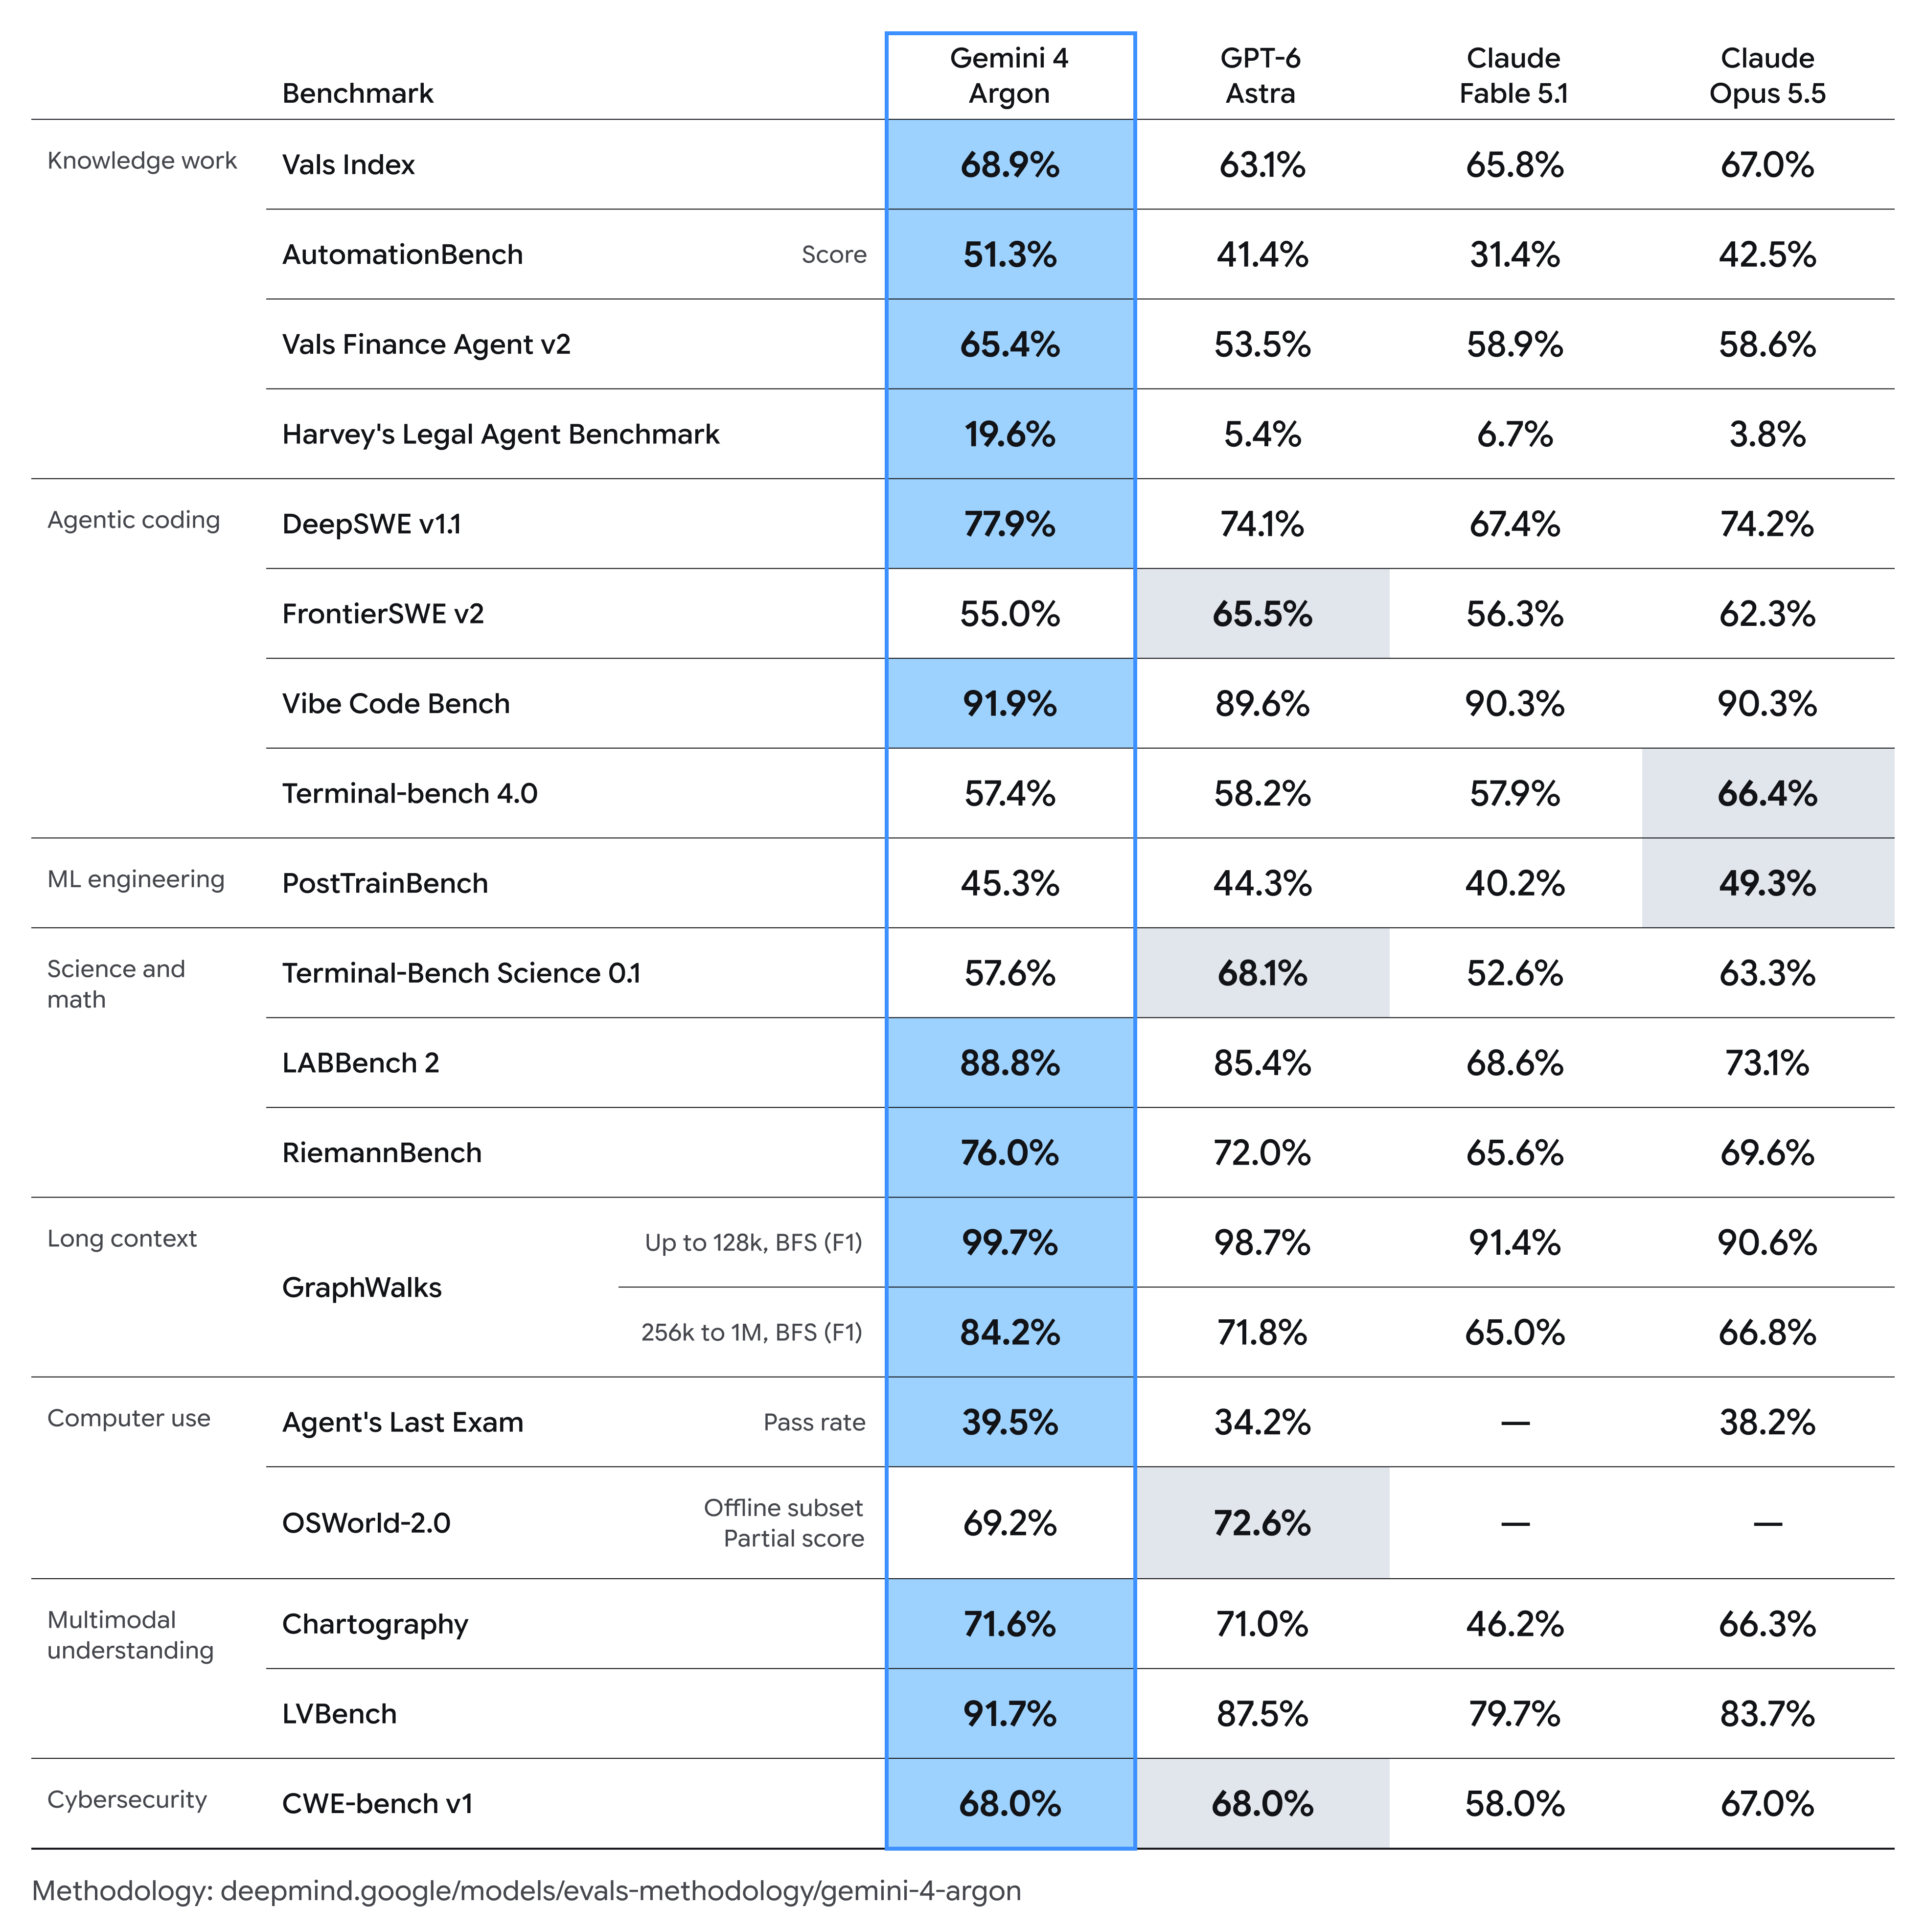
Googles offizielle Benchmark-Vergleichstabelle zu Gemini 4 Argon
Sofern nicht anders angegeben, verwenden Argon-Ergebnisse einen einzelnen Versuch und die höchste Thinking-Einstellung. Ergebnisse anderer Modelle stammen in der Regel von den Anbietern, mit benchmark-spezifischen Ausnahmen. LVBench nutzt 1 FPS für Gemini, 800 Frames für GPT-6 Astra, 300 für Fable 5.1 und 600 für Opus 5.5. Diese Eingaben sind nicht identisch, daher sollten die gemeldeten Konfigurationen verglichen werden, statt jede Zeile als kontrollierte Neuauflage zu behandeln.
Evaluation Conditions and Limitations
Die Tabelle ist nützlich, sollte aber nicht als unabhängiges universelles Leaderboard interpretiert werden.
- Die Benchmark-Auswahl ist Googles Auswahl.
- Die benchmark-spezifischen Evaluations-Setups unterscheiden sich zwischen den Zeilen, einschließlich Agent-Frameworks, Zeitbudgets, Tools und Input-Sampling.
- Die offizielle Methodik nennt Anbieterberichte zu Wettbewerbern als Standard, mit benchmark-spezifischen Leaderboard- und Selbstberechnungs-Ausnahmen.
- Die höchste Benchmark-Einstellung spiegelt möglicherweise keine Standard-Produktionsinferenz-Konfiguration wider.
- Ein Benchmark-Score in der Überschrift offenbart nicht Tokenverbrauch, Tool-Aufrufe, Retries, verstrichene Zeit oder menschliche Eingriffe.
Für Produktionssysteme ist oft Kosten pro erfolgreich abgeschlossener Aufgabe ein besserer Maßstab als Preis pro Token oder ein einzelner Benchmark-Prozentsatz.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Das klarste Muster in Argons Ergebnissen zeigt sich in professioneller, mehrstufiger Wissensarbeit.
Auf dem Vals Index erreicht Argon 68,9%, verglichen mit 67,0% für Claude Opus 5.5. Die numerische Lücke ist moderat, aber in spezialisierten Workflows wird das Muster deutlicher.
- Vals Finance Agent v2: 65,4%, 6,5 Punkte über dem stärksten Wettbewerber in Googles Tabelle.
- AutomationBench: 51,3%, 8,8 Punkte über Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19,6%, verglichen mit 6,7% für das nächsthöchste berichtete Modell.
Das Leistungsprofil legt nahe, dass Argon besonders profitiert, wenn das Modell Informationen sammeln, Zustand bewahren, über mehrere Phasen hinweg schlussfolgern und ein professionelles Artefakt produzieren muss, statt nur eine geschlossene Frage zu beantworten.
Wichtig ist auch der niedrige absolute Score beim Legal-Agent. Ein Wert von 19,6% allein verrät nicht, wie viele Kriterien oder vollständige Workflows fehlgeschlagen sind. Die nützliche Schlussfolgerung ist, dass Argon auf dieser Evaluation einen großen relativen Fortschritt zeigt, während das Ergebnis keine verlässliche Automatisierung juristischer Arbeit belegt.
Long-Context Reasoning
Argons auffälligster Vorteil könnte die 256K–1M-Version von GraphWalks sein.
- Gemini 4 Argon: 84,2%
- GPT-6 Astra: 71,8%
- Claude Opus 5.5: 66,8%
- Claude Fable 5.1: 65,0%
Das ist ein Vorsprung von 12,4 Punkten gegenüber dem nächsten Modell im veröffentlichten Vergleich.
Die Lücke ist bei kürzeren Kontextlängen viel kleiner: Auf GraphWalks bis 128K erzielt Argon 99,7% und GPT-6 Astra 98,7%. Das deutet darauf hin, dass Argon auf dieser speziellen Langkontext-Evaluation weniger stark degradiert als die verglichenen Modelle.
Google hat jedoch nicht genügend architektonische Informationen offengelegt, um diesen Unterschied einem spezifischen Aufmerksamkeitsmechanismus, einem Retrieval-System, einem Trainingsrezept oder einer Strategie zur Laufzeit zuzuordnen. Aussagen wie „Gemini 4 führt eine neue Attention-Architektur ein“ würden über die öffentliche Evidenz hinausgehen.
Coding Performance
Die offizielle Benchmark-Tabelle unterstützt kein einfaches Ja.
Argon schneidet bei einigen Formen des Codings äußerst gut ab und verliert bei anderen klar. Auf DeepSWE v1.1 erreicht es 77,9%, gegenüber 74,2% für Claude Opus 5.5 und 74,1% für GPT-6 Astra. Sein Vibe Code Bench Score ist ebenfalls stark mit 91,9%.
- FrontierSWE v2: 55,0% Argon vs. 65,5% GPT-6 Astra.
- Terminal-Bench 4.0: 57,4% Argon vs. 66,4% Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57,6% Argon vs. 68,1% GPT-6 Astra.
Diese Aufspaltung ist für Entwickler wichtig. Argon scheint besonders stark, wenn Coding zu einem langen Engineering-Workflow mit umfangreichem Kontext und Planung wird, während terminallastige Ausführung stärker umkämpft bleibt. Ein Benchmark zur Repository-Migration und ein interaktiver Terminal-Benchmark sollten nicht als austauschbare Maße der „Coding-Fähigkeit“ behandelt werden.
Defensive Cybersecurity
Cybersicherheit ist ein Kerneinsatzgebiet. Googles defensive Cybersecurity-Positionierung umfasst autonome Schwachstellenerkennung, Validierung und Patchen. Dies ist eine Anbieterfähigkeits-Aussage; das untenstehende CWE-bench-Ergebnis misst die Vulnerability-Remediation auf seiner eigenen Evaluation.
Auf CWE-bench v1 erzielt Argon 68%, gleichauf mit GPT-6 Astra und leicht vor Claude Opus 5.5 mit 67%.
Google hebt zudem stärkere Schutzmaßnahmen gegen Missbrauch, indirekte Prompt-Injektion, riskantes Agentenverhalten und Kompromittierung der Ausführungsumgebung hervor. Damit ist Argon ebenso sehr ein Agent-Sicherheits-Release wie ein konventionelles Modell-Upgrade.
Multimodal Understanding
Argon erzielt 71,6% auf Chartography und 91,7% auf LVBench für Langvideo-Verständnis. Das LVBench-Ergebnis liegt 4,2 Prozentpunkte über GPT-6 Astra in Googles Tabelle. Da die Modelle unterschiedliche Frame-Sampling-Konfigurationen erhalten, ist dies ein Vergleich der gemeldeten Setups und kein reiner Modellvorteil.
Das ist relevant, weil viele professionelle Workflows nicht rein textbasiert sind. Ein Finanzforschungsagent muss möglicherweise ein Diagramm prüfen; ein Enterprise-Assistent kombiniert Berichte, PDFs und Screenshots; ein Videoanalysesystem muss Ereignisse über eine lange Sequenz hinweg bewahren, statt einzelne Frames unabhängig zu verarbeiten.
Argons Kombination aus multimodaler Wahrnehmung und nachhaltigem Reasoning ist daher relevanter als alleinige Multimodal-Unterstützung.
Science and Mathematics Performance
Die Ergebnisse sind gemischt, aber insgesamt stark. Argon erreicht 88,8% auf LABBench 2 und 76,0% auf RiemannBench, vor den verglichenen Modellen in Googles Tabelle. Auf Terminal-Bench Science 0.1 hingegen erreicht GPT-6 Astra 68,1% gegenüber Argons 57,6%.
Dieser Unterschied weist auf ein breiteres Muster hin: Argon scheint stärker im Reasoning über wissenschaftliche Informationen als in jeder Form werkzeuggetriebener wissenschaftlicher Ausführung.
Computer-Use Performance
Auf Agent's Last Exam erzielt Argon eine binäre Bestehensrate von 39,5%, vor GPT-6 Astra mit 34,2% und Claude Opus 5.5 mit 38,2%. Auf dem Offline-Subset von OSWorld-2.0 liegt sein Teilscore bei 69,2%, unter GPT-6 Astra mit 72,6%. Der OSWorld-Wert ist keine Erfolgsrate voller Aufgaben, und fehlende Claude-Einträge implizieren keine Nullfähigkeit.
Die aktuellen Daten zeigen also keinen durchgängigen Vorteil bei der Computer-Nutzung. Für die Produktion sollten Benchmark-Scores durch aufgabenbezogene Tests von Navigationsgenauigkeit, Fehlklicks, Retry-Häufigkeit, unbeabsichtigten Aktionen, Zeit bis zur Fertigstellung und Quote menschlicher Korrekturen ergänzt werden.
Gemini 4 Argon vs GPT-6 Astra und Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Knowledge work | Sehr stark | Stark | Sehr stark | Stark |
| Long-context benchmark | Stärkstes veröffentlichtes Ergebnis | Stark | Moderat–stark | Moderat |
| Long-horizon coding | Sehr stark | Sehr stark | Sehr stark | Stark |
| Terminal coding | Wettbewerbsfähig | Stark | Am stärksten in ausgewähltem Test | Wettbewerbsfähig |
| Scientific terminal agents | Wettbewerbsfähig | Am stärksten in ausgewähltem Test | Stark | Wettbewerbsfähig |
| Multimodal understanding | Sehr stark | Sehr stark | Stark | Wettbewerbsfähig |
| Computer use | Wettbewerbsfähig | Stark | Gemischt / begrenzter Vergleich | Begrenzter Vergleich |
| Cybersecurity | Spitze, gleichauf auf CWE-bench v1 | Spitze, gleichauf | Sehr nah | Niedriger |
Argon sticht in diesem Vergleich durch Langkontext-, dokumentenlastige und professionelle Agentenarbeit hervor. Entwickler können es mit GPT-6 Astra, Claude Opus 5.5 und Claude Fable 5.1 über CometAPI vergleichen.
Performance-based selection
Die qualitativen Labels oben fassen die ausgewählte Benchmark-Tabelle zusammen, nicht ein universelles Ranking. Bevorzuge Argon für ein Pilotprojekt, wenn die Arbeit seinen führenden Evaluierungen ähnelt; teste Astra und Opus bei terminallastigen Workloads, bevor du einen Standard auswählst.
Specifications and deployment constraints
Dieser Leistungsvergleich belegt weder einen Architekturvorteil noch einen allgemeinen Preis-/Leistungssieger. Argons Parameteranzahl und Architektur sind in den geprüften Google-Launch-Materialien nicht spezifiziert. Sein öffentlicher Input-Kontextlimit erfordert offizielle API-Dokumentation. CometAPI meldet einen gemini-4-argon-Route; bestätige die unterstützten Parameter und den Kontozugang unabhängig von Googles breiterem Rollout. Vergleiche die Limits und die tatsächlichen Aufgabenkosten jedes Pfades vor dem Deployment.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI meldet das Modell als verfügbar unter gemini-4-argon. Verwende das Kontodashboard, um einen API-Schlüssel zu erstellen, wähle diesen Identifier im Playground und führe einen Testaufruf vor der Integration aus. Das OpenAI-kompatible Beispiel nutzt die Basis-URL https://api.cometapi.com/v1. Bestätige den unterstützten Endpoint und die Parameter in der Kontodokumentation; ein Katalog-Badge allein verifiziert keinen erfolgreichen Aufruf.
- Erstelle ein CometAPI-Konto und generiere im Dashboard einen API-Schlüssel.
- Wähle gemini-4-argon und validiere eine repräsentative Anfrage im Playground.
- Konfiguriere den kompatiblen Client mit der CometAPI-Basis-URL, deinem Schlüssel und dem Modell-Identifier; bestätige das unterstützte Request-Schema und die Abrechnung vor dem Deployment.
CometAPI and official pricing
Google kündigte Einführungspreise von $2 pro eine Million Eingabe-Token und $10 pro eine Million Ausgabe-Token an, mit 95% Rabatt auf gecachte Eingaben zum Eingabe-Tarif. Nach der Einführungsphase liegen die angekündigten Sätze bei $4 Input und $20 Output pro eine Million Token. Dies sind Googles angekündigte Sätze, nicht die CometAPI-Preise oder eine Bestätigung eines sofortigen allgemeinen API-Zugangs.
| Billing basis | Gemini 4 Argon API in CometAPI | Google official announcement | Comparison |
|---|---|---|---|
| Input / 1M tokens | $3.20 | $4.00 nach Einführungsphase | 20% unter dem angekündigten Post-Intro-Satz |
| Output / 1M tokens | $16.00 | $20.00 nach Einführungsphase | 20% unter dem angekündigten Post-Intro-Satz |
Conclusion
Das Benchmark-Profil von Gemini 4 Argon ist interessanter als ein simples Leaderboard.
Die stärksten Ergebnisse in diesem Vergleich bündeln sich um professionelle Wissensarbeit, langen Kontext und nachhaltige Agenten-Ausführung. Dieses Muster ist nützlich für die Workload-Auswahl, identifiziert jedoch nicht die zugrunde liegende Architektur und beweist nicht, welcher Mechanismus die Zugewinne verursacht hat.
Die gemeldeten Resultate in Finanzen, Recht, Langvideo und Software-Engineering stützen ein fokussiertes Pilotprojekt für diese Workloads. Ob derselbe Vorteil in Produktion anhält, hängt vom Input-Mix, dem Agenten-Framework, den Inferenz-Settings und den Verifikationsanforderungen ab.
Gleichzeitig zeigen die Ergebnisse, dass die Performance von Frontier-Modellen zunehmend spezialisiert wird. Argon kann DeepSWE anführen und bei FrontierSWE zurückliegen; Agent's Last Exam anführen und bei OSWorld zurückliegen; LABBench anführen und bei Terminal-Bench Science zurückliegen. Diese Benchmarks belasten unterschiedliche Teile eines Agentensystems.
Für Entwickler ist die wichtigste Lektion, dass die Modellauswahl zunehmend auf Workload-Ebene statt nach Marke oder Familie erfolgen muss.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Erstelle einen repräsentativen Aufgabenbestand mit expliziten Akzeptanzkriterien. Halte Tools, Zeitlimits, Input-Aufbereitung und Retry-Policies zwischen Modellen vergleichbar. Erfasse abgeschlossene Aufgaben, Gesamt-Token, verstrichene Zeit und menschliche Korrektur. Starte mit einem kleinen Pilot und untersuche Fehlerfälle, bevor du Produktionstraffic routest.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
Nein. Die Tabelle kombiniert unterschiedliche Metriken, einschließlich F1, Bestehensraten und Teil-Scores. Verwende aufgabenspezifische Kriterien statt alle Prozentsätze zu mitteln.
Should a Gemini 4 Argon agent always use its full output budget?
Nein. Wähle den kleinsten getesteten Etat, der deine Qualitäts- und Zuverlässigkeitsanforderungen erfüllt. Das maximale Ausgabe-Limit ist eine Decke, kein Zielwert.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Beginne mit einer Verfügbarkeitsprüfung auf Kontoebene und einem kleinen Request über die dokumentierte CometAPI-Route. Miss Antwortqualität, Latenz, Limits und abgerechnete Token und wende dieselben Akzeptanztests an wie für alternative Modelle. Behandle CometAPIs Zugangsangabe getrennt von Googles breiterem Rollout, und halte das Routing konfigurierbar, bis der Pfad deine Anforderungen erfüllt.