
TL;DR
Beginnen Sie mit GPT-6.1 Sol, wenn Sie bereits OpenAI Responses-Tools verwenden oder seine explizite Aufwandsleiter für das Reasoning benötigen; testen Sie Claude Sonnet 5.5 für klar abgegrenzte Coding-Iteration und vorlagengetriebene professionelle Deliverables. Dies sind Bewertungsprioritäten, kein belegtes Qualitätsranking. Beide starten bei $2/M Input und $10/M Output und berechnen $0.10/M für Basis-Cache-Lesevorgänge. Bei ungefähr 1M Kontext und 128K standardmäßiger maximaler Ausgabe liegen die praktischen Unterschiede in Integration, Aufgabenverhalten, Cache-Retention und Langkontext-Abrechnung, nicht in einem Rabatt für Basis-Cache-Lesevorgänge.
Der zentrale Trade-off betrifft Aufgabenverhalten und Abrechnungsbedingungen. GPT-6.1 Sol nutzt fünf Aufwandsstufen und erfordert für Toolaufrufe Responses; Sonnet 5.5 verwendet adaptives Denken. Oberhalb von 272K Input-Token wendet GPT-6.1 Sol höhere Sätze auf die gesamte Anfrage an. Die hier betrachteten Quellen etablieren keinen Sieger in einem abgestimmten Benchmark für exakt diese Versionen; wählen Sie das Modell, das Ihre Abnahmekriterien bei den niedrigsten Gesamtkosten des Workflows erfüllt.
Zentrale Punkte
- Gleich hohe Basistarife: Beide Modelle berechnen $2/M Input, $10/M Output und $0.10/M für Cache-Lesevorgänge. Vergleichen Sie Cache-Schreibvorgänge, Retention, Langkontext-Stufen und tatsächlich abgerechnete Nutzung.
- Kontext ist ähnlich: 1.05M gegenüber 1M Token; beide unterstützen 128K standardmäßige maximale Ausgabe.
- Integration unterscheidet sich: GPT-6.1 Sol erfordert für Toolaufrufe Responses und akzeptiert keinen oder minimalen Aufwand; Sonnet 5.5 verwendet adaptives Denken und modellspezifische Tool-Einschränkungen.
- Nachweise versionsspezifisch halten: GPT-6 Sol-Werte dürfen nicht als Ergebnisse von GPT-6.1 Sol umgelabelt werden.
- Nach erledigter Arbeit entscheiden: Messen Sie Qualität, Latenz, Retries, Cache-Schreib- und -Lesevorgänge, Tool-Gebühren und menschliche Korrektur.
GPT-6.1 Sol vs Claude Sonnet 5.5 auf einen Blick
| Decision factor / specification | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Provider | OpenAI | Anthropic |
| Release date | 29. September 2026 | 28. September 2026 |
| Model ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Context / standard maximum output | 1,050,000 / 128,000 tokens | 1,000,000 / 128,000 tokens |
| Input → output | Text und Bilder → Text | Text und Bilder → Text |
| Reasoning controls | low, medium, high, xhigh, max; medium Standard | Adaptives Denken; high Standard auf Claude Platform |
| Default effort | medium | high auf Claude Platform |
| Knowledge cutoff | 30. April 2026 | Juni 2026 |
| Official base input / output per 1M tokens | $2 / $10; Standardanfragen mit bis zu 272K Input-Token | $2 / $10 |
| Official base cache reads per 1M tokens | $0.10 | $0.10 |
| Official base cache writes per 1M tokens | $2.50 | $2.50 für 5 Minuten; $4.00 für 1 Stunde |
| Long-context billing | Über 272K Input: $4 Input, $0.20 Cache Read, $5 Cache Write, $15 Output pro 1M; gilt für die gesamte Standardanfrage | Kein entsprechender Zuschlag in der zitierten Modellübersicht |
| Primary positioning | Komplexes Coding, Computernutzung und professionelle Arbeit | Schnelle Coding-Iteration und professionelle Workflows |
| Test first when | Sie bereits Responses-Tools verwenden oder explizite Aufwandssteuerung benötigen | Ihre Arbeit auf Coding, Dokumente, Folien oder Tabellen zentriert ist |
| Evidence and decision limit | Dokumentierte Fähigkeiten; kein abgestimmter numerischer Sieger für exakt diese Version hier belegt | Veröffentlichte Coding- und Knowledge-Work-Ergebnisse; kein kontrollierter Sieg über GPT-6.1 Sol |
GPT-6.1 Sol Überblick
GPT-6.1 Sol ist OpenAIs Sol-Release vom 29. September 2026 für komplexes Coding, Computernutzung und professionelle Arbeit. OpenAI beschreibt es als nahe an Astra-Performance bei geringeren Kosten (https://developers.openai.com/api/docs/models/gpt-6.1-sol); diese Positionierung sollte an Ihren Aufgaben validiert werden. Sein großer Kontext und die einstellbare Denk-Tiefe machen es zu einem Kandidaten für Repository-Agenten und mehrstufige professionelle Workflows.
Seine betrieblichen Einschränkungen sind ebenso wichtig wie die Positionierung: medium ist der Standardaufwand, low die niedrigste unterstützte Stufe, und Toolaufrufe erfordern Responses. Ein Workflow, der auf einem No-Reasoning-Pfad oder Chat Completions-Tools basiert, benötigt Migrationsarbeit, bevor dieses Modell zuverlässig genutzt werden kann.
Claude Sonnet 5.5 Überblick
Claude Sonnet 5.5 ist Anthropics Release vom 28. September 2026 für klar abgegrenztes Alltags-Coding, Agenten und professionelle Arbeit. Die Modellübersicht (https://platform.claude.com/docs/en/models/sonnet-5-5/overview) dokumentiert adaptives Denken, einen hohen Standardaufwand auf der Claude Platform, Text-und-Bild-Input und 128K standardmäßige maximale Ausgabe. Anthropic betont Bugfixing, klare Dokumente, polierte Folien und effiziente Iteration.
Für ein Entwicklungsteam macht das Sonnet zu einem nützlichen Kandidaten für wiederholte Implementierungs- und Review-Zyklen. Für Office-Workflows bewerten Sie Erstentwurfsqualität und Vorlagentreue. Die Geschwindigkeitsbehauptung des Anbieters vergleicht Sonnet 5.5 mit Sonnet 5; sie etabliert keinen Geschwindigkeitsvorteil gegenüber GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
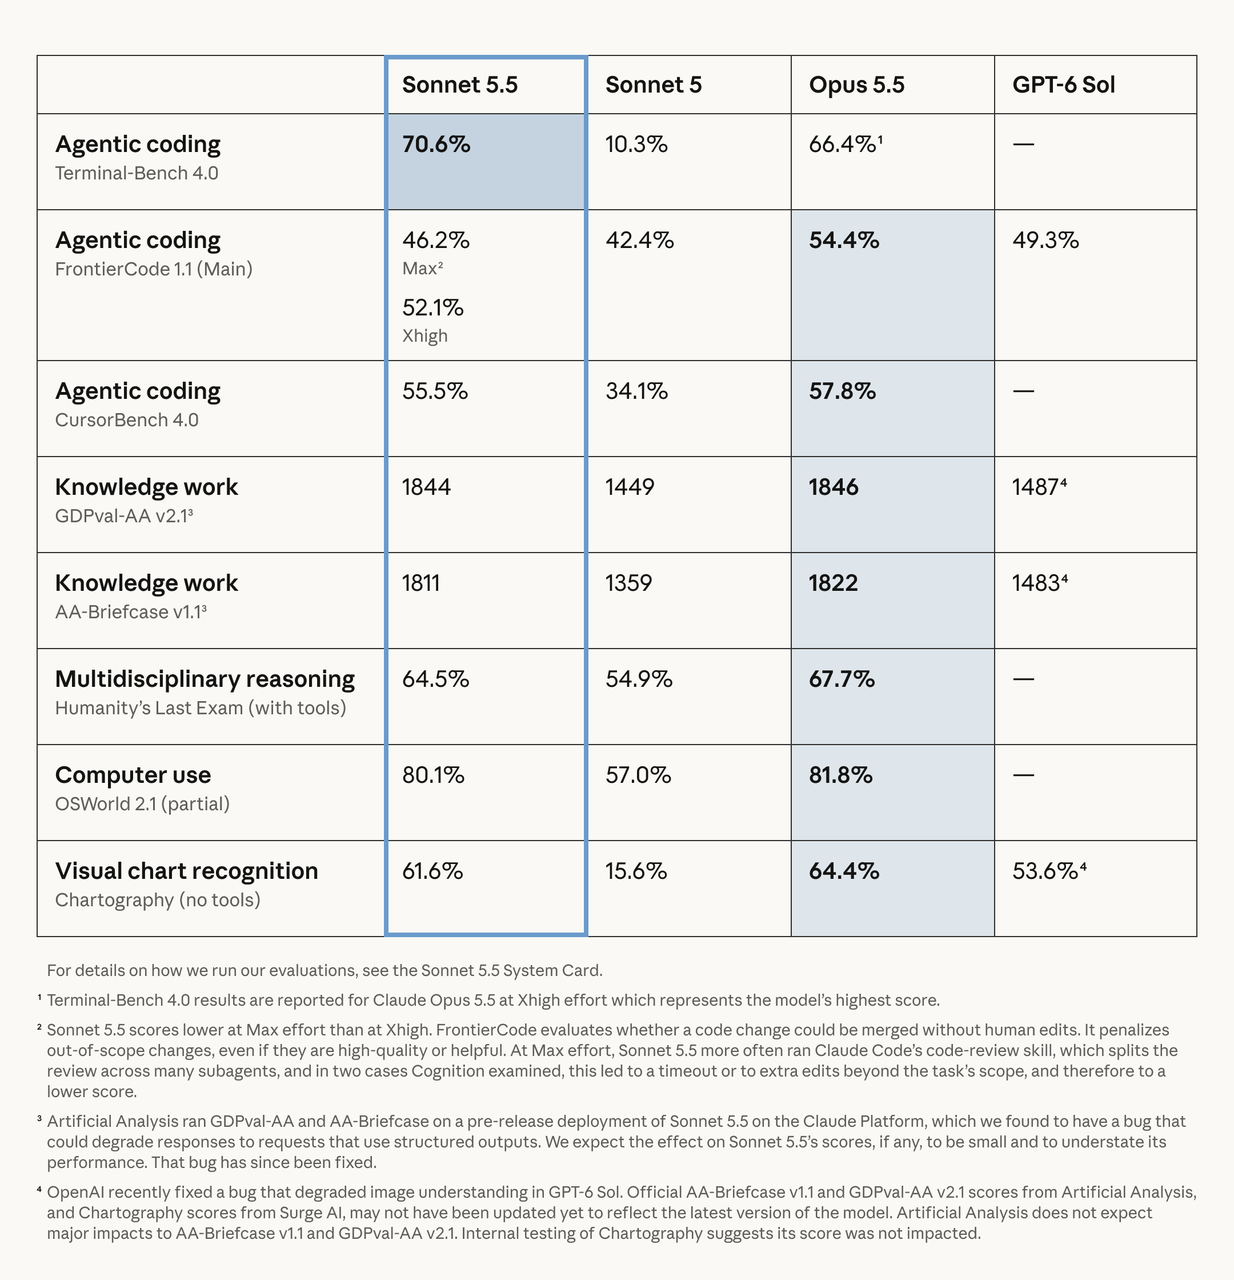
Anthropics Sonnet-5.5-Launch-Ergebnisse (https://www.anthropic.com/claude-sonnet-5-5) liefern ein nützliches Set an Workload-Signalen. Der Vergleich umfasst das ältere GPT-6 Sol, daher sind diese OpenAI-Spaltenwerte in der aktuellen Modelltabelle unten ausgeschlossen. „Nicht belegt“ bedeutet, dass die zitierten Quellen keinen exakten Versionsvergleich für diese Gegenüberstellung unterstützen; es bedeutet nicht null Performance.
| Benchmark / conditions | GPT-6.1 Sol | Claude Sonnet 5.5 | What it measures |
|---|---|---|---|
| Terminal-Bench 4.0 | Not established here | 70.6% | Terminal coding tasks |
| FrontierCode 1.1 Main | Not established here | 52.1% Xhigh; 46.2% Max | Mergeable repository changes |
| CursorBench 4.0 | Not established here | 55.5% | Agentic development in Cursor tasks |
| GDPval-AA v2.1 | Not established here | 1844 | Professional knowledge work |
| AA-Briefcase v1.1 | Not established here | 1811 | Long-horizon knowledge work |
| Humanity’s Last Exam, tools | Not established here | 64.5% | Multidisciplinary reasoning |
| OSWorld 2.1, partial | Not established here | 80.1% | Computer-use partial reward |
| Chartography, no tools | Not established here | 61.6% | Visual chart recognition |
Testbedingungen: Aufwand und Agenten-Harness beeinflussen die Coding-Ergebnisse. GDPval-AA und AA-Briefcase sind Bewertungen von Artificial Analysis, während Chartography-Ergebnisse von Surge AI stammen. Anthropic weist auf einen anschließend behobenen Structured-Output-Bug in der Pre-Release-Sonnet-Bereitstellung hin, der die Professional-Work-Ergebnisse leicht unterschätzt haben könnte. Verwenden Sie den System-Card-Link der Ankündigung für Testumgebungen und vollständige Methodik; kombinieren Sie unähnliche Metriken nicht zu einem Gesamtranking.
Das ursprüngliche Anthropic-Bild unten enthält die Evaluierungs-Fußnoten. Die GPT-6 Sol-Spalte ist nur historischer Kontext und berichtet keine GPT-6.1-Sol-Performance.
Agentisches Coding und Software Engineering
Sonnet 5.5 hat berichtete Evidenz zu Terminal-Coding, zusammenführbaren Codeänderungen und IDE-ähnlichen Agentenaufgaben. GPT-6.1 Sol ist für komplexes Coding dokumentiert und integriert sich in das OpenAI-Tool-Ökosystem. Weder Produktpositionierung noch die Punktzahl eines Vorgängers etablieren einen aktuellen Coding-Sieger. Für eine nützliche Evaluierung wählen Sie reale Änderungen mit Regressionstests und lassen Reviewer Umfang, Wartbarkeit und Merge-Reife beurteilen.
Wissensarbeit, Reasoning, Mathematik und Wissenschaft
Sonnets GDPval-AA- und AA-Briefcase-Ergebnisse machen Berichte, Analysen und Office-Deliverables zu sinnvollen Evaluierungszielen. GPT-6.1 Sol zielt ebenfalls auf professionelle Arbeit, doch liefern die hier verwendeten Quellen keinen abgeglichenen Vergleich über diese Modelle. Nutzen Sie Ihre eigenen Dokument-, Tabellen- und Präsentationsvorlagen. Fortgeschrittene Mathematik und wissenschaftliche Claims erfordern aufgabenspezifische Evidenz statt Extrapolation aus allgemeinen Reasoning-Kontrollen.
Computernutzung, Browser-Automatisierung und multimodale Workflows
Beide Modelle akzeptieren Bilder, was Screenshot-Debugging und visuelle Analysen unterstützt. Sonnets OSWorld- und Chartography-Ergebnisse sind Evidenz für diese spezifischen Evaluierungen. Testen Sie den gesamten Workflow: Navigationsgenauigkeit, Erholung nach einem fehlgeschlagenen Toolaufruf, Korrektheit der Ausgabe und Zeit bis zur Fertigstellung. Text-und-Bild-Input garantiert für sich genommen keine identische Computernutzungs-Integration.
Unabhängige Evaluierung und Evidenzqualität
Eine vom Anbieter veröffentlichte Tabelle kann Drittresultate enthalten, ohne ein einzelnes kontrolliertes Experiment zu sein. Für jeden unabhängigen Vergleich protokollieren Sie die exakten Modell-IDs, Bereitstellungsdaten, Aufwand, Tools, Schutzmaßnahmen, Timeout, Retry-Policy und Abbruchregeln. Ein aggregierter Intelligenzindex, eine Coding-Erfolgsrate und eine Teilbelohnungs-Computer-Nutzungskennzahl beantworten unterschiedliche Fragen. Die geprüften Quellen etablieren kein vollständiges, abgeglichenes, unabhängiges Resultatset für genau dieses Paar.
GPT-6.1 Sol vs Claude Sonnet 5.5: Kosten
Offizielle API-Preise
| Pricing metric | GPT-6.1 Sol official rates | Claude Sonnet 5.5 official rates |
|---|---|---|
| Input / 1M tokens, base Standard | $2.00 | $2.00 |
| Output / 1M tokens, base Standard | $10.00 | $10.00 |
| Cache read / 1M tokens, base | $0.10 | $0.10 |
| Cache write / 1M tokens, base | $2.50 | $2.50 for 5m; $4.00 for 1h |
| Batch processing | 50% unter Standard | 50% Input/Output-Rabatt |
| Input above 272K, Standard full request | $4 Input / $0.20 Cache Read / $5 Cache Write / $15 Output | Kein entsprechender Zuschlag in der zitierten Übersicht |
Alle Tarife sind USD pro eine Million Token. GPT-6.1 Sol-Basis-Cache-Lesevorgänge kosten $0.10/M (https://developers.openai.com/api/docs/models/gpt-6.1-sol) und Sonnet-5.5-Cache-Lesevorgänge ebenfalls $0.10/M (https://platform.claude.com/docs/en/models/sonnet-5-5/overview). Sols Bedingung oberhalb von 272K Input erhöht die Sätze für die gesamte Standardanfrage, nicht nur für überschüssige Token. Vergleichen Sie Cache-Schreibvorgänge, Retention, Langkontext-Stufen, regionale Verarbeitung und Service-Tiers; der Basis-Read-Preis allein verschafft keinem Modell einen Vorteil.
Kosten pro abgeschlossener Aufgabe
Kosten pro akzeptiertem Ergebnis = Gesamtkosten über alle versuchten Aufgaben / Anzahl akzeptierter Ergebnisse. Gesamtkosten umfassen abgerechneten frischen Input, Cache-Lese- und -Schreibvorgänge, Output (einschließlich abgerechneter Reasoning-Token, sofern zutreffend), bezahlte Toolaufrufe sowie menschliches Review oder Korrektur. Retry-Kosten werden gemäß ihrer tatsächlichen Nutzung gezählt, nicht doppelt als Duplikatgebühr.
Bei einer Million Cache-Lese-Token, die vollständig zum Basissatz abgerechnet werden, kosten beide Modelle $0.10; die Basis-Read-Preisdifferenz beträgt $0.00. Dies ist eine Tarifillustration, keine Sol-Anfrage mit einer Million Input-Token zum Basistarif. Die tatsächlichen Sitzungskosten umfassen außerdem frischen Input, Cache-Schreibvorgänge, Output, Tools und Retries. Vergleichen Sie kalte und warme Sitzungen unter der jeweils geltenden Kontextstufe und berichten Sie die Rate akzeptierter Ergebnisse zusammen mit der abgerechneten Nutzung.
CometAPI-Preise
| Published CometAPI tier | GPT-6.1 Sol API in CometAPI | Claude Sonnet 5.5 API in CometAPI |
|---|---|---|
| Base input / output per 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Base discount vs provider | 20% | 20% |
| GPT long-context input / output | $3.20 / $12.00 | Check current route-specific terms |
| GPT cache reads, base / long | $0.08 / $0.16 | Not specified in the cited basic pricing table |
Dies sind die veröffentlichten Modellrouten-Preise, die für diese Revision geprüft wurden, getrennt von Anbietertarifen. Die CometAPI-Preise von GPT-6.1 Sol unterscheiden zwischen kurzem und langem Kontext. Die zitierte Sonnet-Basistabelle listet Input und Output; sie rechtfertigt keine Annahme einer identischen Gateway-Cache-Policy. Prüfen Sie die aktuellen Abrechnungsbedingungen der gewählten Route, bevor Sie eine Produktionssitzung schätzen.
Wie vergleichen sich Kontextfenster, Geschwindigkeit und technische Spezifikationen?
GPT-6.1 Sol unterstützt 1.05M Token, während Claude Sonnet 5.5 1M Token unterstützt. Der nominelle Unterschied beträgt nur etwa 5%, daher wird die Kontextkapazität allein die meisten Deployments kaum entscheiden.
Die Aufwandsleiter von GPT-6.1 Sol ist low, medium, high, xhigh und max; medium ist der Standard. Sonnet 5.5 nutzt adaptives Denken, mit high als Standard auf der Claude Platform. Diese Bezeichnungen implizieren keine gleichen Reasoning-Budgets. Bei gleichen Qualitätsanforderungen messen Sie Time-to-First-Token, Output-Durchsatz, Tool-Loop-Latenz und End-to-End-Fertigstellung separat.
Anthropic berichtet mehr als 30% schnellere Output-Generierung für Sonnet 5.5 gegenüber Sonnet 5. Behandeln Sie das als Vorgängervergleich. Die Evidenz in diesem Artikel etabliert weder eine universelle Latenzzahl für GPT-6.1 Sol noch einen direkten Geschwindigkeitssieger zwischen den aktuellen Modellen. Für interaktive Workloads testen Sie niedrigere Aufwandsstufen gegen dieselbe Abnahmematrix, statt anzunehmen, dass max die beste Deployment-Einstellung ist.
Was ist für Sicherheit, Alignment und Deployment wichtig?
Deployment-Entscheidungen sollten dokumentiertes Modellverhalten von Applikationskontrollen unterscheiden. Ein Modellvergleich allein kann nicht feststellen, welche Bereitstellung die Datenverarbeitungs- oder Zugriffsanforderungen Ihrer Organisation erfüllt. Evaluieren Sie den tatsächlich verwendeten Anbieter oder das Gateway, einschließlich Request-Logging, Datenresidenz, Tool-Berechtigungen und Fehlerbehandlung.
- Reasoning-Migration: GPT-6.1 Sol unterstützt neither none nor minimal. OpenAIs Migrationsleitfaden (https://developers.openai.com/api/docs/guides/latest-model) verweist für Toolaufrufe auf Responses.
- Claude-Toolverhalten: Sonnets dokumentierte Kompatibilitätsänderungen (https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5) umfassen nicht unterstützte erzwungene Tool-Modi und konversationsgebundene Thinking-Blöcke. Testen Sie diese Pfade vor dem Rollout.
- Betriebliche Kontrollen: Geben Sie Agenten nur die für die Aufgabe benötigten Tools, protokollieren Sie fehlgeschlagene Aufrufe, und behalten Sie menschliches Review für folgenschwere externe Aktionen bei. Dies sind Entscheidungen des Applikationsdesigns, keine gemessenen Vorteile für eines der Modelle.
GPT-6.1 Sol vs Claude Sonnet 5.5: Welche sollten Sie wählen?
Testen Sie GPT-6.1 Sol zuerst, wenn Sie bereits Responses-Tools nutzen oder eine vorhersehbare Aufwandsleiter benötigen. Testen Sie Sonnet 5.5 für klar abgegrenzte Coding-Iteration, Folien, Tabellen und Dokument-Workflows, bei denen seine berichtete Evidenz zu Ihren Aufgaben passt. Für Sitzungen mit zwischengespeicherten Präfixen testen Sie beide: Ihre Basis-Cache-Read-Sätze sind gleich, während Schreibkosten, Retention, Langkontext-Stufen und Erfolg der Aufgabe die Gesamtrechnung verändern können. Routen Sie Arbeit erst nach repräsentativen Evaluierungen, die einen nützlichen Unterschied bei Qualität, Kosten oder Latenz etablieren.
Arbeitslastbasierte Auswahl
| Workload | Starting point | What to verify |
|---|---|---|
| Existing OpenAI Responses agent | GPT-6.1 Sol | Tool compatibility and effort changes |
| Coding iteration / bug fixing | Sonnet 5.5, then compare Sol | Merge readiness, latency and retries |
| Slides / spreadsheets / reports | Sonnet 5.5, then compare Sol | Template adherence and human edit time |
| Stable cached-prefix sessions | Both; equal base cache-read rates | Hit rate, writes, context tier and accepted quality |
| Full requests above 272K input | Both | Actual long-context bill and retrieval quality |
| Computer / browser automation | Both | Recovery, task completion and permissions |
| Math / scientific analysis | Both on task-specific tests | Correctness with verifiable answers |
| Cost-sensitive production | Both | Total cost per accepted result |
Ein Produktionsvergleich sollte das umgebende System konstant halten. Verwenden Sie dieselben Prompts, Repositories oder Dokumente, Tool-Berechtigungen, Timeout, Retry-Policy und Abnahmematrix.
Protokollieren Sie frischen Input, Cache-Schreib- und -Lesevorgänge, Output-Nutzung, bezahlte Toolaufrufe, Retries, Zeit für menschliches Review, Aufgabenerfolg und End-to-End-Latenz. Eine günstigere erste Antwort kann dennoch ein teureres akzeptiertes Ergebnis erzeugen.
Wie erhalten Sie Zugriff auf GPT-6.1 Sol und Claude Sonnet 5.5?
Entwickler können über die dokumentierten Modellrouten auf die GPT-6.1-Sol-API in CometAPI (https://www.cometapi.com/models/openai/gpt-6-1-sol/) und die Claude-Sonnet-5.5-API in CometAPI (https://www.cometapi.com/models/anthropic/claude-sonnet-5-5/) zugreifen. Erstellen Sie einen API-Schlüssel, speichern Sie ihn sicher, und verifizieren Sie Modellzugriff und routenspezifische Abrechnung vor dem Produktionseinsatz.
GPT-6.1 Sol Zugriff
Für Sol verwenden Sie die dokumentierte Responses-Route, wenn Toolaufrufe erforderlich sind. Wählen Sie gpt-6.1-sol und eine unterstützte Aufwandsstufe, standardmäßig medium. Übergeben Sie den Aufgabeninput, konfigurieren Sie nur die benötigten Tools und validieren Sie zurückgegebenen Text, Toolaufrufe, Fehler und Nutzung. Bestätigen Sie Gateway-Support für anbieterspezifische Funktionen, statt anzunehmen, dass jede OpenAI-Option verfügbar ist.
Claude Sonnet 5.5 Zugriff
Für Sonnet wählen Sie claude-sonnet-5-5 auf einer dokumentierten kompatiblen Schnittstelle und senden die Aufgabe als Konversationsnachrichten mit einem passenden Output-Budget. Bestätigen Sie, wie diese Route natives Thinking und Tool-Parameter handhabt; OpenAI-Reasoning-Felder sind nicht automatisch mit Claude-Optionen austauschbar. Validieren Sie Konversationsfortsetzung und Fehlerbehandlung vor dem Agenten-Deployment.
Ein Endpunkt-Check verifiziert die Konnektivität, nicht die vergleichende Performance. Für die Evaluierung gleichen Sie Prompts, effektives Output- und Reasoning-Budget, Tools, Retries, Timeouts und Abnahmekriterien ab und vergleichen anschließend akzeptierte Arbeit, Latenz und insgesamt abgerechnete Kosten.
Fazit
GPT-6.1 Sol und Claude Sonnet 5.5 teilen gleiche Basis-Input-, Output- und Cache-Read-Sätze bei ähnlicher Kontextkapazität. Sol ist ein natürlicher Kandidat für bestehende Responses-Agenten und explizite Aufwandssteuerung. Sonnets adaptives Denken und gemeldete Coding- und Professional-Work-Ergebnisse machen es zu einem nützlichen Kandidaten für Alltags-Deliverables. Cache-lastige Workflows erfordern einen Vergleich der gesamten Sitzung: Gleiche Basis-Read-Sätze garantieren keine gleichen Schreib-, Retentions-, Langkontext- oder Kosten pro fertiggestellter Aufgabe.
Wählen Sie das Modell, das Ihre tatsächliche Arbeit innerhalb von Qualitäts-, Latenz- und Kostenanforderungen erledigt. Halten Sie Vorgängerwerte getrennt von Evidenz aktueller Modelle, bepreisen Sie die Kontextstufe, die Ihre Arbeitslast nutzt, und vergleichen Sie beide Routen, bevor Sie einen Standard übernehmen.
FAQ
Können GPT-6.1 Sol und Sonnet 5.5 ein gemeinsames Tool-Schema verwenden?
Eine gemeinsame JSON-Tooldefinition kann ein Ausgangspunkt sein, aber Endpunkt-Support, erzwungene Tool-Modi, Thinking-Blöcke und Antwortverarbeitung unterscheiden sich. Validieren Sie die Toolaufrufe jedes Modells mit Kontrakttests für Argumente, Fehlerpfade und Konversationsfortsetzung. Behalten Sie modellspezifische Adapter für nicht unterstützte Optionen bei, statt anzunehmen, dass eine erfolgreiche Textanfrage Agentenkompatibilität beweist.
Wie sollte der Reasoning-Aufwand zwischen beiden Modellen abgeglichen werden?
Behandeln Sie identisch benannte Einstellungen nicht als gleiche Compute-Budgets. Definieren Sie eine Abnahmematrix und entweder ein Kostenlimit oder ein Latenzziel, und sweepen Sie die Aufwandsstufen für jedes Modell. Vergleichen Sie die beste Konfiguration, die dieselbe betriebliche Vorgabe erfüllt – einschließlich Retries und menschlicher Korrektur – statt nur die höchsten Stufen beider Modelle gegenüberzustellen.
Wann sollte ein 1M-Kontext-Workflow stattdessen Retrieval verwenden?
Nutzen Sie Retrieval, wenn eine Aufgabe einen kleinen, identifizierbaren Teil eines großen Korpus benötigt und Ihre Retrieval-Tests zeigen, dass relevantes Material konsistent wiedergefunden wird. Testen Sie Vollkontext-Anfragen, wenn Evidenz verteilt ist oder Querverbindungen zwischen Dateien wichtig sind. Vergleichen Sie Antwortkorrektheit, Zitierungsabdeckung, Inputkosten und Latenz; ein großes Kontextlimit allein begründet nicht, dass das gesamte Fenster zu füllen wirtschaftlich oder zuverlässig ist.
Wie vermeiden Teams einen irreführenden Cache-Kostenvergleich?
Messen Sie Cold-Cache- und Warm-Cache-Läufe separat, erfassen Sie Cache-Schreibvorgänge ebenso wie Lesevorgänge, und wenden Sie das korrekte Retentionsfenster und die Langkontext-Stufe an. Halten Sie gemeinsame Präfixe stabil und vergleichen Sie wiederholte realistische Sitzungen – nicht nur eine rabattierte Anfrage. Berichten Sie die Trefferquote und die insgesamt abgerechnete Nutzung, damit ein scheinbarer Spareffekt reproduzierbar ist.
Was sollte eine neue Evaluierung GPT-6.1 Sol vs Sonnet 5.5 auslösen?
Führen Sie die betroffene Aufgabensuite nach einem Deployment-Update, Anbieter-Bugfix, Routing-Änderung, Tool- oder Prompt-Änderung oder einer wesentlichen Preisrevision erneut aus. Protokollieren Sie Evaluierungsdatum, Modell-ID, Endpunkt, Aufwand und Harness-Version. Bewahren Sie den früheren Lauf als Baseline auf, damit Qualitäts- oder Latenzänderungen nicht mit Änderungen im umgebenden System verwechselt werden.