Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
So führen Sie MiniMax M3.1 Flash lokal aus: GPU-, vLLM- & SGLang-Leitfaden
Erfahren Sie, wie Sie MiniMax M3.1 Flash lokal ausführen. Erkunden Sie dessen 428B/23B-MoE-Architektur, GPU-Anforderungen, vLLM- und SGLang-Setup, Benchmarks und API-Alternativen.
MiniMax M3.1 Flash bringt Open-Weight-KI in anspruchsvolle Coding- und Agent-Workflows, aber lokaler Betrieb erfordert ernstzunehmende Hardware. Die 428B-Parameter-MoE-Architektur aktiviert pro Token nur 23B Parameter, reduziert damit Rechenaufwand, eliminiert jedoch nicht die Notwendigkeit, das vollständige Modell zu speichern. Entwickler mit unterstützten Multi-GPU-Systemen können es mit vLLM oder SGLang bereitstellen. Wer das Infrastruktur-Management überspringen möchte, kann mit der MiniMax M3.1 Flash API in CometAPI einfacher starten.
Wichtigste Erkenntnisse
Hardware ist die größte Hürde. Die veröffentlichten vLLM-Konfigurationen nutzen vier unterstützte Blackwell- oder AMD MI355X-GPUs oder acht H100/H200-GPUs.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Langer Kontext bringt Speicherkosten mit sich. Das Modell unterstützt bis zu eine Million Tokens, aber praktische Serving-Grenzen hängen von verfügbarer GPU-Speicherkapazität und Parallelität ab.
Bereitstellung ist hardwarespezifisch. Verwenden Sie eine kompatible Inferenz-Engine, ein passendes Quantisierungsformat und eine abgestimmte Beschleunigerkonfiguration statt eines generischen Installationsbefehls.
Benchmarks sind nur ein Ausgangspunkt. Bewerten Sie Coding-Genauigkeit, Agent-Task-Erfolg, Latenz und Durchsatz unter Ihren eigenen Workloads.
Lokale und gehostete Inferenz erfüllen unterschiedliche Bedürfnisse. Self-Hosting bietet mehr Infrastrukturkontrolle, API-Zugriff reduziert Setup-Komplexität und Wartungsaufwand.
Was ist MiniMax M3.1 Flash?
MiniMax M3.1 Flash akzeptiert Text, Bilder und Video und generiert Text. Es ist für Coding, Automatisierung, Computerinteraktion und Security-Workflows ausgelegt. Die Gewichte werden unter der MiniMax Community License verteilt. Bevor Sie einen kommerziellen Dienst anbieten, lesen Sie die mit dem Checkpoint gelieferte Lizenz und prüfen Sie die für Ihre Nutzung geltenden Bedingungen.
MiniMax M3.1 Flash Spezifikationen
Spezifikation
MiniMax M3.1 Flash
Entwickler
MiniMax
Modellfamilie
Native multimodale MoE
Gesamtparameter
Ca. 428B
Aktive Parameter
Ca. 23B pro Token
Maximaler Kontext
1.048.576 Tokens (Modellfähigkeit)
Eingabetypen
Text, Bilder und Video (routenabhängig)
Ausgabe
Text
Attention
MiniMax Sparse Attention in jeder Schicht
Quantisierung
MXFP8 dichte Schichten / NVFP4 Experten
Draft-Decoding
DSpark integrierter Draft-Head
Reasoning-Aufwand
low, medium, high, xhigh, max
Gemeldete Ausgabegeschwindigkeit
200+ Tokens/s unter günstigen Bedingungen; P50 170+ Tokens/s
Lizenz
MiniMax Community License
Dokumentierte Inferenz
vLLM, SGLang
Typische Topologie
4 unterstützte Blackwell- oder MI355X-GPUs; 8 H100/H200-GPUs
Wie nutzt MiniMax M3.1 Flash seine 428B/23B-Architektur?
Ein Mixture-of-Experts (MoE)-Modell routet jedes Token durch ausgewählte Experten. In MiniMax M3.1 Flash sind für ein Token etwa 23B Parameter aktiv, während der vollständige Parameterpool etwa 428B umfasst. Sparse-Aktivierung reduziert die Berechnung; sie macht den Checkpoint nicht zu einem dichten 23B-Modell.
Was hat sich in MiniMax M3.1 Flash geändert?
Sparse Attention: Durchgängig im Modell angewendet, um den Attention-Aufwand bei langen Eingaben zu senken; der Nutzen hängt von den Serving-Kernels und dem Prompt ab.
Gemischte Präzision der Gewichte: MXFP8-Komponenten für dichte Teile und NVFP4 für Experten senken Speicher- und Rechenbedarf, erfordern aber weiterhin kompatible Hardware und Kernel.
DSpark-Decoding: Ein integrierter Draft-Head kann die Generierung in unterstützten Recipes beschleunigen; Ergebnisse hängen von Token-Akzeptanz und Workload ab.
Strombewusstes Serving: Scheduling auf Infrastrukturebene kann die Auslastung verbessern, ist aber kein Feature, das Sie automatisch durch Download der Gewichte erhalten.
Welche Hardware wird für MiniMax M3.1 Flash benötigt?
Planen Sie GPU-Speicher in vier Teile ein: Checkpoint-Gewichte, Key-Value-(KV)-Cache für vorangegangene Tokens, Laufzeitpuffer und Reserve für Workloads. Die folgenden Schätzungen decken nur die Rohspeicherung der Parameter ab. Gemischte Präzision, Quantisierungsskalen, multimodale Komponenten und Serving-Overhead ändern den tatsächlichen Bedarf.
Validierte GPU-Topologien
Beschleuniger
Veröffentlichte Topologie
Hinweise
NVIDIA GB200/GB300/B200/B300
4 GPUs, Tensor-Parallelität
NVFP4-nativer Pfad für Blackwell
NVIDIA H100/H200
8 GPUs, Tensor-Parallelität
FP8-Caches und Marlin-MoE-Pfad
AMD MI355X
4 GPUs, Tensor-Parallelität
Erfordert unterstütztes ROCm und AITER-Einstellungen
24–32 GB Consumer-GPU
Kein Referenzrezept für Full-Checkpoint
Nicht ausreichend für einfaches Single-GPU-Laden
Nur-CPU-Workstation
Keine validierte praktische Bereitstellung
Offloading-Experimente sind keine Produktionsleitlinie
Speicherschätzung: Rohspeicher für 428B Parameter beträgt grob 856 GB bei BF16, 428 GB bei 8-Bit oder 214 GB in idealisiertem 4-Bit. Der offizielle Checkpoint mischt Formate, daher sind diese Zahlen keine VRAM-Laufzeitanforderungen. Berücksichtigen Sie Quantisierungsskalen, KV-Cache, Laufzeitpuffer und Parallelität; nutzen Sie die tatsächlichen Checkpoint-Dateien und das Rezept für Ihre GPU für die Systemdimensionierung.
Reservieren Sie NVMe-Speicher für den Checkpoint, temporäre Downloads und eine Rollback-Kopie.
Welche Bereitstellungsmethode sollten Sie wählen?
Für einen unterstützten lokalen Cluster ist vLLM ein praktischer Startpunkt mit Referenzkonfigurationen und vertrauter API-Integration; SGLang passt für Teams, die nach Kompatibilitätsprüfung Serving-Anpassungen erkunden möchten, während CometAPI einen gehosteten Weg für Prototyping und Modellwechsel bietet.
Anbieterverwaltete Inferenz; keine lokalen Gewichte
Blackwell / AMD MI355X
Hardwarespezifische Rezepte
Hardwarespezifische Rezepte
Hardware wird vom Anbieter verwaltet
H100/H200
Dokumentiertes Acht-GPU-Rezept
Aktuelle Support-Matrix prüfen
Hardware wird vom Anbieter verwaltet
Decoding und Parallelismus
DSpark auf unterstützten Pfaden; Tensor- und verteiltes Serving
Hardwarespezifisches Decoding; Tensor- und Experten-Parallelismus
Beschränkt auf die vom Pfad exponierten Optionen
Kontrolle und Datenverarbeitung
Ihre Umgebung; Skalierung liegt bei Ihnen
Ihre Umgebung; Skalierung liegt bei Ihnen
Externer Anbieter; Skalierung liegt beim Anbieter
Wählen Sie das Framework mit einem validierten Rezept für Ihre Hardware und vergleichen Sie anschließend Latenz und Durchsatz mit denselben Prompts, Präzisionsstufen und Parallelität.
Wie führt man MiniMax M3.1 Flash lokal mit vLLM aus?
Die folgenden Schritte setzen einen Linux-Host mit vier kompatiblen NVIDIA-Blackwell-GPUs, einer unterstützten Treiber/CUDA-Umgebung und Zugriff auf den offiziellen Checkpoint voraus. Verwenden Sie einen validierten vLLM-Build; eine gewöhnliche Installation auf nicht unterstützter GPU-Hardware kann trotz erfolgreicher Paketinstallation fehlschlagen.
Stellen Sie sicher, dass das installierte Wheel und die CUDA-Runtime zu Ihrer GPU-Familie passen. Falls ein projektspezifischer Development-Build erforderlich ist, folgen Sie den Referenz-Installationshinweisen, bevor Sie die Startargumente verwenden.
Verwenden Sie bei Bedarf ein geeignetes Hugging Face Access Token, erhalten Sie die Verzeichnisstruktur bei und verifizieren Sie den vollständigen Shard-Download vor dem Start des Servers.
Warten Sie, bis der Server das Laden abgeschlossen hat und „bereit“ meldet, bevor Sie eine Anfrage senden. Der obige Befehl begrenzt den Kontext auf 32.768 Tokens und die gleichzeitigen Sequenzen auf vier für einen ersten Smoke-Test. Diese reduzierten Limits sind keine benchmarkten Einstellungen; passen Sie sie nach Messung von Speicherauslastung und Anfragenverhalten auf Ihrer Hardware an.
Wenn sich der bediente Bezeichner vom Verzeichnisnamen unterscheidet, rufen Sie /v1/models auf und verwenden Sie die exakt zurückgegebene ID. Eine erfolgreiche Textantwort validiert nur die Basisinferenz; testen Sie Vision, Tool-Aufrufe, Parallelität und langen Kontext separat.
Schritt 5: Integration mit einem OpenAI-kompatiblen Python-Client
Das Beispiel lauscht auf 127.0.0.1 für lokale Tests. Bevor Sie Remote-Clients verbinden, stellen Sie Zugriffskontrollen vor den Endpunkt und konfigurieren Sie Client-Timeouts, begrenzte Wiederholungen und Monitoring.
Auf acht H100/H200-GPUs verwenden Sie den Hopper-spezifischen FP8-Cache und den Marlin-MoE-Pfad statt der Blackwell-NVFP4-Konfiguration. Der folgende Befehl folgt dem offiziellen vLLM-Hopper-Rezept mit auf 32K und vier Sequenzen reduzierten Kontext und Parallelität für einen initialen Test. Er deaktiviert Videoeingaben gemäß diesem Rezept. Belassen Sie diesen Endpunkt hinter Ihren bestehenden Zugriffskontrollen.
SGLang bietet hardwarespezifische M3.1-Bereitstellungsrezepte und OpenAI-kompatibles Serving. Im Snapshot vom 23. Oktober umfasst die Dokumentation dedizierte Development-Container-Images, daher sollte nicht davon ausgegangen werden, dass eine generische SGLang-Installation sämtliche modellspezifische Unterstützung enthält.
Dediziertes Container-Image ziehen
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Folgen Sie anschließend dem SGLang MiniMax M3.1 Cookbook für Ihren Beschleuniger. Das Pullen eines Images lädt nur die Laufzeit; Sie müssen dennoch einen Container mit GPU-Zugriff starten und darin die passende Serving-Konfiguration launchen. Verwenden Sie den vollständigen hardwarespezifischen Befehl aus dem Cookbook, warten Sie auf die Bereitschaft und fragen Sie die Modulliste des Endpunkts ab, bevor Sie eine Testanfrage senden. Die dokumentierten NVIDIA- und AMD-Pfade nutzen unterschiedliche Abhängigkeiten und sollten separat konfiguriert werden.
Wie schneidet MiniMax M3.1 Flash in Benchmarks ab?
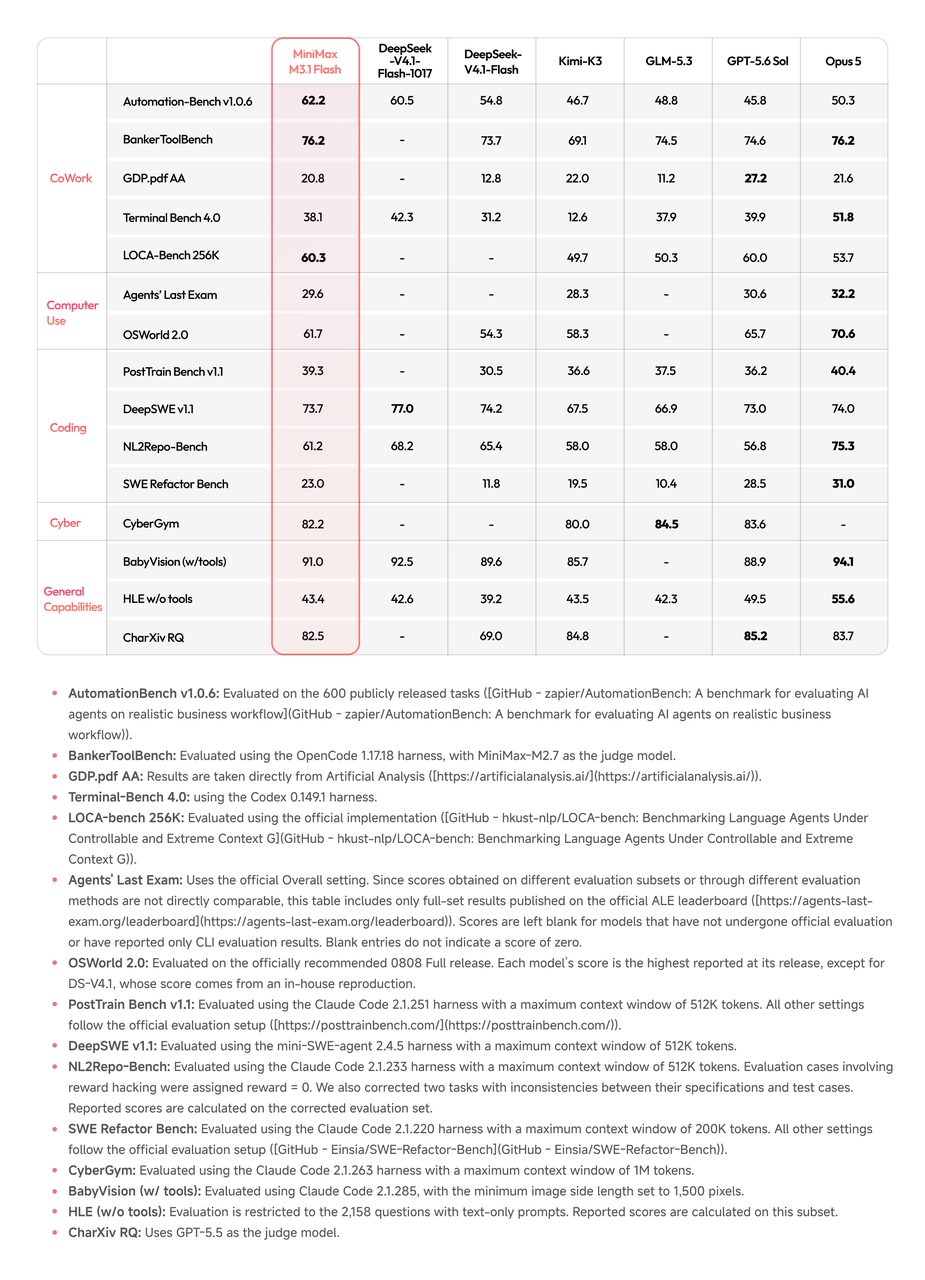
Sobald Ihr Endpunkt die Basistests besteht, nutzen Sie veröffentlichte Benchmarks, um die nächsten zu testenden Workloads auszuwählen. Die folgenden Zahlen sind Vom Anbieter veröffentlichte Bewertungen, nicht Messungen Ihrer lokalen Bereitstellung.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
In diesem Vergleich führt MiniMax bei Automation-Bench die gelisteten Modelle an, während DeepSeek mehrere Coding-Benchmarks anführt. Lesen Sie die Model Card und Evaluierungseinstellungen, bevor Sie Schlüsse ziehen, und testen Sie die Prompts und Tools, die Ihre Anwendung tatsächlich nutzt. Scores aus unterschiedlichen Benchmark-Versionen oder Setups sind nicht direkt vergleichbar.
Wie lässt sich die Leistung von MiniMax M3.1 Flash optimieren?
Kontext und Parallelität steuern
Erhöhen Sie nach der ersten erfolgreichen Anfrage jeweils nur eine Lastvariable: Eingabelänge, Ausgabelänge oder gleichzeitige Anfragen. Protokollieren Sie Spitzen-Speicherbedarf und Antwortlatenz für jeden Lauf. Behalten Sie die zuletzt stabilen Einstellungen als Rollback-Punkt bei, damit ein fehlgeschlagenes Experiment nicht Ihre neue Basislinie wird.
Reasoning-Aufwand gezielt wählen
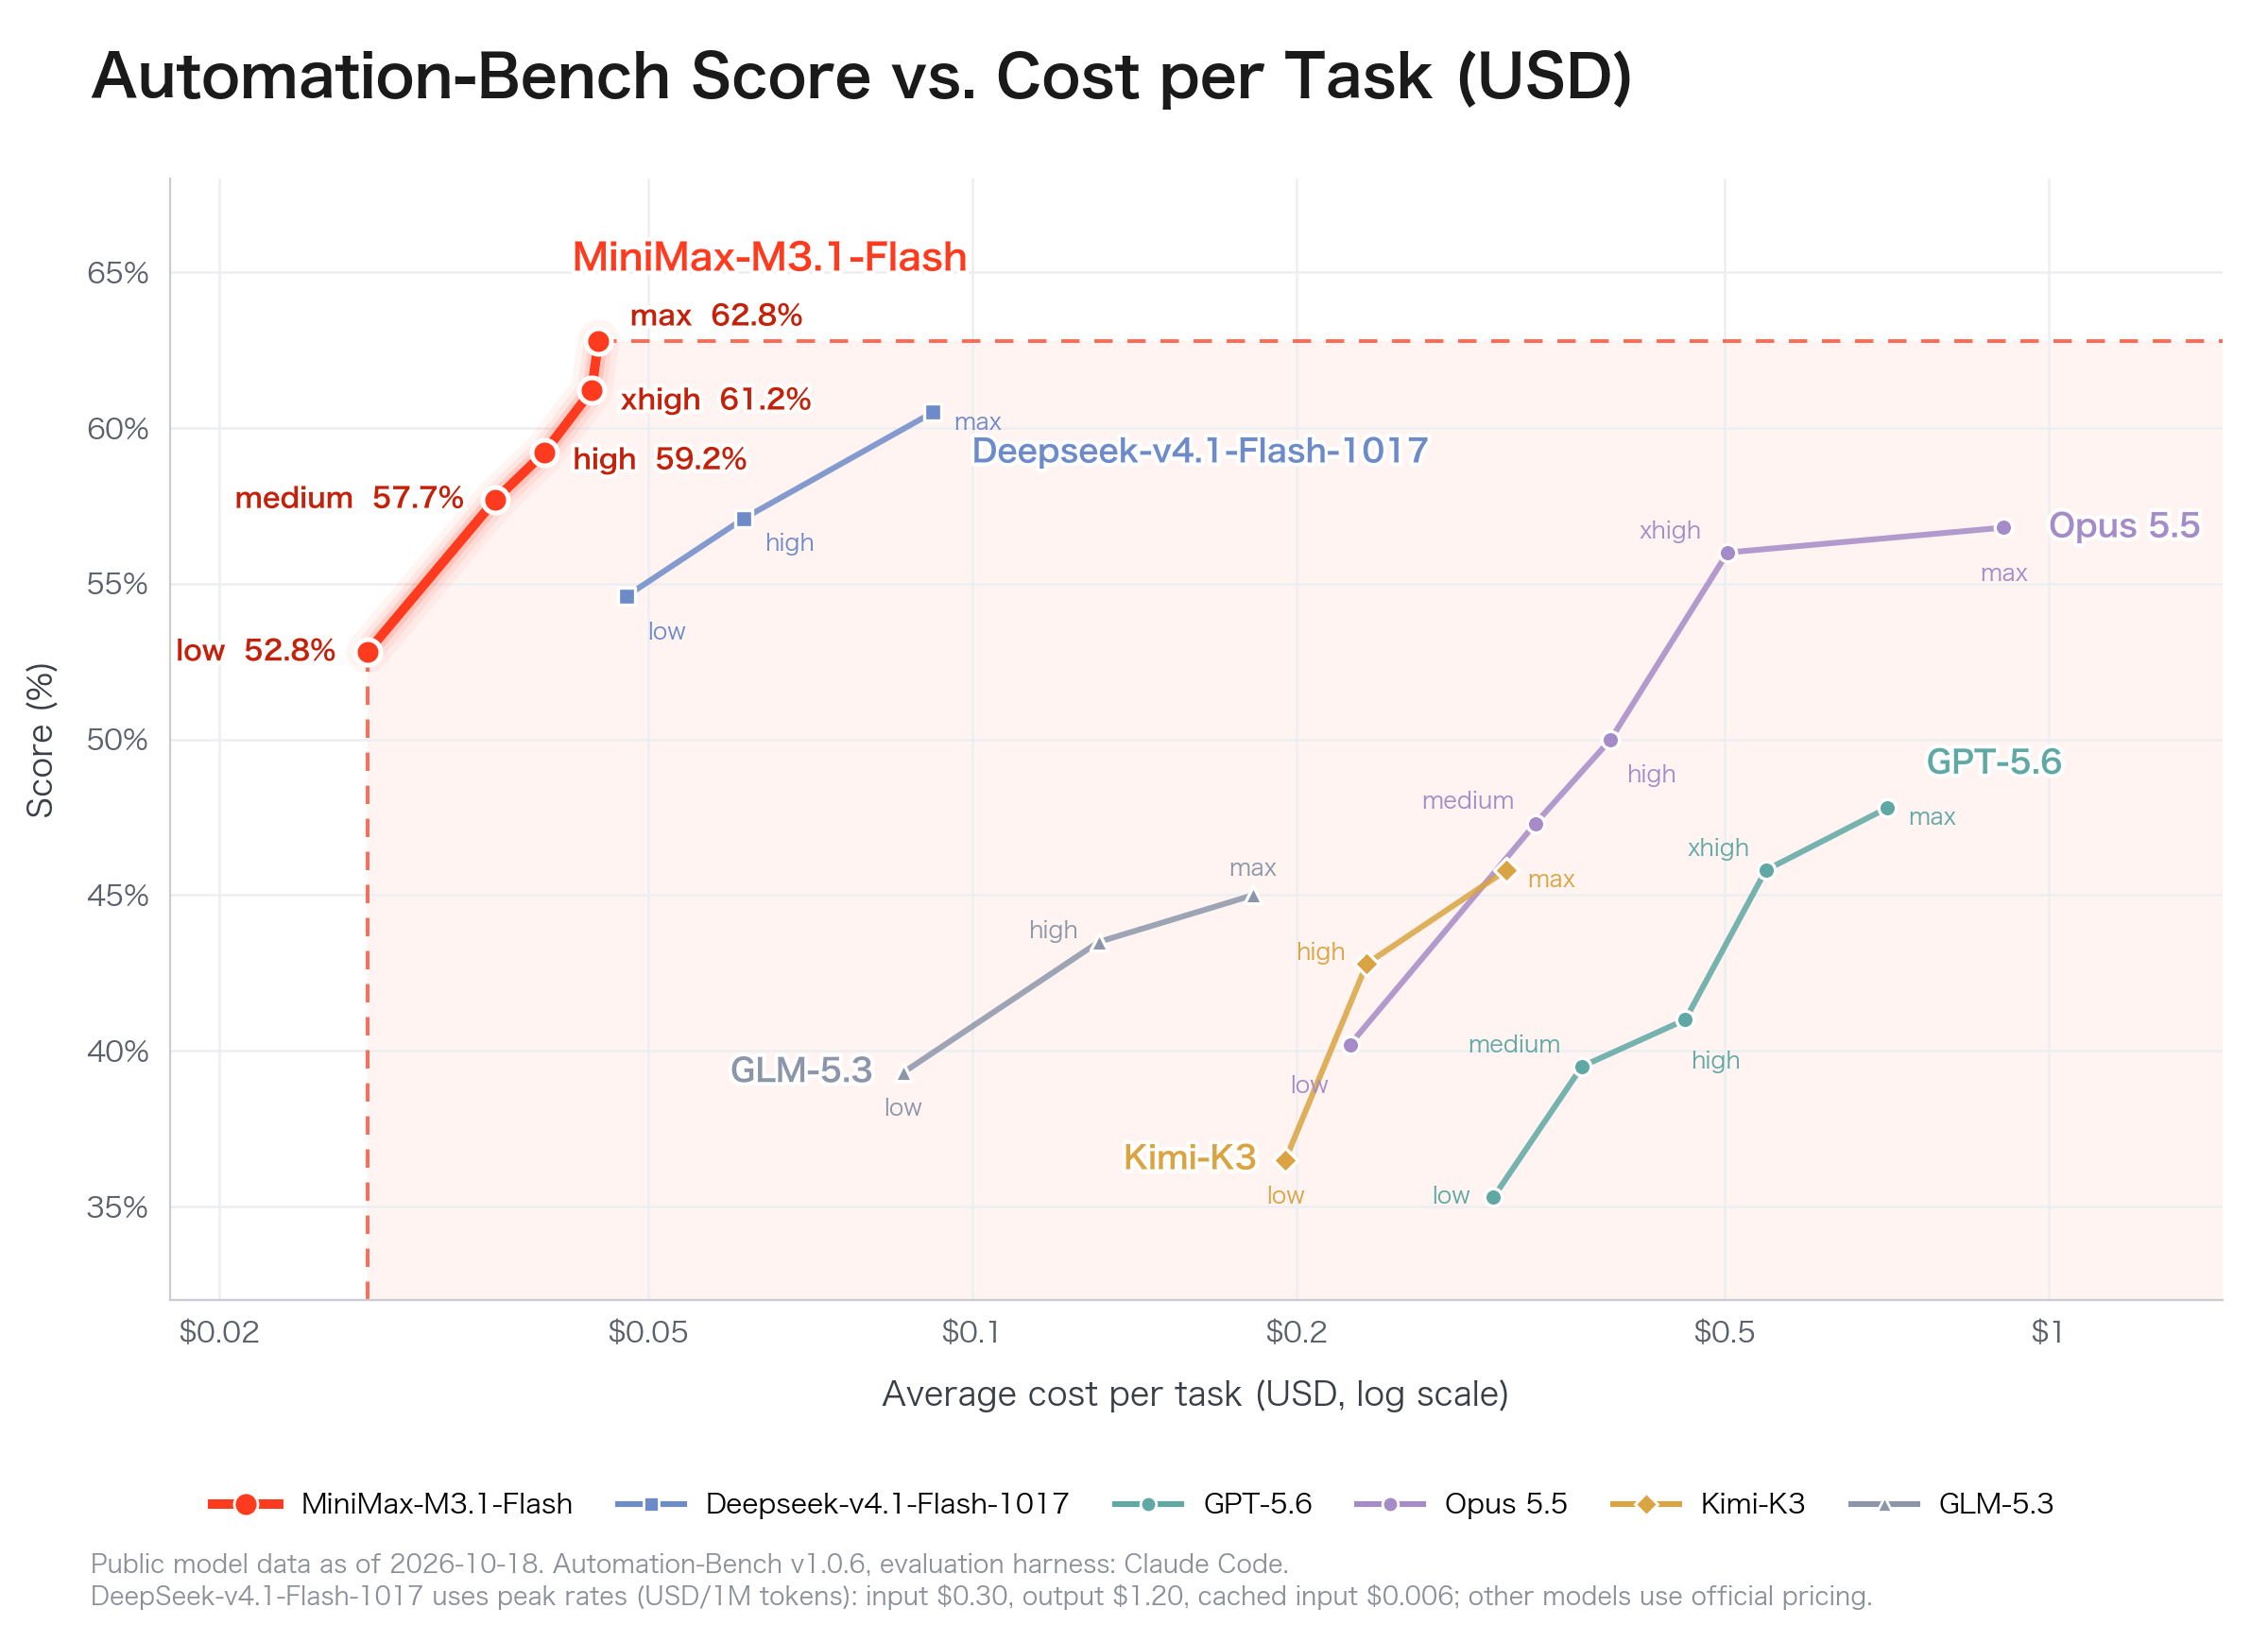
M3.1 Flash unterstützt low, medium, high, xhigh und max Aufwand. Höhere Einstellungen können anspruchsvolle Task-Scores verbessern, erfordern jedoch oft mehr Reasoning-Tokens und längere Latenz. Nutzen Sie Task-Qualität und angefallene Rechenkosten gemeinsam.
Für lokale vLLM-Anfragen zeigt das Rezept Reasoning-Effort-Settings unter chat_template_kwargs. Prüfen Sie sowohl die finale Antwort als auch ein ggf. separat zurückgegebenes Reasoning-Feld bei der Client-Validierung, da gehostete und lokale Endpunkte diese Felder unterschiedlich exponieren können.
Kosten pro abgeschlossenem Task verfolgen
Für Agents reicht Tokens pro Sekunde nicht aus. Zeichnen Sie Time-to-First-Token, Ausgaberate, Akzeptanzrate beim spekulativen Decoding, parallelen Durchsatz, Tool-Aufruf-Fehler, Speicherauslastung und Kosten pro abgeschlossenem Task auf. Eine langsamere Antwort mit weniger fehlgeschlagenen Tools kann zu einer besseren Gesamtökonomie führen.
Wie nutzt man die MiniMax M3.1 Flash API in CometAPI?
Teams, die keine dedizierte Beschleuniger-Infrastruktur benötigen, können einen OpenAI-kompatiblen gehosteten Endpunkt nutzen. Dies eliminiert Checkpoint-Download und GPU-Betrieb, verlagert die Anfrageverarbeitung jedoch aus der selbstgehosteten Umgebung.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Bestätigen Sie die Modell-ID in Ihrer CometAPI-Konsole, bevor Sie dieses Beispiel ausführen. Nutzen Sie das Gateway, wenn eine gemeinsame API über Anbieter hinweg Ihrer Anwendung hilft; vergleichen Sie das aktuelle Angebot mit direktem Zugriff für Ihre erwartete Nutzung.
MiniMax M3.1 Flash API-Preise
Preis pro Million Tokens
MiniMax offizielle API
CometAPI
Input
$0.15
$0.80
Output
$0.60
$3.20
Cached input
$0.015
Aktuelles Routen-Angebot bestätigen
Die direkten API-Preise von MiniMax in der Launch-Ankündigung vom 19. Oktober 2026 betragen $0.15 für Input, $0.60 für Output und $0.015 für gecachten Input pro Million Tokens. Für CometAPI prüfen Sie den aktiven Modellpfad, Input/Output-Raten, Caching-Regeln und eventuelle Kontorabatte, bevor Sie die Ausgaben schätzen. Vergleichen Sie die Gesamtkosten für Ihren erwarteten Token-Mix und Wiederholungen.
Welche Probleme können beim Betrieb von MiniMax M3.1 Flash auftreten?
Speicher läuft beim Laden oder bei Anfragen aus
Wenn Gewichte nicht geladen werden: Prüfen Sie die fehlschlagende Phase im Start-Log, bestätigen Sie die Vollständigkeit des Checkpoints und verifizieren Sie, dass GPU-Topologie und Quantisierungs-Backend zum Rezept passen. Wenn die Gewichte den verfügbaren Speicher überschreiten, verwenden Sie eine Konfiguration mit ausreichender Kapazität; das Verkürzen einer Anfrage kann einen Gewichts-Ladefehler nicht beheben.
Wenn Gewichte laden, aber die Cache-Allokation beim Start fehlschlägt: Prüfen Sie die Cache-Einstellungen und verfügbaren Speicher, reduzieren Sie dann den konfigurierten Kontext oder die Parallelität entsprechend dem Rezept.
Wenn der Server startet, aber eine Anfrage aus dem Speicher läuft: Wiederholen Sie einen kurzen Prompt mit einer Anfrage zur Zeit, erhöhen Sie dann Eingabelänge, Ausgabelänge und Parallelität getrennt, während Sie den Speicher überwachen.
Inkompatible Quantisierungs- oder Attention-Kernel
NVFP4-Ausführung unterscheidet sich zwischen Blackwell, Hopper und AMD-Hardware. Stimmen Sie Versionen der Inferenz-Engine, Quantisierungs-Backends, CUDA/ROCm-Versionen und Beschleunigerfamilien ab, statt Flags wahllos wiederzuverwenden.
Sparse-Attention-Cache-Konfiguration
Wenn der Start ein nicht unterstütztes Cache-Layout meldet, vergleichen Sie die vollständige Cache-Konfiguration mit dem hardwarespezifischen Rezept. Das aktuelle vLLM-Rezept erfordert --block-size 128 für den MSA-Sparse/Index-Cache. Wenn der Start einen Cache-Layout- oder Blockgrößenfehler meldet, vergleichen Sie die komplette Konfiguration mit dem Rezept für Ihre Hardware.
Unerwartete Modellbezeichner
Ein lokaler Pfad und ein Modellname eines externen Gateways sind nicht zwangsläufig identisch. Fragen Sie die lokale /v1/models-Antwort ab und vermeiden Sie Hardcodings aus einem anderen Endpunkt.
Geringe beobachtete Durchsatzleistung
Trennen Sie langsame Prompt-Verarbeitung von langsamer Tokengenerierung. Vergleichen Sie Läufe mit derselben Eingabelänge und Output-Grenze, prüfen Sie dann GPU-Auslastung und Interconnect-Verhalten, bevor Sie die Batchgröße erhöhen. Eine providerseitig veröffentlichte Geschwindigkeitszahl ist kein Basiswert für Ihren lokalen Cluster.
Fazit
Wählen Sie den ersten Bereitstellungspfad basierend auf der Hardware, die Sie heute betreiben können. Nutzen Sie die vLLM-Anleitung für einen unterstützten lokalen Cluster, das hardwarespezifische SGLang-Cookbook für einen alternativen Serving-Stack oder eine gehostete API, wenn Sie sich auf die Anwendungsintegration konzentrieren möchten. Behalten Sie die Konfiguration bei, die Ihre Zielwerte für Task-Qualität und Latenz zu nachhaltigen Betriebskosten erfüllt.
Die verlässlichste Methode zur Auswahl eines Serving-Ansatzes ist die Optimierung auf korrekt abgeschlossene Arbeit pro Dollar und Minute, nicht nur auf maximale Tokens pro Sekunde.
FAQ
Wie mache ich eine Bereitstellung nach einem Runtime-Upgrade reproduzierbar?
Pinnen Sie die Checkpoint-Revision, Runtime-Images oder Paketversionen, den Treiber-Stack und die Startparameter. Führen Sie vor jedem Upgrade denselben kleinen Abnahmesatz aus und halten Sie die vorherige funktionierende Konfiguration für ein Rollback bereit.
Wie sollte ich mit Retries umgehen, wenn ein Agent Tools aufruft?
Trennen Sie das Wiederholen des Modells vom Wiederholen einer Tool-Aktion. Verwenden Sie Idempotency-Keys für Aktionen mit Datenänderung, prüfen Sie, ob der erste Versuch erfolgreich war, und validieren Sie vollständige Tool-Argumente vor der Ausführung.
Kann ich zwischen einem lokalen Endpunkt und CometAPI wechseln, ohne das Anwendungsverhalten zu ändern?
Halten Sie Endpunkt, Zugangsdaten und Modell-ID konfigurierbar. Testen Sie Streaming, Tool-Aufrufe, Reasoning-Felder und multimodale Eingaben auf beiden Routen und bestätigen Sie Ihre Datenrouting-Anforderungen, bevor Sie Fallback aktivieren.
Was sollte ich testen, bevor ich multimodale Eingaben akzeptiere?
Testen Sie repräsentative Bilder und Videos, einschließlich minderer Qualität und nicht unterstützter Dateien. Prüfen Sie Vorverarbeitung, Größenlimits, Antwortqualität und Timeouts separat; eine erfolgreiche Textanfrage validiert nicht den multimodalen Pfad.
Woran erkenne ich, ob eine Bereitstellung für echte Nutzer bereit ist?
Setzen Sie Ziele für Task-Erfolg, gültige Tool-Aufrufe, Latenz, Fehler und Kosten. Testen Sie realistischen Traffic, verifizieren Sie Monitoring und Fallback-Verhalten und erweitern Sie dann erst aus einem kleinen Rollout, solange diese Ziele erfüllt bleiben.