
TLDR Claude Haiku 5.5 bezeichnet es als das günstigste, schnellste und leistungsfähigste kleine Modell, das es je ausgeliefert hat. Ausgelegt für volumenstarke, latenzkritische Workloads wie Klassifikation, Extraktion, Routing, Zusammenfassung und Subagenten-Aufgaben, bietet es ein Kontextfenster von 1 Million Tokens, bis zu 128K Ausgabetokens sowie adaptives Denken mit justierbaren Aufwandsstufen.
Im Durchschnitt kostet der Betrieb rund 75% weniger als bei Haiku 4.5, bei gleichzeitig großen Zugewinnen auf agentischen und Computer-Nutzungs-Benchmarks. Entwickler können über die offizielle Claude API (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry oder kostenoptimierte Gateways wie CometAPI (ab $0.08 / $0.40) darauf zugreifen.
Zentrale Erkenntnisse
- Veröffentlichung & Positionierung: Am 7. Oktober 2026 als kleines, hochdurchsatzfähiges Modell der Claude-5.5-Familie veröffentlicht – ideal für Echtzeit-Support, Dokumentenverarbeitung und delegierte Agentenschritte.
- Kernspezifikationen: 1M-Token-Kontext, 128K maximale Ausgabe (300K über Batch API Beta), adaptives Denken (Standard: medium effort), Text + Bild Eingabe → Text Ausgabe, Wissensstand Juni 2026.
- Preisvorteil: $0.10 Input / $0.50 Output pro Million Tokens für Prompts bis 100K (≈90% günstiger als Haiku 4.5 bei den meisten Anfragen); höhere Stufe oberhalb von 100K. Cache-Lesezugriffe ab $0.01. CometAPI bietet ≈20% niedrigere Standardpreise.
- Leistungssprung: Große Zugewinne gegenüber Haiku 4.5 (z. B. OSWorld 72.4% vs 15.7%, Terminal-Bench 39.2% vs 0%, GDPval-AA 1620 vs 735 Elo) und konkurrenzfähig mit oder vor GPT-6 Luna in vielen Tests.
- Entwicklerfunktionen: Effort-Parameter (
low–max), Prompt-Caching, Batch API (50% Rabatt), Computer-/Browser-Nutzung (Beta-SDK-Unterstützung). Temperature/top_p/top_k müssen weggelassen werden, sonst tritt ein 400-Fehler auf.
Was ist Claude Haiku 5.5 und warum es 2026 wichtig ist
Claude Haiku 5.5 ist Anthropics jüngster Zugang im Leichtgewichts-Segment der Claude-Familie. Anders als die teureren, auf komplexes Reasoning und langwierige Agenten optimierten Opus 5.5 und Sonnet 5.5 ist Haiku 5.5 gezielt für volumenstarke, kostensensitive und latenzkritische Workloads gebaut. Anthropic beschreibt es als „das günstigste, schnellste und leistungsfähigste kleine Modell, das wir je veröffentlicht haben“.
Typische Produktionsszenarien umfassen:
- Ticket-Klassifikation und Routing im Kundensupport
- Felderfassung und Zusammenfassung aus langen Dokumenten
- Kompaktierung von Gesprächsverläufen für größere Modelle
- Abfragen im Datenbankstil und strukturierte Datentasks
- Schnelle Subagenten, die eng abgegrenztes Coden, Toolnutzung oder Browser-Schritte übernehmen, während ein stärkeres Modell orchestriert
Weil es deutlich günstiger und schneller als sein Vorgänger ist und gleichzeitig einen großen Teil der Qualitätslücke bei praktischen agentischen Aufgaben schließt, bauen viele Teams ihre Pipelines um, sodass Haiku 5.5 den Großteil der Anfragen bearbeitet und nur schwierige Fälle an Sonnet oder Opus eskaliert. Frühes Kundenfeedback von Asana, HubSpot, Box und anderen hebt über 30% geringere Latenzen und messbare Genauigkeitssteigerungen in internen Hochvolumen-Evals hervor.
Technische Spezifikationen von Claude Haiku 5.5
| Spezifikation | Wert | Hinweise |
|---|---|---|
| Modell-ID (Claude API) | claude-haiku-5-5 | Kein Datums-Suffix |
| Amazon Bedrock | anthropic.claude-haiku-5-5 (oder global/us/eu/au/jp Profile) | |
| Kontextfenster | 1,000,000 Tokens | ≈555k Wörter mit neuem Tokenizer |
| Max. Ausgabe (Messages API) | 128,000 Tokens | 300K mit Batch API + Beta-Header |
| Eingabemodalitäten | Text + Bilder | |
| Ausgabemodalität | Text | |
| Thinking | Adaptiv (standardmäßig aktiviert) | Gesteuert über Effort |
| Standard-Effort | medium | Optionen: low, medium, high, xhigh, max |
| Wissensstand | Juni 2026 | |
| Verpflichtung zur Verfügbarkeit | Nicht vor dem 7. Oktober 2027 | |
| Tokenizer | Neuer (gleiche Familie wie Claude 4.7+) | Gleicher Text ≈30% mehr Tokens als Haiku 4.5 |
Quelle: Anthropic Modellübersicht und Plattformdokumentation.
Der größere Kontext- und Ausgabelimitrahmen, kombiniert mit adaptivem Denken, macht Haiku 5.5 für reale Produktionssysteme deutlich brauchbarer als frühere kleine Modelle, die aggressive Kürzung oder fixe Denkbudgets erforderten.
Antworten und Abschlussprüfungen
Lesen Sie Inhaltsblöcke nach Typ, statt anzunehmen, content[0] sei die sichtbare Antwort. Prüfen Sie stop_reason, bevor Sie die Ausgabe akzeptieren: max_tokens weist auf eine abgeschnittene Generierung hin, und bei refusal ist eine explizite Anwendungsreaktion erforderlich. Für tool-fähige Anfragen verarbeiten Sie Tool-Use-Blöcke und geben die Tool-Ergebnisse im nativen Format zurück, statt sie als abgeschlossene Textantwort zu behandeln.
Was hat sich gegenüber der Claude Haiku 4.5 API geändert?
Änderungen bei Kapazität, Verhalten und Preisgestaltung
| Dimension | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Kontextfenster | 200K | 1M | 1M |
| Maximale Ausgabe | 64K | 128K | 128K |
| Adaptiver Aufwand | Nein | Ja | Ja |
| Anthropic Input / MTok | $1.00 | $0.10 | $2.00 |
| Anthropic Output / MTok | $5.00 | $0.50 | $10.00 |
| Positionierung | älteres Schnellmodell | Routinearbeit im großen Maßstab | Anspruchsvollere komplexe Aufgaben |
Die in diesem Vergleich genannten Haiku-5.5-Preise gelten für Prompts bis 100.000 Tokens; größere Prompts kosten mehr. Dies sind Anthropic-Standardpreise, nicht CometAPI-Preise. Der Vergleich dient als Routing-Ausgangspunkt, nicht als Aussage, dass die Modelle identisch performen.
Für Haiku-4.5-Integrationen sind die zentralen Umsetzungsänderungen: adaptives Denken anstelle eines manuellen Budgets, Effort-Steuerung, selektives Parsen von Content-Blöcken und aktualisierte Token-Zählungen. Der gleiche Text kann etwa 30% mehr Input-Tokens verbrauchen. Zählen Sie repräsentative Prompts neu, statt Haiku-4.5-Schätzungen zu übernehmen. Der Migrationsabschnitt übersetzt diese Änderungen in eine Deployment-Checkliste.
Gemeldete Benchmark-Verbesserungen
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1 (Offline-Subset; Teilgutschrift) | 15.7% | 72.4% | 83.9% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Humanity’s Last Exam (keine Tools) | 10.2% | 45.9% | 56.9% |
| Chartography (keine Tools) | 6.4% | 46.4% | 61.6% |
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
Anthropic berichtet die obigen Werte in seiner Launch-Benchmark-Zusammenfassung. Es sind gemeldete Evaluationsresultate, keine Live-Tests der CometAPI-Beispiele in diesem Leitfaden. Die 72.4% von OSWorld sind Teilgutschrift, nicht eine strikte Aufgabenabschlussrate.
Die Haiku-5.5-Systemkarte beschreibt die Evaluationsbedingungen. Standard-Haiku-5.5-Evaluierungen nutzen adaptives Denken mit max effort und Standard-Sampling, sofern nicht anders angegeben; das Produkt-Default ist medium. OSWorld verwendet 82 Offline-Aufgaben, keinen Internetzugang, 1080p-Auflösung und ein Limit von 500 Aktionen. Terminal-Bench 4.0 nutzt Claude Code im Bare-Modus, keinen Internet-Egress und 10 Versuche pro Aufgabe für Haiku 5.5; Sonnets Setup unterscheidet sich. HLE- und Chartography-Zeilen oben sind ohne Tools. GDPval-AA meldet ein Elo-Rating aus Artificial-Analysis-Evaluierungen. Stimmen Sie beim Vergleich die relevanten Harness-, Effort- und Tool-Einstellungen ab.
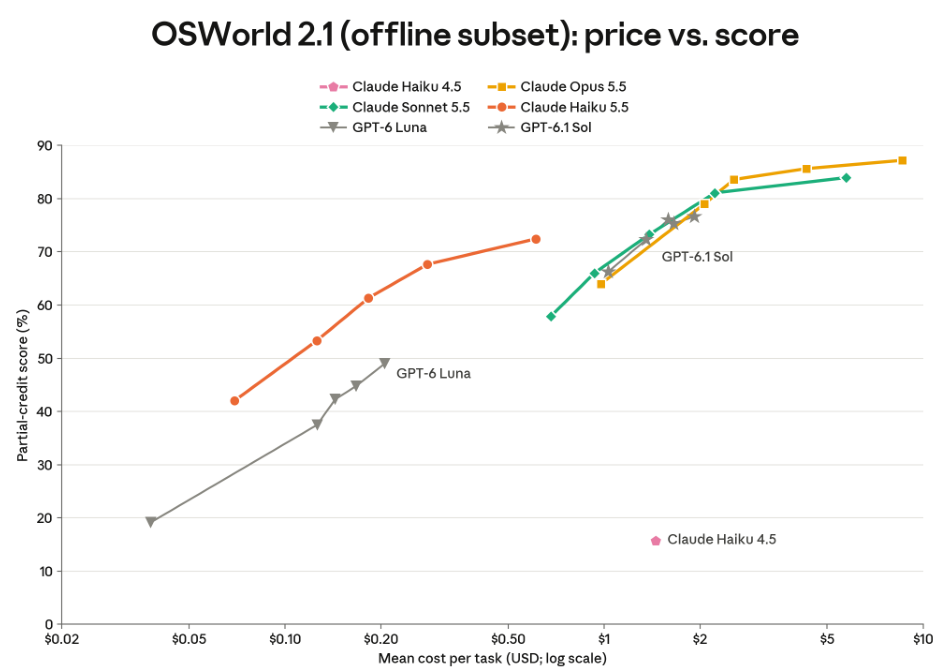
Die ursprüngliche OSWorld-Grafik von Anthropic zeigt den Zusammenhang zwischen Effort, Kosten pro Aufgabe und Teilgutschrift-Score. Sie misst keine API-Latenz und garantiert nicht die gleiche Performance für Ihre Workloads.
Die Werte deuten auf deutlich stärkere Computer-Nutzungs- und General-Task-Performance als bei Haiku 4.5 hin, garantieren jedoch keine gleichen Ergebnisse in Ihrer Anwendung. Führen Sie einen repräsentativen Evaluationssatz aus, bevor Sie Produktivtraffic umstellen.
Die Benchmark-Tabelle und die beigefügte Grafik werden als Modellvergleiche beibehalten. Es handelt sich um gemeldete Evaluierungen, nicht um Live-Tests der CometAPI-Beispiele. Verwenden Sie bei der Evaluierung einer Anwendung die gleiche Aufgabenverteilung, die gleichen Effort- und Tool-Einstellungen; ein Benchmark-Score belegt weder Gateway-Latenz noch Ihre eigene Erfolgsrate.
Verwendung der Claude Haiku 5.5 API über CometAPI
Schlüssel erstellen und native Route wählen
Erstellen Sie ein CometAPI-Konto, bestätigen Sie den Zugriff auf claude-haiku-5-5 und generieren Sie einen serverseitigen API-Schlüssel. Setzen Sie COMETAPI_KEY in Ihrer Umgebung. Halten Sie den Schlüssel außerhalb der Versionskontrolle und von Browser-Code. Anthropic- und CometAPI-Schlüssel gehören zu unterschiedlichen Anbietern; verwenden Sie in diesem überarbeiteten Leitfaden für jedes Beispiel den CometAPI-Schlüssel.
export COMETAPI_KEY="your_cometapi_api_key"
pip install --upgrade anthropic
$env:COMETAPI_KEY="your_cometapi_api_key"
| Integration | SDK-Basis-URL | Anfragepfad | Anmeldedaten |
|---|---|---|---|
| Anthropic-kompatible Messages | https://api.cometapi.com | /v1/messages | COMETAPI_KEY |
| OpenAI-kompatible Chat Completions | https://api.cometapi.com/v1 | /chat/completions | COMETAPI_KEY |
CometAPI unterstützt Claude’s natives Messages- und Content-Block-Format. Verwenden Sie das Anthropic SDK mit der CometAPI-Root-Basis-URL. Native Messages ist in diesem Leitfaden die bevorzugte Route für Claude-spezifisches Denken und Content-Blöcke. Die kompatible Chat-Completions-Route ist eine Option für bestehende OpenAI-Style-Anwendungen. Bestätigen Sie die Unterstützung erweiterter Felder auf der exakten Gateway-Route.
Eine Minimalanfrage senden und das Ergebnis prüfen
curl https://api.cometapi.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $COMETAPI_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 2048,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize three AI uses in customer support."}]
  }'
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Speichern Sie das Python-Beispiel als example.py und führen Sie python example.py aus. Ein erfolgreicher Checkpoint ist eine abgeschlossene Antwort mit sichtbarem Text und Usage-Feldern. Ein Authentifizierungsfehler bedeutet, dass der Schlüssel überprüft werden muss; ein Modell-/Routenfehler bedeutet, dass die Modell-ID, der Endpunkt oder der Kontozugriff überprüft werden muss.
Dasselbe native Format mit JavaScript verwenden
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Verwenden Sie eine unterstützte Node.js-Version. Speichern Sie die Datei als example.mjs, setzen Sie COMETAPI_KEY und führen Sie node example.mjs aus. Notieren Sie die von Ihnen validierte SDK-Version für das Deployment.
Eine bestehende OpenAI-kompatible Anwendung anpassen
Wenn Ihre Anwendung bereits Chat Completions nutzt, installieren Sie das openai-Paket und konfigurieren Sie den separaten Client unten. Diese Route liefert choices statt nativer Content-Blöcke. Halten Sie routenspezifisches Parsing getrennt und testen Sie Thinking, Bilder und Tools, bevor Sie sich auf die Gateway-Übersetzung verlassen.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Bilder an die Claude Haiku 5.5 API senden
Verwenden Sie ein Bild zusammen mit einer Anweisung, die die benötigten Belege und die gewünschte Ausgabe spezifiziert. Die offizielle Vision-Schnittstelle akzeptiert Bild-Content-Blöcke mit Base64-Daten, einer Bild-URL oder einer unterstützten hochgeladenen Dateireferenz. Dieses Beispiel liest ein lokales PNG ein, platziert das Bild vor der Frage und fordert Werte an, die gegen die Quelle geprüft werden können.
Analysieren Sie ein echtes lokales PNG über die native Anthropic Messages API.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Verwenden Sie den zum tatsächlichen Dateiinhalt passenden MIME-Typ. Prüfen Sie Lesbarkeit, Bildabmessungen und Request-Größenlimits vor der Übermittlung; vermeiden Sie hochauflösende Medien, die der Aufgabe nicht helfen. Für CometAPI ändern Sie Schlüssel und Root-Basis-URL wie im Messages-Beispiel gezeigt und prüfen die Bildunterstützung auf der exakten Route.
Steuerung des Reasonings von Claude Haiku 5.5
Haiku 5.5 verwendet standardmäßig adaptives Denken. Die offizielle Thinking-Konfiguration erklärt, wann disabled akzeptiert wird und wie Thinking-Blöcke zurückgegeben werden. Setzen Sie Effort über output_config.effort; verwenden Sie nicht das veraltete budget_tokens.
| Aufwand | Geeigneter Einstiegseinsatz | Abwägung |
|---|---|---|
| low | Kurze Klassifikation, einfache Extraktion | Typisch geringere Token-Nutzung und Latenz |
| medium | Support-Antworten, Routine-Agentenarbeit | Ausgewogener Standard |
| high | Mehrstufige Dokumentanalyse | Potenziell mehr Reasoning |
| xhigh | Schwierige Evaluierungen | Mehr Verarbeitung und Kosten |
| max | Reasoning-intensive Fälle | Höchstes mögliches Reasoning-Budget |
Konfigurieren Sie adaptives Denken mit niedrigem Aufwand.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Entwickler können Thinking bei low, medium und high deaktivieren, jedoch nicht bei xhigh oder max. Thinking verbraucht abgerechnete Ausgabetokens und das max_tokens-Budget, auch wenn sein Text versteckt ist. Ein leeres Thinking-Feld kann dennoch eine Signatur tragen; es beweist nicht, dass kein Reasoning stattgefunden hat. Belassen Sie zurückgegebene Content-Blöcke unverändert, wenn Sie Tool-Konversationen fortsetzen.
Beispielanfrage mit deaktiviertem Thinking
Senden Sie einen nativen Request-Body mit deaktiviertem Thinking.
{ "model": "claude-haiku-5-5", "max_tokens": 1024, "thinking": {"type": "disabled"}, "output_config": {"effort": "low"}, "messages": [ {"role": "user", "content": "Return sentiment only: positive, neutral, negative."} ]}
Streaming von Claude Haiku 5.5 Antworten
Streaming liefert sichtbaren Text schrittweise und verbessert die Reaktionsfähigkeit in interaktiven Anwendungen. Behandeln Sie gestreamten Text als vorläufig, bis die Anfrage erfolgreich abgeschlossen ist.
Streamen Sie sichtbaren Text mit dem Anthropic-Python-SDK.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Claude Haiku 5.5 API Preisgestaltung
Tokenraten und Promptlängen-Bänder vergleichen
Preise geprüft am 8. Oktober 2026. Die Tabelle vergleicht Anthropic Standardpreise mit veröffentlichten CometAPI-Preisen, in USD pro Million Tokens. Das Band wird durch die Promptlänge bestimmt: bis 100.000 Tokens versus mehr als 100.000. Längere Anfragen verwenden die entsprechenden höheren Bandpreise, nicht nur einen Zuschlag auf die überzähligen Tokens. Kontobilling, Cache-Nutzung und optionale Tools müssen separat abgeglichen werden.
| Tokenkategorie | Anthropic ≤100K | CometAPI ≤100K | Anthropic >100K | CometAPI >100K |
|---|---|---|---|---|
| Input | $0.10 | $0.08 | $0.50 | $0.40 |
| Output | $0.50 | $0.40 | $2.50 | $2.00 |
| Cache-Lesen | $0.01 | $0.008 | $0.05 | $0.04 |
| 5-min Cache-Schreiben | $0.125 | $0.10 | $0.625 | $0.50 |
| 1-Std Cache-Schreiben | $0.20 | $0.16 | $1.00 | $0.80 |
Die Rate-Snapshot des Originalartikels bleibt oben erhalten. Prüfen Sie die aktuelle CometAPI-Listung und das Kontobilling vor Kauf oder Deployment; die in der Listung genannten Einstiegspreise für Input sind kein vollständiges Angebot für jedes Promptlängen-Band, Cache-Operationen oder optionale Tools.
Beispiel: Kosten von 100.000 Support-Anfragen
Angenommen 100.000 monatliche Anfragen, jeweils mit 2.000 Input-Tokens und 300 abgerechneten Output-Tokens einschließlich generierten Thinkings. Jeder Prompt fällt in das bis-zu-100K-Band. Caching, Tool-Gebühren und Retries ausgeschlossen.
| Komponente | Nutzung | Anthropic | CometAPI |
|---|---|---|---|
| Input | 200M Tokens | $20.00 | $16.00 |
| Output | 30M Tokens | $15.00 | $12.00 |
| Gesamt | 100,000 Anfragen | $35.00 | $28.00 |
Unter diesen Annahmen beträgt der illustrative Unterschied $7 pro Monat bzw. 20%. Produktionskosten hängen von Anfrage-Längen, verborgenem Reasoning, Caching und Retry-Verhalten ab.
Verwenden Sie die aktuellen Token-Zählungen des Modells in der Berechnung. Kosten = Input-Tokens × anwendbare Input-Rate / 1,000,000 + abgerechnete Output-Tokens × anwendbare Output-Rate / 1,000,000, zuzüglich ggf. anfallender Cache-, Tool- und Retry-Kosten. Thinking-Tokens sind Teil der abgerechneten Ausgabe.
Kosten senken, ohne die Qualität akzeptierter Aufgaben zu verlieren
| Optimierung | Maßnahme | Nutzen |
|---|---|---|
| Effort-Tuning | low verwenden, wo Qualität es erlaubt | Geringerer Reasoning-Overhead |
| Prompt-Reduktion | Redundante Gesprächshistorie entfernen | Weniger Input-Tokens |
| Prompt-Caching | Wiederverwendbaren Kontext stabil halten | Niedrigere wiederholte Input-Kosten |
| Streaming | Tokens bei Eintreffen rendern | Bessere wahrgenommene Reaktionszeit |
| Schema-Validierung | Fehlformatierte Datensätze früh verwerfen | Weniger Nacharbeit downstream |
| Modell-Routing | Komplexe Aufgaben eskalieren | Besseres Kosten-Qualitäts-Verhältnis |
| Batch-Verarbeitung | Geeignete Offline-Anfragen bündeln | Potenziell zusätzliche Einsparungen |
Wählen Sie nicht automatisch den niedrigsten Effort. Eine billigere Einzelanfrage kann Gesamtkosten erhöhen, wenn sie zu mehr Retries führt. Evaluieren Sie Genauigkeit, p50/p95-Latenz, Token-Nutzung und Kosten pro erfolgreicher Aufgabe.
Für Prompt-Caching verwenden Sie ein stabiles Präfix und prüfen Sie die Nutzung von Cache-Erstellung und Cache-Lesen, statt einen Treffer anzunehmen. Haiku 5.5 hat auf der dokumentierten Claude API ein 512-Token-Mindestmaß für cachebare Prompts. Das Ändern von Effort kann gecachte Präfixe invalidieren; halten Sie Einstellungen innerhalb einer Konversation stabil. Ein 1M-Kontextfenster ist eine Kapazitätsobergrenze, keine Empfehlung, jedes Dokument in jeder Runde zu senden.
Halten Sie ein stabiles wiederverwendbares Präfix für Caching, kürzen Sie unnötige Inputs und benchmarken Sie Effort-Änderungen. Streaming verbessert die wahrgenommene Reaktionsfähigkeit, reduziert aber nicht automatisch die abgerechnete Nutzung. Vergleichen Sie die Kosten pro akzeptierter Aufgabe über den gesamten Workflow, einschließlich Retries und Tool-Aufrufen.
Migrationsleitfaden von Claude Haiku 4.5 zu Haiku 5.5
Integration und Anfrageformat aktualisieren
| Bereich | Migrationsmaßnahme |
|---|---|
| Modell-ID | Durch claude-haiku-5-5 ersetzen |
| Thinking | Manuelles budget_tokens durch adaptives Denken ersetzen |
| Effort | Bei Bedarf output_config.effort verwenden |
| Sampling | Temperature, top_p und top_k weglassen; jeder top_k-Wert wird nicht unterstützt |
| Response-Parser | Mehrere Content-Block-Typen verarbeiten |
| Output-Budget | Ausreichenden Raum für Reasoning und finale Ausgabe vorsehen |
| Prefill | Nicht unterstütztes Assistant-Prefilling entfernen |
| Caching | Prompts bei Effort-Änderungen erneut testen |
| Tool-Integrationen | Unterstützte Tool-Versionen prüfen |
Für die hier verwendete CometAPI-Route behalten Sie COMETAPI_KEY und die native Basis-URL bei, während Sie die Modell-ID und die Anfragekonfiguration ändern. Ersetzen Sie Legacy-aktiviertes Thinking mit Budget durch adaptives Thinking und Effort. Entfernen Sie Assistant-Prefilling und lassen Sie Sampling-Parameter weg. Bewahren Sie die Unterscheidung zwischen Claudes nativem Content-Array und der kompatiblen Route mit choices-Response.
Zustand bewahren und Budgets neu berechnen
Der offizielle Haiku-5.5-Migrationsleitfaden berichtet etwa 30% mehr Input-Tokens für identischen Text als bei Haiku 4.5. Zählen Sie repräsentative Prompts neu und justieren Sie Limits, bevor Sie Traffic migrieren. Zurückgegebene Thinking-Blöcke funktionieren nur im Konto, das sie erzeugt hat, oder in einem verknüpften Konto; ein Kontowechsel kann diese Blöcke stillschweigend verwerfen. Bewahren Sie ein Append-only-Gesprächspräfix, statt frühere Nachrichten nach einer Generation zu verändern. Prüfen Sie stop_reason, einschließlich max_tokens und refusal, und behandeln Sie diese explizit, bevor Sie Ausgaben akzeptieren.
Zählen Sie repräsentative Prompts mit dem Zielmodell neu und stimmen Sie max_tokens, Latenzgrenzen und Kostenabschätzungen ab. Testen Sie gespeicherte Konversationen gegen das Konto und die Gateway-Route, über die sie erneut abgespielt werden; gehen Sie nicht davon aus, dass signierte Thinking-Blöcke über nicht verknüpfte Konten oder umgeschriebene Gesprächspräfixe portabel sind.
Fazit
Claude Haiku 5.5 markiert einen echten Wendepunkt für kosteneffiziente, hochdurchsatzfähige KI. Mit deutlich besserer agentischer und Computer-Nutzungs-Performance zu etwa einem Zehntel des bisherigen Haiku-Preises bei der Mehrheit der Anfragen macht Anthropic den großflächigen Einsatz leistungsfähiger kleiner Modelle praktikabel. Ob Sie die offizielle API aufrufen, über Amazon Bedrock routen oder ein einheitliches Gateway wie CometAPI für zusätzliche Einsparungen und operative Einfachheit nutzen – die Kombination aus Geschwindigkeit, Leistungsfähigkeit und Preis eröffnet neue Produktmöglichkeiten, die zuvor unwirtschaftlich waren.