
TL;DR
Mit Stand 9. Oktober 2026 deuten Berichte darauf hin, dass Kimi K3.1 noch in diesem Monat erscheinen könnte, doch die geprüften Quellen legen weder ein offizielles Launch-Datum, noch endgültige Preise oder K3.1-spezifische Benchmark-Ergebnisse fest. Die gemeldeten Low-/High-/Max-, Extra Long-, Agent- und Swarm-Flags überschneiden sich mit bestehenden K3-Funktionen. Ein potenzielles Upgrade ist relevant, wenn es Reasoning-Effizienz, Langkontext-Zuverlässigkeit und Kosten pro abgeschlossener Aufgabe verbessert; reine Konfigurationslabels können diese Vorteile nicht belegen.
Key Takeaways
- Veröffentlichungszeitraum: Oktober ist eine medial berichtete Möglichkeit, ohne dass die zitierten Quellen eine offizielle Launch-Verpflichtung belegen.
- Technische Hinweise: Low/High/Max und eine gemeldete 1M-Token-Option überschneiden sich mit K3-Fähigkeiten; K3.1-Architektur und finale Limits sind unbestätigt.
- Agent-Workflows: Agent-, Swarm-, Search- und Batch-Flags deuten eher auf mögliche Integrationsarbeit als auf gemessene Verbesserungen hin.
- Leistung und Preise: Veröffentlichte K3-Ergebnisse und -Tarife sind Referenzbaselines, keine K3.1-Benchmarks oder -Gebühren.
- API-Bereitschaft: Vor dem Einsatz von K3.1 über die CometAPI aktivierte Modell-IDs, dokumentierte Parameter und Kontozugriff verifizieren.
What is Kimi K3.1?
Kimi K3.1 ist eine gemeldete nächste Iteration der Kimi-Modellfamilie von Moonshot AI. Durchgesickerte Konfigurationskennungen deuten auf Arbeiten an Reasoning, Langkontext und Agent-Workflows hin. Finale Spezifikationen, Veröffentlichungsdatum und Preise sind durch die geprüften Quellen nicht belegt und sollten als prospektives Modell statt als bestätigter öffentlicher Release betrachtet werden.
What Do We Know About Kimi K3.1?
Der ursprüngliche Post zeigt eine K3.1-bezogene Kennung
Am 23. September 2026 hat @MaxForAI einen Konfigurations-Screenshot gepostet, der k3d1-agent zeigt. Dies ist das Originalbild zum Beitrag; seine interne Herkunft und sein Produktionsstatus wurden nicht unabhängig authentifiziert.
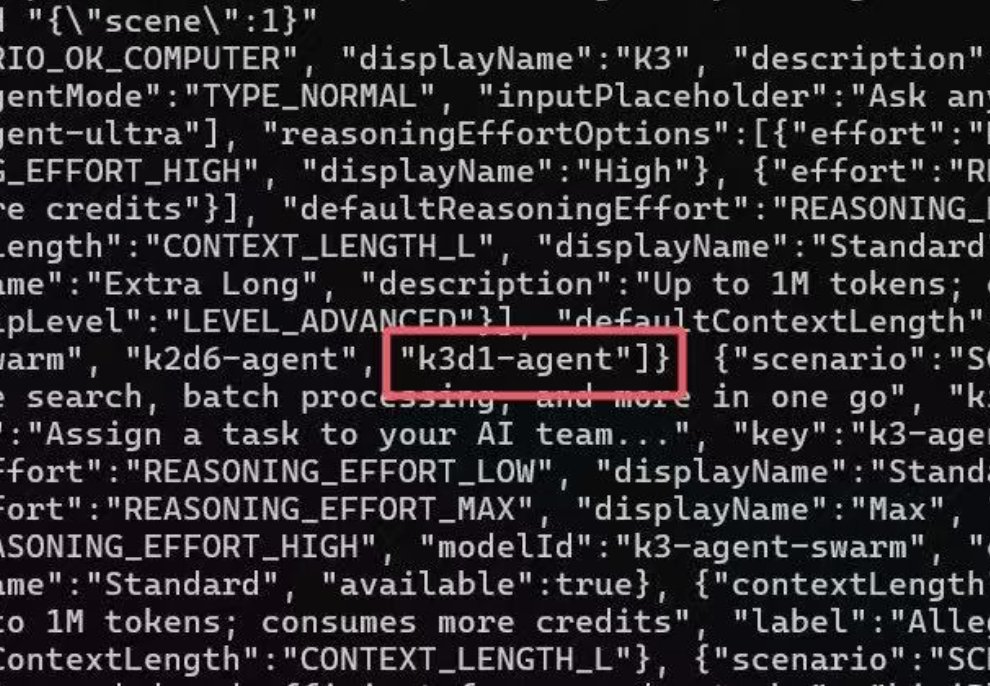
Bildquelle: @MaxForAI’s Originalpost. Das Bild enthält Reasoning-Aufwand- und Kontext-Einstellungen sowie Agent-Kennungen. Sichtbare Konfigurationsstrings beweisen nicht, dass jede Option zu K3.1 gehört.
Wccftechs Bericht vom 23. September interpretiert den Screenshot als K3.1-Entwicklungssignal. IT Home’s Folgebericht vom 24. September wiederholt die gemeldeten Optionen. Diese Berichte sind sekundäre Interpretationen desselben Leaks, keine unabhängige Bestätigung der Launch-Bereitschaft.
Gemeldete Optionen deuten auf Reasoning- und Agent-Workflows
Die Berichte beschreiben Low-/High-/Max-Reasoning-Einstellungen, eine Extra Long-Option bis zu 1M Tokens sowie Agent-, Swarm-, Search- und Batch-Flags. Diese Hinweise lassen mögliche Workflow-Integration vermuten. Sie offenbaren weder eine finale Architektur noch validierte Leistungsgewinne oder ein unterstütztes öffentliches API-Schema.
Medienberichte unterscheiden sich beim Launch-Fenster
Wccftech nennt eine mögliche Ankunft vor Oktober, während IT Home Oktober 2026 angibt. Diese Diskrepanz mindert den praktischen Nutzen beider Prognosen. Keiner der Berichte liefert eine datierte Moonshot-Veröffentlichungsankündigung.
Eine Modellkennung kann für einen privaten Checkpoint, einen unfertigen Entwicklungszweig, einen gestuften Rollout oder eine zugangsbeschränkte Vorschau stehen. Sie kann nicht eigenständig einen kommerziellen API-Release belegen. Die genauen Bedeutungen und die Verfügbarkeit der geleakten Flags bleiben ungewiss.
When Will Kimi K3.1 Be Released?
Die geprüften Quellen belegen kein offizielles Kimi K3.1-Veröffentlichungsdatum. IT Home meldet Oktober 2026, während die frühere Wccftech-Berichterstattung vor Oktober sagt. Das sind divergierende Medienprognosen, kein verifizierter Entwicklungszeitplan. Ein Screenshot kann keine Rollout-Daten, Konto-Berechtigungen oder Einsatzbereitschaft belegen.
Warten Sie auf eine datierte Moonshot-Ankündigung, unterstützte Modell-IDs, Entwicklerdokumentation und Zugangsbedingungen, bevor Sie ein Launch-Datum als bestätigt ansehen. Preise und reproduzierbare K3.1-spezifische Bewertungen sind separate Evidenz, die für Einsatzentscheidungen benötigt wird.
What Specifications Could Kimi K3.1 Offer?
Die stärkste technische Basis ist das bestehende Kimi K3, ein Release vom Juli 2026 mit einer 2,8-Billionen-Parameter Sparse-MoE-Architektur, nativem visuellen Input und einem Kontextfenster, das allgemein mit 1M Tokens beschrieben wird. Die zitierten Quellen belegen keine K3.1-Architektur, Parameterzahlen oder modellspezifischen Evaluationsergebnisse.
Moonshots offizielle Modellzusammenfassung nennt 104B aktivierte Parameter und ein Kontextfenster von 1.048.576 Tokens. Die Open-Weight-Ankündigung vom 27. Juli bestätigt die Veröffentlichung der K3-Gewichte. Diese Spezifikationen gelten für K3, nicht für das gemunkelte K3.1.
| Spezifikation | Kimi K3 | Kimi K3.1 |
|---|---|---|
| Veröffentlichung | Juli 2026 | Möglich im Oktober 2026 |
| Gesamtparameter | 2,8 Billionen | Nicht offengelegt |
| Aktivierte Parameter | 104 Milliarden (offizielle Modellzusammenfassung) | Nicht offengelegt |
| Architektur | Sparse MoE, KDA, AttnRes | Nicht offengelegt |
| Kontext | 1.048.576 Tokens (ca. 1M) | Bis zu 1M angedeutet |
| Reasoning | Low/High/Max in aktueller Kimi Code-Dokumentation | Low-/High-/Max-Flags |
| Vision | Nativer visueller Input | Nicht bestätigt |
| Swarm | Bestehende Kimi Swarm-Fähigkeit | Swarm-Flag erscheint angeblich |
| API-Preis | Veröffentlichter K3-Tarif | Keine finalen Preise |
| Gewichte | K3-Gewichte veröffentlicht | Unbekannt |
What Features Are Reported for Kimi K3.1?
Die drei Themen kombinieren gemeldete K3.1-Hinweise mit dokumentierten K3-Fähigkeiten. Sie erklären, was die Einstellungen bedeuten könnten, ohne gemunkelte K3.1-Funktionen als bestätigte Spezifikationen darzustellen.
Drei Reasoning-Stufen bilden einen Aufwandskompromiss
Low, High und Max sind gemeldete K3.1-Konfigurationslabels. Sie beschreiben einen Aufwand-Trade-off, keine neue Architektur. Die aktuelle Kimi Code-Dokumentation unterstützt Low/High/Max für K3, mit High als Standard. Dies ist eine Kimi Code-Einstellung; Defaults und Berechtigungen sollten nicht für jede API oder jedes Produkt als identisch angenommen werden.
Low kann sich bei Extraktion, einfachem Q&A und Routineklassifikation eignen, wenn geringere Latenz zählt. High kann einen praktischen Ausgleich für mehrstufige Entwicklung und Dokumentenarbeit bieten. Max kann ein höheres Reasoning-Budget für schwieriges Coding oder Recherche zuweisen, mit höherer Latenz und ggf. höheren Kosten. Diese Aufgabenabbildungen sind Interpretationen zum Testen, keine verifizierten K3.1-Garantien.
Diese Workload-Beispiele sind analytische Interpretationen, keine verifizierten K3.1-Servicegarantien. Entwickler sollten Qualität pro ausgegebenem Betrag vergleichen: Ein Lauf mit hohem Aufwand kann pro Versuch mehr kosten, doch weniger Wiederholungen könnten die Gesamtkosten des Workflows senken. Das sinnvolle Upgrade wären verbesserte Task-Erfolge bei vergleichbarem Token- und Tool-Budget.
Eine 1M-Token-Option erweitert die Langkontext-Basis
Ein Millionen-Token-Fenster kann umfangreiche Code-Repositories, lange technische Dokumente, Projektverläufe und umfassende Tool-Traces aufnehmen. Doch maximale Kontextlänge ist nicht gleichbedeutend mit akkurater Nutzung ferner Information. Ein produktives Modell muss weiterhin die richtigen Fakten abrufen, Konsistenz über Dokumente wahren und die Prefill-Latenz beherrschbar halten.
Bewerten Sie Langkontext durch Tests des Abrufs an unterschiedlichen Prompt-Positionen, Konsistenz über Dokumente und Zeit bis zum ersten Token. Messen Sie auch Cache-Wiederverwendung sowie die Kosten für das Beibehalten oder Komprimieren der Agenten-Historie. Eine nominale 1M-Token-Grenze ist nur nützlich, wenn das Modell entfernte Evidenz innerhalb akzeptabler Latenz und Budgets zuverlässig wiederfindet.
Moonshot berichtet einen K3 BrowseComp-Score von 90,4 mit 1M-Token-Kontext und ohne Kontextmanagement. Dies ist eine spezifische K3-Bewertungsbedingung, getrennt von Ergebnissen mit kompaktem Kontext und von jeglichen K3.1-Leistungsbehauptungen.
Agent- und Swarm-Flags deuten auf koordinierte Aufgabenausführung hin
Die agentenbezogenen Kennungen und Swarm-Flags sind vermutlich interessanter als die Kontextzahl. Kimi unterstützt bereits Multi-Agent-Arbeit; daher müsste das gemunkelte Upgrade Routing, Delegation, Ergebnisaggregation und Kostenkontrolle verbessern, statt nur ein Swarm-Label hinzuzufügen.
In einem plausiblen orchestrierten Workflow zerlegt ein Koordinator eine komplexe Anfrage in Recherche-, Coding-, Test- und Synthese-Subtasks. Spezialisierte Worker laufen parallel, liefern Evidenz, und der Koordinator versöhnt die Ergebnisse. Solche Parallelisierung kann die Durchlaufzeit senken, während die Gesamtzahl der Modellaufrufe steigt; daher müssen Wandzeit und Kosten getrennt berichtet werden.
Kimis offizielle Agent Swarm-Dokumentation beschreibt bestehende parallele Agentenausführung. Das folgende Beispiel illustriert, wie solche Orchestrierung Arbeit teilen kann; es legt K3.1s finale Konfiguration oder eine vorgeschriebene Swarm-Topologie nicht fest.
Ein Research-Worker kann Quellen abrufen und Zitate verifizieren; ein Coding-Worker kann Module modifizieren und Ausführungsbelege zurückgeben; ein Analyse-Worker kann Alternativen mit reproduzierbaren Berechnungen vergleichen. Ein Koordinator weist Aufgaben zu, versöhnt Widersprüche und begrenzt das Budget. Die Ausgabe jedes Workers bedarf der Verifikation, bevor das kombinierte Ergebnis akzeptiert wird.
Für K3.1 sollten Entwickler reproduzierbare Benchmarks erfolgreicher End-to-End-Agentenaufgaben, Fehlertoleranz, Agent-zu-Agent-Dissensbehandlung, Tool-Call-Zahlen und Gesamtaufwand suchen. Konfigurationsflags allein können keine Verbesserung belegen.
How Does Kimi K3.1 Compare with K3 on Benchmarks?
Es liegt keine verifizierte K3.1-spezifische Benchmark-Tabelle vor. Die folgenden Zahlen stammen aus Moonshots offiziellen K3-Evaluationen und dienen ausschließlich als Vergleichsbasis. Unterschiedliche Modell-Harnesses und Bewertungs-Settings begrenzen strenge Eins-zu-eins-Schlussfolgerungen.
| Benchmark | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67,5 | 73,0 | 70,0 |
| Terminal-Bench 2.1 | 88,3 | 88,8 | 88,0 |
| FrontierSWE | 81,2 | 71,3 | 86,6 |
| Program Bench | 77,8 | 77,6 | 76,8 |
| Kimi Code Bench 2.0 | 72,9 | 64,8 | 76,9 |
| SWE Marathon | 42,0 | 39,0 | 35,0 |
Quellendivergenz: Das ursprüngliche Visual zeigt Fable 5 mit 84,6 auf Terminal-Bench 2.1, während die offizielle Repository-Bewertungstabelle 88,0 berichtet. Die obige Tabelle folgt dem Repository; das offizielle Bild wird unverändert reproduziert.
Die Evaluationsnotizen spezifizieren K3 Max-Aufwand, Temperatur 1,0 und Top-p 1,0. DeepSWE v1.1 nutzt hier Kimi Code; das separat zitierte mini-SWE-agent-Ergebnis liegt bei 67,3. Terminal-Bench nutzt Kimi Code für K3, Terminus 2 für Fable 5 und Codex für Sol. FrontierSWE verwendet Kimi Code/Codex und Dominanzscores vom 16. Juli; ProgramBench verwendet Kimi Code für K3. KCB 2.0 nutzt Kimi Code/Claude Code für K3 und Claude Code/Codex für Fable/Sol. SWE Marathon nutzt einen H20-kalibrierten v1.1-Branch mit Claude Code/Codex; Fable hatte Fallbacks bei 35% der Aufgaben. Dies sind vom Anbieter gemeldete Ergebnisse unter unterschiedlichen Harnesses.
Konsultieren Sie die offiziellen Evaluationsnotizen für das vollständige Protokoll jedes Benchmarks; die Zahlen begründen keinen kontrollierten K3.1-Vergleich.
K3 ist in diesem Set besonders wettbewerbsfähig bei Program Bench und SWE Marathon, während die relativen Spitzenreiter je nach Test variieren. K3.1 kann nicht als schneller oder genauer deklariert werden, bis Tests mit dokumentiertem Agent-Harness, Reasoning-Budget und Bewertungsdatum veröffentlicht wurden.
What Could Kimi K3.1 API Pricing Look Like?
Der offizielle K3-Starttarif liegt bei $0,30 Caching-Input, $3 nicht gecachter Input und $15 Output pro Million Tokens. Die folgende Tabelle zeichnet diesen Referenzplan auf, nicht einen verifizierten aktuellen K3.1-Tarif. K3.1-Raten und etwaige Orchestrierungskosten müssen separat bestätigt werden.
| Metrik | Kimi K3 API in CometAPI (Referenztarif zur offiziellen Markteinführung) | Kimi K3.1 API in CometAPI (unbestätigter Tarif) |
|---|---|---|
| Zwischengespeicherter Input | US$0,30 / 1M Tokens | Unbestätigt |
| Nicht zwischengespeicherter Input | US$3,00 / 1M Tokens | Unbestätigt |
| Ausgabe | US$15,00 / 1M Tokens | Unbestätigt |
| Agenten-Orchestrierung | Abhängig vom tatsächlichen Verbrauch | Unbestätigt |
Zu diesen K3-Referenzraten würden 100.000 nicht gecachte Input-Tokens plus 10.000 Output-Tokens US$0,45 kosten. Dies ist ein illustratives K3-Rechenbeispiel, nicht K3.1-Preisgestaltung. Unternehmensplanung sollte Kosten pro verifizierter Aufgabe statt nur Tokens verwenden.
How Can Developers Prepare for Kimi K3.1 API Access?
Zugangsprüfungen kommen vor der Integration
Entwickler können Kimi K3.1 API in CometAPI für Zugangs-Updates verfolgen. Am 9. Oktober 2026 zeigte der Abschnitt zur Verfügbarkeit weiterhin Coming Soon, neben generischem Endpoint- und Health-Text. Behandeln Sie diese uneinheitliche Seite als Discovery-Link; bestätigen Sie eine aktivierte Modell-ID und einen erfolgreichen kontoebenen Test, bevor Sie Produktionszugang annehmen.
Eine Launch-Checkliste leitet die Einsatzentscheidung
| Frage | Derzeit verfügbare Evidenz | Bestätigung erforderlich |
|---|---|---|
| Veröffentlichung? | Leak-Berichte vom September | Moonshot-Veröffentlichungsankündigung |
| Neue Architektur? | Keine K3.1-Model-Card | Technischer Bericht und Parameter |
| Besseres Reasoning? | Drei vertraute Aufwand-Modi | Qualität/Kosten vs. K3 auf jeder Stufe |
| Besserer Langkontext? | Gemeldete 1M-Option | Genauigkeit und Latenz bei 1M |
| Bessere Multi-Agenten-Fähigkeiten? | Agent/Swarm-Konfigurationsflags | Benchmarks zu Agentenerfolg und Kosten |
| API-Produktionszugang? | Coming Soon-Indikator | Unterstützte IDs, Doku, Preise |
Die Vorbereitung kann mit portablen Evaluationen und einem gedeckelten Testbudget beginnen. Migration sollte auf dokumentierten Zugang und wiederholbare, auf Workload-Ebene nachweisbare Gewinne warten. Die Entscheidung ist, ob K3.1 akzeptierte Ergebnisse zuverlässiger und wirtschaftlicher produziert, nicht ob ein Katalogeintrag oder ein Konfigurationsflag existiert.
FAQs
Wie können Entwickler Kimi K3.1-Zugang verifizieren?
Bestätigen Sie die unterstützte Modell-ID des Providers und die Konto-Berechtigung, führen Sie dann eine kleine Anfrage aus und prüfen Sie die zurückgegebene Modellkennung, Nutzung und Fehler. Ein erfolgreicher Call verifiziert den Zugang für dieses Konto und diese Route zu diesem Zeitpunkt; ein Katalogeintrag oder Health-Label allein belegt keinen öffentlichen Launch oder stabile Quoten.
Kann Kimi K3.1 K3 in einem bestehenden Agenten ersetzen?
Behandeln Sie die Migration als Kompatibilitätsänderung. Prüfen Sie Tool-Schemas, Handling der Reasoning-Historie, Ausgabeformate und Timeout-Verhalten, bevor Sie repräsentative Aufgaben erneut ausführen. Verwenden Sie eine festgenagelte Baseline und behalten Sie eine Rollback-Route. Ein ähnlicher Modellname oder Kontextlimit ist unzureichende Evidenz dafür, dass lang laufende Sessions identisch agieren.
Wie sollten Teams ein Kimi K3.1-Pilotbudget planen?
Starten Sie mit einem gedeckelten Aufgabenset statt mit der Extrapolation eines gemunkelten Tokenpreises. Tracken Sie nicht gecachten Input, Cache-Treffer, Reasoning-/Output-Tokens, Tool-Calls, Wiederholungen und Zeit für menschliche Korrektur. Reservieren Sie ein fixes Evaluationsbudget und vergleichen Sie Kosten pro akzeptiertem Ergebnis, nachdem finale Raten dokumentiert sind.
Was würde als sinnvolles Kimi K3.1-Upgrade gelten?
Fordern Sie wiederholbare Gewinne auf Ihrer Workload bei vergleichbaren Reasoning- und Tool-Budgets. Testen Sie Abruf entfernter Evidenz, widersprüchliche Dokumente, Agenten-Fehlerbehebung und End-to-End-Aufgabenakzeptanz. Protokollieren Sie Ausfallrate, Latenz und Gesamtausgaben gemeinsam; ein größeres nominales Fenster oder ein extra Konfigurationsflag allein ist unzureichend.
Conclusion
Kimi K3.1 sollte als gemeldeter prospektiver Release behandelt werden. Die überprüften Evidenzen identifizieren mögliche Konfigurationsarbeit, während K3 bereits Langkontext, anpassbaren Aufwand und Swarm-Ausführung bietet. Die praktische Chance ist bessere Aufgabenqualität zu tragbaren Kosten. Bereiten Sie jetzt portable Evaluationen vor und treffen Sie Migrationsentscheidungen, nachdem offizielle Spezifikationen, Zugangsbedingungen, Preise und reproduzierbare K3.1-Ergebnisse vorliegen.