Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
MiMo-V2.5 ist die stärkere Standardwahl für multimodale Arbeit, Routine-Agenten und kostenempfindliche Produktion. MiMo-V2.5-Pro ist die Spezialoption für schwieriges Reasoning, Coding auf Repository-Ebene und lang andauernde Tool-Nutzung. Beide bieten ein Kontextfenster von 1M Tokens und bis zu 128K Ausgabetokens, aber Pro verwendet ein deutlich größeres Sprach-Backbone und kostet etwa 3,1× so viel für gewöhnliche Ein- und Ausgabetoken.
MiMo-V2.5 vs. Pro: Schnelle Entscheidung
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
MiMo-V2.5 vs MiMo-V2.5-Pro Welches Xiaomi-Modell ist besser? - CometAPI
Spezifikation — offizielle Veröffentlichung
MiMo-V2.5
MiMo-V2.5-Pro
Empfohlenes Modell
Begründung
Primäre Positionierung
Omnimodales Modell und effiziente Agents
Flagship-Agent und komplexes Coding
Nach Arbeitslast wählen
Omnimodale Eingaben sprechen für V2.5; anhaltend schwierige Textarbeit spricht für Pro.
Architektur
Sparse-MoE
Sparse-MoE
Nach Arbeitslast wählen
Die Modellgröße allein macht nicht für jede Aufgabe die bessere Wahl aus.
Gesamtparameter
310B
1.02T
Nach Arbeitslast wählen
Das größere Modell zielt auf schwieriges Reasoning, aber Gesamtgröße ist kein Ergebnismaß.
Aktivierte Parameter
15B
42B
Nach Arbeitslast wählen
Entscheidung anhand Aufgabenerfolg und Kosten treffen.
LLM-Schichten
48
70
Nach Arbeitslast wählen
Die Schichtanzahl beschreibt die Architektur, ist aber kein universeller Vorteil.
Geroutete Experten
256
384
Nach Arbeitslast wählen
Der Unterschied zählt nur, wenn er die Zielarbeitslast verbessert.
Experten pro Token
8
8
Beide
Beide aktivieren acht Experten pro Token.
Kontextfenster
1M Tokens
1M Tokens
Beide
Beide werben mit einem 1M-Token-Fenster; effektive Retrievalleistung testen.
Maximale Ausgabe
128K Tokens
128K Tokens
Beide
Beide werben mit bis zu 128K Ausgabetokens.
Eingabemodalitäten
Text, Bild, Video und Audio
Text
MiMo-V2.5
Akzeptiert Bild-, Video- und Audioeingaben; Pro ist auf Texteingabe ausgerichtet.
Toolaufrufe
Ja
Ja
Nach Arbeitslast wählen
Beide rufen Tools auf; Erfolgsrate auf der tatsächlichen Trajektorie testen.
Offene Gewichte und Lizenz
Ja; MIT
Ja; MIT
Beide
Beide bieten offene Gewichte unter MIT; Betriebskosten unterscheiden sich.
Der entscheidende Unterschied: Multimodal vs. Agent-First
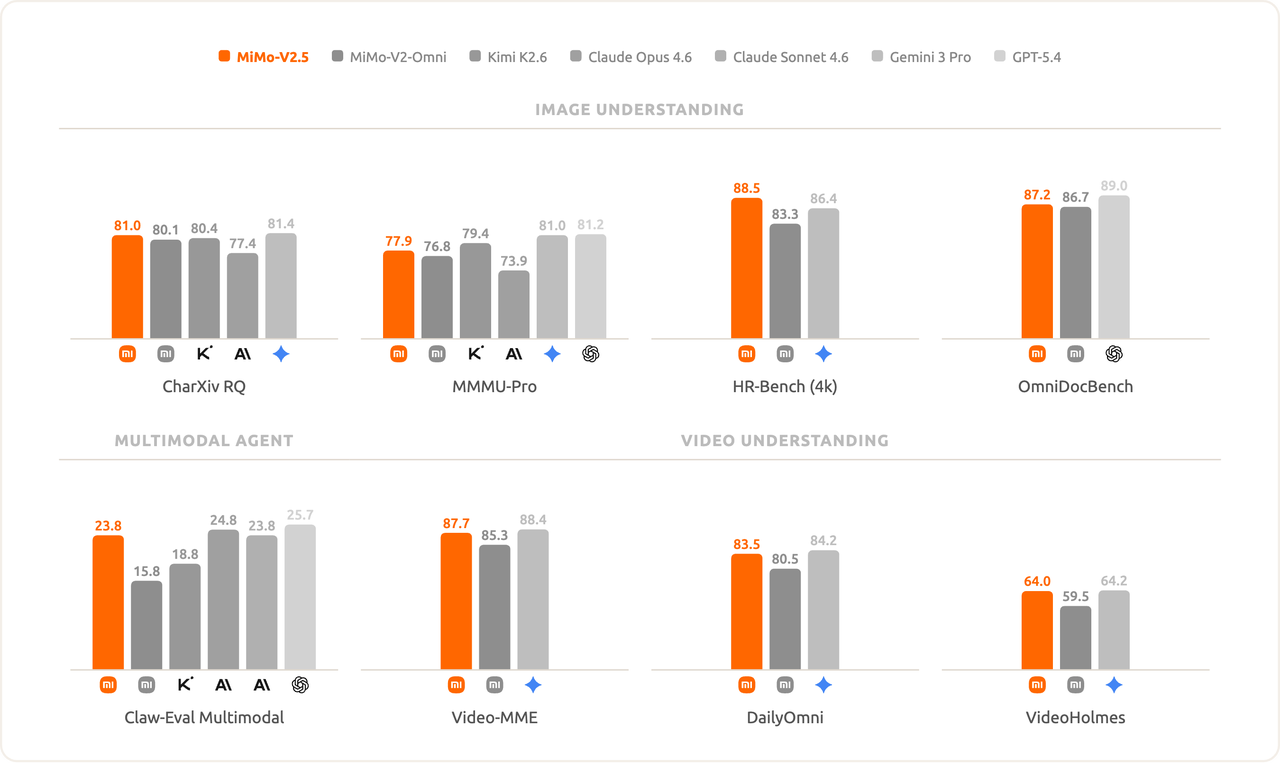
V2.5 akzeptiert nativ Text, Bilder, Video und Audio. Xiaomi kombiniert das Sprach-Backbone mit einem Vision-Encoder mit 729M Parametern und einem Audio-Encoder mit 261M Parametern, sodass multimodale Informationen direkt im gleichen Reasoning-Workflow teilnehmen.
Screenshots analysieren, bevor Tools aufgerufen werden.
Ein Video und dessen Audiotrack gemeinsam verstehen.
Informationen aus Diagrammen und Dokumentenbildern extrahieren.
Visuelle Schnittstellen und multimodale Support-Agenten bedienen.
Über lange Videosequenzen hinweg schlussfolgern.
V2.5-Pro folgt einem anderen Design. Xiaomi spezifiziert derzeit Text als Eingabemodalität und betont tiefes Reasoning, Code-Entwicklung und lang andauernde Tool-Orchestrierung.
Wenn der Workflow selbst Bild-, Video- oder Audioeingaben enthält, beginnen Sie mit V2.5. Testen Sie Pro, wenn der schwierige Teil das Reasoning über Text, Quellcode, Tools oder eine lange Agenten-Trajektorie ist.
Warum V2.5-Pro bei schweren Aufgaben besser sein kann
Modellskala: 310B/15B vs. 1.02T/42B
Beide Modelle nutzen Sparse-Mixture-of-Experts-Backbones, hybrides Sliding-Window- und Global-Attention, sowie drei Multi-Token-Prediction-Module. Xiaomis V2.5 Model Card dokumentiert ein Backbone mit 310B Gesamt- und 15B aktiven Parametern; die Pro Model Card skaliert auf 1.02T Gesamtparameter mit 42B aktivierten Parametern pro Token.
Architektur — offizielle Model Card
V2.5
Pro
Unterschied
Gesamtparameter
310B
1.02T
Ca. 3,3×
Aktive Parameter
15B
42B
2,8×
Hidden Size
4,096
6,144
1,5×
LLM-Schichten
48
70
22 mehr
Attention-Heads
64
128
2×
Geroutete Experten
256
384
1,5×
Experten pro Token
8
8
Gleich
MTP-Schichten
3
3
Gleich
V2.5 nutzt ein 5:1-Aufmerksamkeitsmuster, während Pro zu einem lokalen-zu-globalen Muster von 6:1 übergeht. Xiaomi sagt, dass diese Designs die KV-Cache-Anforderungen um nahezu 6× bzw. 7× reduzieren, verglichen mit vollständiger Attention im gesamten Netzwerk.
Gesamtparameter übersetzen sich nicht linear in Antwortqualität. Das größere Backbone von Pro zählt vor allem dann, wenn Schwierigkeitsgrad des Reasonings oder Trajektorienlänge kleine Zuverlässigkeitsgewinne pro Schritt kumulieren lässt.
Warum sich kleine Zuverlässigkeitsgewinne kumulieren
Eine lange Agentenaufgabe hat viele abhängige Schritte. Ein Fehler in einem frühen Toolaufruf kann Wiederholungen erzwingen oder spätere Arbeit entwerten, sodass ein bescheidener Gewinn an Zuverlässigkeit pro Schritt einen größeren Effekt auf die End-to-End-Fertigung haben kann. Evaluieren Sie diesen Effekt an repräsentativen Aufgaben, anstatt anzunehmen, dass die Modellgröße ihn garantiert.
Wo verbessert sich V2.5-Pro tatsächlich?
Der sauberste numerische Vergleich ist Xiaomis Base-Model-Evaluation, in der beide Modelle unter denselben Einstellungen erscheinen. So wird vermieden, Ergebnisse zu kombinieren, die mit unterschiedlichen Harnesses oder Post-Training-Konfigurationen erzeugt wurden.
Allgemeinwissen: Kleine bis moderate Zugewinne
In Xiaomis Base-Model-Vergleich gewinnt Pro 1,2 Punkte auf BBH, 3,1 auf MMLU und 2,7 auf MMLU-Pro. Das ist messbar, aber kleiner als die Zugewinne bei schwierigeren Reasoning-Aufgaben.
Mathematik und Naturwissenschaften: Größere Zugewinne
Pro gewinnt 8,6 Punkte auf GPQA-Diamond, 16,3 auf GSM8K und 18,5 auf MATH in derselben Base-Model-Evaluation. Das ist der klarste Hinweis, Pro zu wählen, wenn schwieriges Reasoning den Aufgabenerfolg treibt.
Coding: Besser, aber nicht durchgehend besser
Berichtet werden Zugewinne von 4,3 Punkten auf HumanEval+, 3,2 auf MBPP+, 4,1 auf LiveCodeBench v6 und 4,9 auf SWE-Bench AgentLess. Testen Sie Aufgaben auf Repository-Ebene und Tool-Nutzung separat: Diese Base-Model-Scores messen nicht jeden Produktions-Agent-Workflow.
Benchmark-Ergebnis: Pro ist nicht dreimal besser, nur weil es etwa dreimal so viel kostet. Es wird schrittweise wertvoller, je mehr der Schwierigkeitsgrad des Reasonings und die Aufgabendauer steigen.
Diese Zeilen sind Base-Model-Evaluierungen, keine Zusicherung, dass eine Produktions-API dieselben Scores reproduziert. Agent-Ergebnisse hängen von Tools, Prompts, Retries, Ausführungsumgebung und Tokenbudgets ab.
Post-Training und lang andauernde Agenten
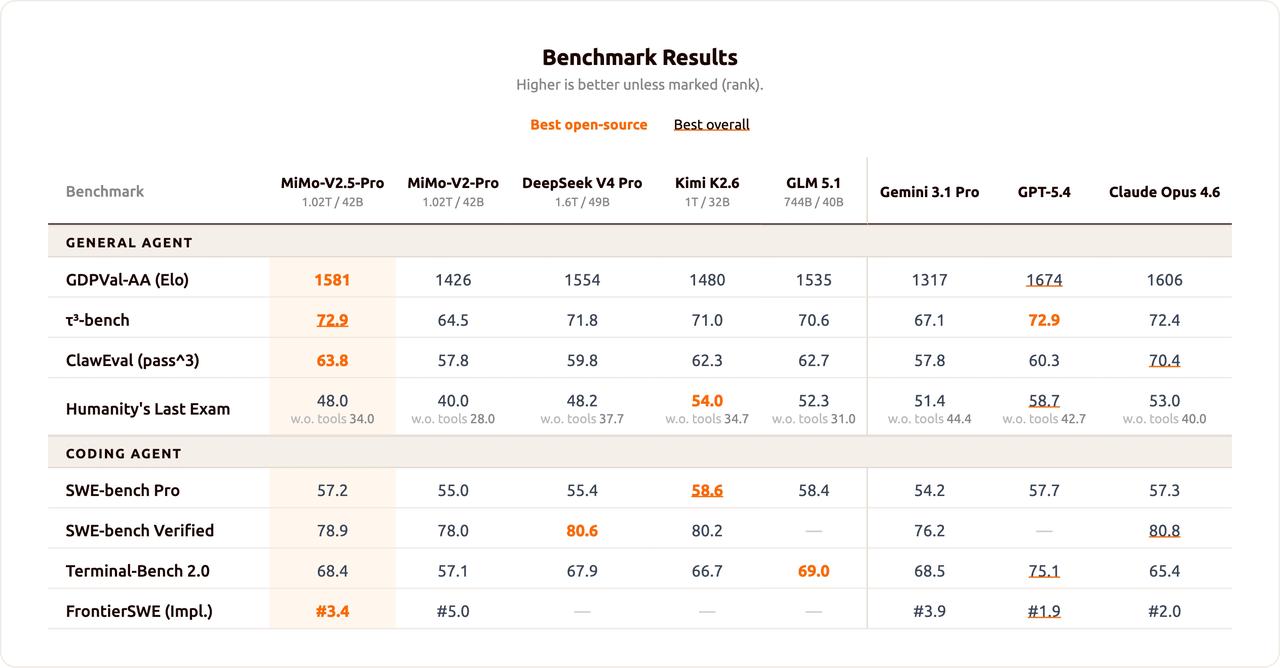
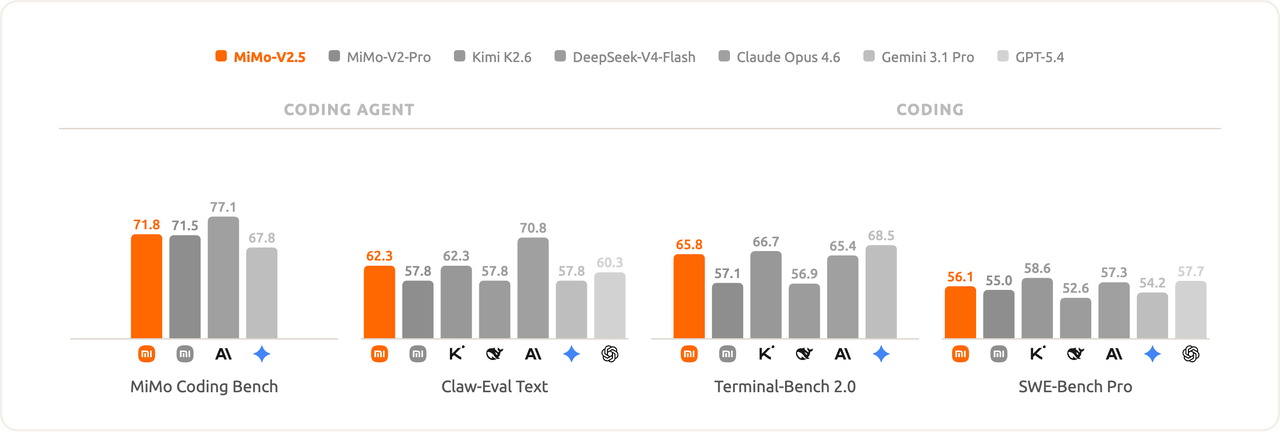
Die Produktionsmodelle fügen Supervised Fine-Tuning, agentisches Reinforcement Learning und Multi-Teacher On-Policy Distillation hinzu. Xiaomi berichtet Post-Training-Scores von 56,1 auf SWE-bench Pro, 65,8 auf Terminal-Bench 2.0 und 62,1 Pass³ im allgemeinen Teil von Claw-Eval für V2.5.
Pro ist expliziter auf lang andauernde Softwareentwicklung optimiert. Xiaomi beschreibt Hunderte Toolaufrufe in anhaltenden Trajektorien und veröffentlicht ein Ergebnis von 78,9% auf SWE-bench Verified.
Eine offizielle Fallstudie zeigt, dass Pro in 4,3 Stunden einen SysY-Compiler mit 672 Toolaufrufen fertigstellt und alle 233 Tests bestehen. Die Lehre ist nicht, dass jede Coding-Anfrage Pro benötigt; vielmehr, dass kleine Zuverlässigkeitsunterschiede darüber entscheiden können, ob ein Workflow mit Hunderten abhängiger Aktionen abgeschlossen wird.
Offizielle Xiaomi-Abbildung zu Coding- und Agent-Benchmarks.
Beide Modelle bieten über Xiaomis aktuelle API ein Kontextfenster von 1M Tokens und bis zu 128K Ausgabetokens. Die reine Kontextgröße unterscheidet sie daher nicht.
V2.5 ist attraktiv, wenn langer Kontext multimodales Material wie Video, Dokumentbilder oder visuelle Agent-Traces enthält. Pro ist das Modell der Wahl, wenn der Kontext selbst zum Reasoning-Problem wird: ein großes Repository, ein langer Vertrag, ein Forschungskorpus oder eine Agenten-Trajektorie mit vielen sequentiellen Aktionen.
Ein großes Kontextfenster beschreibt Kapazität, nicht garantierte Reasoning-Fidelity. Testen Sie Retrieval, Instruktionsbeibehaltung und Evidenznutzung in den Längen, die für die Anwendung relevant sind.
Eine Anfrage mit 1M nicht gecachten Eingabetokens und 200K Ausgabetokens kostet auf V2.5 geschätzt $0.196 und auf Pro $0.609 vor Cache-Treffern, Web-Suchgebühren oder anbieterspezifischer Abrechnung.
Der Cache-Preisunterschied ist kleiner: Pro ist bei Cache-Treffern für Eingaben etwa 29% teurer statt 211% teurer. Lang andauernde Agenten mit stabilen Systemprompts, Tooldefinitionen oder Repository-Präfixen sollten daher ihre tatsächliche Cache-Trefferrate messen.
Schätzen Sie die Kosten pro erfolgreicher Aufgabe. Ein Pro-Agent, der einen schwierigen Workflow einmal abschließt, kann weniger kosten als wiederholte Fehlversuche mit einem günstigeren Modell.
Welches Modell sollten Sie verwenden?
Arbeitslast — offizielle Leitlinie
Bessere Wahl
Warum
Routine-Textchat
V2.5
Geringere Kosten; Pro oft unnötig
Hochvolumige Generierung
V2.5
Etwa 3,1× niedrigerer Standardtoken-Preis
Bild-, Video- oder Audioverständnis
V2.5
Native multimodale Eingabe
Routine-Toolaufrufe
V2.5
Starke Agentenfähigkeit zu geringeren Kosten
Schwierige Mathematik und Naturwissenschaften
Pro
Größere Benchmark-Zugewinne
Coding auf Repository-Ebene
Pro
Für komplexe Softwareentwicklung ausgelegt
Hunderte abhängiger Toolaufrufe
Pro
Besser für anhaltende Ausführung geeignet
Kostenempfindlicher 1M-Kontext
V2.5
Gleiches nominelles Kontextfenster deutlich günstiger
Auswahlergebnis: V2.5 ist der Standard für multimodale Anwendungen, Routine-Agenten und kostenempfindige Workloads. Pro ist das Upgrade für schwieriges Reasoning, komplexe Softwareentwicklung und lange autonome Trajektorien.
Eine bessere Produktionsstrategie: zwischen beiden routen
Eine einzige globale Modellauswahl ist oft unnötig. Leiten Sie multimodale und Routineanfragen an V2.5 und eskalieren Sie nur schwieriges Textreasoning, komplexes Coding oder lang andauernde Ausführung zu Pro.
Bewertungsdimension
Messgröße
Warum es wichtig ist
Routing-Signal
Abschluss
Erfolgreiche Aufgaben/Versuche
Erfasst End-to-End-Zuverlässigkeit
Klassen mit niedrigem Abschluss eskalieren
Qualität
Menschliche oder Rubrik-Note
Verhindert, dass Tokenkosten dominieren
Hochstufige Aufgaben eskalieren
Tool-Zuverlässigkeit
Fehler und Retries
Kleine Fehler kumulieren sich bei Agenten
Lange Trajektorien eskalieren
Latenz
Zeit bis zum akzeptierten Ergebnis
Beinhaltet Retry-Overhead
Interaktive Aufgaben leichtgewichtig halten
Kosten
Aufwand pro akzeptierter Aufgabe
Spiegelt Fehler und Neuversuche wider
Günstigstes erfolgreiches Modell nutzen
Beide APIs in CometAPI testen
MiMo-V2.5 API in CometAPI und MiMo-V2.5-Pro API in CometAPI unterstützen Side-by-Side-Evaluation über eine Aggregationsschicht. Senden Sie dieselben Prompts, Systemanweisungen, Tools und Ausgabelimits an beide Modelle und vergleichen Sie dann Aufgabenerfolg und Kosten.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Überprüfen Sie diesen Implementierungsplan.
Identifizieren Sie verborgene technische Risiken und schlagen Sie die drei Korrekturen mit der höchsten Priorität vor.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Führen Sie einen repräsentativen Batch aus, der einfache Anfragen, schwieriges Reasoning, Code-Editing, Langkontext-Aufgaben und Agenten-Toolaufrufe enthält. Protokollieren Sie Abschlussrate, Tokens, Latenz, Toolfehler, Retries, Antwortqualität und Kosten pro erfolgreicher Aufgabe.
Einschränkungen
V2.5-Einschränkungen
Das kleinere Sprach-Backbone lässt mit zunehmender Reasoning-Schwierigkeit Leistung liegen. Die Lücke ist bei BBH moderat, wird aber bei GPQA-Diamond und MATH wesentlich größer. Ein Kontextfenster von 1M Tokens ist zudem nicht gleichbedeutend mit garantierter Reasoning-Fidelity über 1M Tokens.
Pro-Einschränkungen
Pros Standardpreise für Ein- und Ausgabe liegen etwa 3,1× über denen von V2.5, und die reine Texteingabe macht es als Drop-in-Ersatz für multimodale Anwendungen ungeeignet. Das offene 1,02T-Parameter-Gewichtsmodell ist auch ein anspruchsvolles Self-Hosting-Projekt, auch wenn pro Token 42B Parameter aktiviert werden.
Abschließendes Urteil
Wählen Sie V2.5 für multimodale Anwendungen, Routine-Agenten und kostenempfindliche Produktion. Wählen Sie Pro für schwieriges Reasoning, komplexe Softwareentwicklung und lang laufende autonome Agenten. Für gemischte Workloads leiten Sie den Großteil des Traffics an V2.5 und eskalieren nur Anfragen, deren Schwierigkeit oder Trajektorienlänge die zusätzlichen Kosten rechtfertigt.
FAQ
Ist Pro immer besser als V2.5?
Nein. Pro ist stärker bei schwierigem Textreasoning und Coding, aber V2.5 unterstützt Bild-, Video- und Audioeingabe und ist deutlich günstiger.
Unterstützen beide Modelle ein Kontextfenster von 1M Tokens?
Ja. Beide werben mit 1M Tokens Kontext und bis zu 128K Ausgabetokens. Anwendungen sollten dennoch Retrieval und Reasoning in ihren tatsächlichen Betriebslängen testen.
Welches Modell sollte ein multimodaler Agent verwenden?
Beginnen Sie mit V2.5, da es visuelle und Audioeingaben nativ akzeptiert. Pro zielt derzeit auf Workflows mit Texteingabe.
Wann lohnt sich der höhere Preis von Pro?
Am besten zu rechtfertigen ist er, wenn bessere Reasoning-Zuverlässigkeit den Abschluss schwieriger Mathematik, Coding auf Repository-Ebene oder langer Trajektorien mit vielen abhängigen Toolaufrufen beeinflusst.
Sollten Produktionssysteme nur ein einziges Modell verwenden?
Nicht zwingend. Eine Routing-Schicht kann Routine- und multimodale Arbeit auf V2.5 halten und schwierige Text- und Agentenaufgaben zu Pro eskalieren.