Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
So reduzieren Sie die Token-Kosten von KI-Agenten im Produktivbetrieb
Senken Sie die Token-Kosten von KI-Agenten, indem Sie das Kontextwachstum, die Tool-Ausgaben, Wiederholversuche, das Reasoning und Subagenten steuern. Enthält ein Kostenbeispiel in 12 Schritten.
Die Token-Kosten von KI-Agenten steigen, wenn bei jedem Schritt Anweisungen, Verlauf, Tool-Ergebnisse und Zwischenzustände erneut verarbeitet werden.
Reduzieren Sie das Token-Volumen mit Budgets auf Run-Ebene, Filterung von Tool-Ergebnissen, Kontextverdichtung, Retry-Grenzen und kontrolliertem Reasoning. Nutzen Sie Prompt-Caching für stabil wiederholte Eingaben, optimieren Sie jedoch zuerst die Agentenschleife, bevor Sie auf ein günstigeres Modell wechseln.
Die nützlichste Kennzahl im Betrieb ist die Kennzahl Kosten pro erfolgreicher Aufgabe, gemessen über den gesamten Run – nicht der Preis pro Anfrage oder die Kontextgröße des letzten Aufrufs.
Dieser Leitfaden konzentriert sich explizit auf mehrschrittige KI-Agenten. Er erklärt, wie sich wiederholter Kontext über einen Run kumuliert, wie Sie die größte Verschwendungsquelle identifizieren und welche Maßnahmen zuerst zu implementieren sind.
Introduction
Ein Chatbot sendet pro Nutzer-Nachricht möglicherweise eine einzige Modellanfrage. Ein KI-Agent kann 10, 20 oder mehr Aufrufe durchführen, bevor er eine Aufgabe abschließt.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
In jedem Schritt können Anweisungen, Gesprächsverlauf, Tool-Ergebnisse und Zwischenzustände erneut gesendet werden. Retries, Reasoning und Subagenten erhöhen die Nutzung weiter, sodass eine kurze finale Antwort dennoch eine große Anzahl von Token verbrauchen kann.
Mit wachsender Nutzung werden diese Kosten schwerer vorhersehbar und können die Produktmargen schnell verringern. Ihre Senkung erfordert die Optimierung der gesamten Agentenschleife – nicht nur den Wechsel auf ein günstigeres Modell.
Dieser Artikel konzentriert sich auf agentenspezifische Kosten. Für einen breiteren Leitfaden zu Prompt-Caching, exaktem Antwort-Caching, semantischem Caching, Modell-Routing und allgemeinem API-Kostenmanagement siehe How to Reduce AI API Costs.
Why Do AI Agent Token Costs Compound?
Bei einem mehrschrittigen Agenten sind die Kosten einer Aufgabe die Summe aller Modellaufrufe – nicht nur der finalen Antwort.
Die Hauptquellen des Token-Verbrauchs von Agenten sind:
Cost source
What causes it
First control to test
Repeated instructions
System prompts, tool schemas, policies, examples
Stabilize the reusable prefix
Growing history
Earlier turns are resent at each step
Compact or selectively retrieve state
Tool results
Search pages, files, logs, and database records
Filter before adding them to context
Intermediate output
Plans, status messages, and verbose tool decisions
Use compact structured outputs
Reasoning tokens
High reasoning effort on routine steps
Match effort to task complexity
Retries
Invalid output, timeouts, tool errors, and rate limits
Classify failures and cap retries
Subagents
Workers duplicate context, tools, and analysis
Send each worker a narrow context slice
Es gibt zwei unterschiedliche Wege, die Rechnung zu reduzieren:
Weniger Token verarbeiten durch Filterung, Verdichtung, Ausgabelimits und Loop-Kontrollen.
Den effektiven Preis notwendiger Token durch Prompt-Caching oder Modellauswahl senken.
Wichtige Unterscheidung: Prompt-Caching senkt die Kosten wiederholter Eingaben. Kontextverdichtung reduziert die wiederholte Eingabe selbst.
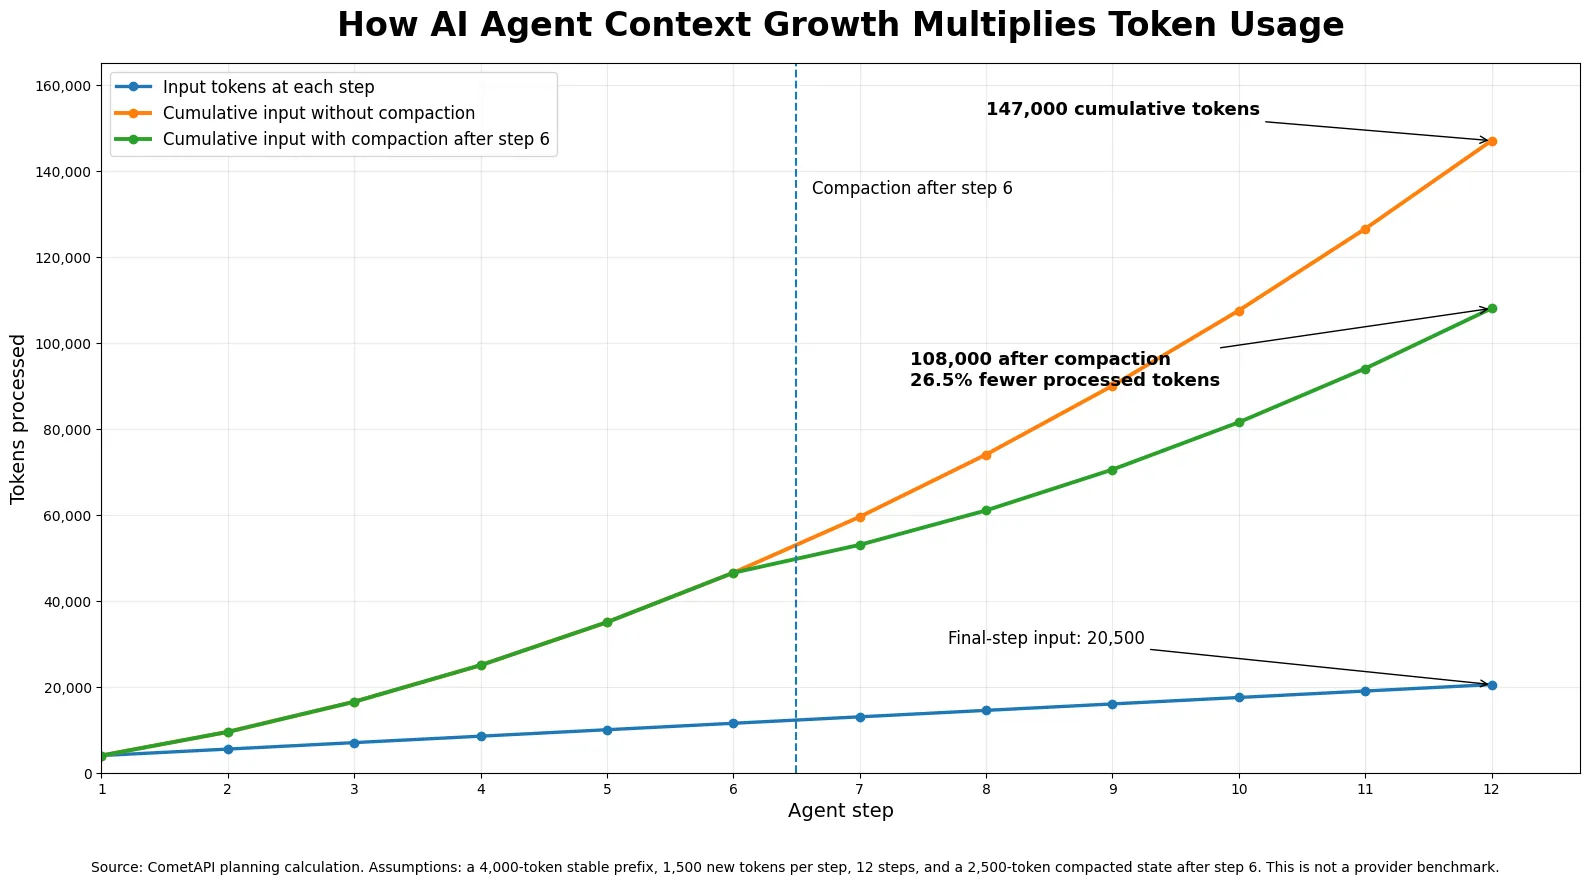
How Can a 12-Step Agent Process 147,000 Tokens?
Betrachten wir einen hypothetischen Support-Agenten mit:
einem stabilen Präfix von 4.000 Token
1.500 neuen Token nach jedem Schritt
dem komplett kumulierten Verlauf, der bei jeder Anfrage erneut gesendet wird
Der letzte Aufruf enthält nur 20.500 Eingabetoken, aber der gesamte Run verarbeitet 147.000 kumulierte Eingabetoken.
Wenden wir nun zwei Maßnahmen an:
Das stabile Präfix mit 4.000 Token nach dem ersten Aufruf cachen.
Den Verlauf nach Schritt sechs in einen 2.500-Token-Zustand verdichten.
Scenario
Uncached input
Cached input
Total processed input
Change
Full history on every step
147,000
0
147,000
Baseline
Stable prefix cached
103,000
44,000
147,000
Same volume, cheaper mix
Cache plus compaction
64,000
44,000
108,000
26.5% fewer processed tokens
Dies ist eine Planungsrechnung, kein Anbieter-Benchmark.
Es wird angenommen, dass jede Anfrage den komplett kumulierten Verlauf enthält. Agenten, die Zustand selektiv konstruieren, alte Nachrichten zusammenfassen oder nur relevante Informationen abrufen, können einer anderen Kostenkurve folgen.
Kostenwachstums-Regel: Messen Sie die kumulierte Eingabe über den gesamten Run. Die finale Kontextgröße repräsentiert nicht die insgesamt verarbeiteten Token.
Which Metrics Reveal Agent Token Waste?
Beginnen Sie nicht mit dem Modellwechsel. Identifizieren Sie zuerst, wo der Workflow Token verbraucht, ohne das Ergebnis zu verbessern.
Protokollieren Sie diese Felder für jeden Agenten-Schritt:
Field
Why it matters
run_id, step_id, parent_step_id
Rekonstruiert den Agenten- und Subagenten-Baum
Rendered input tokens
Zeigt, wie der Kontext zwischen Aufrufen wächst
Cached and uncached input
Trennt Wiederverwendung von neuem Kontext
Output and reasoning tokens
Identifiziert teure Generierungsschritte
Tool result size and retained tokens
Zeigt, wie viel Roh-Evidenz in spätere Prompts gelangt
Retry reason and attempt number
Identifiziert wiederholte Fehler
Compaction tokens before and after
Misst die tatsächliche Kontextreduktion
Worker ID and returned tokens
Deckt doppelte Subagenten-Arbeit auf
Accepted, rejected, or escalated result
Verknüpft Kosten mit der Aufgabenqualität
Die primäre Kennzahl sollte sein:
cost per successful task
= total workflow cost
/ accepted tasks
Ein günstigerer Run ist keine Verbesserung, wenn er mehr Fehlversuche, wiederholte Tools oder menschliche Nacharbeit erzeugt.
Vier agentenspezifische Metriken helfen, das Problem zu lokalisieren.
Ein hoher Wert zeigt an, dass früherer Kontext wiederholt verarbeitet wird.
Tool Retention Ratio
tool retention ratio
= tool-result tokens retained in context
/ tokens originally returned by tools
Eine hohe Quote kann darauf hindeuten, dass der Agent zu viel Roh-Evidenz zwischen Schritten mitschleppt.
Retry Tax
retry tax
= retry and repair cost
/ total workflow cost
Reasoning Share
reasoning share
= reasoning-token cost
/ total model cost
Messen Sie jede Arbeitslast separat. Forschungs-, Coding-, Browser- und Customer-Support-Agenten sollten keinen globalen gemeinsamen Basiswert haben.
Six Ways to Reduce AI Agent Token Costs
1. Set a Budget for the Complete Run
Eine Ausgabelimitierung pro Anfrage steuert einen mehrschrittigen Agenten nicht.
Setzen Sie Limits auf Run-Ebene für:
Gesamtzahl der Modellschritte
Kumulative Ein- und Ausgaben
Tool-Aufrufe und Größe der Tool-Ergebnisse
Retries nach Fehlertyp
Subagenten
Gesamte verstrichene Zeit oder geschätzte Kosten
Das folgende anbieterneutrale Python-Beispiel bewertet den Run vor jedem Modellaufruf:
from dataclasses import dataclass
from enum import Enum


class Action(str, Enum):
    CONTINUE = "continue"
    COMPACT = "compact"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    max_steps: int = 12
    max_input_tokens: int = 120_000
    max_output_tokens: int = 18_000
    compact_at: float = 0.80


@dataclass
class Usage:
    steps: int = 0
    input_tokens: int = 0
    output_tokens: int = 0


def evaluate_budget(usage: Usage, budget: Budget) -> Action:
    if (
        usage.steps >= budget.max_steps
        or usage.input_tokens >= budget.max_input_tokens
        or usage.output_tokens >= budget.max_output_tokens
    ):
        return Action.STOP

    input_ratio = usage.input_tokens / budget.max_input_tokens

    if input_ratio >= budget.compact_at:
        return Action.COMPACT

    return Action.CONTINUE
Führen Sie die Prüfung vor jeder Modellanfrage aus und aktualisieren Sie Usage mit den vom Anbieter gemeldeten Token-Daten.
Bei 80% des Eingabebudgets verdichten Sie den Zustand oder verengen die nächste Tool-Abfrage. Bei 100% stoppen Sie mit einer strukturierten Begründung.
Häufiger Fehler: Jede Antwort begrenzen, aber unbegrenzte Schritte, Tools und Retries zulassen.
2. Filter Tool Results Before They Enter the Transcript
Geben Sie nur die Belege zurück, die der Agent für die nächste Entscheidung benötigt.
Hängen Sie nicht eine ganze
Webseite
Logdatei
Repository-Struktur
Datenbankantwort
Terminalsitzung
API-Nutzlast
an, wenn der nächste Schritt nur wenige Felder braucht.
Ein Such-Tool könnte Folgendes zurückgeben:
{
  "source_id": "search_17",
  "title": "Relevant page title",
  "url": "https://example.com/page",
  "relevant_passage": "A short evidence block"
}
Speichern Sie das vollständige Artefakt außerhalb des Prompts und rufen Sie später einen engeren Abschnitt ab.
Regel zur Tool-Filterung: Geben Sie die Felder zurück, die für die nächste Entscheidung nötig sind – nicht jedes Feld, das später nützlich sein könnte.
Häufiger Fehler: Die ersten 1.000 Zeichen einer JSON-Nutzlast abzuschneiden. Dies kann die Struktur zerstören oder die tatsächlich benötigten Datensätze entfernen.
Parsen Sie die Nutzlast zuerst, wählen Sie Felder strukturell aus, begrenzen Sie Arrays und serialisieren Sie anschließend gültiges JSON.
3. Compact Operational State, Not Just Conversation Text
Verdichtung soll die Informationen bewahren, die zum Fortsetzen der Aufgabe erforderlich sind, während Historie entfernt wird, die die nächsten Aktionen nicht mehr beeinflusst.
Ein nützlicher verdichteter Zustand enthält:
Nutzerziel und Erfolgskriterien
Bereits getroffene Entscheidungen
Verifizierte Fakten und Quell-IDs
Geänderte Dateien oder Datensätze
Gescheiterte Ansätze
Offene Fragen
Die nächste Aktion
Sicherheits- und Ausgabebeschränkungen
Er sollte nicht die komplette Unterhaltung nacherzählen.
OpenAI dokumentiert Verdichtung für lang laufende Interaktionen der Responses API. Anthropic bietet Kontext-Management-Kontrollen zum Löschen oder Zusammenfassen älterer Inhalte. Diese Implementierungen unterscheiden sich, prüfen Sie daher vor der Integration die aktuellen Felder des Anbieters.
Regel zur Verdichtung: Entscheidungen und unerledigte Arbeit bewahren. Erzählung und Belege entfernen, die erneut abrufbar sind.
Häufiger Fehler: Quell-IDs, geänderte Dateinamen, verworfene Ansätze oder ungelöste Constraints zu löschen.
Messen Sie nach der Einführung der Verdichtung, ob der Agent Suchen oder Tool-Aufrufe wiederholt. Ein kürzerer Prompt ist nicht günstiger, wenn der Agent verlorenen Zustand neu aufbauen muss.
4. Keep the Reusable Prefix Stable
Agenten-Prompts enthalten oft große wiederverwendbare Blöcke:
Systemanweisungen
Tool-Schemata
Sicherheitsrichtlinien
Ausgabeformate
Gemeinsames Referenzmaterial
Repository- oder Produkthinweise
Platzieren Sie diese stabilen Elemente vor den anfrage-spezifischen Daten:
1. System instructions
2. Policies and constraints
3. Tool definitions
4. Stable examples
5. Shared reference material
6. Request-specific data
Vermeiden Sie es, Zeitstempel, Request-IDs, Sitzungsdaten oder häufig wechselnde Werte nahe dem Anfang zu platzieren.
Caching ist am nützlichsten, wenn das Präfix lang, stabil und wiederverwendet ist. Für kurze Sitzungen oder häufig wechselnde Prompts bringt es möglicherweise keine Einsparungen.
Häufiger Fehler: Auf Cache-Trefferquote optimieren, ohne die Kosten für Cache-Schreiben, -Lesen oder -Speicherung zu messen.
Für einen breiteren Vergleich von Anbieter-Prompt-Caching, exaktem Antwort-Caching und semantischem Caching siehe How to Reduce AI API Costs.
5. Prevent Retries From Replaying the Same Context
Ein Retry ist ein weiterer Agenten-Schritt – oft mit demselben großen Prompt.
Wiederholen Sie eine fehlgeschlagene Anfrage nicht, ohne die Ursache zu ändern.
Failure
Better response
Invalid structured output
Validierungsfehler zurückgeben und einmal erneut versuchen
Tool timeout
Eine idempotente Operation einmal wiederholen, dann stoppen oder Fallback nutzen
Context overflow
Zustand verdichten oder weniger Evidenz abrufen
Repeated tool call
Mit einem Operations-Hash deduplizieren
Rate limit
Backoff oder getestete Fallback-Route nutzen
Low-confidence result
Fehlende Informationen anfordern oder eskalieren
Verwenden Sie Idempotenzschlüssel für Operationen mit Nebenwirkungen wie Zahlungen, E-Mails, Deployments und Datenbankschreibvorgänge.
Häufiger Fehler: Ein rate-limitiertes Modell mehrfach erneut aufrufen und dabei jedes Mal den gesamten Agenten-Kontext erneut senden.
Verfolgen Sie die Retry-Steuer nach Fehlertyp, damit das Team die größte Schleife zuerst beheben kann.
6. Limit Reasoning and Subagents to Steps That Need Them
Nicht jeder Agenten-Schritt benötigt tiefes Reasoning.
Extraktion, Formatierung, Klassifikation, Validierung und routinemäßige Tool-Auswahl können oft mit geringerem Reasoning-Aufwand und kompakten strukturierten Ausgaben erfolgen.
Reservieren Sie höheren Reasoning-Aufwand für Aufgaben wie:
Komplexe Planung
Anspruchsvolles Coding
Synthese über mehrere Dokumente
Mehrdeutige Entscheidungen
Wiederherstellung nach fehlgeschlagener Ausführung
Regel zum Reasoning: Verwenden Sie den geringsten Reasoning-Aufwand, der die Akzeptanzrate der Aufgaben erhält.
Auch Subagenten benötigen eine klare Abgrenzung. Geben Sie jedem Worker:
Eine enge Aufgabe
Einen aufgabenspezifischen Kontextausschnitt
Eine Tool-Allowlist
Ein Token-Budget
Ein kompaktes Ausgabeschema
Der Root-Agent braucht in der Regel Ergebnisse, Evidenz-IDs, Vertrauen und ungelöste Punkte – nicht das vollständige Transkript des Workers.
Subagenten-Regel: Parallelisieren Sie unabhängige Arbeit, nicht duplizierten Kontext.
Häufiger Fehler: Dem vollständigen Root-Agenten-Verlauf an jeden Worker zu senden, bevor eine enge Aufgabe zugewiesen wird.
Which Optimization Should You Apply First?
Nutzen Sie Agenten-Telemetrie, um die erste Maßnahme auszuwählen.
Die folgenden Schwellen sind Auslöser für Untersuchungen, keine universellen Standards.
Observed signal
Start here
Context amplification is high
Verlauf verdichten und Zustand selektiv abrufen
Tool output dominates the prompt
Felder filtern und vollständige Artefakte extern speichern
Retry tax is high
Validierung, Timeouts und wiederholte Tool-Aufrufe beheben
Reasoning share is high
Aufwand bei Routine-Schritten senken
Subagents repeat the same evidence
Worker-Scopes und Kontextausschnitte verengen
Cached input remains low
Wiederverwendbares Präfix stabilisieren
Costs remain high after loop cleanup
Günstigere Modellrouten vergleichen
Eine sichere Implementierungsreihenfolge ist:
Kumulative Eingabe, Tool-Beibehaltung, Retries und Reasoning messen.
Harte Limits für Schritte, Tools, Retries und Gesamt-Token hinzufügen.
Große Tool-Ergebnisse filtern.
Älteren Zustand ab einem gemessenen Schwellwert verdichten.
Das wiederverwendbare Prompt-Präfix stabilisieren.
Modellrouten erst vergleichen, nachdem die Agentenschleife bereinigt ist.
Ändern Sie jeweils nur eine große Variable und spielen Sie denselben Evaluationssatz erneut ab.
Vergleichen Sie:
Aufgaben-Akzeptanzrate
Kosten pro erfolgreicher Aufgabe
Kumulative Eingabe
Anzahl der Tool-Aufrufe
Retry-Steuer
Reasoning-Anteil
p50- und p95-Latenz
Zeit für menschliche Überprüfung
Setzen Sie Änderungen zurück, die Token sparen, indem sie die Aufgabenqualität senken oder notwendige Evidenz entfernen.
Test Agent Workflows With CometAPI
Bevor Sie eine Multi-Modell-Evaluation starten, verwenden Sie die CometAPI pricing page und den cost estimation guide, um Eingabe-, Ausgabe-, gecachte Token- und Reasoning-Kosten zu schätzen.
Nutzen Sie anschließend den model catalog, um geeignete Routen zu identifizieren, und den Quickstart, um einen OpenAI-kompatiblen Client zu konfigurieren.
Für Fallback im Produktivbetrieb folgen Sie dem CometAPI model fallback guide, um Routen zu wechseln, ohne bereits ausgeführte Tool-Aufrufe zu wiederholen oder validierten Zustand zu verwerfen.
Einheitlicher Zugriff vereinfacht den Modellvergleich und die Fallback-Integration. Token-Budgets, Verdichtung, Validierung, Tool-Filterung, Retry-Grenzen und Abnahmekriterien gehören dennoch auf die Anwendungsebene.
FAQ
Why do AI agents use more tokens than chatbots?
Agenten führen mehrere Modellaufrufe aus und können bei jedem Schritt frühere Nachrichten, Tool-Ergebnisse, Anweisungen und Zwischenzustände erneut senden. Dadurch wird früherer Kontext wiederholt verarbeitet.
Does prompt caching reduce context-window usage?
Nein. Prompt-Caching kann den effektiven Preis oder die Latenz wiederholter Eingaben senken, aber gecachte Token sind weiterhin Teil des verarbeiteten Kontexts. Verwenden Sie Verdichtung, Filterung oder selektiven Abruf, um die Prompt-Größe zu reduzieren.
When should an AI agent compact its context?
Verdichten Sie, bevor das Kontextwachstum Kosten, Latenz oder verfügbaren Ausgaberaum beeinflusst. Vergewissern Sie sich, dass der verdichtete Zustand Entscheidungen, Evidenz-IDs, geänderte Dateien, offene Fragen und Sicherheits-Constraints bewahrt.
Do subagents reduce token costs?
Nicht automatisch. Sie können die verstrichene Zeit reduzieren oder die Abdeckung unabhängiger Arbeit verbessern, aber duplizierter Kontext und überlappende Analysen erhöhen oft den gesamten Token-Verbrauch.
What is the best metric for AI agent cost optimization?
Verwenden Sie Kosten pro erfolgreicher Aufgabe als primäre Kennzahl. Diagnostizieren Sie sie mit kumulativer Eingabe, Kontextverstärkung, Tool-Beibehaltung, Retry-Steuer, Reasoning-Anteil, Latenz und Zeit für menschliche Prüfung.