Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Tencent Hyra 2.0: Harness-Architektur, Benchmarks und Ergebnisse
Erkunden Sie Tencent Hunyuan Hyra 2.0, sein dreischichtiges Agenten-Harness Harness, wissenschaftliche Modelle, Benchmarks, Forschungsdurchbrüche und die Unterschiede zu Hyra 1.0.
Tencent Hunyuan stellte am 2. November 2026 Hyra 2.0 als Forschungs-Harness für die Entwicklung wissenschaftlicher Modelle, Softwarewerkzeuge und wiederverwendbarer Workflows vor. Das prägende Merkmal ist die persistente Koordination über mehrtägige oder mehrwöchige Experimente hinweg.
Die öffentliche Veröffentlichung besteht derzeit aus ausgewählten Forschungsartefakten – Modellen, Code, Gewichten und Berichten – und nicht aus einem allgemein verfügbaren gehosteten Hyra-2.0-Dienst. Mit Stand 4. November 2026 dokumentieren die öffentlichen Materialien von Tencent keine allgemeine Orchestrierungs-API oder ein Abonnementangebot.
Key Takeaways
Forschungsziel: Hyra 2.0 entwickelt wiederverwendbare wissenschaftliche Modelle und Werkzeuge, die mehr als ein Forschungsprojekt unterstützen können.
Persistente Koordination: Overall-, Mission- und Worker-Agenten teilen Verantwortlichkeiten, während Warteschlangen und Forschungsaufzeichnungen den Fortschritt über lange Experimente hinweg bewahren.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Wiederverwendbares Wissen: Agent Memory, Books und Forschungsfähigkeiten halten Erkenntnisse zusammen mit unterstützender Evidenz und Einsatzbedingungen fest.
Aufgabenspezifische Ergebnisse: Die veröffentlichten Protein-, Kraftfeld- und Zellmodelle adressieren unterschiedliche wissenschaftliche Workloads; Geschwindigkeit und Qualität sollten gemeinsam bewertet werden.
Praktischer Zugang: Beginnen Sie mit den verfügbaren Forschungsartefakten. Das vollständige Hyra-Harness und die gehosteten Hunyuan-Model-APIs sind unterschiedliche Angebote.
What Is Tencent Hunyuan Hyra 2.0?
Hyra 2.0 steht für Hunyuan Research Agent 2.0, ein Multi-Agent-System zur Automatisierung komplexer wissenschaftlicher Forschungs- und Engineering-Workflows.
Tencent präsentiert Hyra 2.0 als einen Wandel weg vom Lösen isolierter Probleme hin zur Entwicklung von Modellen, Methoden und Infrastruktur, mit denen eine breitere Klasse von Fragestellungen untersucht werden kann.
Hyra 2.0 ist kein eigenständiges Foundation-Modell mit fester Parameterzahl oder Context Window. Es ist ein Orchestrierungssystem, das verschiedene KI-Modelle nutzen, Code ausführen, wissenschaftliche Experimente managen und spezialisierte Forschungsagenten koordinieren kann.
Wissenschaftliche Forschung umfasst mehr als bloßes Schlussfolgern. Ein vollständiges Projekt kann Versuchsdesign, Implementierung, Training, Debugging, Evaluation und wiederholte Revisionen erfordern. Diese Aktivitäten können sich über mehrere Tage oder Wochen erstrecken und umfassen häufig parallele Experimente und geteilte Rechenressourcen.
Hyra 2.0 adressiert diese operative Herausforderung, indem es Modellintelligenz mit persistenter Ausführung, strukturierter Zusammenarbeit und evidenzbasierter Verifikation verbindet.
Hyra 2.0 Technical Specifications
Specification
Hyra 2.0
Developer
Tencent Hunyuan
Public announcement
2. November 2026
System category
Autonomer wissenschaftlicher Forschungsagent
Core architecture
Hierarchisches Multi-Agent-Harness
Agent roles
Overall, Mission, Worker
Research execution
Lang laufende, gleichzeitige Workflows
Task management
Persistente Aufgabenwarteschlange
Collaboration
Research Board und Agenten-Messaging
Verification
Evidenzgestützte Ergebnisse und unabhängige Review Worker
Die Spezifikationen des Systems beschreiben seine Orchestrierungs- und Forschungsfähigkeiten. Einzelne wissenschaftliche Modelle, die von Hyra 2.0 erstellt wurden, haben eigene Architekturen, Parameterzahlen und Leistungsbenchmarks.
Why Hyra 2.0 Builds Tools
Der Übergang von Hyra 1.0 zu Hyra 2.0 adressiert eine grundlegende Begrenzung automatisierter Forschung: Das erfolgreiche Lösen eines Problems verbessert nicht zwingend die Fähigkeit des Systems, das nächste zu lösen.
Hyra 1.0 nutzte eine relativ einfache Agentenschleife, um Lösungen zu generieren, Auswertungen durchzuführen und Ergebnisse durch wiederholte Versuche zu verbessern. Angetrieben vom Open-Source-Modell Hy3 von Tencent trug Hyra 1.0 zur Bestimmung des optimalen Exponenten bei, der Summenmengen und Differenzmengen verknüpft; ein maschinengeprüfter Beweis wurde zusammen mit dem Ergebnis veröffentlicht. Der Unterschied ist wichtig: Ein evaluiertes mathematisches Resultat ist eine konkrete Ausgabe, während eine Verbesserung des Forschungsprozesses über spätere Probleme hinweg wiederverwendet werden kann.
Die nächste Herausforderung besteht darin, Forschungsfortschritt kumulativ zu machen.
From Answers to Reusable Capabilities
Betrachten Sie drei Stufen mathematischer Automatisierung:
Ein Agent löst ein einzelnes mathematisches Problem.
Ein Agent entwickelt einen Beweis-Workflow, der ähnliche Probleme lösen kann.
Ein Agent verbessert die Reasoning-Modelle und Verifikationstools, die von zukünftigen Forschungssystemen genutzt werden.
Die erste Stufe liefert eine Antwort. Die zweite liefert eine wiederverwendbare Methode. Die dritte kann die zugrunde liegende Forschungsfähigkeit selbst verbessern.
Hyra 2.0 zielt auf die zweite und dritte Stufe.
Tencent beschreibt zwei breite Kategorien wiederverwendbarer Werkzeuge. Symbolische Werkzeuge drücken Fähigkeiten durch Code, Algorithmen, Regeln und Workflows aus. Beispiele sind automatisierte Verifikationssysteme, wissenschaftliche Suchalgorithmen und Pipelines für das Experimentmanagement. Parametrische Werkzeuge speichern erlernte Fähigkeiten in Modellgewichten, einschließlich Proteindesign-Modellen und wissenschaftlichen Foundation-Modellen.
Die Verbesserung einer der beiden Kategorien kann mehreren nachgelagerten Aufgaben zugutekommen, ohne dass jedes Forschungsprojekt vom gleichen Ausgangspunkt starten muss.
The Direction Toward Recursive Self-Improvement
Hyra 2.0 schafft auch einen Pfad zur rekursiven Selbstverbesserung. Forschung an Foundation-Modellen hängt von Trainingsinfrastruktur, Pipelines für synthetische Daten, Optimierungsalgorithmen und Inferenzsystemen ab.
Wenn KI-Agenten diese Werkzeuge verbessern, können sie bei der Entwicklung stärkerer Modelle helfen. Diese stärkeren Modelle können dann in nachfolgenden Runden der Werkzeugentwicklung mitwirken.
Tencent beschreibt den Einsatz von Hyra für Pretraining-Infrastruktur, Post-Training-Datengenerierung und Inferenzoptimierung. Dies schafft eine plausible Rückkopplungsschleife zwischen Tool- und Modellentwicklung. Für sich genommen etabliert es jedoch keine unbegrenzte oder vollständig autonome rekursive Verbesserung; jeder vorgeschlagene Gewinn braucht weiterhin ein Experiment, das seinen Effekt isoliert.
How Does the Hyra 2.0 Harness Architecture Work?
Das Harness ist die zentrale technische Innovation von Hyra 2.0. Eine konventionelle Agentenschleife kann Werkzeuge ausführen, Ergebnisse inspizieren und innerhalb einer Sitzung weiter schlussfolgern. Die Entwicklung wissenschaftlicher Modelle erfordert jedoch eine ausgereiftere Ausführungsumgebung.
Experimente können Stunden dauern, Trainingsjobs Tage, und getrennte Forschungsrichtungen können unterschiedliche Rechenressourcen und Validierungsmethoden benötigen. Hyra 2.0 adressiert diese Anforderungen durch drei Agentenebenen, persistente Aufgabenplanung, strukturierte Forschungsaufzeichnungen und unabhängige Verifikation.
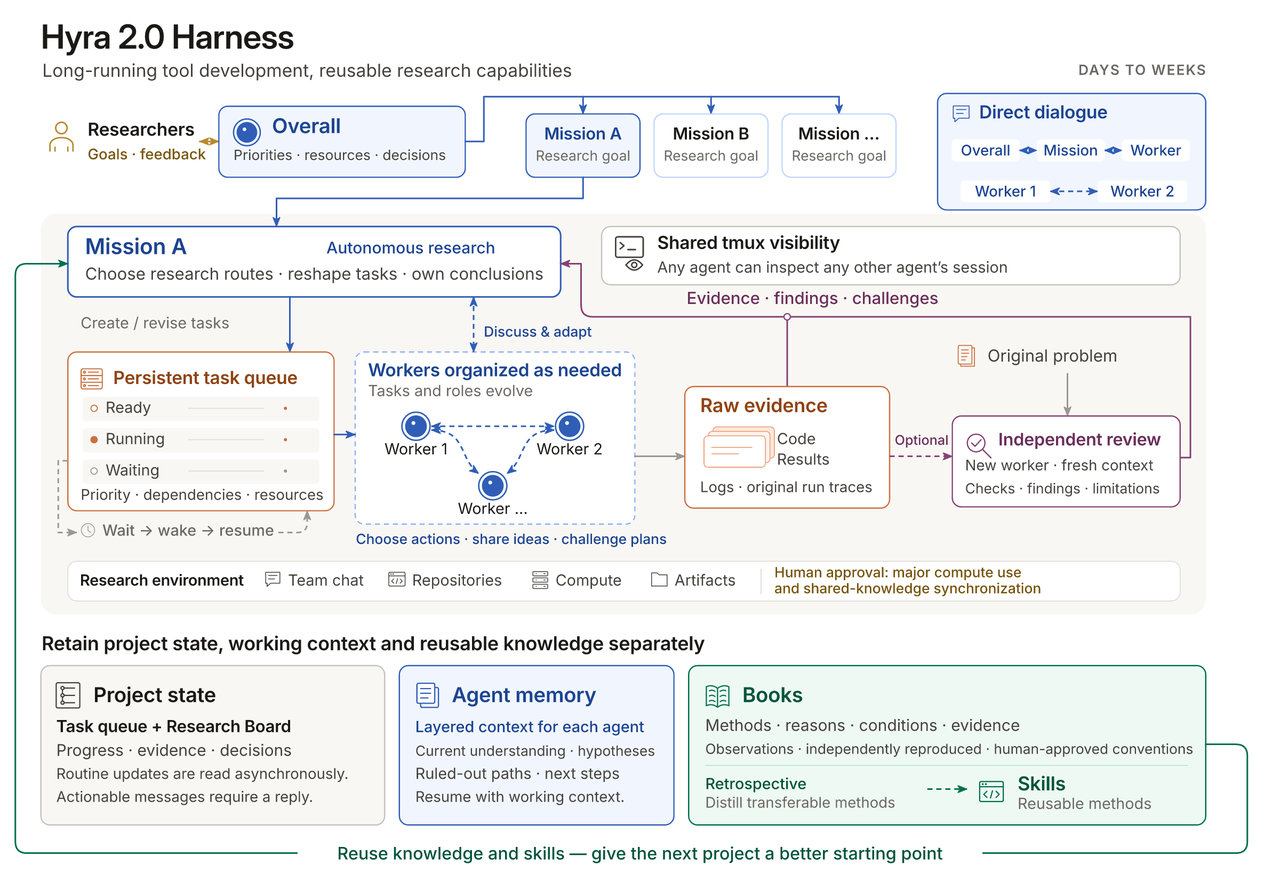
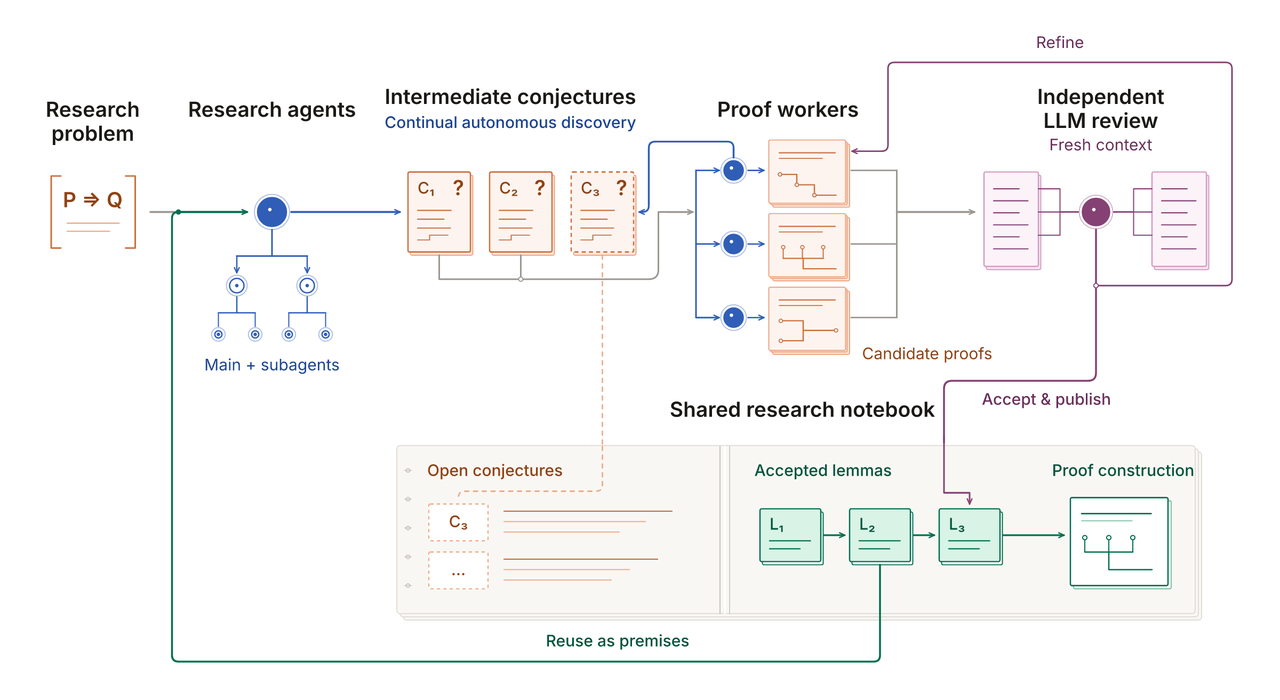
Tencent Hunyuan's official Hyra 2.0 Architekturschaubild zeigt die Hierarchie, die persistente Arbeitswarteschlange, den Review-Prozess und separate Speicher für Projektzustand, Agentenspeicher und geteiltes Wissen.
Overall: Research Coordination and Resource Management
Overall ist die höchste Koordinationsebene. Sie kommuniziert mit menschlichen Forschenden, hält die Ausrichtung an Forschungszielen aufrecht, verwaltet Prioritäten und koordiniert Rechenressourcen.
Zu ihren Aufgaben gehört zu entscheiden, welche Projekte zusätzliche Ressourcen erhalten sollten, und Entscheidungen zu identifizieren, die menschliche Freigabe erfordern. Overall fungiert damit als Koordinationsschicht zwischen autonomen Forschungsaktivitäten und menschlichem Forschungsmanagement.
Mission: Long-Term Research Planning
Jede Mission ist für ein bestimmtes Forschungsproblem verantwortlich. Eine Mission hält die Forschungsrichtung über mehrere Experimente hinweg aufrecht, organisiert Worker, interpretiert Ergebnisse und entscheidet, ob eine Hypothese weitere Untersuchung verdient.
Sie bestimmt auch, wann ein Forschungsansatz überarbeitet oder aufgegeben werden sollte. Dies schafft Kontinuität in einem lang laufenden Projekt, ohne dass eine Agentensitzung jede Zwischenaktion behalten muss.
Worker: Experiment Execution and Independent Exploration
Worker führen spezialisierte Forschungsaufgaben aus. Ihre Aufgaben umfassen das Lesen von Code, die Implementierung von Algorithmen, das Ausführen von Experimenten, das Diagnostizieren von Fehlern und das Vorschlagen alternativer Ansätze.
Worker können die Entscheidungen einer Mission in Frage stellen, und verschiedene Worker können unterschiedliche zugrunde liegende KI-Modelle nutzen. Diese Struktur unterstützt parallele Exploration und verringert die Abhängigkeit von einem einzigen Reasoning-Pfad eines Agenten.
Persistent Scheduling and Research Board
Hyra 2.0 legt Forschungsaufgaben in eine persistente Warteschlange. Der Scheduler berücksichtigt Aufgabenpriorität, Abhängigkeiten und verfügbare Ressourcen beim Starten von Workern.
Wenn ein Experiment auf Trainingsergebnisse oder menschliche Freigabe wartet, können andere Aufgaben fortgesetzt werden. Agenten können außerdem ihre nächste Aktivierung planen, nachdem ein Experiment abgeschlossen ist.
Das Research Board zeichnet Hypothesen, Erkenntnisse, Evidenz und wichtige Entscheidungen auf. Dies trennt den persistierenden Zustand des Forschungsprojekts von einzelnen Agentenkonversationen.
Independent Verification and Human Approval
Schlussfolgerungen von Workern müssen durch experimentelle Evidenz gestützt sein, z. B. Codeversionen, Ausführungslogs, Bewertungsergebnisse oder Original-Traces.
Wenn ein Ergebnis zusätzliche Prüfung erfordert, kann ein separater Review Worker das ursprüngliche Problem und die Evidenz unabhängig inspizieren. Dieser Prozess hilft, unbegründete Schlussfolgerungen und Implementierungsfehler zu identifizieren, bevor sie spätere Forschung beeinflussen.
Rechenintensive Operationen und Änderungen am gemeinsamen Teamwissen unterliegen weiterhin menschlicher Freigabe. Die Architektur verbindet somit autonome Ausführung mit expliziten Checkpoints für folgenschwere Entscheidungen.
Books: Turning Research Experience Into Skills
Hyra 2.0 trennt Informationen in drei Speicherkategorien:
Project state: Aufgabenwarteschlangen, Kollaborationsprotokolle und Forschungsfortschritt.
Agent memory: Aktueller Kenntnisstand, Hypothesen, verworfene Ansätze und Zukunftspläne.
Books: Wiederverwendbares Wissen, das über Forschungsprojekte hinweg geteilt wird.
Books kategorisiert Informationen in Beobachtungen, verifizierte Erkenntnisse und Konventionen. Ein einzelnes Experiment kann eine Beobachtung liefern. Unabhängig reproduzierte Erkenntnisse können zu verifiziertem Wissen werden. Konventionen, die das Teamverhalten beeinflussen, erfordern menschliche Bestätigung.
In Projekt-Reviews können wiederverwendbare Methoden in Fähigkeiten umgewandelt werden. Ein erfolgreiches numerisches Verifikationsverfahren oder eine Methode zur Diagnose von Trainingsinstabilitäten kann zu einer wiederverwendbaren Komponente zukünftiger Forschungs-Workflows werden.
Dieser Mechanismus ermöglicht es dem System, operative Verbesserungen über einzelne Sitzungen hinaus zu bewahren.
What Research Results Has Hyra 2.0 Achieved?
Die ersten Ergebnisse von Hyra 2.0 umfassen wissenschaftliche Modelle, mathematische Forschung, Quantencomputing, Robotik, Einzelzellanalyse und Hardware-Engineering.
Das offizielle Forschungsrepository enthält ausgewählte Implementierungen, Gewichte, Berichte und Verifikationsartefakte. Die folgende Übersicht fasst Tencents gemeldete Ergebnisse zusammen; die anschließenden Unterabschnitte erläutern ihre Testbedingungen und Verfügbarkeit. Dies sind unterschiedliche wissenschaftliche Aufgaben, keine Einzelrangliste einer allgemeingültigen Agentenfähigkeit.
Research output
Technical scale or metric
Reported achievement
HyInv
1.96M parameters
57× schnellere Proteinsequenz-Generierung als ProteinMPNN
HyPLM-Flash
650M parameters; 726B training tokens
130,000 Residues/s auf einem H20; wettbewerbsfähige Qualität über 32 Aufgaben
HyFF
Five models; 2.3M–1.2B parameters
Accuracy-Speed-Paretofront gegenüber 16 öffentlichen Modellen
HyCell
16.1M parameters; 512-dimensional embeddings
Gesamtwert 0.735 über sieben zurückgehaltene Zellatlanten
HyProver
Mathematical proof workflow
Ergebnisse zu Pettys Vermutung und Yaus Kreisaktionsvermutung
HyQEC
Quantum code [[488,123,22]]
Effizienzmetrik 122.0; ca. 48% über dem bisherigen Challenge-Leader
Spiral Hand
Five-finger robotic design
28.6% schnellere Objektdrehung in DR5-Simulation
XiangShan RISC-V
SPEC CPU2006 performance
5.79% höhere Punktzahl pro GHz bei 0.3% Flächenzunahme
Diese Ergebnisse zeigen verschiedene Arten von Forschungsausgaben statt einer einzigen allgemein gültigen Agentenwertung.
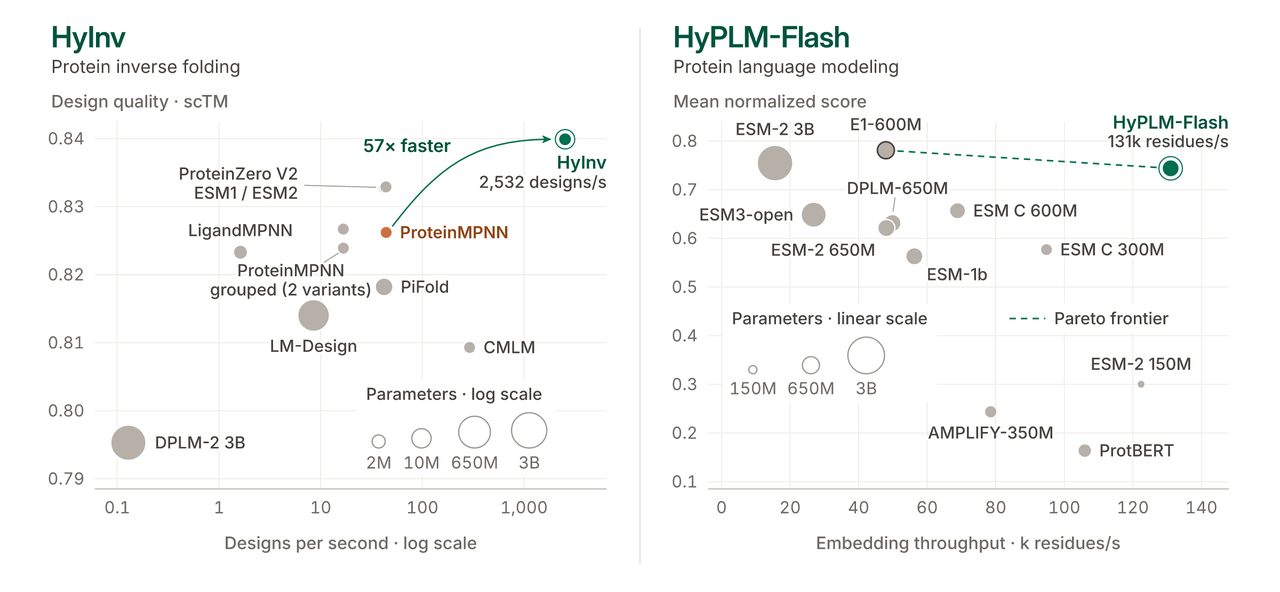
HyInv: 57× Faster Protein Inverse Folding
HyInv generiert Proteinsequenzen für ein Ziel-Backbone. Sein 1,96M-Parameter-Modell läuft Berichten zufolge 57× schneller als ProteinMPNN. Die gemeldeten 50,6 ms für 128 Designs verwenden ein 402-Residue-Backbone, einen H20 und BF16, exklusive Kompilierung und CUDA-Graph-Capture. Behandeln Sie dies als aufgewärmte Generierungsgeschwindigkeit; die strukturelle Selektion trägt weiterhin zum vollständigen Designzyklus bei.
HyPLM-Flash: High-Throughput Protein Language Modeling
HyPLM-Flash ist ein Protein-Language-Modell mit 650M Parametern, trainiert auf 726B Tokens. In der veröffentlichten Auswertung mit 28 Checkpoints und 32 Aufgaben lag seine ProteinGym-Wertung statistisch gleichauf mit vergleichbaren Encodern. INT8-Inferenz erreicht etwa 130,000 Residues/s auf einem H20; BF16 ist vorzuziehen, wenn kleine Repräsentationsunterschiede die Downstream-Analyse beeinflussen. Die unten stehende Startgrafik verwendet einen anderen Evaluationsumfang.
HyFF: Faster Molecular Simulation With Five Model Sizes
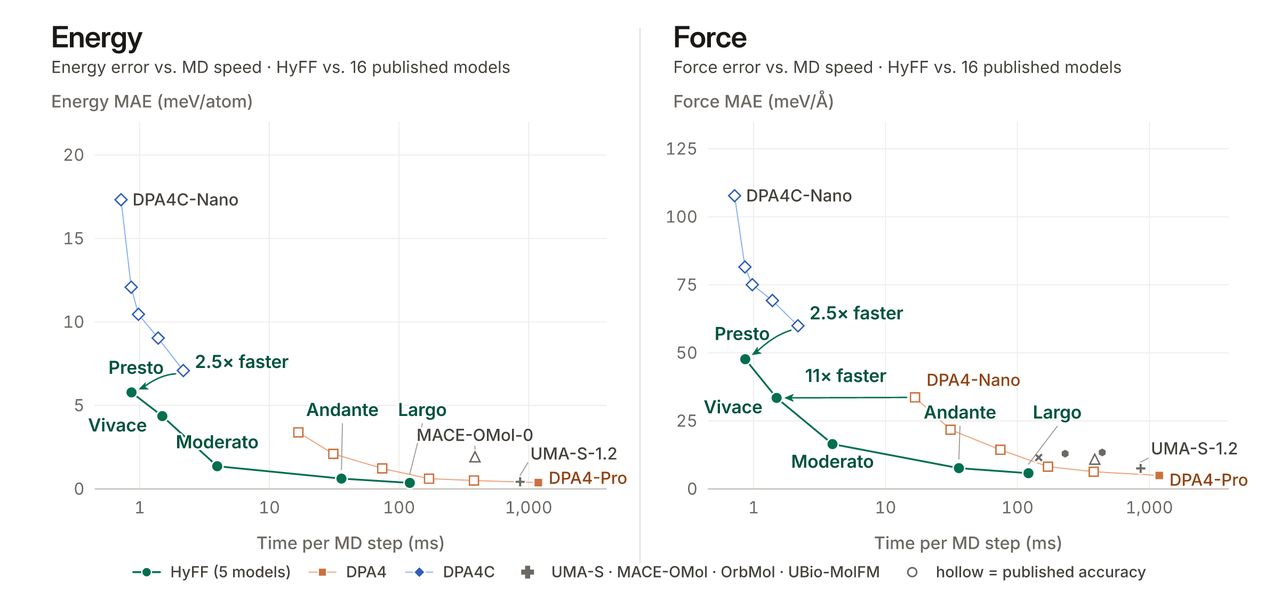
HyFF sagt molekulare Energien und atomare Kräfte voraus, mit fünf Modellgrößen von 2.3M–1.2B Parametern. In der gemeldeten OMol25-Gegenüberstellung kombiniert Andante eine ähnliche Kraftfehlergröße wie UMA-S-1.2 (7.65 gegenüber 7.55 meV/Å) mit 29× schnellerer Molekulardynamik. Largo berichtet niedrigere Energiefehler als DPA4-Pro (0.364 gegenüber 0.380 meV/Atom) und 9.7× höhere Geschwindigkeit. Wählen Sie eine Größe, indem Sie sowohl Genauigkeit als auch Laufzeit an den Molekülen testen, die Sie simulieren möchten.
HyCell: A Single-Cell Embedding Model
HyCell bildet Genexpressionszählungen menschlicher Zellen auf 512-dimensionale Embeddings mit einem 16.1M-Parameter-Modell ab. Über sieben zurückgehaltene Zellatlanten beträgt seine zusammengesetzte Punktzahl 0.735, nahe an Stacks 0.736. Diese Punktzahl kombiniert biologische Konservierung, Batch-Korrektur und Annotationstransfer; sie ist keine Klassifikationsgenauigkeit. Prüfen Sie die Teilmetriken, die für Ihre Studie relevant sind.
HyProver: Reusable Workflows for Mathematical Research
HyProver organisiert mathematische Arbeit in Exploration, Beweisentwicklung und Review. Seine gemeldeten Ergebnisse etablieren den fünfdimensionalen Fall von Pettys Vermutung über gleichseitige Mengen und liefern ein Gegenbeispiel zur uneingeschränkten Form von Yaus Kreisaktionsvermutung. Diese Ergebnisse haben spezifische Grenzen: Pettys Vermutung ist nicht in jeder Dimension geklärt, und Yaus Formulierung für einfach zusammenhängende Fälle bleibt offen.
HyQEC: A 48% Improvement in Quantum-Code Efficiency
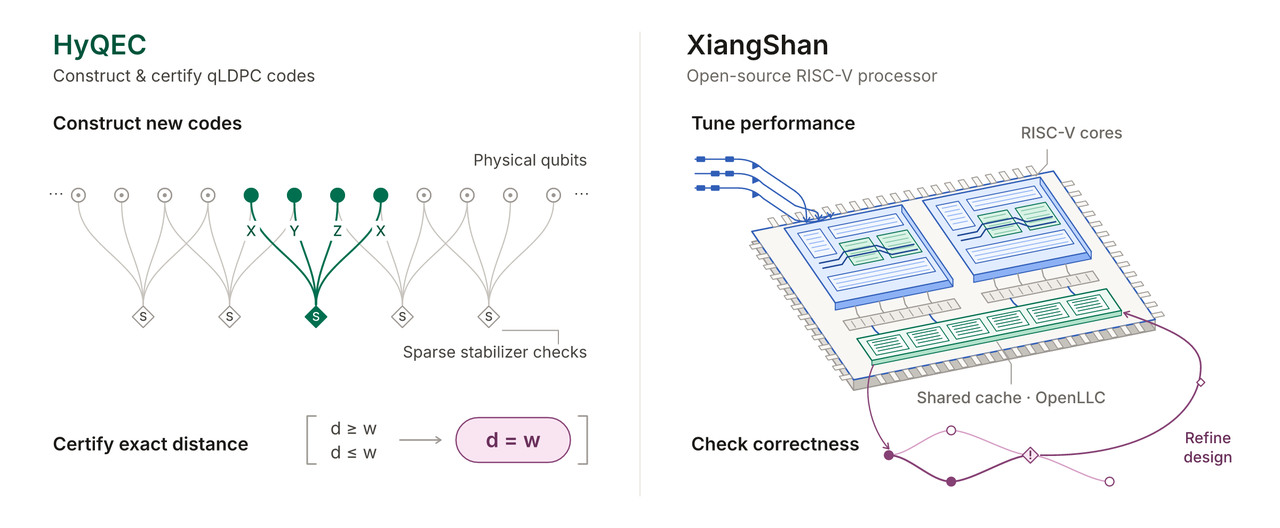
HyQEC sucht nach Quantenfehlerkorrekturcodes und prüft deren Distanzen. Tencent berichtet eine [[488,123,22]]-Konstruktion mit einer Effizienzmetrik kd²/n von 122.0, etwa 48% über dem bisherigen Challenge-Leader unter den angegebenen Einschränkungen. Dies misst die Codeeffizienz, nicht die Leistung von Quantenhardware. Mit Stand 5. November 2026 enthält die offizielle Veröffentlichung die Tools hyqec-verify und hyqec-check, listet aber weiterhin die Code-Datei und das Zertifikat dieser speziellen Konstruktion als noch zu veröffentlichende Evidenz. Öffentliche Tools und öffentlich reproduzierbare Evidenz für ein spezifisches Ergebnis sind getrennte Meilensteine.
Spiral Hand: AI-Designed Robotic Morphology
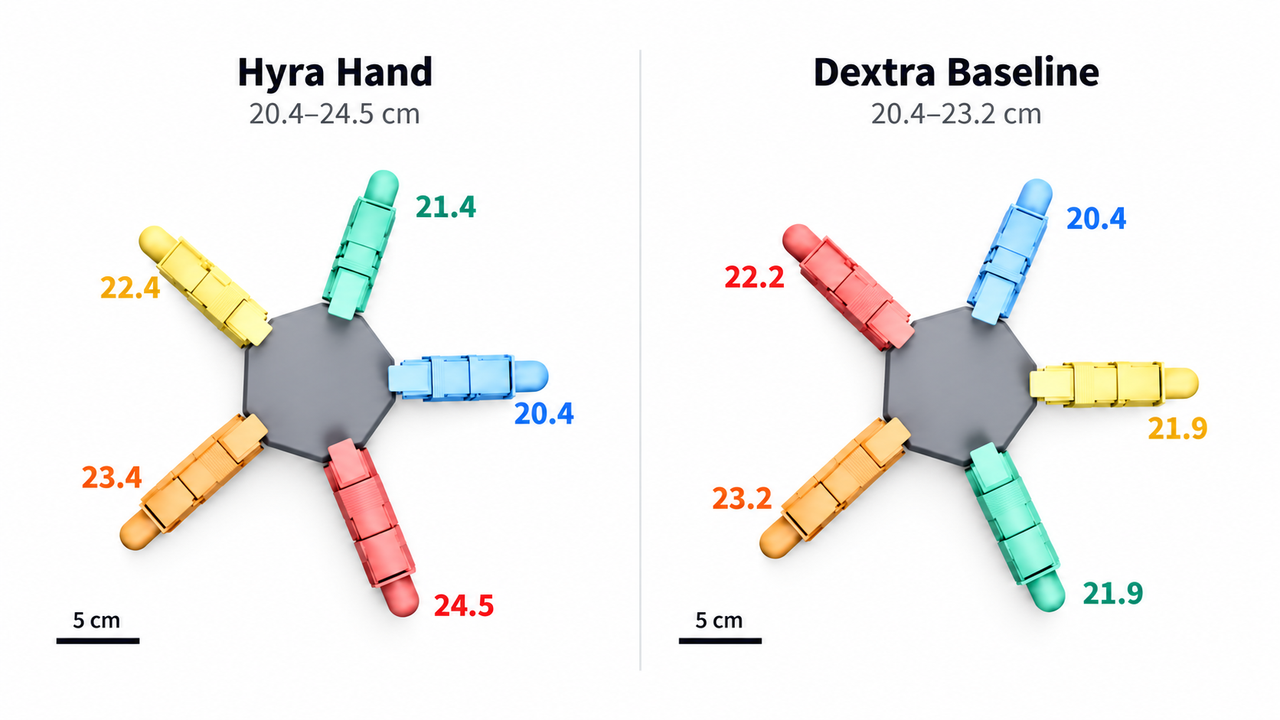
Hyra’s Spiral Staircase Hand verwendet um die Handfläche herum schrittweise längere Finger. Tencent berichtet 28.6% schnellere Objektdrehung und 21% mehr abgeschlossene Ziele als die Dextra-Baseline in der DR5-Simulation nach gleichen Policy-Fine-Tuning-Budgets. Die Validierung auf physischer Hardware steht noch aus.
XiangShan: Processor Optimization and Formal Verification
Für den XiangShan-RISC-V-Prozessor berichtet Tencent eine 5.79%ige Verbesserung der SPEC-CPU2006-Punktzahl pro GHz, unveränderte Kernfrequenz und eine 0.3%ige Flächenzunahme. Die Arbeit fand zudem zehn zuvor nicht gemeldete Bugs und ein Gegenbeispiel zur Cache-Kohärenz. Diese Ergebnisse gelten für das evaluierte Design und die Workloads, nicht für alle RISC-V-Systeme.
How Should Researchers Interpret Hyra 2.0's Benchmarks?
Lesen Sie jeden Benchmark im Kontext seines eigenen Workloads. Vergleichen Sie die gleichen Eingaben, Hardware, Präzision und den Timing-Rahmen und bewerten Sie dann die Ausgabequalität zusammen mit der Laufzeit. Bei wissenschaftlichen Aussagen sollten unterstützender Code, Daten, Beweis oder Zertifikat geprüft werden: Ein gemeldetes Ergebnis und ein unabhängig reproduziertes Ergebnis bieten unterschiedliche Evidenzniveaus.
Can Developers Use Hyra 2.0 Through an API?
Mit Stand 4. November 2026 beschreiben die öffentlichen Hyra-Materialien Forschungsergebnisse und ausgewählte Releases. Sie dokumentieren keine allgemein verfügbare Hyra-2.0-Orchestrierungs-API, keinen Abonnementpreis oder ein vollständiges Deployment-Paket. Eine Forschungsankündigung und herunterladbare Artefakte sollten daher von einem gehosteten Zugang zum vollständigen System unterschieden werden.
Die öffentlich verfügbaren Materialien konzentrieren sich auf Forschungsergebnisse und ausgewählte Artefakte. Entwickler können auf bestimmte durch Hyra erstellte Modelle, einschließlich HyInv, HyPLM-Flash, HyFF und HyCell, über die zugehörigen Forschungsrepositorien zugreifen.
Das vollständige Hyra-2.0-Harness ist von diesen herunterladbaren Outputs zu unterscheiden.
Hyra 2.0 and Hosted Hunyuan APIs
Entwickler können auf Tencent Hy4 über CometAPI mit der Modell-ID hy4 zugreifen. Dies bietet gehostete Modellinferenz für Anwendungen wie Coding, Analyse und Agent-Workflows. Es liefert nicht das vollständige Hyra-2.0-Forschungs-Harness; wissenschaftliche Modelle, die mit Hyra entwickelt wurden, sind separat über Tencents Forschungsrepositorien verfügbar.
What Would Make Hyra 2.0 Useful in a Research Team?
Beginnen Sie mit einem veröffentlichten Artefakt und einem kleinen Referenz-Workload. Sobald das erfolgreich läuft, testen Sie repräsentative lokale Daten mit einem festen Qualitätskriterium und Budget für Rechenressourcen. Halten Sie Repository-Revision, Gewichte, Umgebung, Eingaben und Ausgaben zusammen, damit Kolleginnen und Kollegen das Ergebnis reproduzieren können. Fügen Sie persistente Multi-Agent-Koordination hinzu, wenn lange Wartezeiten, abhängige Experimente oder konkurrierende Hypothesen dies sinnvoll machen.
Conclusion
Hyra 2.0 führt Forschungsplanung, Experimentdurchführung und wiederverwendbares Wissen in einen persistenten Workflow zusammen. Seine wissenschaftlichen Outputs sind vielversprechende Ausgangspunkte für weitere Arbeiten. Für ein Forschungsteam ist der praktische Test, ob ein veröffentlichtes Artefakt ein reales Experiment verbessert und Evidenz produziert, die andere prüfen und reproduzieren können.
FAQ
How should a lab budget its first Hyra artifact trial?
Budgetieren Sie drei Phasen: das Einrichten einer reproduzierbaren Umgebung, das Durchführen eines kleinen Referenzfalls und die Auswertung eines repräsentativen lokalen Workloads. Berücksichtigen Sie Vorbereitungs- und Review-Zeit sowie den Einsatz von Beschleunigern. Wählen Sie vorab ein Akzeptanzkriterium, etwa das Halten eines geforderten Qualitätsniveaus bei gleichzeitig kürzerer Durchlaufzeit. Ein erster Versuch sollte klein genug sein, um Fehler zu diagnostizieren, ohne die Ressourcen eines vollständigen Forschungsvorhabens zu binden.
What should a reproducibility package contain?
Halten Sie Repository-Revision, Modellgewichts-IDs, Versionsstände der Umgebung, Herkunft der Eingabedaten, Konfiguration, Zufallssaaten (wo relevant) und Ausgaben der Evaluation zusammen. Protokollieren Sie jede Abweichung vom veröffentlichten Beispiel. Wenn ein Ergebnis auf einem Beweis oder Zertifikat beruht, bewahren Sie die Version des Prüfers und dessen Ausgabe ebenfalls auf. Das Paket sollte einer anderen Forscherin bzw. einem anderen Forscher erlauben, ein Softwareproblem, einen geänderten Input und einen echten Unterschied im wissenschaftlichen Ergebnis zu unterscheiden.
How can researchers avoid benchmark contamination?
Trennen Sie Daten, die zur Modellauswahl oder zum Tuning genutzt wurden, von den Daten für die finale Evaluation. Frieren Sie das finale Protokoll ein, bevor Sie Kandidaten vergleichen, und dokumentieren Sie jede Überschneidung mit Pretraining- oder Entwicklungsdaten, die feststellbar ist. Bei neuen wissenschaftlichen Datensätzen verwenden Sie Splits, die der vorgesehenen Einsatzumgebung entsprechen, beispielsweise eine zurückgehaltene Studie oder Experimentbedingung. Eine hohe Punktzahl ist weniger aussagekräftig, wenn die Evaluationsbeispiele wiederholt das getestete System geprägt haben.
How should teams handle conflicting agent conclusions?
Vergleichen Sie die zugrunde liegenden Experimente statt die Schlussfolgerungen per Mehrheitsvotum zu kombinieren. Prüfen Sie, ob die Agenten dieselbe Datensatzversion, Annahmen, Metrik und Softwarekonfiguration verwendet haben. Bewahren Sie beide Befunde, bis der Unterschied erklärt ist, und führen Sie dann ein fokussiertes Experiment durch, das zwischen den konkurrierenden Erklärungen unterscheidet. Übereinstimmung zwischen Agenten ist nützlich, ersetzt aber weder externe Messungen noch ein überprüfbares Argument.
When is a simpler research workflow preferable?
Eine kurze, deterministische Aufgabe mit einem ausgereiften Skript und einem klaren Evaluator profitiert möglicherweise nicht von persistenter Multi-Agent-Koordination. Die zusätzliche Planung, Protokollierung und der Review können mehr kosten als sie einbringen. Führen Sie Orchestrierung ein, wenn Experimente bedeutsame Abhängigkeiten, lange Wartezeiten, mehrere konkurrierende Hypothesen oder wiederverwendbare Outputs mit laufendem Pflegebedarf haben. Die Entscheidung sollte der Struktur des Workloads und den beobachteten Koordinationskosten folgen.