Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Was ist MiMo-V2.5? Spezifikationen, Benchmarks, Funktionen, Preise und API-Zugriff
Erkunden Sie Spezifikationen, Architektur, offizielle Benchmarks, Preisgestaltung, den Vergleich mit MiMo-V2.5-Pro, Anwendungsfälle, Einschränkungen und den Zugriff auf die CometAPI von Xiaomi MiMo-V2.5.
Xiaomis Standardmodell V2.5 vereint natives Verständnis für Text, Bild, Video und Audio mit einem Kontextfenster von 1 Million Tokens, Tool-Nutzung und der Effizienz einer sparsamen Mixture-of-Experts. Es ist die bessere Wahl, wenn multimodale Eingaben und die Kosten pro erledigter Aufgabe zählen. Die Pro-Variante ist größer und stärker bei anspruchsvollem Codieren und langhorizontigen Agentenarbeiten, ist jedoch auf Texteingaben fokussiert und kostet laut Xiaomis veröffentlichten Tarifen pro Token etwa das Dreifache.
Die praktische Entscheidung ist einfach: Wählen Sie das Standardmodell für multimodale Agenten, Dokument- und Medienanalyse sowie hochvolumige Automatisierung; wählen Sie Pro, wenn schwierige Softwareentwicklung oder anhaltende autonome Ausführung der Engpass ist.
Key Takeaways
Das Standardmodell nutzt 310B Gesamtparameter und aktiviert 15B pro Token.
Es akzeptiert Text, Bilder, Videos und Audio und liefert Text zurück.
Die API unterstützt 1M Kontext, bis zu 128K Ausgabe, Tool-Aufrufe, Websuche, Streaming, strukturierte Ausgaben und Kontext-Caching.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
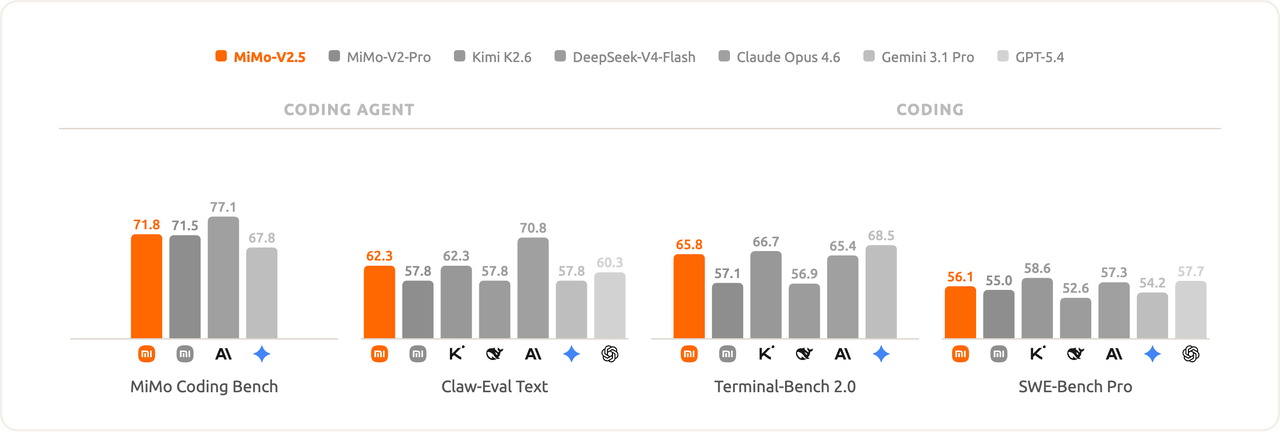
Vom Publisher gemeldete Ergebnisse umfassen 65.8 auf Terminal-Bench 2.0 und 56.1 auf SWE-Bench Pro.
Xiaomis aktueller Model Card für MiMo-V2.5-Pro listet 1.02T Gesamt- und 42B aktive Parameter. Die vom Publisher gelisteten SWE-Bench-Pro-Werte sind 56.1 für MiMo-V2.5 und 57.2 für Pro; dies sind datierte, publisher-gemeldete Vergleiche, keine Garantie für einen spezifischen Coding-Workflow.
Zu den aktuellen Xiaomi-Tarifen kosten Standard-Eingabe/-Ausgabe $0.14/$0.28 pro Million Tokens; Pro kostet $0.435/$0.87.
Beide APIs in der CometAPI sind 20% unter dem offiziellen ungecachten Preispaar bepreist.
Information geprüft: 28. September 2026. Preise, Benchmarks, Limits, Verfügbarkeit und Request-Formate können sich ändern. Xiaomi hat angekündigt, dass die offiziellen API-Modellnamen mimo-v2.5 und mimo-v2.5-pro am 21. Oktober 2026 um 10:00 Pekinger Zeit deprecaten werden, ohne automatische Ersatzbereitstellung. Planen Sie die Migration und verifizieren Sie vor dem Deployment die Live-Route.
API-Lifecycle-Hinweis: Die offizielle Xiaomi-Plattform plant, beide V2.5-Modell-IDs am 21. Oktober 2026 außer Betrieb zu nehmen. Dieser Hinweis betrifft Xiaomis API-Plattform; prüfen Sie etwaige Drittanbieter-Gateways separat. Xiaomi Modell-Abkündigungsmitteilung
What the Standard Model Is
MiMo-V2.5 ist Xiaomis MiMo-Foundation-Modell, optimiert auf Effizienz für multimodale Wahrnehmung und agentische Arbeit. Es bietet native Text-, Bild-, Video- und Audioeingabe innerhalb einer Architektur und erzeugt Textausgaben.
Xiaomis Modell-Veröffentlichungslog datiert die öffentliche Beta der MiMo-V2.5-Serie auf den 23. April 2026. Die Gewichte wurden anschließend unter der MIT-Lizenz veröffentlicht. MiMo-V2.5 hat 310B Parameter insgesamt, aktiviert jedoch nur etwa 15B pro Token; es nutzt einen großen Pool an Spezialisten, ohne alle gleichzeitig auszuführen.
MiMo-V2.5-Pro zielt auf einen anderen Workload. Es ist ein Billionen-Parameter-, Texteingabe-Modell, entworfen für die härtesten Coding-, Terminal- und langlaufenden Agentenaufgaben. Beide Varianten teilen ein maximales Kontextfenster von 1M, unterscheiden sich jedoch stark in Modalität, aktiver Rechenleistung und Preis.
MiMo-V2.5 Specifications and Features
Offizielle Architekturdaten
Wert
Warum es wichtig ist
Architektur
Sparse MoE
Große Expertenkapazität mit selektiver Aktivierung
Gesamt-/aktive Parameter
310B / 15B
Aktive Rechenleistung liegt weit unter der Gesamtkapazität
Transformer-Ebenen
48: 1 dicht + 47 MoE
Die meisten Ebenen verwenden geroutete Experten
Geroutete Experten
256; 8 aktiv pro Token
Spezialisierung ohne dichte 310B-Ausführung
Attention
39 SWA + 9 globale Ebenen
Balanciert lokale Effizienz und Langstreckenfluss
SWA-Fenster
128 Tokens
Reduziert den KV-Cache-Druck bei langem Kontext
Kontext / maximale Ausgabe
1M / 128K Tokens
Unterstützt lange Dokumente und ausgedehnte Traces
Eingabe / Ausgabe
Text, Bild, Video, Audio / Text
Native Wahrnehmung über vier Eingabetypen
Vision-Encoder
729M ViT; 28 Ebenen
Bild- und Videoverständnis
Audio-Encoder
261M Transformer; 24 Ebenen
Natives Audioverständnis
Multi-Token Prediction
3 Module; etwa 329M Parameter
Unterstützt Effizienz durch spekulative Dekodierung
Der Betriebsrahmen umfasst 1M Kontext und 128K Ausgabe sowie veröffentlichte Limits von 100 Requests pro Minute und 10 Millionen Tokens pro Minute. Provider-spezifische Limits können je nach Konto und Integrationsroute variieren.
Sparse Experts: Gesamtkapazität ist nicht aktive Rechenleistung
Die zentrale Effizienzfakt ist das Design mit 310B gesamt und 15B aktiv. Der Router wählt acht von 256 Experten für jedes Token. Das gibt dem Modell Zugang zu einem viel größeren Parameterpool als ein konventionelles 15B dichtes Modell, ohne jedes Mal alle 310B Parameter auszuführen.
Das macht Self-Hosting nicht trivial. Die vollständigen Gewichte müssen weiterhin gespeichert und verteilt werden, daher bleiben Speicherkapazität, Interconnect-Bandbreite, Expertenrouting und Serving-Software wesentliche Einschränkungen.
Hybride Attention für langen Kontext
Das Backbone verschachtelt Sliding-Window- und globale Attention in einem 5:1-Verhältnis von SWA zu global. Neununddreißig lokale Ebenen kontrollieren das Cache-Wachstum, während neun globale Ebenen den Langstreckeninformationsfluss erhalten. Xiaomi berichtet von einer nahezu sechsfachen KV-Cache-Reduktion gegenüber einem vollständig globalen Design.
Ein Maximum von 1M Tokens ist Kapazität, keine garantierte Genauigkeit. Retrieval-Qualität, Latenz, Wachstum des Tool-Zustands und Aufmerksamkeit über entfernte Evidenz erfordern weiterhin eine workload-spezifische Evaluation.
Native Encoder und Agentenfunktionen
Ein Vision-Transformer mit 729M Parametern verarbeitet Bild- und Videoeingaben; ein Audio-Transformer mit 261M Parametern verarbeitet Audio. Die Projektoren bringen beide Ströme in das Sprach-Backbone ein, sodass ein Agent einen Screenshot, ein Videosegment, eine Audiospur, Textanweisungen und Tool-Ergebnisse kombinieren kann.
Drei Multi-Token-Prediction-Module unterstützen Effizienz bei spekulativer Dekodierung und Reinforcement Learning. Das Modell wurde auf etwa 48T Tokens trainiert, wobei der Kontext während des Post-Trainings schrittweise auf 1M erweitert wurde.
Die offenen Gewichte verwenden eine MIT-Lizenz. Kommerzielle Bereitstellung ist erlaubt, jedoch erfordern Infrastrukturkosten und Abhängigkeiten Dritter weiterhin eine separate Prüfung.
MiMo-V2.5 Benchmarks: Coding, Agenten und Multimodale Ergebnisse
Benchmark-Hinweis:
die folgenden Zahlen sind vom Publisher gemeldet. Sie sind Richtwerte, keine Garantie für ein spezifisches Repository, Medienformat, Tool-Stack, Latenzziel oder Safety-Policy.
Coding- und Agenten-Ergebnisse
Offizielles Benchmark-Diagramm für Coding und Agenten von Xiaomi MiMo.
Offizieller Coding-Benchmark
Gemeldeter Score
Entscheidungssignal
MiMo Coding Bench
71.8
Breite Coding-Agenten-Fähigkeit
Claw-Eval Text
62.3
Allgemeine Text-Agenten-Abschlüsse
Terminal-Bench 2.0
65.8
Interaktive Terminalausführung
SWE-Bench Pro
56.1
Real-World Software Engineering
Claw-Eval Multi-Turn
63.2
Längere mehrstufige Agentenarbeit
ResearchClawBench
16.91
Autonome Research-Workflows
Ergebnis: Der stärkste Fall ist die praktische Tool-Nutzung statt isolierter Code-Vervollständigung. Ein 65.8-Resultat auf Terminal-Bench stützt terminalorientierte Agenten, während 56.1 auf SWE-Bench Pro nützliche Repository-Fähigkeit nahelegt. Der deutlich niedrigere Research-Score erinnert daran, Evidenzsuche und Zitationsverhalten separat zu testen.
Multimodale Ergebnisse
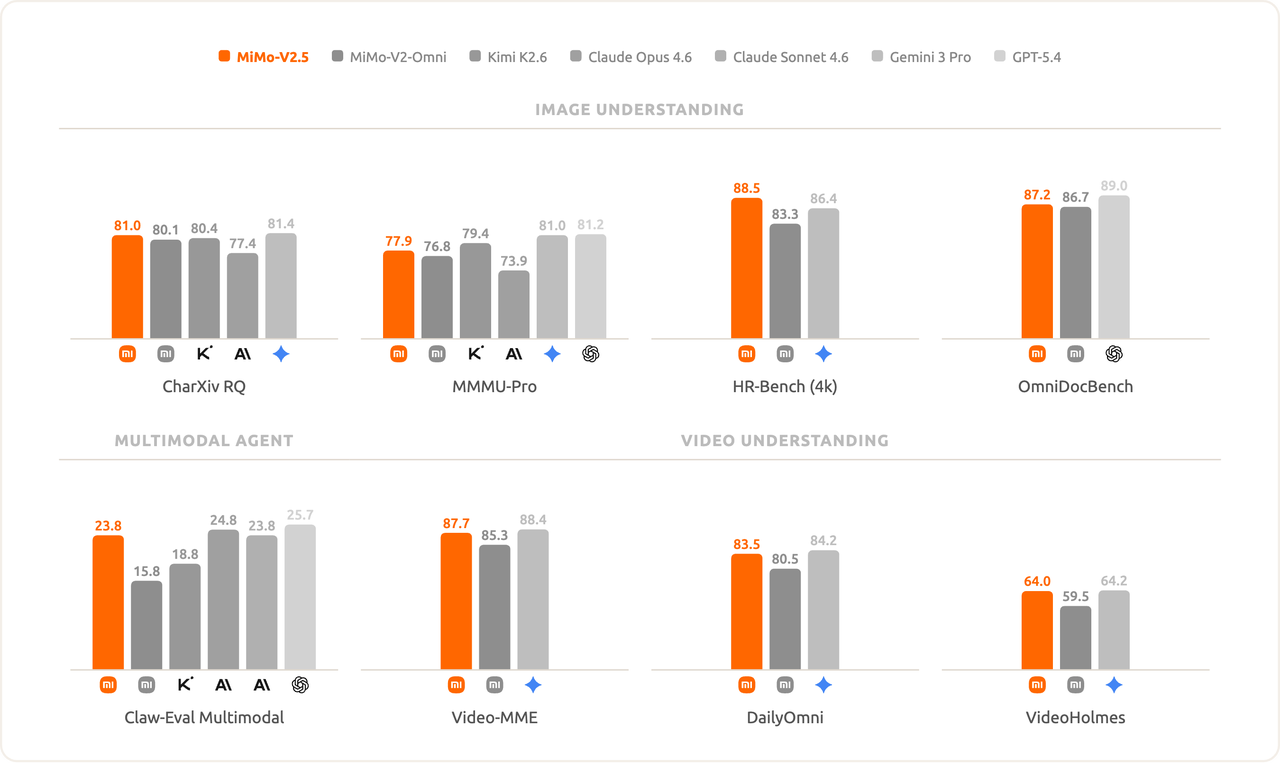
Offizielles Benchmark-Diagramm für Bild, Video und multimodale Agenten von Xiaomi MiMo.
Offizieller Multimodal-Benchmark
Gemeldeter Score
Getestete Fähigkeit
CharXiv RQ
81.0
Diagramm- und Dokumenten-Reasoning
MMMU-Pro
77.9
Expertenniveau im multimodalen Reasoning
HR-Bench 4K
88.5
Hochauflösendes Bildverständnis
OmniDocBench
87.2
Dokumentenverständnis
Claw-Eval Multimodal
23.8
Multimodaler Agentenabschluss
Video-MME
87.7
Videoverständnis
DailyOmni
83.5
Alltägliches audiovisuelles Reasoning
VideoHolmes
64.0
Temporales Video-Reasoning
Ergebnis: Dokument-, High-Resolution-Bild- und Videoverständnis sind die klarsten Stärken. Der 23.8-Multimodal-Agenten-Score liegt deutlich unter den Wahrnehmungsscores, daher sollte ein System, das sowohl Medien versteht als auch zuverlässig Tools bedient, Ende-zu-Ende evaluiert werden.
MiMo-V2.5 vs MiMo-V2.5-Pro: Multi-Dimensionale Gegenüberstellung
Beide listen bis zu 1M Tokens; testen Sie Retrieval und Latenz bei Ihrer Workload-Größe
Offizielles API-Maximum Ausgabe
128K
128K
Beide aktuellen Xiaomi-API-Modellseiten listen 128K; provider-spezifische Limits können variieren
Native Eingabe
Text, Bild, Video, Audio
Text
MiMo-V2.5 ist die dokumentierte multimodale Wahl; verifizieren Sie den genauen Pro-Endpunkt vor dem Senden von Medien
SWE-Bench Pro
56.1
57.2
Pro führt mit 1.1 Punkten
Terminal-Bench 2.0
65.8
68.4
Pro führt mit 2.6 Punkten
Primärer Fit
Effiziente multimodale Agenten
Komplexes Coding und langhorizontige Agenten
Wählen Sie anhand getesteter Workloads; die Modell-Level-Margen beweisen keinen generellen Qualitätsvorsprung
Ergebnis des Vergleichs: Pro liegt auf den zwei gemeinsamen Coding-Agenten-Tests nur moderat vorne, während die Standardvariante native Bild-, Video- und Audioeingabe bietet und deutlich weniger aktive Parameter nutzt. Pro ist gerechtfertigt, wenn kleine Zugewinne bei harten Aufgaben mehr wert sind als multimodale Eingabe und geringere Stückkosten.
How Much Do MiMo-V2.5 and MiMo-V2.5-Pro Cost?
Preisstand: 27. Mai 2026
Offizielle Standard-API
Offizielle Pro-API
MiMo-V2.5 API in CometAPI
MiMo-V2.5-Pro API in CometAPI
Eingabe, Cache-Miss / MTok
$0.14
$0.435
$0.112
$0.348
Ausgabe / MTok
$0.28
$0.87
$0.224
$0.696
Eingabe, Cache-Hit / MTok
$0.0028
$0.0036
Live-Billing prüfen
Live-Billing prüfen
Rabatt vs offizieller ungecachter Satz
Baseline
Baseline
20%
20%
Zu offiziellen Raten kostet Pro für ungecachte Ein- und Ausgaben etwa 3.1× so viel wie Standard. Die oben gezeigten Providerpreise reduzieren jedes ungecachte Paar um 20%, aber die relative Lücke zwischen den Varianten bleibt im Wesentlichen unverändert.
Der Preis pro Token ist nicht die Gesamtkosten. Tool-Retries, Kontextgröße, Ausgabelänge, Latenz, Wiederherstellung fehlgeschlagener Aufgaben und menschliche Prüfung bestimmen die Kosten pro abgeschlossener Aufgabe. Führen Sie eine repräsentative Workload-Stichprobe aus, bevor Sie ein Standard-Produktionsmodell wählen.
What Is MiMo-V2.5 Best For?
Multimodale Agenten: kombinieren Sie Screenshots, Dokumente, Video, Audio, Anweisungen und Tools in einem Workflow.
Langdokument-Analyse: verarbeiten Sie Repositories, Verträge, Forschungsarchive, Logs und Support-Historien.
Medienverständnis: fassen Sie Videos zusammen, extrahieren Sie Ereignisse, interpretieren Sie Diagramme und beantworten Sie audiovisuelle Fragen.
Coding- und Terminal-Agenten: inspizieren Sie Dateien, führen Sie Befehle aus, ändern Sie Code und iterieren Sie anhand von Testergebnissen.
Hochvolumige Automatisierung: nutzen Sie spärliche Aktivierung und niedrigere Token-Preise für wiederholte Produktionsaufgaben.
Limitations and Risks
Pro Token sind nur 15B Parameter aktiv, aber Self-Hosting erfordert dennoch das vollständige 310B-Gewichtssystem.
Multimodale Ausgabe ist Text; Bild-, Sprach- und Videogenerierung erfordert andere Modelle.
Ein 1M-Kontextlimit garantiert keine gleichmäßige Retrieval-Genauigkeit über das gesamte Fenster.
Publisher-Benchmarks übertragen sich möglicherweise nicht auf individuelle Tools, Repositories, Prompts oder Safety-Vorgaben.
Die Modalitätsexponierung des Providers kann sich von den vollen Fähigkeiten des zugrunde liegenden Open-Weight-Modells unterscheiden.
Produktions-Gate:
validieren Sie Genauigkeit, Tool-Call-Abschluss, Latenz, Token-Verbrauch, Modalitätshandling und Fallback-Verhalten an repräsentativen Aufgaben, bevor Sie Traffic committen.
API Example
Der folgende Python-Beispielcode verwendet einen OpenAI-kompatiblen CometAPI-Endpunkt und die Standardmodell-ID. Bestätigen Sie den aktuellen Endpunkt und das unterstützte Request-Schema vor dem Deployment.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    max_retries=0,
)

response = client.chat.completions.create(
    model="mimo-v2.5",
    max_tokens=256,
    messages=[
        {
            "role": "user",
            "content": "Summarize the main findings in this technical report.",
        }
    ],
)

print(response.choices[0].message.content)
Decision Guide
Workload-Signal
Start mit
Wechsel, wenn
Bilder, Video oder Audio sind zentrale Inputs
Standard
Nicht wechseln, es sei denn, multimodale Vorverarbeitung ist akzeptabel
Großes Dokument- oder Mixed-Media-Volumen
Standard
Pro nur, wenn Reasoning-Fehler die Kosten dominieren
Schwierige Repository-Entwicklung
Beide testen
Pro wählen, wenn der Completion-Gewinn den 3.1×-Preisaufschlag kompensiert
Lange autonome Terminal-Trajektorien
Pro
Zum Standard zurückkehren, wenn Zugewinne nicht messbar sind
Hochvolumige Routineautomatisierung
Standard
Nur fehlgeschlagene oder hochwertige Aufgaben eskalieren
Empfohlenes Routing:
verwenden Sie Standard als Default für multimodale und hochvolumige Arbeit, und routen Sie nur schwierige, text-first Coding- oder langhorizontige Aufgaben zu Pro. So bewahren Sie die Fähigkeit und kontrollieren gleichzeitig die Gesamtkosten.
Conclusion
Das Standardmodell ist nicht einfach ein kleineres Pro. Es ist ein eigener Optimierungspunkt: native multimodale Eingabe, 1M Kontext, starke toolorientierte Benchmarks und 15B aktive Parameter zu einem deutlich niedrigeren Tokenpreis.
Pro ist die Spezialistenoption für schwierige Softwareentwicklung und anhaltende autonome Ausführung. Seine zusätzliche Kapazität erzeugt messbare, aber nicht universelle Zugewinne, daher ist das stärkste Deployment-Muster ein workloadbasiertes Routing, statt eine einzige Variante für jede Anfrage zu wählen.
FAQ
Ist das Standardmodell Open Source?
Seine Gewichte werden unter der MIT-Lizenz veröffentlicht, die kommerzielle Nutzung, Modifikation, Feintuning und Weiterverbreitung gemäß den Lizenzbedingungen erlaubt.
Wie viele Parameter nutzt es?
Das Sparse-MoE enthält 310B Gesamtparameter und aktiviert 15B pro Token. Aktive Parameter beschreiben die pro Token ausgeführte Berechnung, nicht die Speichergröße des vollständigen Modells.
Unterstützt es Bilder, Video und Audio?
Ja. Die Standardvariante akzeptiert Text, Bilder, Video und Audio und liefert Text. Die offizielle Spezifikation der Pro-Variante listet Texteingabe.
Wie groß ist das maximale Kontextfenster?
Beide Model Cards geben ein Kontextfenster von bis zu 1M Tokens an. Xiaomis aktuelle API-Seiten listen ein Maximum von 128K Ausgabe für MiMo-V2.5 und MiMo-V2.5-Pro. Tatsächlich nutzbare Limits können je nach Endpunkt, Provider, Konto und Request-Format variieren; verifizieren Sie die eingesetzte Route, bevor Sie sich auf diese Obergrenzen verlassen.
Die aktuelle offizielle Pro-API-Seite bestätigt separat den 1M-Kontext und 128K maximale Ausgabe: MiMo-V2.5-Pro API specifications
Welche Variante ist besser für Coding-Agenten?
Pro meldet höhere Ergebnisse bei gemeinsamen Coding- und Terminal-Benchmarks, aber die Marge ist moderat. Testen Sie beide im Ziel-Repository und wählen Sie anhand von Task-Abschluss, Latenz und Gesamtkosten.
Welche Variante ist besser für multimodale Agenten?
Die Standardvariante ist die natürliche Wahl, da sie native Bild-, Video- und Audioeingaben unterstützt. Pro ist auf Texteingaben fokussiert.
Wie sollte ein Produktionsteam wählen?
Starten Sie mit Standard, messen Sie Fehlschläge und routen Sie nur die schwierigen Text-First-Aufgaben, die von Pro profitieren. Vergleichen Sie die Kosten pro abgeschlossener Aufgabe statt nur den Preis pro Token.