
TL;DR
Die OpenAI Decisions API ist ein spezialisierter Endpunkt, der Text und Bilder in umsetzbare, maschinenlesbare Entscheidungen statt in generierte Prosa verwandelt. Sie verwendet GPT-6 Luna und unterstützt die Fragetypen predicate, choice und score. OpenAI berichtet für unterstützte Entscheidungsaufgaben von einer etwa 10× schnelleren Performance als die Responses API sowie von einem Standard-Eingabepreis von $0.10 pro einer Million Tokens.
Key Takeaways
- Zweckgebundene Entscheidungen: vordefinierte Fragen statt freier Konversation.
- Drei Entscheidungstypen: predicate, choice und score.
- Wahrscheinlichkeitsbewusste Automatisierung: mehrdeutige oder folgenschwere Eingaben an eine manuelle Prüfung weiterleiten.
- Vom Anbieter gemeldete Geschwindigkeitsgewinne und ein reines Eingabe-Standardpricing von $0.10 pro einer Million Tokens machen den Endpunkt für Entscheidungen in hohem Volumen relevant.
- Am besten geeignet für Routing, Klassifikation, visuelle Prüfungen und Entscheidungs-Gates von KI-Agenten.
What Is the OpenAI Decisions API?
Die OpenAI Decisions API bewertet Informationen und liefert begrenzte, maschinenlesbare Entscheidungen zurück. OpenAI veröffentlichte sie am 6. Oktober 2026 als Beta. Dieser Leitfaden richtet sich an Entwickler, die mit API-Schlüsseln und JSON vertraut sind und Klassifikations- oder Routing-Workflows evaluieren möchten. Produktdetails wurden am 12. Oktober 2026 geprüft.
Das Anfrageschema POST /v1/decisions akzeptiert ein Modell, gemeinsame Text- oder Bildeingaben und vom Entwickler definierte Fragen. Der dedizierte Endpunkt liefert typisierte Urteile statt erklärender Prosa.
OpenAI Decisions API specifications
| Spezifikation | Dokumentierte Endpunktdetails |
|---|---|
| Produkttyp | Spezialisierter API-Endpunkt, kein eigenständiges Foundation Model |
| Endpunkt | POST /v1/decisions |
| Zugrundeliegendes Modell | gpt-6-luna |
| Eingaben | Text und Bilder |
| Entscheidungstypen | predicate, choice, score |
| Ausgaben | Typisierte Entscheidungen und Wahrscheinlichkeitsinformationen |
| Leistung | Etwa 10× schneller als die Responses API (Angabe des Anbieters) |
| Standard-Eingabepreis | $0.10 / 1M Tokens |
| Ausgabekosten | Keine für die Decisions API |
| Toolaufrufe/Streaming | Von diesem Endpunkt nicht direkt unterstützt |
Current availability and access
Stand 15. Oktober 2026 führt der offizielle Leitfaden einen öffentlichen Beta-Zugang auf, wobei gpt-6-luna das einzige unterstützte Modell ist. Senden Sie Anfragen an POST /v1/decisions; der Beta-Status ist keine Garantie für Produktionsstabilität.
Verwenden Sie ein OpenAI-API-Projekt und prüfen Sie vor der Bereitstellung Modellzugriff, Abrechnungsstatus und Ratenlimits. Der Leitfaden nennt das Python SDK ab Version 3.26.0; kontospezifischen Zugriff sollten Sie mit einer kleinen Testanfrage bestätigen.
Berechtigte Kunden können Zero Data Retention und HIPAA-Vereinbarungen nutzen. Der Leitfaden nennt regionale Verarbeitung in den USA und Europa; Berechtigung und vertragliche Anforderungen gelten weiterhin. Der Zugriff über eine Luna-Schnittstelle eines Drittanbieters begründet keine Kompatibilität mit diesem dedizierten Endpunkt.
How Does the OpenAI Decisions API Work?
Eine Anfrage kombiniert gemeinsame Eingabedaten mit vom Entwickler definierten Fragen. Die API bewertet die Eingabe mit GPT-6 Luna und gibt Antworten zurück, die der Anwendungscode zur Automatisierung, Prüfung oder Eskalation nutzen kann. Mehrere Fragen können dieselbe Eingabe teilen, abhängige Fragen sollten jedoch von der Anwendung sequenziert werden.
Predicate evaluation
Ein Prädikat bewertet, ob eine bestimmte Bedingung erfüllt ist. Ein Händler könnte fragen, ob ein Foto sichtbare Produktschäden zeigt; die Antwort liefert eine Wahrscheinlichkeit zwischen 0 und 1.
Ausschnitt einer illustrativen Prädikatsantwort.
{
  "type": "predicate",
  "name": "visible_damage",
  "probability": 0.92
}
Choice selection
Eine Auswahlfrage wählt zwischen ausdrücklich vorgegebenen Kategorien, etwa Billing, Technical Support oder Account Access. Verteilungs- und Konfidenzfelder unterstützen nachgelagertes Routing und Eskalationsrichtlinien.
Score evaluation
Eine Punktfrage bewertet die Eingabe anhand einer geordneten Bewertungsrubrik. Die erwartete Punktzahl kann die wahrscheinlichkeitsgewichteten Indizes der definierten Stufen widerspiegeln; dies stellt nicht automatisch ein kalibriertes reales Risiko dar.
| Index | Schweregrad | Interpretation |
|---|---|---|
| 0 | Niedrig | Kein sofortiger Handlungsbedarf |
| 1 | Moderat | Routinemäßige Nachverfolgung |
| 2 | Hoch | Bedeutende Kundenauswirkung |
| 3 | Kritisch | Sofortige Eskalation |
What Are the Main Features of the OpenAI Decisions API?
Schnelle, begrenzte Ausführung
Typisierte Ausgaben verringern den Bedarf, Prosa zu generieren, Text zu parsen oder fehlerhafte Antworten neu zu versuchen. OpenAI beschreibt eine relative Geschwindigkeitsverbesserung um etwa den Faktor zehn bei unterstützten Entscheidungsaufgaben; die tatsächlichen Gewinne hängen von Eingabelänge, Netzwerk-Overhead und Parallelität ab.
Mehrere Fragen über geteilten Kontext
Ein Support-Ticket kann in einer Anfrage hinsichtlich Zuständigkeit, Dringlichkeit und Prüftauglichkeit bewertet werden. Anwendungen müssen weiterhin deterministische Geschäftsregeln und Autorisierungsprüfungen durchsetzen.
Verständnis von Text und Bildern
Text und Bilder unterstützen Ticket-Routing, Screenshot-Triage und visuelle Inspektion. Konsultieren Sie die offizielle Dokumentation zu unterstützten Bildformaten, Größenlimits und derzeit akzeptierten Nutzlaststrukturen.
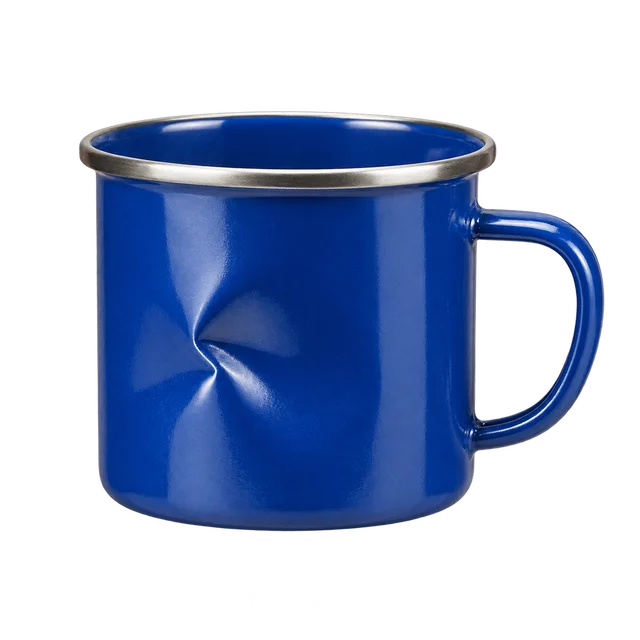
OpenAI verwendet diese verbeulte Tasse in seinem Beispiel für visuelle Entscheidungen. Das Bild veranschaulicht sichtbare Beschädigungen; es ist kein Beleg für eine gemessene Genauigkeitsrate. Dieser Endpunkt akzeptiert inline Base64-Image-Data-URLs, nicht gehostete Bild-URLs oder Datei-IDs.
Wahrscheinlichkeitsbewusste Automatisierung
Gemeldete Konfidenz ist keine garantierte Genauigkeit. Teams sollten Schwellenwerte anhand gelabelter Holdout-Daten abstimmen und für Fälle mit hohen False-Positive- oder False-Negative-Folgen separate Schwellenwerte verwenden.
Sicherheit und Datenkontrollen
Datenaufbewahrung, regionale Verarbeitung und regulierte Nutzung hängen von der Kontokonfiguration und den geltenden vertraglichen Anforderungen ab. Bestätigen Sie die Berechtigung, bevor Sie regulierte oder sensible Informationen verarbeiten.
How Much Does the OpenAI Decisions API Cost?
Der gemeldete Standardtarif beträgt $0.10 pro einer Million Eingabetokens ohne Abrechnung von Ausgabetokens über den dedizierten Decisions-Endpunkt. Regionale Verarbeitung oder Multiplikatoren für langen Kontext können die Endrechnung verändern.
| Komponente | Preis am dedizierten Endpunkt |
|---|---|
| Standardeingabe | $0.10 pro 1M Tokens |
| Ausgabetokens | $0 |
| Cache-Lese-/Schreibvorgänge | $0 |
| Regionalverarbeitung | Es kann ein Aufpreis anfallen |
| Langer Kontext | Multiplikator kann gelten |
| Abrechnungseinheit | Eingabetokens |
Wie viel kann die Decisions API gegenüber der Responses API einsparen?
Vergleichen Sie gleichwertige Aufgaben auf demselben Modell. Der Decisions-Leitfaden nennt $0.10 pro Million Eingabetokens und keine Output- oder Cache-Kosten. Die Luna-Modellseite nennt Standard-Textpreise von $0.10/M für nicht gecachte Eingaben und $0.50/M für Ausgaben bei allgemeiner Modellenutzung.
Illustrative Rechnung, kein Benchmark: 1.000.000 Textanfragen, 500 nicht gecachte abrechenbare Eingabetokens pro Anfrage auf jedem Endpunkt, eine Klassifikation pro Anfrage und keine regionalen oder Langkontext-Aufschläge. Für Responses die insgesamt abgerechneten Ausgabetokens verwenden, einschließlich abgerechneter Reasoning-Tokens, nicht nur die sichtbare Antwortlänge.
Unter diesen Annahmen: Decisions cost = N × I × $0.10 / 1,000,000. Responses cost = N × (I × $0.10 + O × $0.50) / 1,000,000. Savings percentage = (Responses cost − Decisions cost) / Responses cost × 100%, wobei N die Anfragen, I die Eingabetokens/Anfrage und O die abgerechneten Ausgabetokens/Anfrage sind.
| Abgerechnete Responses-Ausgabe / Anfrage | Decisions-Kosten / 1M Anfragen | Responses-Kosten / 1M Anfragen | Geschätzte Einsparung |
|---|---|---|---|
| 5 Tokens | $50.00 | $52.50 | $2.50 (4.8%) |
| 20 Tokens | $50.00 | $60.00 | $10.00 (16.7%) |
| 100 Tokens | $50.00 | $100.00 | $50.00 (50.0%) |
Die obigen Einsparungen resultieren aus der angenommenen Responses-Ausgaberechnung; sie sind kein fixer Endpunkt-Rabatt. Rechnen Sie mit gemessenem Eingabeverbrauch, Cache-Treffern, Cache-Schreibvorgängen, Verarbeitungstier und Retries nach. Cache-Trefferraten oder Batch/Flex-Tarife können das Ergebnis ändern. Tool-Gebühren, manuelle Prüfung und Infrastruktur separat berücksichtigen. Vergleichen Sie die Kosten pro akzeptierter korrekter Entscheidung nach Prüfung von Qualität und Latenz; ein kurzes Label und eine längere Erklärung sind unterschiedliche Arbeitslasten.
OpenAI Decisions API vs Responses API vs Jev and Aplomb 1
Die Tabelle konzentriert sich auf dedizierte Entscheidungsdienste. Für generierte Erklärungen, benutzerdefinierte Extraktionsschemata oder Tool-Workflows nutzen Sie die Responses API wie im OpenAI-Entscheidungsleitfaden beschrieben. Eine Entscheidung kann einen Workflow-Zweig auswählen, während Responses Inhalte generiert oder einen Toolaufruf anfordert; der Anwendungscode übernimmt die benutzerdefinierte Toolausführung.
Capabilities and pricing overview
| Dimension | OpenAI Decisions API | Jev 1.13 | Aplomb 1 |
|---|---|---|---|
| Eingaben | Text und Bilder | Text; experimentelle Bilder mit Opt-in | Text, JSON, Bilder, Video und Audio |
| Standardpreis für Eingaben / 1M Tokens | $0.10 | $0.042 | $0.02 |
| Zugang | Gehostete OpenAI API | Gehostete TypeSafe API | Gehostete API; herunterladbare Gewichte unter der EmpirioLabs Model License |
| Eignung für Evaluierung | Routing, Filterung und Scoring in OpenAI-Workflows | Klassifikation und Intent-Routing | Entscheidungen über mehrere Medien; Bereitstellung mit benötigten Gewichten |
Auswahlrahmen: Jev und Aplomb sind aufgrund ihrer veröffentlichten Entscheidungsfunktionen enthalten, nicht als Popularitätsranking. Spezifikationen und Standardpreise für Eingaben wurden am 16. Oktober 2026 geprüft. TypeSafe ordnet jev-latest weiterhin 1.13 und jev-preview 1.14 zu, daher fixiert dieser Vergleich 1.13. Jev-Bildsupport ist experimentell. Aplomb-Gewichte sind lizenzbeschränkt; prüfen Sie die Bedingungen für den kommerziellen Einsatz. Veröffentlichte Tokenpreise sind weder ein Qualitätsranking noch eine Schätzung der gesamten Workflow-Kosten.
Workflow selection
Erstellen Sie eine Shortlist nach benötigten Eingaben und Bereitstellungsoptionen und testen Sie dann auf denselben gelabelten Fällen. Stimmen Sie Eingabeaufbereitung, Entscheidungsrubriken, End-to-End-Latenzmessungen und Richtlinien für manuelle Prüfungen ab. Vergleichen Sie Routinggenauigkeit, verpasste Fälle, Prüfaufwand und Kosten pro akzeptierter korrekter Entscheidung. Berichten Sie diese gemeinsam, damit ein niedrigerer Tokenpreis oder eine schnellere Antwort nicht zusätzliche Fehler oder Prüfungskosten verdeckt.
How Can You Use the OpenAI Decisions API?
Step 1: Configure credentials
Erstellen Sie einen API-Schlüssel und übergeben Sie ihn als Umgebungsvariable OPENAI_API_KEY. Hartcodieren Sie niemals geheime Schlüssel in Repositories oder Frontend-Anwendungen.
Step 2: Send a request with cURL
Die folgende Anfrage folgt dem offiziellen Beispielschema für choice. Setzen Sie OPENAI_API_KEY vor der Ausführung; eine erfolgreiche Antwort enthält ein answers-Array. Die Shell-Befehle verwenden Bash-Syntax.
Eine Support-Anfrage mit cURL routen.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this complaint?",
        "choices": [
          {"value": "billing", "description": "Payments and refunds"},
          {"value": "technical", "description": "Product issues"},
          {"value": "other", "description": "Everything else"}
        ]
      }
    ]
  }'
Step 3: Integrate with Python
Erforderliches Python SDK installieren.
pip install --upgrade "openai>=3.26.0"
Eine Auswahlentscheidung anfragen und prüfen.
from openai import OpenAI

client = OpenAI()
result = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[{
        "type": "choice",
        "name": "department",
        "instructions": "Which team should handle this request?",
        "choices": [
            {"value": "billing", "description": "Payments and refunds"},
            {"value": "technical", "description": "Product issues"},
            {"value": "other", "description": "Other requests"}
        ]
    }]
)
answer = result.answers[0]
if answer.type == "refusal":
    print("Decision refused")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
Step 4: Define an escalation rule
Einen illustrativen Routing-Schwellenwert anwenden.
if answer.type == "choice":
    if answer.choice != "other" and answer.confidence >= 0.90:
        print("Eligible for automatic routing")
    else:
        print("Send to human review")
Der Schwellenwert von 0.90 ist illustrativ, keine Anbieterzusage und kein offiziell empfohlener Standard. Validieren Sie ihn anhand realer Beispiele und Geschäftsrisiken.
How Can You Access GPT-6 Luna Through CometAPI?
Entwickler können die GPT-6 Luna API in CometAPI für allgemeine Modellaufgaben nutzen. Dies ist nicht mit der Unterstützung für den dedizierten OpenAI-Decisions-Endpunkt zu verwechseln, der eine separate Kompatibilitätsprüfung erfordert.
Textklassifikation über CometAPI Responses.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.responses.create(
    model="gpt-6-luna",
    input=(
        "Classify as billing, technical, or other. "
        "Return only the category. "
        "Request: I was charged twice for my order."
    )
)
print(response.output_text)
Dieses Beispiel ist eine allgemeine Klassifikation über die mit CometAPI kompatible Modell-Schnittstelle; es gibt nicht die native Wahrscheinlichkeitsstruktur der Decisions API zurück und übernimmt nicht deren reine Eingabepreise.
What Are the Best Use Cases for the OpenAI Decisions API?
Dies sind illustrative Anwendungs-Workflows, keine berichteten Deployments oder Benchmark-Ergebnisse. Sie nutzen die Fragetypen predicate, choice und score im offiziellen Decisions-Leitfaden. Der Anwendungscode führt die nachgelagerten Aktionen aus.
Customer support classification
Stellen Sie den Tickettext, relevante Gesprächshistorie und eine vordefinierte Liste von Support-Teams bereit. Eine Auswahlfrage kann Billing, Technical Support oder Account Access auswählen; eine separate Punktfrage kann die Dringlichkeit anhand einer schriftlichen Rubrik bewerten. Der Anwendungscode kann die vorgeschlagene Warteschlange zuweisen und unsichere oder unvollständige Fälle an einen Prüfer senden.
Bewerten Sie den Workflow an Tickets, die vom Supportpersonal gelabelt wurden, und messen Sie die Routinggenauigkeit nach Kategorie, verpasste dringende Fälle, Umverteilungsquoten und Prüfaufwand. Vergleichen Sie diese Ergebnisse mit dem bestehenden Routing-Prozess, bevor Sie die Bereitstellung ausweiten.
Content moderation and review queues
Liefern Sie eingereichten Text oder Bilder zusammen mit klar definierten Prüfkategorien. Prädikatsfragen können bewerten, ob bestimmte Bedingungen im Inhalt vorkommen, während eine Punktfrage die Prüfung nach einer dokumentierten Schweregradrubrik priorisieren kann. Die Anwendung kann dann markierte Elemente in die passende Warteschlange einordnen und den Prüfern die relevanten Inhalte präsentieren; der Endpunkt selbst entfernt keine Inhalte und erzwingt keine Plattformregeln.
Bewerten Sie verpasste Verstöße, unnötige Markierungen, Prüferübereinstimmung und Warteschlangendauer an repräsentativen gelabelten Beispielen. Passen Sie Schwellenwerte getrennt für Kategorien mit unterschiedlichen Konsequenzen an.
E-commerce image inspection
Stellen Sie Produktfotos und die für den Artikel relevanten Prüfkriterien bereit, etwa sichtbare Risse, Risse im Material oder beschädigte Verpackungen. Prädikatsfragen können beurteilen, ob jede Bedingung vorliegt, und eine Punktfrage kann einen definierten Schweregrad anwenden, wenn die Bilder ausreichende Belege liefern. Der Anwendungscode kann ein weiteres Foto anfordern oder eine manuelle Inspektionsaufgabe erstellen, wenn die Beweislage unklar ist.
Bewerten Sie die Erkennungsgenauigkeit an inspizierten Artikeln, einschließlich übersehener Schäden und Fehlalarme über Produktkategorien und Bildbedingungen hinweg. Belassen Sie Erstattungs- oder Ersatzentscheidungen im bestehenden Genehmigungsworkflow des Händlers.
AI-agent action gating
Stellen Sie die vorgeschlagene Aktion, ihre Argumente, die relevante Nutzeranfrage und die schriftlichen Ausführungsregeln der Anwendung bereit. Prädikatsfragen können bewerten, ob der Vorschlag zur angeforderten Aufgabe passt oder eine Prüfung erfordert. Der Anwendungscode kann das Ergebnis nutzen, um einen vordefinierten Zweig zu wählen: fortfahren, um Klarstellung bitten oder eskalieren. Unabhängige Berechtigungsprüfungen müssen weiterhin bestimmen, ob die Ausführung autorisiert ist; das Urteil des Modells ist nur ein Input.
Bewerten Sie das Gate mit gelabelten Aktionsvorschlägen und messen Sie übersehene unautorisierte Aktionen, unnötige Eskalationen und Sensitivität gegenüber unvollständigem oder widersprüchlichem Kontext, bevor Sie es mit der Ausführung verbinden.
Document and email triage
Stellen Sie den Dokument- oder E-Mail-Text, relevante Metadaten und einen festen Satz von Kategorien wie Rechnung, Supportanfrage, Besprechungsanfrage oder Sonstiges bereit. Eine Auswahlfrage kann die Kategorie wählen, während Prädikatsfragen Bedingungen wie fehlende Pflichtangaben identifizieren können. Der Anwendungscode kann das Element an den passenden Extraktions-, Abruf- oder Prüfworkflow senden, ohne den Entscheidungsendpunkt mit diesen späteren Schritten zu betrauen.
Bewerten Sie Kategoriegenauigkeit, fehlerhaftes nachgelagertes Routing, Prüfvolumen und Durchlaufzeit anhand repräsentativer gelabelter Datensätze, einschließlich mehrdeutiger Elemente und ungewohnter Formate.
What Are the OpenAI Decisions API’s Limitations?
Die API generiert keine beliebigen erklärenden Inhalte, führt Tools nicht direkt aus und ersetzt nicht die Notwendigkeit, Vorhersagen zu testen. Fehlende Kategorien und schlecht formulierte Entscheidungsrubriken können unangemessene Ergebnisse erzeugen. Konfidenzwerte können fehlkalibriert sein; Automatisierung mit hohen Risiken benötigt weiterhin Schutzmechanismen, manuelle Prüfung und Autorisierungslogik.
Conclusion
Die Decisions API ist vielversprechend für großvolumige, begrenzte Urteile, da sie typisierte Wahrscheinlichkeitsausgaben mit einem vereinfachten Token-Preismodell kombiniert. Teams sollten sie gegenüber Structured Outputs und alternativen Entscheidungsmodellen anhand derselben gelabelten Fälle, Latenzmessungen und gesamter Workflow-Kosten vergleichen. Die Kernchance besteht darin, Schritte in einer KI-Anwendung zu identifizieren, die eine Auswahl brauchen statt generierter Prosa.
FAQs
How should OpenAI Decisions API refusals be handled?
Behandeln Sie eine Ablehnung als eigenen Workflow-Ausgang. Prüfen Sie answer.type, bevor Sie choice-, score- oder probability-Felder auslesen. Protokollieren Sie den Fragnamen und leiten Sie die Anfrage an einen Prüf- oder Wiederherstellungspfad; interpretieren Sie eine Ablehnung niemals als negatives Prädikat oder als Nullpunktzahl.
How can Decisions API thresholds be maintained over time?
Wählen Sie Schwellenwerte anhand gelabelter Holdout-Beispiele und überwachen Sie anschließend die Genauigkeit unter den akzeptierten Entscheidungen sowie den Anteil, der zur Prüfung gesendet wird. Evaluieren Sie neu, nachdem sich Kategorien, Anweisungen, Eingabequellen oder das Modellverhalten ändern. Führen Sie eine versionierte Rubrik, damit Änderungen im Routing auf die Konfiguration zurückgeführt werden können, die sie erzeugt hat.
How should OpenAI Decisions API latency tests be reported?
Protokollieren Sie Datum, Region, Modellkennung, Anzahl der Fragen, Textlänge, Bildgröße, Parallelität, Client-Version, Retry-Policy und Konfiguration des Vergleichsendpunkts. Berichten Sie End-to-End p50 und p95 mit Stichprobengrößen und Qualitätsresultaten, damit ein Geschwindigkeitsgewinn nicht allein dadurch erreicht wird, dass mehr Fehler akzeptiert werden.
How should Decisions API categories evolve without breaking integrations?
Verwenden Sie stabile, maschinenlesbare Werte und pflegen Sie eine explizite Zuordnung zu nachgelagerten Warteschlangen. Fügen Sie eine Fallback-Kategorie hinzu und testen Sie historische Edge-Cases, bevor Sie neue Beschreibungen bereitstellen. Wenn eine Kategorie umbenannt wird, aktualisieren Sie die Routingzuordnung und die Rubrik gemeinsam, statt unbekannte Werte in Produktionsaktionen gelangen zu lassen.
What should be logged for a Decisions API routing audit?
Protokollieren Sie die Rubrikversion, die gewählte Kategorie, relevante Wahrscheinlichkeiten oder Konfidenz, Schwellenwert, Modellkennung, Zeitstempel und ergriffene Aktion. Beschränken Sie gespeicherte Eingabedaten auf das, was der Workflow benötigt, und wenden Sie die Aufbewahrungsrichtlinie der Organisation an. Ein Audit-Datensatz sollte zeigen, warum die Anwendungslogik den Fall geroutet oder eskaliert hat.