
TL;DR: ¿Qué alternativa a la API de GPT-6 Astra deberías elegir?
Elige el modelo según la carga de trabajo: Claude Opus 5 como sustituto premium más cercano, Claude Fable 5.1 para el razonamiento sostenido más difícil, GPT-5.6 Sol para la migración con menor fricción desde OpenAI, Claude Sonnet 5 para producción de alto volumen, Gemini 3.8 Flash para trabajo multimodal de bajo costo, y DeepSeek V4.1 Flash cuando el costo por token es la restricción principal.
Mantén GPT-6 Astra para cargas donde su mayor capacidad de uso del ordenador, ejecución autónoma, razonamiento científico o desempeño en ciberseguridad reduzcan significativamente los reintentos y la intervención humana.
Puntos clave: ¿Qué importa al reemplazar GPT-6 Astra?
- GPT-6 Astra es difícil de reemplazar en sus tareas más agenticas. La tabla oficial de benchmarks de GPT-6 Astra registra 57.9% en Terminal-Bench 4.0, 97.6% en FrontierMath Tier 4, y 96.0% en GPQA Diamond.
- Claude Opus 5 es la alternativa directa más equilibrada para probar primero. Anthropic fija Opus 5 en $5/$25 por millón de tokens de entrada/salida, la mitad de las tarifas base de Astra.
- Claude Fable 5.1 no es una alternativa de presupuesto. Su precio de $10/$50 para entrada/salida coincide con la tarifa principal de Astra, mientras que ciertas evaluaciones de conocimiento y razonamiento de largo horizonte favorecen a Fable 5.1.
- GPT-5.6 Sol es la degradación más sencilla en lugar de un cambio real de plataforma. La ventana de contexto de 1.05M, salida máxima de 128K y precios de $4/$20 reducen la fricción de migración para aplicaciones de OpenAI.
- Gemini 3.8 Flash ofrece una sólida relación precio/rendimiento alojada. Su tarifa de introducción 2026 es de $0.75/$3.75 por millón de tokens de entrada/salida.
- DeepSeek V4 Flash está en una clase de costo diferente. Sus tarifas oficiales pico y valle están muy por debajo de los precios de modelos premium, pero un menor costo por token no establece tasas de éxito agenticas equivalentes.
- La mejor métrica de producción suele ser el costo por tarea completada aceptada. Incluye reintentos, fallos de herramientas, latencia, uso de tokens de salida y retrabajo humano.
¿Qué es la API de GPT-6 Astra?
OpenAI posiciona GPT-6 Astra como su modelo insignia para trabajo complejo de extremo a extremo. La especificación de la API incluye una ventana de contexto de 1,050,000 tokens y salida máxima de 128,000 tokens, entrada de texto e imagen, soporte de tokens de razonamiento y cinco niveles de esfuerzo de razonamiento: low, medium, high, xhigh y max.
Astra difiere de un chatbot convencional porque está diseñado para ejecución de larga duración. La descripción oficial de capacidades enfatiza el uso del ordenador y trabajo profesional, junto con ingeniería de software, navegación, ciencia, ciberseguridad y razonamiento complejo.
| Especificación de GPT-6 Astra | Valor |
|---|---|
| ID del modelo de API | gpt-6-astra |
| Proveedor | OpenAI |
| Ventana de contexto | 1,050,000 tokens |
| Salida máxima | 128,000 tokens |
| Entrada | Texto, imágenes |
| Salida | Texto |
| Fecha de corte de conocimientos | 30 de abril de 2026 |
| Esfuerzo de razonamiento | Low, medium, high, xhigh, max |
| Precio estándar de entrada | $10 / 1M tokens |
| Entrada en caché | $1 / 1M tokens |
| Precio estándar de salida | $50 / 1M tokens |
| Umbral de contexto largo | Más de 272K tokens de entrada |
Nota sobre precios de contexto largo:
las solicitudes por encima de 272K tokens de entrada
se revalúan para toda la solicitud a $20/M de entrada y $75/M de salida. Presupuesta estas solicitudes por separado.
Por qué los equipos miran más allá de GPT-6 Astra
Astra es más convincente cuando su capacidad adicional elimina intentos fallidos, errores de herramientas, intervención manual o llamadas repetidas a modelos más débiles. Su precio premium es más difícil de justificar para tareas de resumen, extracción, clasificación, RAG rutinario, chat ordinario y generación de código estándar.
Por eso, los equipos evalúan alternativas para reducir costos, mantenerse dentro de un ecosistema de proveedor existente, mejorar la economía de caché, añadir soporte multimodal o usar un modelo más rápido para tráfico rutinario reservando Astra para la escalada.
Comparación de benchmarks y limitaciones
Nota sobre la evidencia: la tabla usa el marco de comparación publicado por OpenAI para situar varias alternativas en una configuración común. Estas puntuaciones reportadas por los proveedores pueden cambiar con snapshots de modelos, prompts, herramientas y metodología de evaluación; úsalas para preseleccionar candidatos y luego valida a los finalistas en tareas de producción representativas.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
Los resultados muestran por qué llamar a cualquier modelo un “reemplazo universal de Astra” es engañoso. Astra tiene una ventaja clara en varias evaluaciones agenticas y científicas, mientras que Fable 5.1 rinde mejor en Humanity’s Last Exam y varias alternativas se mantienen muy cerca en DeepSWE.
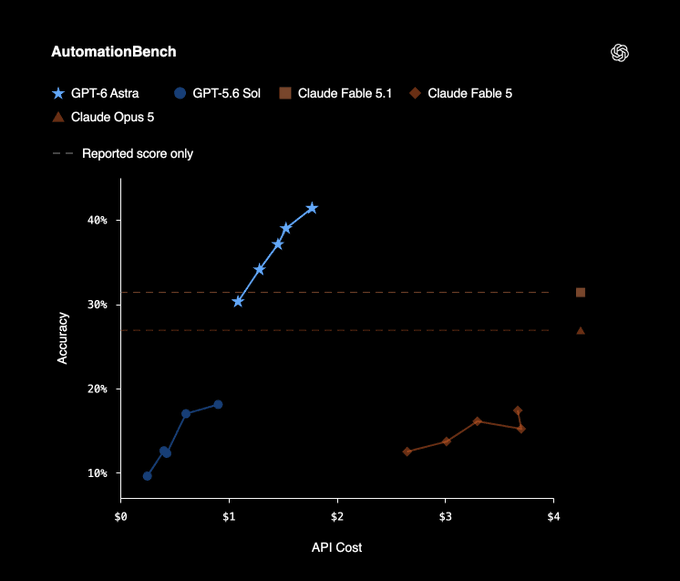
Gráfico oficial del benchmark AutomationBench de OpenAI.
Los índices públicos de benchmarks también pueden cambiar a medida que se revisan metodología y snapshots de modelos. Úsalos para preseleccionar candidatos, no como sustituto de la evaluación específica por carga de trabajo.
Alternativas a GPT-6 Astra
Ningún modelo reemplaza a Astra en todas las cargas. La opción más práctica depende de la capacidad que necesites, del ecosistema de proveedor que ya uses y del costo de ejecuciones fallidas o repetidas.
| Alternativa | Precio oficial de entrada/salida por 1M de tokens | Contexto | Mejor motivo para elegirla |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Sustituto premium general más cercano |
| Claude Fable 5.1 | $10 / $50 | 1M | Razonamiento más difícil y agentes de larga duración |
| GPT-5.6 Sol | $4 / $20 | 1.05M | Migración con menor fricción desde OpenAI |
| Claude Sonnet 5 | $2 / $10 | 1M | Trabajo de producción de alto volumen |
| Gemini 3.8 Flash | $0.75 / $3.75 promocional | 1M | Trabajo multimodal y por lotes de bajo costo |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Costo por token más bajo y procesamiento de alto volumen |
Claude Opus 5
Por qué considerarlo
Claude Opus 5 es la primera alternativa a probar cuando un producto necesita rendimiento premium en razonamiento, programación o trabajo profesional a un precio de lista inferior al de Astra.
Precio, contexto y caché
Anthropic lista Claude Opus 5 a $5/M de entrada y $25/M de salida con una ventana de contexto de 1M tokens. Confirma las condiciones actuales de caché antes de presupuestar producción.
Dónde rinde bien
Es competitivo en programación, análisis, redacción profesional y flujos de agentes; la tabla de benchmarks citada lo sitúa cerca de Astra en DeepSWE y FrontierCode.
Limitaciones
No supera de forma consistente a Astra. Astra sigue siendo la opción más fuerte cuando la operación del ordenador, la ejecución autónoma avanzada, la ciberseguridad o las herramientas nativas de OpenAI son centrales para el producto.
Ideal para / Evitar cuando
Ideal para: agentes de programación premium, análisis complejo y redacción profesional. Evitar cuando: el flujo depende en gran medida de herramientas específicas de Astra o de su capacidad de uso del ordenador.
Claude Fable 5.1
Por qué considerarlo
Claude Fable 5.1 compite como insignia para el razonamiento más difícil, investigación, programación y tareas de agentes de larga duración, más que como un reemplazo de bajo costo.
Precio, contexto y caché
Sus tarifas de $10/M de entrada y $50/M de salida coinciden con las de Astra. La ventana de contexto de 1M tokens y el precio de lectura de caché de $0.25/M pueden mejorar la economía cuando se reutilizan prompts grandes con frecuencia.
Dónde rinde bien
Es especialmente atractivo para razonamiento sostenido y agentes intensivos en caché; en la comparación citada, supera a Astra en Humanity’s Last Exam con herramientas.
Limitaciones
No reduce la tarifa principal por token, y Astra conserva ventajas en varios benchmarks agenticos y científicos, así como en herramientas nativas de OpenAI.
Ideal para / Evitar cuando
Ideal para: máxima calidad de razonamiento y flujos de largo contexto con repetición. Evitar cuando: el objetivo principal es una gran reducción del precio estándar por token.
GPT-5.6 Sol
Por qué considerarlo
GPT-5.6 Sol ofrece la migración con menor fricción para aplicaciones ya construidas alrededor del comportamiento y herramientas compatibles con OpenAI.
Precio, contexto y caché
La especificación citada del modelo indica $4/M de entrada y $20/M de salida, una ventana de contexto de 1.05M tokens y salida máxima de 128K. Verifica las condiciones actuales de entrada en caché antes del presupuesto final.
Dónde rinde bien
Se mantiene cerca de Astra en DeepSWE y GPQA Diamond mientras cuesta considerablemente menos bajo el nivel estándar de contexto corto.
Limitaciones
La brecha se amplía en tareas representadas por Terminal-Bench y FrontierMath, por lo que los ahorros pueden desaparecer si una menor tasa de finalización provoca reintentos o reparación manual.
Ideal para / Evitar cuando
Ideal para: aplicaciones existentes de OpenAI y cargas generales que no necesitan las capacidades agenticas más fuertes de Astra. Evitar cuando: la carga se beneficia repetidamente de las grandes ganancias de Astra en benchmarks.
Claude Sonnet 5
Por qué considerarlo
Claude Sonnet 5 es un valor práctico por defecto en producción para trabajo de conocimiento competente y repetible que no requiere un modelo insignia de frontera en cada solicitud.
Precio, contexto y caché
Su tarifa permanente citada es $2/M de entrada y $10/M de salida con una ventana de contexto de 1M tokens. Confirma las condiciones actuales de caché para despliegues con mucha reutilización de prompts.
Dónde rinde bien
Se ajusta a clasificación de tickets, extracción de documentos, RAG estándar, transformación de contenido, explicación de código, invocación de funciones rutinaria y generación estructurada.
Limitaciones
No puede sustituir de forma fiable a Astra en todos los problemas de largo horizonte o razonamiento de frontera.
Ideal para / Evitar cuando
Ideal para: tráfico de producción de alto volumen y automatización empresarial rutinaria. Evitar cuando: fallar en una tarea agentica difícil es más costoso que la prima del modelo insignia.
Gemini 3.8 Flash
Por qué considerarlo
Gemini 3.8 Flash combina entrada multimodal, gran contexto y bajo costo de API alojada para documentos, medios, programación y pipelines por lotes.
Precio, contexto y caché
La tarifa de introducción citada es $0.75/M de entrada y $3.75/M de salida hasta el 31 de diciembre de 2026, con una ventana de contexto de 1M tokens y caché con descuento durante el periodo promocional.
Dónde rinde bien
Es adecuado para extracción multimodal, PDFs, audio, video, imágenes, grandes colecciones de documentos, análisis por lotes y cargas de programación sensibles al costo.
Limitaciones
El precio promocional es por tiempo limitado, y las tareas agenticas o de uso del ordenador más difíciles aún requieren validación específica por carga frente a Astra.
Ideal para / Evitar cuando
Ideal para: procesamiento multimodal de bajo costo y por lotes de alto volumen. Evitar cuando: la aplicación requiere la ejecución autónoma más fuerte independientemente del costo por token.
DeepSeek V4.1 Flash
Por qué considerarlo
DeepSeek V4.1 Flash es la opción enfocada en costo para razonamiento, programación, resumen, extracción, clasificación y procesamiento offline de alto rendimiento.
Precio, contexto y caché
El calendario de tarifas pico y valle citado lista lecturas de caché de entrada a $0.007–$0.014/M, fallos de caché de entrada a $0.22–$0.44/M y salida a $0.66–$1.32/M, con una ventana de contexto de 1M tokens. Revisa la página de precios actual de V4.1 antes de publicar.
Dónde rinde bien
Es atractivo cuando el costo por token domina y la aplicación puede usar enrutamiento, validación o controles de calidad offline para gestionar la variabilidad.
Limitaciones
Un precio por token mucho menor no establece un éxito agentico equivalente. Fiabilidad, comportamiento de herramientas, latencia y tasa de aceptación deben medirse en la carga objetivo.
Ideal para / Evitar cuando
Ideal para: procesamiento a gran escala y sensible al costo con validación. Evitar cuando: una ejecución autónoma fallida de alto valor superaría el ahorro en tokens.
GPT-6 Astra vs alternativas: ¿Qué modelo gana en cada categoría?
Juntar precio, arquitectura, contexto y evidencia de benchmarks proporciona una tabla de decisión más útil que simplemente clasificar modelos del primero al sexto.
| Categoría | Mejor opción | Por qué |
|---|---|---|
| Alternativa general a Astra | Claude Opus 5 | Rendimiento cercano a frontera a la mitad del precio de lista de Astra |
| Razonamiento máximo | Claude Fable 5.1 | Razonamiento insignia y fuerte rendimiento de largo horizonte |
| Permanecer en OpenAI | GPT-5.6 Sol | Ecosistema de API similar con precios 60% más bajos |
| Producción de alto volumen | Claude Sonnet 5 | Alta calidad a $2/$10 |
| Relación precio/rendimiento multimodal | Gemini 3.8 Flash | Contexto de 1M más precio de introducción 2026 muy bajo |
| Costo de API más bajo | DeepSeek V4.1 Flash | $0.22–$0.44 entrada y $0.66–$1.32 salida |
| Agentes con uso intensivo de computadora | GPT-6 Astra | Uno de los diferenciadores más claros de Astra |
| Flujos científicos y matemáticos difíciles | GPT-6 Astra | Resultados muy fuertes en FrontierMath y agentes científicos |
| Agentes largos con uso intensivo de caché | Claude Fable 5.1 | Lecturas de caché a $0.25/M |
El resultado más importante es que GPT-6 Astra aún gana en algunas categorías. Un artículo de alternativas no debería implicar que un modelo más barato lo reemplace universalmente. Astra se vuelve caro cuando se despliega en todas partes; aún puede ser económico cuando su mayor tasa de finalización de tareas reemplaza varios intentos con modelos más débiles.
¿Cuánto puedes ahorrar realmente al reemplazar la API de GPT-6 Astra?
Considera una carga que consume 1 millón de tokens de entrada sin caché y 200,000 tokens de salida. Ignorando descuentos de caché, tarifas de herramientas, reintentos, precios por lotes y recargos por contexto largo:
| Modelo | Costo aproximado de API |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Tarifa promocional de Gemini 3.8 Flash | $1.50 |
| DeepSeek V4.1 Flash fuera de pico | $0.35 |
El cálculo básico es:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Este ejemplo simple también demuestra por qué el precio por token no puede ser la única métrica. Si una solicitud de $20 con Astra tiene éxito una vez mientras que un modelo de $4 requiere seis intentos, múltiples reintentos de herramientas y reparación humana, Astra fue en realidad más barato.
Una mejor métrica de producción es:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Sigue ese número junto con latencia, éxito de tareas, tasa de reintentos, errores de llamadas a herramientas y tasa de escalado a humanos.
¿Cómo puedes probar alternativas a GPT-6 Astra a través de CometAPI?
Un beneficio práctico de una capa de API multmodelo es que la evaluación no tiene que convertirse en un proyecto de integración con un proveedor. CometAPI proporciona GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash y DeepSeek V4.1 Flash a través de un catálogo único de modelos.
Con un cliente compatible con OpenAI, el modelo puede hacerse configurable en lugar de estar codificado:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Puedes volver a ejecutar el mismo conjunto de evaluación usando IDs de modelo como:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Esto suele ser más informativo que elegir una alternativa solo desde un ranking de benchmarks. Toma de 100 a 500 prompts de producción representativos y registra éxito de tareas, aceptación humana, reintentos, errores de herramientas, tokens totales, latencia y costo total de API.
¿Deberías reemplazar GPT-6 Astra con un único modelo o usar enrutamiento de modelos?
Para muchas aplicaciones, reemplazar Astra con un único modelo universal es la optimización equivocada. Una arquitectura más eficiente se ve así:
- Tráfico rutinario → Claude Sonnet 5, Gemini 3.8 Flash o DeepSeek V4.1 Flash
- Razonamiento difícil → Claude Opus 5 o GPT-5.6 Sol
- Tareas muy difíciles de largo horizonte → Claude Fable 5.1 o GPT-6 Astra
- Uso intensivo del ordenador o flujos de agentes específicos de Astra → GPT-6 Astra
Esto convierte a Astra en un modelo de escalada en lugar del modelo por defecto. Si solo el 10% de las solicitudes requiere realmente rendimiento agentico de frontera, enrutar el 100% del tráfico por Astra significa pagar su prima también en el otro 90%.
¿Qué alternativa a la API de GPT-6 Astra deberías elegir?
Elige Claude Opus 5 si quieres el equilibrio más cercano entre calidad y precio.
Elige Claude Fable 5.1 si el razonamiento máximo importa más que reducir las tarifas principales por token.
Elige GPT-5.6 Sol si ya usas OpenAI y quieres el menor cambio de integración.
Elige Claude Sonnet 5 si la mayor parte de tu tráfico de producción es trabajo de conocimiento competente pero ordinario.
Elige Gemini 3.8 Flash si importan la multimodalidad, la escala y el bajo costo de API alojada.
Elige DeepSeek V4.1 Flash si el costo por token es la restricción dominante y tu carga puede tolerar más evaluación y validación.
Y elige GPT-6 Astra cuando tu aplicación se beneficie realmente de un uso del ordenador más fuerte, trabajo autónomo de software difícil, razonamiento científico u otras capacidades agenticas.
El error principal no es elegir el “modelo de frontera equivocado”. Es pagar precios de modelo de frontera por solicitudes que nunca necesitaron un modelo de frontera en primer lugar.
Preguntas frecuentes
¿Cuál es la mejor alternativa general a la API de GPT-6 Astra?
Claude Opus 5 es uno de los sustitutos de propósito general más fuertes. Ofrece una ventana de contexto de 1M, sólidas capacidades de programación y agentes, y precios de lista de $5/$25—la mitad de las tarifas estándar por token de Astra.
¿Cuál es la alternativa más barata a GPT-6 Astra?
Entre los modelos cubiertos aquí, DeepSeek V4.1 Flash tiene el precio por token de primera parte más bajo. Su tarifa actual fuera de pico es $0.22/M de entrada sin caché y $0.66/M de salida. Sin embargo, no debe asumirse que iguala el éxito agentico de Astra simplemente por ser más barato.
¿Claude Fable 5.1 es mejor que GPT-6 Astra?
Ninguno gana en todas las cargas. La comparación de OpenAI da a Astra ventajas significativas en FrontierMath Tier 4 y Terminal-Bench 4.0, mientras que Fable 5.1 puntúa más alto en Humanity’s Last Exam con herramientas.
¿Sigue valiendo la pena GPT-5.6 Sol después de GPT-6 Astra?
Sí. Sus precios estándar de API de $4/$20 están sustancialmente por debajo de los $10/$50 de Astra mientras conserva una ventana de contexto de 1.05M. Por tanto, puede ser mejor por defecto en cargas donde las ganancias de Astra no mejoran materialmente la finalización de tareas.
¿Gemini 3.8 Flash es suficiente para reemplazar GPT-6 Astra?
Para algunas cargas de programación, multimodales, de documentos y procesamiento por lotes, sí. Es dramáticamente más barato y tiene una ventana de contexto de 1M. Para los agentes autónomos más difíciles y tareas de uso del ordenador, Astra sigue siendo la opción más fuerte.
¿GPT-6 Astra tiene desventaja de precios para prompts muy largos?
Sí. OpenAI aplica un nivel de precios superior cuando la entrada supera los 272K tokens, por lo que las solicitudes de contexto largo deben presupuestarse por separado.
¿Debo comparar modelos usando precio por token o puntuaciones de benchmarks?
Usa ambos solo como métricas de cribado. La métrica de producción que más suele importar es el costo por tarea aceptada completada, incluyendo tokens de razonamiento, reintentos, llamadas a herramientas, latencia y retrabajo humano.
¿Puedo usar varias alternativas a GPT-6 Astra en la misma aplicación?
Sí. En muchas aplicaciones, el enrutamiento de modelos es preferible a comprometer todas las solicitudes con un solo modelo. Un modelo de bajo costo puede manejar solicitudes rutinarias mientras modelos más fuertes manejan escaladas cada vez más difíciles.