

TL;DR
Claude Opus 5.5 es un sólido candidato inicial porque ofrece precios por token sustancialmente más bajos, a la vez que iguala o supera a Fable 5.1 en varias evaluaciones publicadas, cobrando $4 por millón de tokens de entrada y $20 por millón de tokens de salida, frente a Fable 5.1 con $10 y $50.
Fable 5.1 sigue teniendo un papel cuando una tarea es inusualmente difícil, de larga duración, costosa de reintentar o se espera que opere sin supervisión cercana. La regla práctica es simple: empieza con Opus 5.5 y escala solo cuando pruebas representativas en producción muestren que Fable 5.1 reduce lo suficiente los costos por fallos, correcciones o reintentos como para justificar su prima.
Claude Opus 5.5 vs Claude Fable 5.1 de un vistazo
| Dimensión | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Fecha de lanzamiento | Sep. 22, 2026 | Sep. 1, 2026 |
| ID de modelo de la API | claude-opus-5-5 | claude-fable-5-1 |
| Contexto / salida máxima | 1M / 128K | 1M / 128K |
| Precio entrada/salida por MTok | $4 / $20 | $10 / $50 |
| Lectura de caché por MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Migración de HAProxy C a Rust | 9.5 horas; 51% menos costo de tarea | 12 horas; costo de tarea base |
| Opción de velocidad | Fast mode, hasta 2.5× la velocidad normal | Sin modo de lanzamiento equivalente |
| Punto de partida del esfuerzo | Orientación media | Alta |
| Mejor uso predeterminado | Programación de frontera diaria, agentes, producción supervisada y tráfico API de alto volumen | Trabajo de mayor valor, difícil, de larga duración o autónomo sin supervisión |
| Acceso a la API | Anthropic API y proveedores compatibles, incluido CometAPI | Anthropic API y proveedores compatibles, incluido CometAPI |
Nota de lectura: Las cifras de los benchmarks son reportadas por Anthropic y dependen del nivel de esfuerzo, el arnés, las salvaguardas, la versión de la tarea, el número de ensayos y el error estándar. Deben compararse solo en condiciones de evaluación equiparables.
Conclusiones clave
- Las tarifas estándar de entrada y salida de Opus 5.5 son un 60% inferiores a las de Fable 5.1.
- Ambos modelos admiten una ventana de contexto de 1M tokens y hasta 128K de salida, por lo que el costo, la configuración de esfuerzo y el ajuste al trabajo importan más que el tamaño nominal del contexto.
- Los resultados publicados por Anthropic favorecen a Opus 5.5 en muchas evaluaciones de programación y agentic, pero la configuración del benchmark afecta materialmente el resultado.
- Evaluaciones independientes respaldan la posición de frontera de Opus 5.5, aunque reporten puntajes absolutos diferentes, lo que refuerza la necesidad de pruebas equiparadas.
- Para la mayoría del trabajo de producción supervisado, Opus 5.5 es el mejor punto de partida. Fable 5.1 es una capa de escalado, no el predeterminado automático.
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es el primer modelo Claude 5.5 de Anthropic. Está orientado a programación agentic, agentes de larga duración, trabajo profesional de conocimiento, flujos de trabajo empresariales, análisis financiero, visión y uso de computadoras.
Su ID de modelo de API es claude-opus-5-5. El pensamiento adaptativo está siempre habilitado, mientras que los desarrolladores controlan la intensidad del razonamiento mediante niveles de esfuerzo low, medium, high, xhigh y max. Anthropic también ofrece Fast mode, que puede operar hasta 2.5 veces más rápido que la velocidad normal por $8/M de entrada y $40/M de salida.
¿Qué es Claude Fable 5.1?
Claude Fable 5.1 está orientado a proyectos exigentes y de larga duración como programación de varias horas, investigación compleja, interacción con navegador, agentes autónomos y flujos de trabajo que abarcan múltiples aplicaciones.
Su ID de modelo de API es claude-fable-5-1. Utiliza pensamiento adaptativo, parte de una configuración de API con mayor esfuerzo y debe tratarse como la opción premium cuando el costo esperado de fallos o reintentos repetidos supera el costo adicional de inferencia.
Una lectura simplificada sería que Opus 5.5 ofrece casi el mismo alcance por el 40% del precio estándar de tokens de Fable. Pero aquí es precisamente donde una tabla de especificaciones simples se vuelve engañosa.
Comparación de código y benchmarks
Anthropic reporta a Opus 5.5 por delante de Fable 5.1 en Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam con herramientas, Terminal-Bench-Science, OSWorld 2.0 y Chartography.
Cómo leer los resultados de los benchmarks
Anthropic reporta a Opus 5.5 por delante de Fable 5.1 en Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam con herramientas, Terminal-Bench-Science, OSWorld 2.0 y Chartography. Estas cifras son resultados de evaluación, no constantes del modelo independientes de la configuración.
La mayoría de los puntajes destacados de Opus 5.5 usaron esfuerzo max, mientras que Terminal-Bench 4.0 usó esfuerzo xhigh. El diseño del arnés, la configuración de herramientas, las salvaguardas, el número de ensayos, el error estándar, el comportamiento de fallback y los límites de costo pueden cambiar el resultado. La propia Anthropic advierte que los márgenes de los benchmarks pueden sobrestimar la brecha práctica entre modelos de frontera.
Rendimiento en programación
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretación |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Ventaja reportada de 10.6 puntos en tareas de agentes basadas en terminal |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Opus 5.5 con esfuerzo medio se mantiene competitivo para la economía de producción |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Esfuerzo medio supera ligeramente el resultado reportado de Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Ventaja reportada en trabajo agentic profesional |
Estas cifras son resultados de benchmarks reportados por Anthropic. La tabla debe leerse junto con las advertencias sobre la configuración de evaluación en las secciones siguientes y la página oficial del modelo Claude Opus.
Los tres primeros resultados destacan porque cubren la carga de trabajo donde Claude es cada vez más importante comercialmente: agentes de ingeniería de software. Terminal-Bench 4.0 muestra una diferencia absoluta de 10.6 puntos porcentuales; FrontierCode muestra 4.1 puntos; CursorBench 4.0 muestra 6 puntos.
GDPval-AA, que mide trabajo agentic profesional, también reporta 1846 Elo para Opus 5.5 frente a 1735 para Fable 5.1. Si estas cifras fueran toda la historia, la jerarquía de producto parecería invertida. No es tan simple.
Evaluación independiente
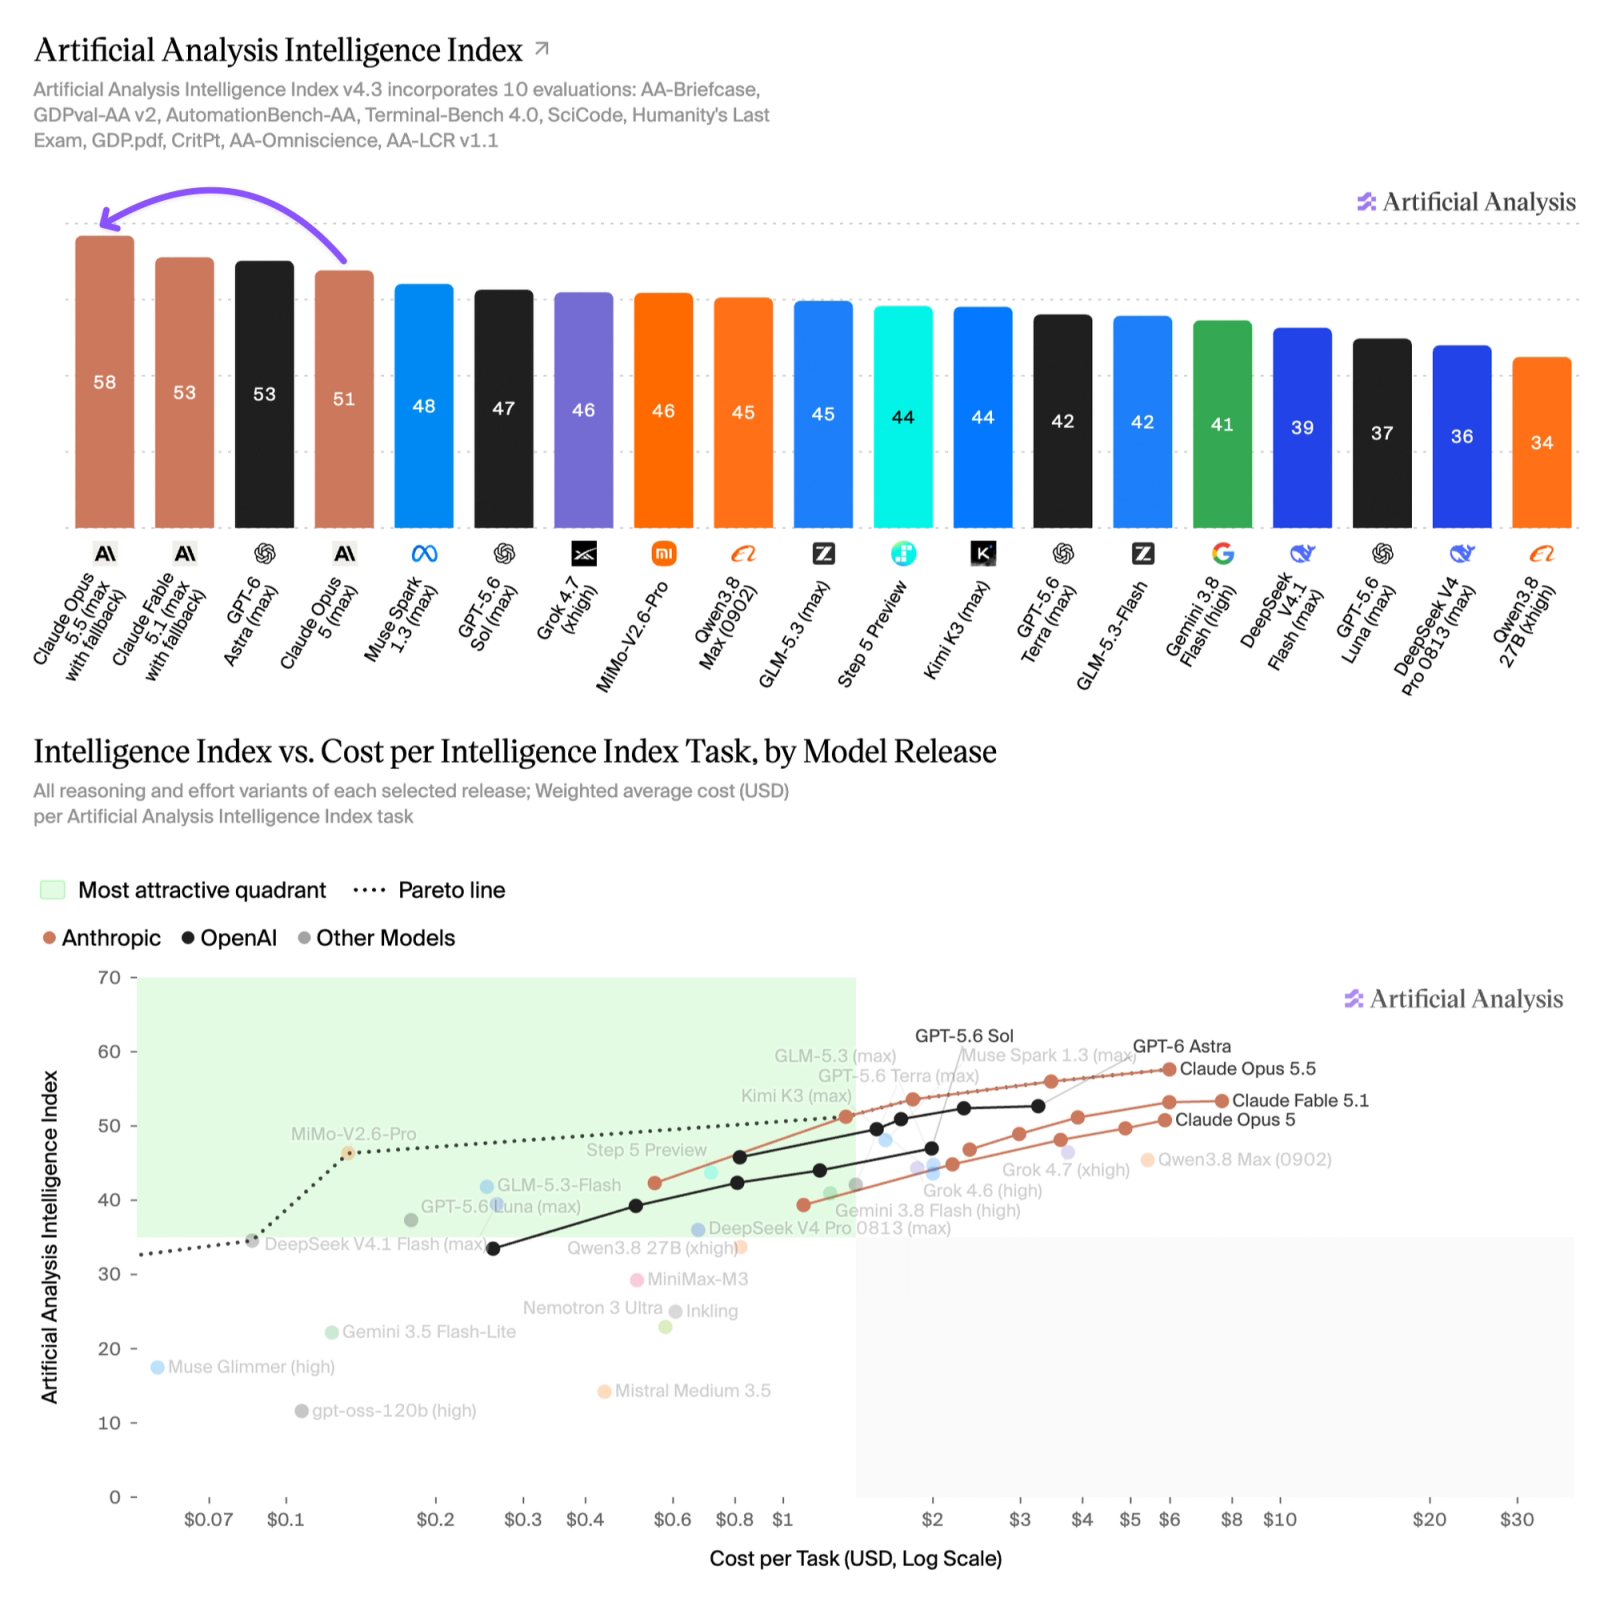
Artificial Analysis ubicó a Opus 5.5 Max en 58 en su Intelligence Index y reportó resultados sólidos en AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode y Humanity's Last Exam. Su resultado de Terminal-Bench 4.0 fue 59.6%, por debajo del 66.4% de Anthropic, demostrando por qué los equipos deben documentar la versión del modelo, el nivel de esfuerzo, el arnés, las herramientas, el número de ensayos y el límite de costo siempre que los puntajes discrepen.
Comparación de precios y costo por tarea completada
CometAPI ofrece precios por token inferiores a las tarifas oficiales, lo que permite a los desarrolladores lograr el mismo rendimiento que la API oficial usando el formato estándar de solicitud de mensajes.
Precios por token
| Precios | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Entrada | $4 | $10 |
| Salida | $20 | $50 |
| Escritura de caché 5 min | $5 | $12.50 |
| Escritura de caché 1 hora | $8 | $20 |
| Lectura de caché | $0.20 | $0.25 |
| Entrada/salida por lotes | 50% de descuento | 50% de descuento |
Supongamos que una carga de trabajo consume 10 millones de tokens de entrada nuevos y 2 millones de tokens de salida. Sin efectos de caché:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Bajo esos supuestos, Opus 5.5 cuesta 60% menos. Sin embargo, este número no debe confundirse con la afirmación de Anthropic de que Opus 5.5 cuesta alrededor de 40% menos de ejecutar que Opus 5.
Son dos comparaciones completamente diferentes. La cifra del 40% incluye los precios más bajos de la capa Opus 5.5 y la reducción del consumo de tokens por tarea en relación con Opus 5. La cifra del 60% proviene directamente de comparar los precios de lista estándar de Opus 5.5 y Fable 5.1.
Costo por tarea completada
Una API de modelo realmente no vende tokens. Los desarrolladores compran trabajo completado.
A un equipo de programación no le importa que un modelo haya consumido 6.2 millones de tokens. Le importa si el modelo arregló el bug, completó la migración, pasó la batería de pruebas o finalizó la tarea de investigación.
Anthropic hace este punto directamente en su análisis What a task costs on Opus 5.5: dos modelos con precios similares pueden tener costos de tarea muy diferentes si uno necesita más turnos, relee más contexto, reintenta más a menudo o genera más tokens de pensamiento.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Ese último elemento suele pasarse por alto. Un modelo más barato que falla dos veces puede resultar más caro que un modelo más costoso que completa la tarea en una sola ejecución. Del mismo modo, un nivel de esfuerzo alto que evita diez turnos de reintento puede, de hecho, reducir el costo total.
Economía del almacenamiento en caché del prompt
Los agentes intensivos en caché reutilizan repetidamente definiciones de herramientas, contexto del repositorio, instrucciones del sistema, historial de conversación y salida de pruebas. Dado que el precio de lectura de caché es $0.20/M para Opus 5.5 y $0.25/M para Fable 5.1, la brecha es mucho menor que la diferencia de $6/M en precio de entrada nueva. Por lo tanto, los equipos deben rastrear por separado entrada nueva, lecturas de caché, escrituras de caché, salida, turnos de herramientas y reintentos.
Economía por nivel de esfuerzo
Potencialmente, sí. Artificial Analysis probó cinco niveles de esfuerzo de Opus 5.5 y encontró una clara curva de capacidad-costo.
| Esfuerzo de Opus 5.5 | Índice de Inteligencia de Artificial Analysis | Costo por tarea del Índice |
|---|---|---|
| Bajo | 42 | $0.55 |
| Medio | 51 | $1.34 |
| Alto | 54 | $1.82 |
| Muy alto | 56 | $3.46 |
| Máximo | 58 | $5.98 |
El esfuerzo medio es un punto de partida sensato para cambios rutinarios de código, refactors conocidos y depuración supervisada. Alto o muy alto puede estar justificado para fallos de sistema ambiguos, migraciones nocturnas o tareas en las que un plan erróneo genera retrabajo sustancial.
Comparación de seguridad y fiabilidad
Ningún modelo debe etiquetarse como más seguro basándose únicamente en benchmarks de capacidad. Una comparación defendible requiere prompts, herramientas, permisos, niveles de esfuerzo, límites de reintentos y criterios de aceptación equiparados. Una mayor capacidad puede reducir errores accidentales, pero mayor autonomía y ejecuciones más largas también incrementan el impacto de un mal plan, un prompt injection, una llamada de herramienta insegura o una deriva inadvertida.
| Dimensión de seguridad | Comparación práctica | Control en producción |
|---|---|---|
| Razonamiento y esfuerzo | Opus 5.5 expone múltiples niveles de esfuerzo, mientras que Fable 5.1 parte de una postura de mayor esfuerzo. Más razonamiento no sustituye la aplicación de políticas. | Fija la política de esfuerzo por tipo de carga de trabajo y vuelve a probar el comportamiento de seguridad cada vez que cambie. |
| Autonomía de larga duración | Fable 5.1 está orientado a trabajo difícil y desatendido; Opus 5.5 también soporta flujos agentic. El riesgo crece con la duración, permisos y número de acciones irreversibles. | Usa checkpoints, compuertas de aprobación, techos de tiempo y costo y condiciones de rollback o apagado automático. |
| Uso de herramientas y del computador | Ambos modelos pueden operar herramientas, por lo que la elección del modelo por sí sola no controla la exposición de datos ni acciones destructivas. | Aplica mínimo privilegio, listas de permitidos, sandboxing, aislamiento de secretos y confirmación antes de acciones externas o irreversibles. |
| Evaluación y auditabilidad | Los puntajes públicos de benchmarks no establecen calidad de negativas, resistencia a prompt injection ni tasas de incidentes en producción. | Registra llamadas de herramientas y decisiones de política; mide la tasa de cumplimiento inseguro, negativas falsas, éxito de inyecciones, filtración de secretos, intentos destructivos y calidad de recuperación. |
Regla de seguridad práctica: comienza con la configuración de Opus 5.5 con el menor privilegio que cumpla la tarea y escala a Fable 5.1 solo después de que pase la misma batería de seguridad. Para flujos de alto impacto, exige aprobación humana independientemente de cuál modelo puntúe más alto en pruebas de capacidad.
- Ejecuta pruebas adversarias de prompt injection y exfiltración de datos con el conjunto real de herramientas de producción.
- Separa permisos de lectura, escritura, publicación, borrado y financieros en lugar de otorgar un rol de herramienta amplio.
- Define disparadores de rollback por violaciones de política, fallos repetidos de herramientas, expansión inesperada de alcance y sobrecostos.
- Revalida tras cambios en el modelo, prompt del sistema, nivel de esfuerzo, herramientas, permisos o ruteo.
Cómo elegir entre Opus 5.5 y Fable 5.1
| Carga de trabajo | Punto de partida recomendado | Condición de escalado |
|---|---|---|
| Programación diaria y code review | Opus 5.5, esfuerzo medio | Escala solo para casos inusualmente difíciles o de alto riesgo |
| Trabajo de funcionalidades multiarchivo | Opus 5.5, medio o alto | Usa Fable cuando fallos repetidos de planificación dominen el costo |
| Migración a escala de repositorio | Prueba primero Opus 5.5 alto o muy alto | Escala para los proyectos desatendidos más difíciles |
| Ejecuciones autónomas nocturnas | Opus 5.5 con checkpoints estrictos | Prefiere Fable cuando el costo de una dirección incorrecta es extremo |
| Tráfico API de alto volumen | Opus 5.5 | Escala solo la minoría de tareas propensas a fallar |
| Despliegue validado existente de Fable | Mantén el despliegue actual durante pruebas | Cambia solo después de que Opus cumpla los mismos umbrales de aceptación |
Una prueba práctica en producción
Ejecuta las mismas tareas representativas, prompts, herramientas, política de esfuerzo, criterios de aceptación y límites de reintento en ambos modelos. Registra tasa de tareas aceptadas, latencia, entrada nueva y en caché, tokens de salida y de pensamiento, llamadas de herramientas, reintentos, correcciones humanas y costo total por resultado aceptado. Incluye tareas rutinarias y casos difíciles de fallo.
Guía de migración para usuarios existentes de Claude Opus 5
Los usuarios actuales de Opus 5 deben probar Opus 5.5 como sucesor en lugar de asumir que cambiar el ID de modelo es libre de riesgos. Compara profundidad de planificación, patrones de llamadas a herramientas, longitud de respuesta, cumplimiento de formato, latencia, comportamiento del caché de prompts, recuperación de llamadas fallidas a herramientas, ruteo de seguridad y costo por tarea completada. Mantén criterios de rollback y el modelo existente disponible hasta que Opus 5.5 supere pruebas con aceptación similar a producción.
Los usuarios actuales de Fable 5.1 no necesitan una sección genérica de migración. En su lugar, deben tratar a Opus 5.5 como una posible optimización y evaluarlo bajo los mismos criterios de aceptación de producción antes de cambiar un despliegue validado.
Acceso mediante CometAPI
Los desarrolladores que evalúen cualquiera de los modelos pueden revisar las guías relacionadas de CometAPI para Claude Opus 5.5 y Claude Fable 5.1. Al integrar a través de cualquier proveedor de API compatible, confirma el ID exacto del modelo, parámetros de esfuerzo admitidos, comportamiento de caché, límites de tasa, disponibilidad regional y precio vigente antes del despliegue en producción.
Usa claude-opus-5-5 para Opus 5.5 y claude-fable-5-1 para Fable 5.1 donde se admitan esos identificadores. Evita enrutar silenciosamente ambas clases de carga de trabajo a un único nivel de esfuerzo fijo; la selección del modelo y la política de esfuerzo deben configurarse de forma independiente.
Python — API de Messages de Anthropic a través de CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Conclusión
Claude Opus 5.5 cambia el límite práctico entre el modelo de frontera diario de Anthropic y su capa premium de escalado. Es sustancialmente más barato a tarifas estándar por token, lidera muchos benchmarks publicados de programación y agentic, y ofrece suficiente flexibilidad de esfuerzo para cubrir un amplio rango de producción.
Claude Fable 5.1 sigue siendo relevante cuando la tarea es difícil, de alto valor, de larga duración o desatendida, y el costo del fallo supera la factura de inferencia más alta. Para la mayoría de los equipos, la mejor política es empezar con Opus 5.5, medir resultados por tarea completa y escalar selectivamente.
Preguntas frecuentes
¿Cómo deben diseñar los equipos una prueba A/B en producción para Opus 5.5 y Fable 5.1?
Usa las mismas tareas representativas, prompts, herramientas, política de esfuerzo, criterios de aceptación y límites de reintentos para ambos modelos. Registra la tasa de tareas aceptadas, latencia, entrada nueva y en caché, tokens de salida y de pensamiento, llamadas de herramientas, reintentos, correcciones humanas y el costo total por resultado aceptado. Ejecuta suficientes tareas para captar trabajo rutinario y casos difíciles de fallo.
¿Cuándo puede un precio de token más bajo no reducir el costo total por tarea?
Un modelo de menor precio puede aun así costar más si requiere más turnos, relee contexto adicional, produce más tokens de pensamiento o necesita reintentos repetidos. El comportamiento de caché también importa: la brecha de precio de entrada se reduce en sesiones largas dominadas por lecturas de caché. Compara el costo por tarea completa en lugar del precio de lista únicamente.
¿Qué se debe documentar cuando los resultados de los benchmarks discrepan?
Registra la versión del modelo, el nivel de esfuerzo, el arnés, la configuración de fallback y seguridad, el número de ensayos, la versión de la tarea, el error estándar y el límite de costo. Etiqueta cada resultado como oficial o independiente y evita combinar puntajes de configuraciones no equiparadas en una sola clasificación.
¿Qué riesgos de migración deben monitorear los usuarios actuales de Fable 5.1?
Observa cambios en la profundidad de planificación, patrones de llamadas a herramientas, longitud de respuesta, cumplimiento de formato, latencia, comportamiento del caché de prompts, recuperación de fallos, y ruteo de seguridad. Mantén el despliegue existente disponible durante la evaluación, establece criterios de rollback y migra solo después de que Opus 5.5 cumpla los mismos umbrales de aceptación en tareas similares a producción.
Metadatos SEO
Meta title: Claude Opus 5.5 vs Fable 5.1: Código, costo y benchmarks
Meta description: Compara Claude Opus 5.5 y Claude Fable 5.1 en benchmarks de programación, precios de API, velocidad, caché, niveles de esfuerzo, costo por tarea completada y ajuste al flujo de trabajo.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, benchmarks de programación de Claude, precios de la API de Claude, CometAPI, modelos de programación de IA
URL slug: claude-opus-5-5-vs-claude-fable-5-1