
TL;DR
Claude Opus 5.5 y Claude Sonnet 5.5 ofrecen contexto de 1M y salida estándar máxima de 128K, con entrada de texto e imagen y una fecha de corte de conocimiento en junio de 2026. Opus se orienta a trabajo complejo y abierto; Sonnet se orienta a ejecuciones más rápidas en tareas cotidianas bien delimitadas.
Con las tarifas estándar de la API de Anthropic, Sonnet 5.5 cuesta $2/M de entrada y $10/M de salida, exactamente la mitad de los $4/M de entrada y $20/M de salida de Opus 5.5. Varias puntuaciones publicadas son cercanas, pero el ranking varía según el benchmark. Opus puntúa más alto en CursorBench, mientras que Sonnet puntúa más alto en Terminal-Bench. Estos resultados usan configuraciones de esfuerzo diferentes y no deben tratarse como una comparación controlada cara a cara.
Elige el modelo que cumpla tus requisitos de calidad y latencia al menor costo total por tarea. Los equipos deberían comparar el costo por tarea aceptada, la latencia, el comportamiento de llamadas a herramientas, los reintentos y la cantidad de juicio requerida antes de decidir dónde Opus justifica su prima.
Puntos clave
- Precio: Sonnet 5.5 cuesta la mitad del precio estándar de entrada/salida de Opus 5.5.
- Especificaciones: Ambos admiten una ventana de contexto de 1M de tokens y hasta 128K de salida estándar.
- Programación: Opus lidera FrontierCode y CursorBench, mientras que Sonnet publica el resultado más alto en Terminal-Bench 4.0.
- Trabajo de conocimiento: Opus conserva una pequeña ventaja en GDPval-AA y AA-Briefcase.
- Despliegue: Prueba el más rápido Sonnet para ejecuciones delimitadas y Opus para escalamiento de complejidad; valida ambos frente a objetivos de calidad, latencia y costo.
Claude Opus 5.5 vs Sonnet 5.5 de un vistazo
| Factor de decisión | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Contexto / salida estándar máxima | 1M / 128K | 1M / 128K |
| Modalidades de entrada/salida | Texto + imagen -> texto | Texto + imagen -> texto |
| Razonamiento | Pensamiento adaptativo, siempre activado | Pensamiento adaptativo |
| Esfuerzo predeterminado en Platform Claude | Medio | Alto |
| Precio oficial entrada/salida | $4 / $20 por 1M | $2 / $10 por 1M |
| Lectura de caché | $0.20 / 1M | $0.10 / 1M |
| Latencia comparativa | Moderada | Rápida |
| Destacado en programación | FrontierCode 54.4%; CursorBench 57.8% | Terminal-Bench 70.6%; CursorBench 55.5% |
| Destacado en trabajo de conocimiento | GDPval-AA 1846 | GDPval-AA 1844 |
| Ajuste principal | Trabajo complejo, ambiguo y de larga duración | Trabajo de producción rápido, delimitado y repetible |
Claude Opus 5.5
Claude Opus 5.5 se lanzó el 22 de septiembre de 2026 como el primer modelo de la familia Claude 5.5. Anthropic lo posiciona para programación avanzada, agentes complejos, trabajo profesional de conocimiento y flujos de trabajo de larga duración donde preservar la intención a lo largo de muchos pasos importa más que la latencia mínima.
Su comportamiento operativo más distintivo es el pensamiento adaptativo siempre activado. Los desarrolladores pueden controlar el esfuerzo de razonamiento, pero el pensamiento adaptativo en sí no se puede desactivar. Esto hace que las pruebas de migración sean importantes para agentes antiguos que antes dependían de una ruta con el pensamiento desactivado o de diferentes valores predeterminados de esfuerzo.
La API de Claude Opus 5.5 en CometAPI proporciona una ruta unificada para el mismo ID de modelo, claude-opus-5-5, junto con otros modelos para enrutamiento de cargas de trabajo.
Claude Sonnet 5.5
Claude Sonnet 5.5 se lanzó el 28 de septiembre de 2026 como el segundo modelo de la familia Claude 5.5. Anthropic lo describe como un complemento más rápido y de menor costo que Opus 5.5 para trabajo cotidiano bien delimitado, incluyendo corrección de errores, creación de documentos, programación, agentes y tareas orientadas al diseño.
Anthropic informa que Sonnet 5.5 genera salida más de un 30% más rápido que Sonnet 5 y puede costar hasta un 30% menos por tarea que su predecesor. Estas son comparaciones reportadas por el proveedor con Sonnet 5, no relaciones de velocidad o costo por tarea medidas frente a Opus 5.5.
La API de Claude Sonnet 5.5 en CometAPI usa el ID de modelo claude-sonnet-5-5 y es adecuada para probar Sonnet como la capa de ejecución de menor costo en aplicaciones de modelos mixtos.
Claude Opus 5.5 vs Sonnet 5.5: Rendimiento
Los resultados publicados por Anthropic muestran pequeñas diferencias de puntuación en varias evaluaciones de trabajo de conocimiento y uso de computadoras. Opus reporta puntuaciones más altas en FrontierCode, CursorBench y Humanity’s Last Exam, mientras que Sonnet reporta una puntuación más alta en Terminal-Bench. Las comparaciones dependen de las configuraciones de esfuerzo y de las condiciones de evaluación.
| Benchmark | Claude Opus 5.5 | Claude Sonnet 5.5 | Qué mide |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 70.6% | Tareas de agente en línea de comandos |
| FrontierCode 1.1 Main | 54.4% | 46.2% (Max) | Ingeniería de software del mundo real |
| CursorBench 4.0 | 57.8% | 55.5% | Tareas de codificación ambiguas en múltiples archivos |
| GDPval-AA v2.1 | 1846 | 1844 | Trabajo profesional de conocimiento |
| AA-Briefcase v1.1 | 1822 | 1811 | Trabajo de conocimiento de largo horizonte |
| Humanity's Last Exam, tools | 67.7% | 64.5% | Razonamiento multidisciplinario |
| OSWorld 2.1 | 81.8% | 80.1% | Uso de computadoras |
| Chartography | 64.4% | 61.6% | Reconocimiento visual de gráficos |
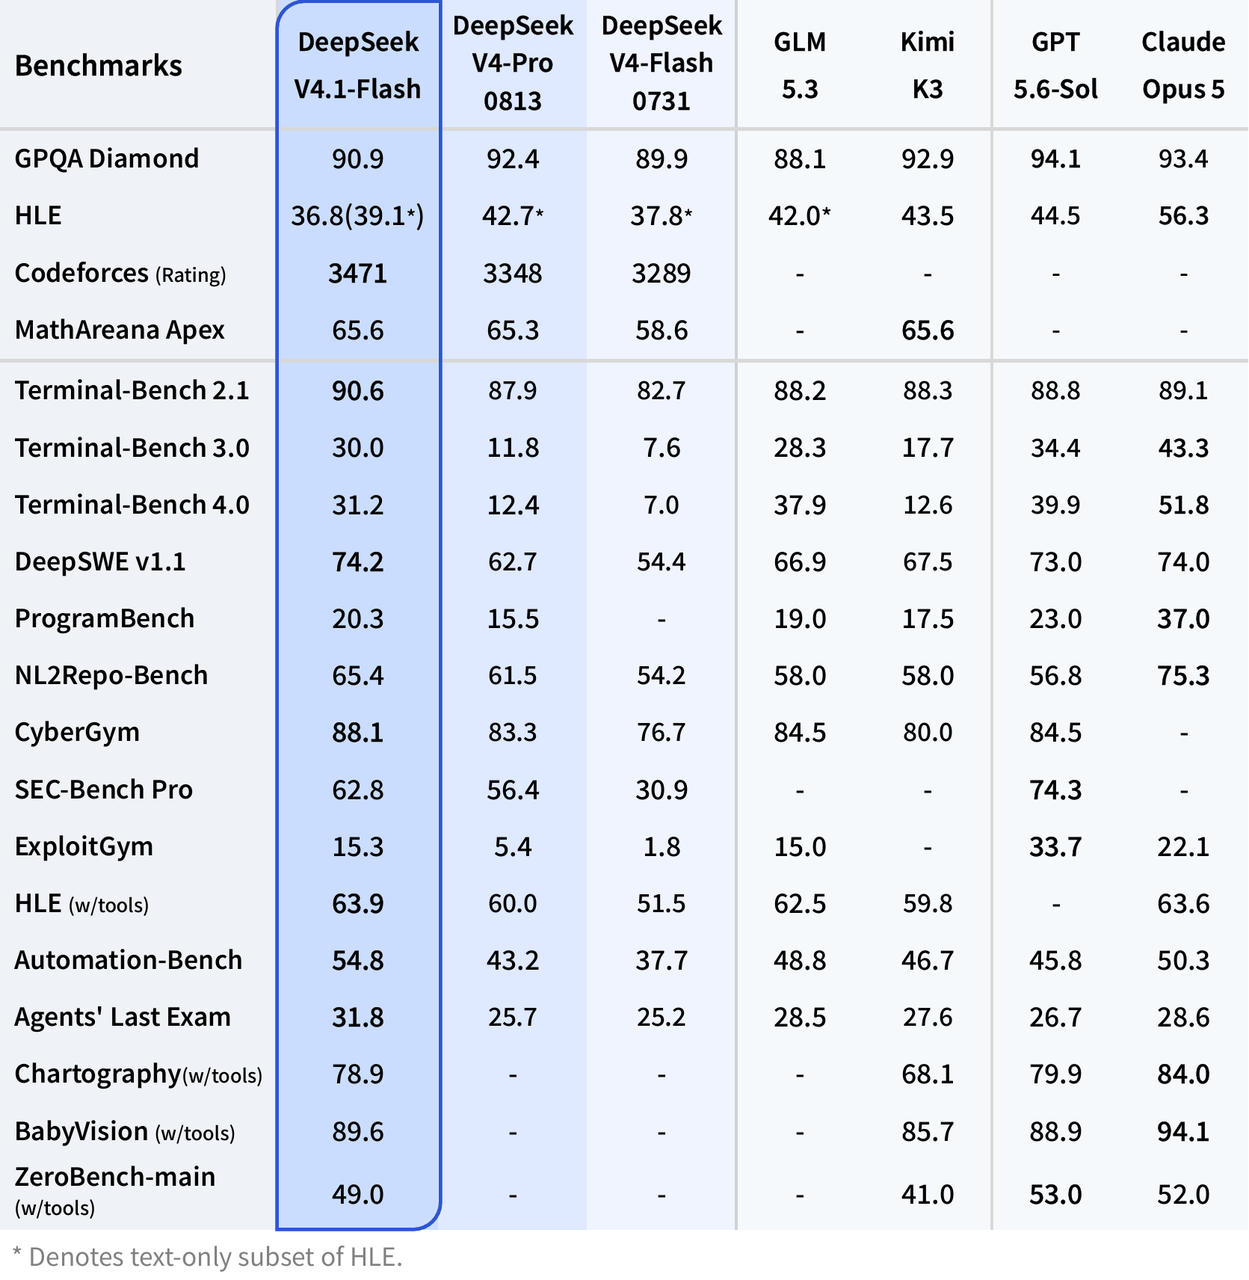
Estos son resultados publicados, no una comparación controlada realizada para este artículo.
- Esfuerzo: El resultado de Opus en Terminal-Bench usa Xhigh. La puntuación de Sonnet en FrontierCode es más alta en Xhigh que en Max.
- Puntuación y herramientas: OSWorld usa crédito parcial; los resultados de Chartography aquí no usan herramientas.
- Despliegue: Los resultados de Sonnet en GDPval-AA y AA-Briefcase se midieron en un despliegue de pre-lanzamiento con un error de salida estructurada que ya ha sido corregido.
Programación con agentes
El resultado de Sonnet 5.5 del 70.6% en Terminal-Bench 4.0 es superior a la puntuación reportada de Opus 5.5 del 66.4%, pero la nota oficial dice que el resultado de Opus es con esfuerzo Xhigh. En FrontierCode 1.1 Main, Opus lidera 54.4% frente al 46.2% (Max) de Sonnet; en CursorBench 4.0, Opus lidera 57.8% frente a 55.5%.
Esta división importa porque los benchmarks de agentes de programación premian comportamientos distintos. Terminal-Bench enfatiza la ejecución exitosa de múltiples pasos en un entorno de línea de comandos, mientras que CursorBench usa tareas ambiguas de múltiples archivos de sesiones reales de programación. Para codificación acotada y ejecución iterativa, Sonnet puede ser muy competitivo; para trabajo más amplio a escala de repositorio, Opus conserva evidencia más sólida en las evaluaciones publicadas por Anthropic.
Trabajo de conocimiento y razonamiento
En GDPval-AA v2.1, Sonnet 5.5 puntúa 1844 frente a 1846 de Opus 5.5. En AA-Briefcase v1.1 la diferencia es 1811 frente a 1822. Estos resultados son notables porque la brecha de precios es mucho mayor que la brecha de benchmarks.
Anthropic identifica a Opus 5.5 como más fuerte en trabajo complejo y abierto que requiere juicio sostenido. Para investigación, arquitectura y auditorías, prueba si ese comportamiento reduce decisiones incorrectas o corrección humana en tus propias tareas en lugar de inferir una ventaja económica a partir de márgenes pequeños en benchmarks.
Uso de computadoras y tareas visuales
En OSWorld 2.1, usando puntuación con crédito parcial, Opus puntúa 81.8% y Sonnet 80.1%. En Chartography sin herramientas, las puntuaciones son 64.4% y 61.6%, respectivamente. Para agentes de navegador o GUI, esto sugiere que la latencia, la eficiencia de llamadas a herramientas y el costo por tarea pueden importar tanto como la brecha principal del benchmark.
Interpretación de benchmarks
La historia del benchmark no es que Sonnet haya reemplazado a Opus. Es que Anthropic ha reducido lo suficiente la brecha de capacidades como para que ahora la forma de la carga de trabajo importe más que la categoría del modelo. Las tareas bien delimitadas y sensibles a la latencia favorecen cada vez más la economía de Sonnet, mientras que la ambigüedad, los horizontes largos y los modos de fallo costosos siguen siendo las razones más sólidas para probar Opus.
Claude Opus 5.5 vs Sonnet 5.5: Precios
Precios oficiales de la API de Claude
La especificación de precios de Opus y la especificación de precios de Sonnet distinguen tarifas estándar por token, ventanas de retención de caché y descuentos de Batch. Los precios a continuación son en USD por millón de tokens; confirme por separado los modificadores de servicio opcionales.
| Métrica de precios | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Entrada / 1M de tokens | $4.00 | $2.00 |
| Salida / 1M de tokens | $20.00 | $10.00 |
| Lectura de caché / 1M de tokens | $0.10 | $0.20 |
| Escritura de caché de 5 minutos / 1M de tokens | $5.00 | $2.50 |
| Escritura de caché de 1 hora / 1M de tokens | $8.00 | $4.00 |
| Entrada por lotes / 1M de tokens | $2.00 | $1.00 |
| Salida por lotes / 1M de tokens | $10.00 | $5.00 |
Sonnet tiene la mitad de las tarifas estándar de entrada, salida y escritura de caché.
Las lecturas de caché siguen la misma relación de precio 2:1: Sonnet 5.5 cuesta $0.10/M de entrada en caché, mientras que Opus 5.5 cuesta $0.20/M. La reutilización de prefijos en caché reduce los costos de entrada para ambos modelos manteniendo la tarifa por token más baja de Sonnet. Los ahorros totales por tarea aún dependen de la longitud de la salida, las escrituras de caché, los reintentos y la tasa de aceptación.
Costo por tarea aceptada
Como ilustración simple, una solicitud con 100K tokens de entrada sin caché y 10K tokens de salida cuesta alrededor de $0.60 en Opus 5.5 y $0.30 en Sonnet 5.5 a tarifas estándar. Pero una diferencia de tarifa por token de 2x no garantiza una diferencia de 2x en el costo por éxito. Los reintentos, las llamadas a herramientas, la longitud de salida, los aciertos de caché, los intentos fallidos y la corrección humana pueden cambiar el resultado.
Por lo tanto, las evaluaciones en producción deberían registrar el costo por tarea aceptada junto con la tasa de finalización, la latencia p50/p95, los reintentos, las llamadas a herramientas y la intervención humana.
Precios de CometAPI
El catálogo de modelos de CometAPI anuncia un descuento del 20% en muchas rutas de Anthropic compatibles. Para la API de Claude Opus 5.5 en CometAPI, el precio de catálogo referenciado es $3.20/M de entrada y $16/M de salida. Para la API de Claude Sonnet 5.5 en CometAPI, los datos localizados del catálogo muestran $1.60/M de entrada y $8/M de salida. Debido a que el precio del gateway puede cambiar, confirme la ruta de modelo activa antes de presupuestar tráfico de producción.
| Tarifa de CometAPI | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Entrada / 1M | $3.20 | $1.60 |
| Salida / 1M | $16.00 | $8.00 |
| Descuento relativo vs oficial | 20% | 20% |
Claude Opus 5.5 vs Sonnet 5.5: Especificaciones técnicas
Ambos modelos comparten el contexto y los límites de salida principales mostrados en la tabla de un vistazo. El límite adicional de 300K de salida es una capacidad beta de Batch API, en lugar del límite estándar de salida interactiva.
La longitud de contexto no es el factor diferenciador entre estos dos modelos. Ambos admiten la misma ventana de 1M de tokens y un techo de salida estándar de 128K. Las diferencias más significativas son el comportamiento de razonamiento, la velocidad y cuánta toma de decisiones difícil requiere la tarea.
La mejora de velocidad de salida reportada de Sonnet es relativa a Sonnet 5. Opus también tiene Fast mode con hasta 2.5x de rendimiento de tokens de salida, con precio de $8/M de entrada y $40/M de salida. Es una vista previa de investigación en la API de Claude; esto no garantiza tareas de extremo a extremo 2.5x más rápidas ni menor tiempo al primer token.
Divulgación de arquitectura y comportamiento de integración
Los materiales citados no revelan recuentos de parámetros ni detalles internos de arquitectura suficientes para una comparación defendible entre denso y MoE. Compare en su lugar las interfaces y el comportamiento documentados. Ambas migraciones requieren probar las restricciones de elección de herramientas y el pensamiento preservado; el pensamiento adaptativo de Opus no puede desactivarse. Valide el estado de la conversación al enrutar entre modelos en lugar de reenviar bloques de pensamiento opacos sin verificar la compatibilidad.
Claude Opus 5.5 vs Sonnet 5.5: Casos de uso
Una estrategia de despliegue útil es tratar a Sonnet 5.5 como el modelo de ejecución predeterminado y a Opus 5.5 como un modelo de escalamiento. Esto puede reducir el gasto en tareas bien especificadas y repetibles mientras se reserva Opus para trabajo que se beneficia del juicio sostenido. Los ahorros dependen de la tasa de aceptación de Sonnet y de la frecuencia con que las tareas necesiten escalamiento.
Selección basada en la carga de trabajo
| Carga de trabajo | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Programación rutinaria | Capaz, mayor costo | Muy adecuado |
| Corrección de errores | Útil para casos difíciles | Muy adecuado |
| Tráfico de API de gran volumen | Mayor costo unitario | Muy adecuado |
| Generación de documentos/diapositivas | Fuerte | Más económico |
| Subagentes de programación | Usar selectivamente | Muy adecuado |
| Migración a escala de repositorio | Muy adecuado | Probar para trabajo acotado |
| Arquitectura ambigua | Muy adecuado | Depende de la complejidad |
| Agentes autónomos de larga duración | Muy adecuado | Buena capa de ejecución |
| Investigación/análisis difíciles | Muy adecuado | Bueno para trabajo acotado |
| UX sensible a la latencia | Moderado | Muy adecuado |
| Carga de trabajo mixta en producción | Modelo de escalamiento | Modelo de ejecución predeterminado |
Un enrutador práctico puede empezar con Sonnet y escalar cuando la tarea cruce un umbral de ambigüedad, longitud del bucle de herramientas, fallos repetidos o impacto en el negocio. La regla de enrutamiento debe validarse con tareas similares a producción en lugar de asumirse a partir de puntuaciones de benchmarks.
Cómo invocar Opus 5.5 y Sonnet 5.5 a través de CometAPI
Cree una clave de API de CometAPI y configure un cliente compatible con Anthropic para usar el endpoint de CometAPI. Elija el ID de modelo para la tarea, envíe su prompt a través de Messages API y lea la respuesta de texto. Al comparar los modelos, mantenga constantes el prompt, el límite de salida, las herramientas y los criterios de aceptación, y registre el esfuerzo de razonamiento efectivo.
Ejemplo de Opus 5.5
Para una revisión de un plan de migración, seleccione claude-opus-5-5 y pida al modelo que identifique los pasos de mayor riesgo, explique su impacto y sugiera salvaguardas. Envíe la solicitud a través de Messages API de CometAPI y revise el texto devuelto.
Ejemplo de Sonnet 5.5
Para la misma revisión de plan de migración, seleccione claude-sonnet-5-5 y envíe el mismo prompt y límite de salida a través de CometAPI. Compare la respuesta contra los mismos criterios de aceptación, luego registre la latencia, los reintentos y el costo real antes de decidir qué modelo encaja con la carga de trabajo.
Para el enrutamiento en producción, mantenga ambos IDs de modelo detrás de la misma interfaz de aplicación y registre la calidad de finalización, la latencia, los reintentos y el costo realmente facturado. Evite escalar únicamente porque un prompt es largo; la ambigüedad y el costo del fallo suelen ser mejores señales.
Conclusión
Claude Opus 5.5 y Sonnet 5.5 ahora comparten casi el mismo sobre de capacidades técnicas, por lo que la elección del modelo se centra cada vez más en la economía y el comportamiento de la carga de trabajo más que en el tamaño del contexto. Sonnet combina una ejecución más rápida y tokens estándar a mitad de precio con un rendimiento en benchmarks que a menudo está cerca del de Opus.
Opus se vuelve más valioso a medida que aumentan la ambigüedad, la duración de la tarea y el costo de una decisión errónea. Su valor tiene menos que ver con tener una ventana de contexto más grande y más con sostener el juicio en flujos de trabajo difíciles y abiertos.
Para muchos equipos de producción, la arquitectura más eficiente usará ambos: Sonnet para la mayoría de trabajo repetible y Opus para el subconjunto de tareas donde un razonamiento más fuerte reduce mediblemente fallos, reintentos o intervención humana.
Preguntas frecuentes
¿Cómo debe un enrutador de Claude 5.5 evitar bucles de escalamiento costosos?
Establezca un número máximo de intentos y un presupuesto antes de la ejecución. Escale después de un fallo reproducible, evidencia faltante o una puerta de calidad específica de la tarea, en lugar de después de cada respuesta incierta. Registre qué fallo activó Opus y si mejoró el resultado aceptado. Si ninguno de los modelos pasa, devuelva el problema no resuelto para revisión en lugar de reintentar indefinidamente.
¿Cómo se pueden comparar de forma justa Opus y Sonnet en una misma carga de trabajo?
Use el mismo corpus de tareas, herramientas disponibles, evidencia de entrada, límite de salida y rúbrica de puntuación. Registre el esfuerzo efectivo y pruebe ejecuciones con caché fría y caché caliente por separado. Revise resultados sin revelar el modelo cuando sea posible. Informe la tasa de aceptación y el costo total incluyendo intentos no exitosos; precios de token iguales o un solo benchmark no establecen un valor igual.
¿Qué se debe conservar al cambiar de modelo Claude 5.5 a mitad de tarea?
Conserve las instrucciones del usuario, la evidencia relevante, los resultados de herramientas y un resumen explícito del progreso. Trate el estado de pensamiento opaco como específico del modelo y de la conversación; no asuma que puede reproducirse entre rutas. Pruebe el comportamiento de traspaso compatible con el proveedor antes de producción, especialmente si el flujo de trabajo mezcla cuentas, gateways o SDKs.
¿Cuándo se debe reevaluar la elección de un modelo Claude 5.5?
Vuelva a ejecutar las pruebas de aceptación afectadas después de una corrección de despliegue, cambio de enrutamiento, cambio de precio, cambio de herramientas o actualización material del prompt. Mantenga la ejecución anterior como línea base y registre fecha, ID de modelo, endpoint, configuración y versión del arnés. Esto distingue un cambio de modelo de los cambios en la aplicación circundante.