
TLDR: DeepSeek-V4.1-Flash-1017 es una actualización menor pero de gran impacto del 17 de octubre de 2026 del modelo V4.1-Flash de DeepSeek. Ofrece mejores resultados en benchmarks de razonamiento, programación, capacidades de agente y visión, a la vez que produce salidas más cortas y completa tareas más rápido, avanzando la frontera de Pareto rendimiento-costo.
Puntos clave
- DeepSeek-V4.1-Flash-1017 Publicado el 17 de octubre de 2026 como una actualización gratuita del endpoint de API existente
deepseek-flash, sin necesidad de cambios de código para los usuarios actuales. - Mejoras informadas por el proveedor en los 11 benchmarks listados frente al V4.1-Flash de septiembre, con los mayores saltos en tareas de agentes y de programación.
- Arquitectura: Mixture-of-Experts de 552B parámetros con diseño Causal Encoder-Decoder (≈8B parámetros activos en entrada/prefill, 16B en decodificación/salida); ventana de contexto de 1M tokens; hasta 384K tokens de salida; compatibilidad nativa con visión.
- Precios sin cambios: Off-peak $0.15 / $0.60 por 1M tokens de entrada (fallo de caché) / salida (peak duplica estas tarifas); aciertos de caché tan bajos como $0.003. CometAPI tiene un precio un 20% inferior a la tarifa oficial.
- Nuevas APIs Search y Fetch abiertas a todos los desarrolladores ($0.75 por 1,000 llamadas; gratis a través de ciertas herramientas del lado del servidor hasta el 31 de octubre de 2026).
- Sólidas capacidades de “wish-driven programming” para generación de proyectos de extremo a extremo (juegos, escenas 3D, repos completos). Competitivo frente a modelos cerrados más grandes en benchmarks de agentes/código, y aun así mucho más barato y rápido para muchas cargas de trabajo en producción.
- Pesos de código abierto bajo licencia MIT en Hugging Face ](https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017)y ModelScope que habilitan autoalojamiento y fine-tuning.
- Para producción, plataformas como CometAPI ofrecen acceso compatible con OpenAI a modelos DeepSeek junto con más de 500 otros, a menudo con precios competitivos y conmutación simplificada.
DeepSeek sigue ampliando los límites de modelos de IA eficientes y de alto rendimiento. El 17 de octubre de 2026, la compañía lanzó DeepSeek-V4.1-Flash-1017, una actualización focalizada de su modelo V4.1-Flash (lanzado originalmente el 10 de septiembre de 2026). Comercializado como un avance sustancial en razonamiento, programación, capacidades agenticas y comprensión visual—mientras reduce el tiempo de ejecución de tareas y la longitud de las salidas—este checkpoint se posiciona como el modelo eficiente más potente de DeepSeek hasta la fecha para cargas de trabajo reales de agentes y programación.
El modelo está disponible en el sitio web de DeepSeek, la app móvil y la API (aún llamada simplemente deepseek-flash). Los pesos se publican abiertamente bajo licencia MIT, lo que lo convierte en una de las opciones de pesos abiertos más sólidas para desarrolladores que buscan rendimiento de nivel frontera sin costos de nivel frontera.
¿Qué es exactamente DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017 es un checkpoint fechado (“1017” se refiere a la publicación del 17 de octubre) de la familia V4.1-Flash. DeepSeek lo describe como una “actualización menor”, pero las mejoras son amplias y significativas: puntuaciones más altas en todas las categorías de benchmarks reportadas, tareas completadas más rápido y salidas más cortas. La empresa lo presenta como una mejora de Pareto real: mejor rendimiento y mejor eficiencia de costos simultáneamente.
Hereda la arquitectura innovadora introducida con V4.1-Flash:
- Diseño Mixture-of-Experts (MoE) con aproximadamente 552B parámetros totales del backbone (más parámetros Engram adicionales en algunos informes). Nueva arquitectura Causal Encoder-Decoder que activa solo ~8B parámetros por token durante el prefill/procesamiento de entrada y ~16B durante la decodificación/generación de salida.
- Caché KV altamente comprimido (reducciones afirmadas de 1/4 en HBM y 1/8 en almacenamiento SSD frente a generaciones anteriores), lo que reduce drásticamente el costo de contextos largos e interacciones de agentes multi-turno.
- Compatibilidad multimodal nativa (entrada de texto + imagen → salida de texto). Ventana de contexto de 1 millón de tokens y longitud máxima de salida de 384K tokens (el muestreo recomendado a menudo usa ≥256K tokens máximos).
- Soporte para modos de pensamiento/sin pensamiento, llamadas a herramientas, salida JSON y esfuerzo de razonamiento ajustable.
El modelo se entrenó con técnicas de refuerzo mejoradas, incluyendo bucles de auto-feedback dirigidos específicamente a mejorar el desarrollo de proyectos de extremo a extremo. Esto permite una “programación wish-driven” más fiable—convertir objetivos de lenguaje natural de alto nivel en proyectos completos y funcionales, como juegos web, escenas 3D o repositorios de código completos.
Para un desarrollador de aplicaciones, esto cambia la pregunta de evaluación. En lugar de comprobar si el modelo puede producir una función plausible, evalúe si puede entender una base de código existente, realizar ediciones coordinadas, ejecutar verificaciones y reparar errores. Una demostración convincente establece una capacidad digna de prueba; no establece fiabilidad en repositorios arbitrarios.
La actualización también hace que valga la pena medir la eficiencia de la salida por separado de la calidad de la respuesta. Una respuesta más corta puede reducir el costo de generación, pero solo si preserva la implementación, explicación o evidencia que la tarea requiere. Eliminar validaciones útiles sería una regresión incluso si la factura de tokens disminuye.
Especificaciones de la API de DeepSeek V4.1-Flash-1017
| Especificación | DeepSeek V4.1-Flash-1017 |
|---|---|
| Identificador nativo de API | deepseek-flash |
| Ventana de contexto | 1M tokens |
| Salida máxima | 384K tokens |
| Compatibilidad de entrada | Texto e imágenes |
| Modos de razonamiento | Con pensamiento y sin pensamiento |
| Funciones para desarrolladores | Llamadas a herramientas, salida JSON, Responses API |
| Arquitectura | Causal Encoder–Decoder MoE |
| Recuento de parámetros anunciado | 552B |
| Par\u00e1metros activos | 8B para entrada; 16B para salida |
¿Cómo rinde DeepSeek V4.1-Flash-1017 en benchmarks?
Pruebas independientes tempranas (por ejemplo, codo a codo con DeepSeek V4 Pro) han mostrado que 1017 iguala la calidad en tareas prácticas siendo significativamente más rápido y barato, además de añadir soporte de visión que Pro no tenía en algunas configuraciones.
Los resultados seleccionados reportados por el proveedor comparan la versión de septiembre con la actualización del 17 de octubre.
| Resultados oficiales de benchmark | Versión de septiembre | Actualización del 17 de octubre | Cambio absoluto (puntos) |
|---|---|---|---|
| HLE sin herramientas | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
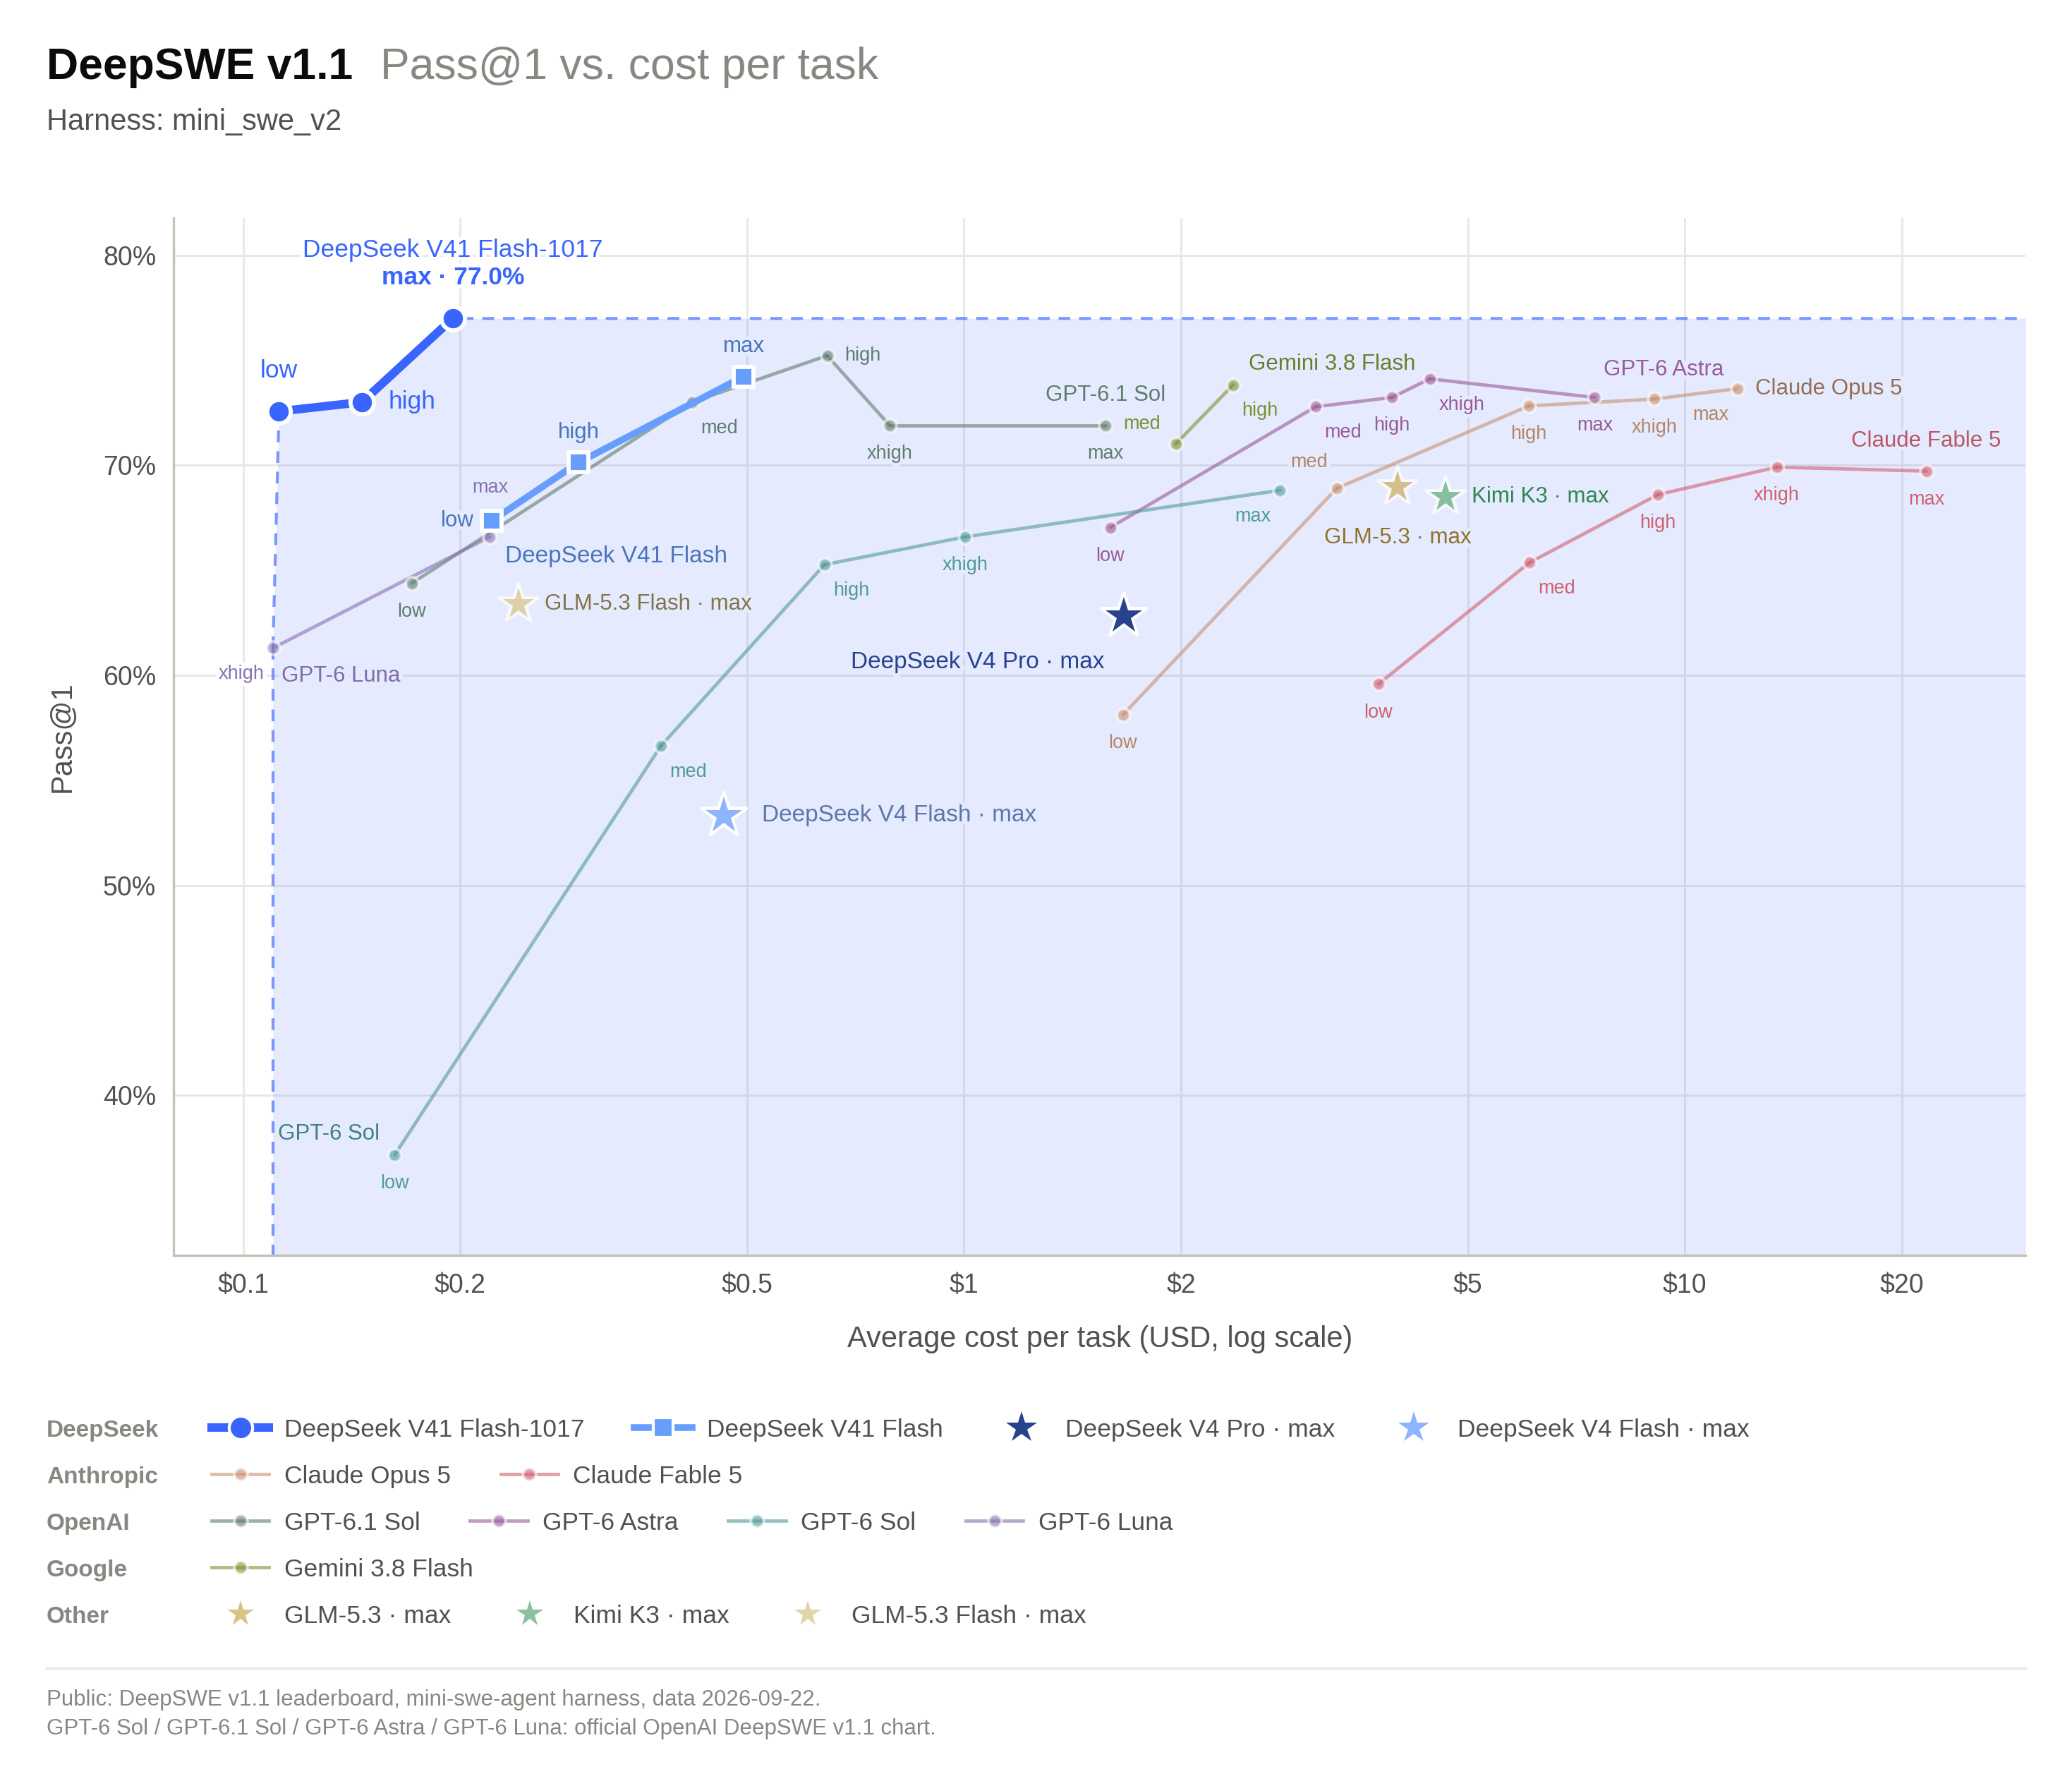
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography con herramientas | 78.9 | 83.0 | +4.1 |
Estos son resultados reportados por el proveedor, no replicaciones independientes. DeepSeek usó Claude Code para Terminal-Bench 4.0 y Mini-SWE-V2 para DeepSWE v1.1. HLE se reporta sin herramientas y utiliza las puntuaciones principales en lugar del subconjunto solo texto marcado por separado; Chartography usa herramientas. La tabla de lanzamiento citada no proporciona una configuración completa por fila para todos los demás benchmarks, por lo que no se pueden asumir presupuestos de razonamiento, hardware y condiciones de parada equivalentes. Los cambios anteriores son diferencias simples de puntuación, no mejoras porcentuales relativas.
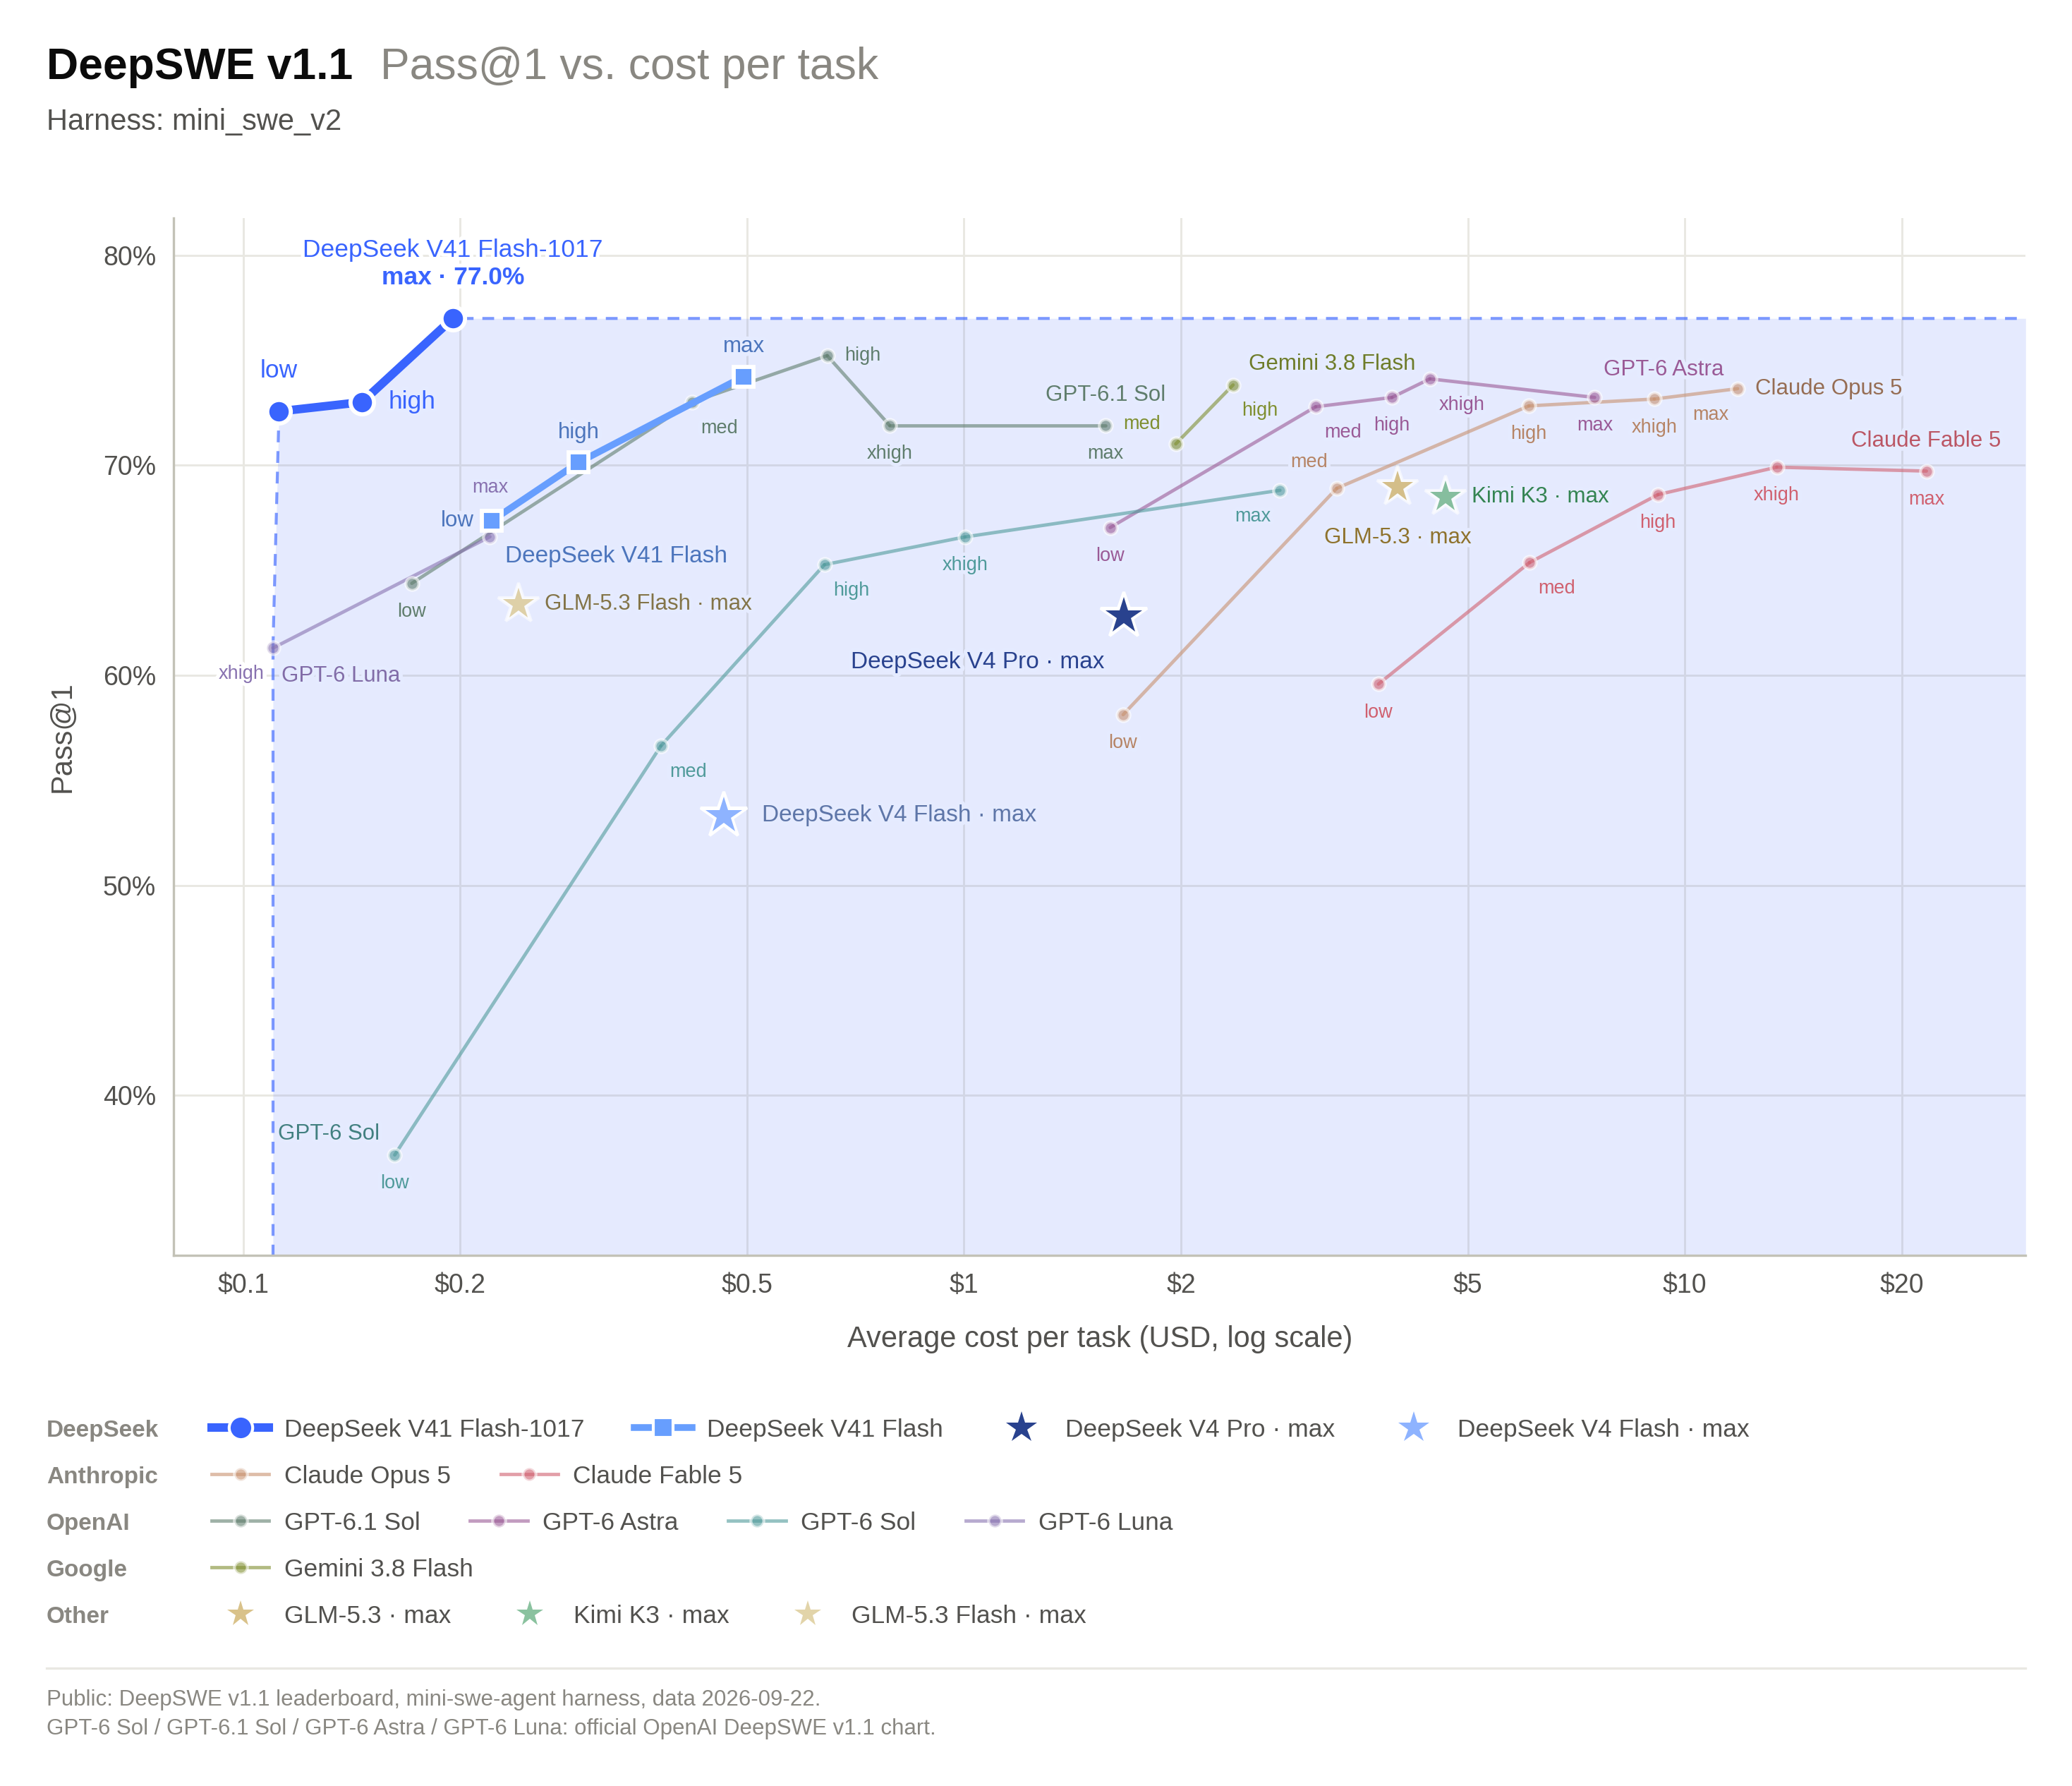
El gráfico de rendimiento versus costo de DeepSWE v1.1 de DeepSeek traza Pass@1 frente al costo promedio por tarea en USD en un eje logarítmico, usando el arnés Mini-SWE-V2. Diferentes configuraciones de razonamiento aparecen como puntos separados; compare una tasa de éxito y configuración adecuadas antes de sacar una conclusión de costo.
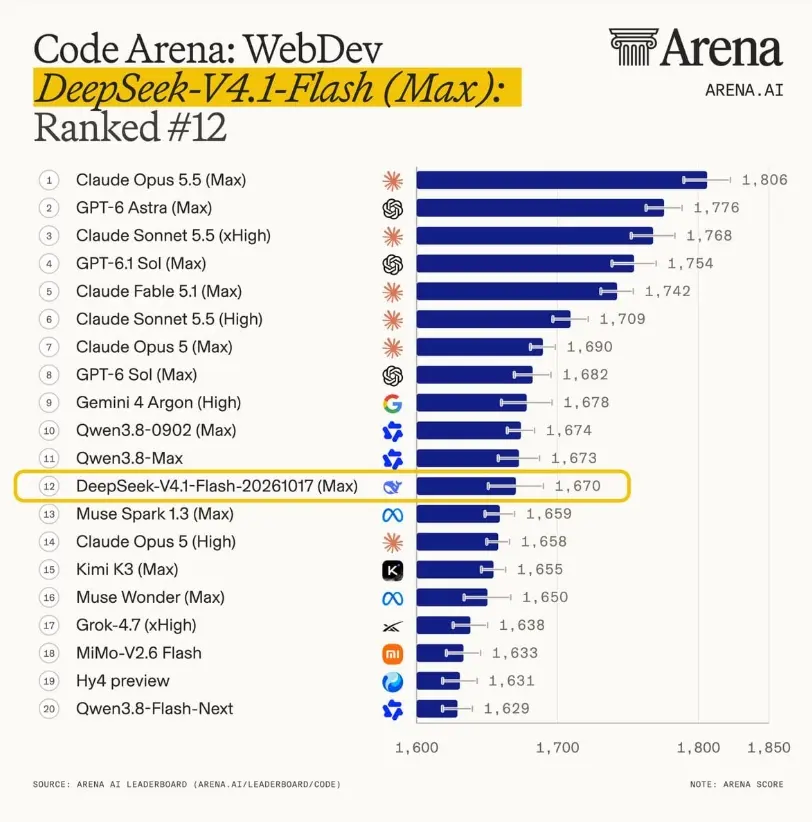
Code Arena: WebDev Leaderboard – Modelo de código abierto líder
En la evaluación más reciente del benchmark de frontera en programación y desarrollo web WebDev, DeepSeek-V4.1-Flash-1017 no solo ha superado al muy valorado Kimi K3 (Max), sino que también ha logrado una mejora de un orden de magnitud en la eficiencia de costo de inferencia, con un gasto operativo aproximadamente una décima parte del de su contraparte. DeepSeek-V4.1-Flash-20261017 (Max) ha reclamado oficialmente el primer puesto en el Code Arena: WebDev leaderboard, ganando el título de “modelo número uno de código abierto”.
En la clasificación general, el modelo aseguró el puesto 12 con una puntuación de 1670. En este nivel de alto ranking, supera al modelo cerrado líder, Claude Opus5 (High), y ha reducido la brecha con el modelo de primera línea, GPT-6Sol (Max), a menos de 10 puntos.
¿Cómo se compara la actualización de octubre con la versión de septiembre?
Comparado con la versión de septiembre, la actualización del 17 de octubre muestra sus mayores avances en los benchmarks de programación seleccionados: Terminal-Bench 4.0 sube de 31.2 a 42.3 (+11.1 puntos), mientras que ProgramBench aumenta de 20.3 a 29.1 (+8.8 puntos). DeepSWE v1.1 mejora de 74.2 a 77.0 (+2.8 puntos). Estos resultados reportados por el proveedor respaldan evaluar la actualización para flujos de trabajo en terminal y tareas de programación más amplias; no implican ganancias de productividad equivalentes en todas las bases de código.
El lanzamiento también pone mayor énfasis en el desarrollo de proyectos completos mediante aprendizaje por refuerzo con auto-feedback. La velocidad y el ahorro de tokens siguen dependiendo de la tarea, como muestran los dos ejemplos de la siguiente sección. Para integraciones nativas existentes, el identificador del modelo sigue siendo deepseek-flash. La decisión práctica de actualización debe basarse en la aceptación de tareas completadas, costo total y tiempo end-to-end medidos en trabajo representativo.
¿Cuánto cuesta DeepSeek V4.1-Flash-1017?
Su ventaja de costo es enorme: Flash suele ser 10–40× más barato por token que los principales modelos cerrados, y las salidas más cortas amplifican el ahorro en agentes de múltiples pasos. Frente a su predecesor, 1017 es estrictamente mejor en las métricas reportadas manteniendo el mismo precio, lo que lo convierte en una mejora pura.
USD por millón de tokens, según el artículo fuente del 19 de octubre de 2026. Las tarifas pico de CometAPI aplican su multiplicador publicado de 2×.
| Categoría de tokens | DeepSeek nativo: off-peak | DeepSeek nativo: peak | DeepSeek V4.1 Flash API en CometAPI: base | CometAPI: ventana 2× |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Entrada, fallo de caché | $0.15 | $0.30 | $0.12 | $0.24 |
| Salida | $0.60 | $1.20 | $0.48 | $0.96 |
Ambos proveedores listan ventanas pico entre semana de 01:00–04:00 y 06:00–10:00 UTC. DeepSeek excluye los festivos chinos; las condiciones mostradas por CometAPI no especifican esa exención. Las demás horas usan tarifas off-peak/base. La columna 2× de CometAPI se calcula a partir de sus precios base publicados.
Para la API nativa de DeepSeek, 10 millones de tokens de entrada sin caché más 2 millones de tokens de salida cuestan:
- Off-peak: (10 × $0.15) + (2 × $0.60) = $2.70.
- Peak: (10 × $0.30) + (2 × $1.20) = $5.40.
Para un presupuesto piloto, divida todos los cargos de tokens y herramientas entre todos los intentos por tareas aceptadas. Incluya la reutilización de caché y las ventanas pico; informe los costos de infraestructura y revisión humana por separado. Los ejemplos anteriores cubren solo tokens del modelo.
Cargos de Search y Fetch
Las APIs Search y Fetch de DeepSeek cuestan $0.75 por 1,000 solicitudes correctas. Su facturación está separada del uso de tokens del modelo; solicitudes fallidas, resultados vacíos y timeouts no se cobran según las reglas documentadas.
Para usuarios de la API de DeepSeek, las llamadas de Search y Fetch del lado del servidor a través de DeepSeek Harness, Claude Code y Codex son temporalmente gratuitas bajo la política oficial de facturación. La facturación para esas llamadas comienza el 31 de octubre de 2026 a las 16:00 UTC, equivalente al 1 de noviembre a medianoche en Beijing. Esta exención limitada no hace gratuitas todas las solicitudes independientes de las APIs Search y Fetch.
¿DeepSeek V4.1-Flash-1017 siempre es más rápido y barato?
No. La prueba de dos tareas de EmpirioLabs encontró menor tiempo y uso de tokens de salida para una animación de acuario, pero valores más altos para una animación de skyline:
| Pruebas de programación de primera mano de EmpirioLabs | Versión de septiembre | Actualización del 17 de octubre | Resultado observado |
|---|---|---|---|
| Tiempo de finalización (Acuario) | 162 seconds | 124 seconds | Actualización de octubre más rápida |
| Tokens de salida (Acuario) | 41,833 | 33,149 | Actualización de octubre usó menos |
| Tiempo de finalización (Skyline) | 163 seconds | 177 seconds | Actualización de octubre más lenta |
| Tokens de salida (Skyline) | 37,928 | 42,907 | Actualización de octubre usó más |
Ambas versiones produjeron animaciones funcionales en estas pruebas en la plataforma de API de EmpirioLabs el 18 de octubre de 2026. Cada tarea usó el mismo prompt y solicitó un archivo HTML autocontenido con CSS y JavaScript en línea, sin bibliotecas ni assets externos. Ambos modelos corrieron con ajustes predeterminados, pensamiento habilitado en su presupuesto por defecto, y un límite de salida de 65,536 tokens. Se ejecutaron en paralelo para cada tarea, con un intento por modelo. Los tiempos cubren toda la solicitud; los conteos de tokens de salida, incluyendo tokens de razonamiento, provienen de informes de uso de la API. Las capturas de pantalla se renderizaron en un navegador headless tras seis segundos. Estos dos ejemplos ilustran la variación según la carga de trabajo más que establecer un ranking general.
¿Cómo puedes acceder a DeepSeek V4.1-Flash-1017?
- API oficial de DeepSeek — Use el nombre de modelo
deepseek-flashen https://api.deepseek.com. - Pesos abiertos — Descargue desde Hugging Face o ModelScope para autoalojamiento y fine-tuning.
- CometAPI — CometAPI Adds DeepSeek-V4.1-Flash-1017 Ver detalles del modelo ID del modelo: deepseek-v4.1-flash-1017
Use la API nativa de DeepSeek
El inicio rápido de la API de DeepSeek y CometAPI confirman que deepseek-flash ahora sirve la versión del 17 de octubre, sin cambios en el método de llamada.
Envíe una solicitud de planificación de proyecto a través de la API con Python. Instale el paquete OpenAI para Python y configure API_KEY en su entorno antes de ejecutar el ejemplo.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
Esto produce una respuesta del modelo. Para construir y validar un proyecto automáticamente, un entorno de agente debe además proporcionar acceso a archivos, ejecución de comandos, retroalimentación de pruebas y permisos apropiados.
[CometAPI] Recomendación: CometAPI ya lista varios modelos DeepSeek y es una excelente manera de probar V4.1-Flash-1017 junto con Claude, GPT, Gemini, Grok y modelos especializados de programación/visión sin quedar atado a un solo proveedor. Regístrese y obtenga una clave de API, y apunte su SDK de OpenAI existente a la URL base de CometAPI. Este enfoque es especialmente potente para frameworks de agentes que se benefician de enrutar diferentes subtareas al modelo más rentable o de mayor rendimiento disponible.
Conclusión
DeepSeek-V4.1-Flash-1017 representa un avance inteligente y eficiente en capacidades de IA abierta. Al mejorar el rendimiento en benchmarks críticos de agentes y programación mientras reduce la longitud de la salida y el tiempo de tarea—todo a precios bajos sin cambios—fortalece la posición de DeepSeek como líder en rendimiento por dólar. Ya sea que esté construyendo agentes de software autónomos, aplicaciones multimodales o sistemas de producción optimizados en costos, este modelo merece una evaluación seria.
Combinado con capas de acceso convenientes como CometAPI, los desarrolladores pueden integrar modelos de vanguardia como V4.1-Flash-1017 en flujos de trabajo robustos de múltiples proveedores con fricción mínima. A medida que continúan emergiendo evaluaciones independientes y madura el ecosistema de herramientas (Harness, CodeBuddy, etc.), es de esperar que este checkpoint se convierta en la opción predeterminada para muchas cargas de trabajo de alto volumen y alta inteligencia a finales de 2026 y más allá.