Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Eleven v4 vs. Eleven v4 Turbo: ¿Cuál deberías elegir?
Compare Eleven v4 y v4 Turbo en calidad de voz, latencia, precios de la API, streaming y acceso a CometAPI. Elija el modelo adecuado para contenido o agentes.
Deon GoodwinEquipo de investigación de modelos de IA y API
Elija Eleven v4 para audiolibros, narración y actuaciones de personajes donde la calidad de producción tenga prioridad. Elija Eleven v4 Turbo para agentes de voz y aplicaciones interactivas donde importe el tiempo de respuesta. ElevenLabs afirma que ambos comparten el mismo rango expresivo; la tarifa publicada por carácter de la API de Turbo es un 50% inferior. Tome la decisión final usando sus propios guiones, pruebas de escucha y mediciones de latencia de extremo a extremo.
Key Takeaways
Para audio producido: comience con la variante estándar y evalúe la entrega, la consistencia y el esfuerzo de edición.
Para interacción en tiempo real: comience con Turbo y mida el tiempo total desde la entrada del usuario hasta la respuesta audible.
En cuanto al costo: la tarifa publicada por carácter de Turbo es un 50% menor, antes de considerar reintentos u otros servicios.
Para benchmarks: los resultados de preferencia publicados comparan el modelo estándar con sistemas competidores; no establecen un margen de calidad directo sobre Turbo.
Narración producida, audiolibros y actuaciones de personajes
Agentes en tiempo real y voz interactiva
Model ID
eleven_v4
eleven_v4_turbo
Idiomas
90+
90+
Precio nativo
$0.08 / 1,000 characters
$0.04 / 1,000 characters
Latencia mediana de inferencia
No se identificó una cifra directamente comparable
~100 ms
Mediana del tiempo hasta el primer habla
No se identificó una cifra comparable
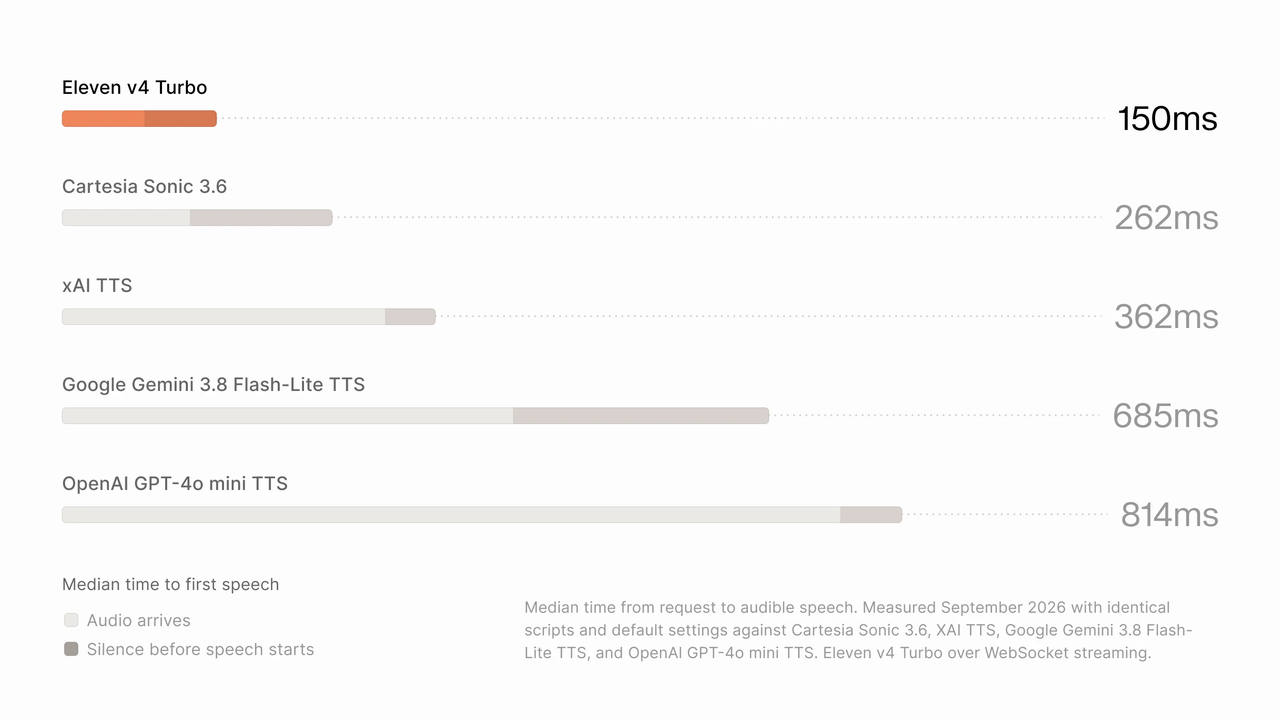
~150 ms de tiempo mediano de solicitud a habla audible por WebSocket; latencia de red excluida
Voces registradas por conexión WebSocket de Text to Dialogue
Hasta 10
Exactamente 1
La cifra de 150 ms proviene de la comparación de septiembre de 2026 de ElevenLabs usando guiones idénticos y ajustes predeterminados. Mide el inicio del habla audible, en lugar del retraso completo de una conversación con un agente de voz. Los límites de registro de voces aplican al endpoint WebSocket de Text to Dialogue.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo: Overview and Specifications
Eleven v4: Produced Audio and Multi-Speaker Performances
El posicionamiento publicado del modelo estándar describe su uso para la producción de voz de máxima calidad, incluyendo diálogo natural multihablante y narración de formato largo. Esto lo convierte en un primer candidato sensato cuando una grabación puede revisarse y editarse antes de su publicación. La pregunta relevante es si su entrega se mantiene convincente a lo largo de pasajes completos y líneas regeneradas.
Eleven v4 Turbo: Real-Time Expressive Speech
Eleven v4 Turbo está diseñado para agentes en tiempo real, asistentes y personajes interactivos. ElevenLabs afirma que conserva el rango expresivo completo de Eleven v4 y admite Professional Voice Clones, priorizando la generación de baja latencia.
Evalúelo mientras el audio se transmite y se reproduce, porque un clip aislado convincente no establece que toda la conversación responda con prontitud. Su baja latencia de inferencia es una especificación de partida, no una garantía para toda una aplicación.
Una locución breve y explicativa puede sonar igualmente aceptable en ambos, mientras que una escena dramática puede revelar diferencias que justifiquen una generación más costosa.
Architecture and Evaluation Scope
El anuncio oficial de arquitectura describe Eleven v4 como construido sobre una arquitectura completamente nueva y afirma que Turbo lleva la misma tecnología a los casos de uso de baja latencia. No divulga suficiente detalle para comparar conteos de parámetros, estructura de capas, cómputo de entrenamiento o los cambios específicos responsables de la diferencia de velocidad. Trate esos detalles como no divulgados en lugar de inferir que Turbo es más pequeño o destilado.
Native Limits and Voice Controls
Verifique el límite de entrada del modelo y el endpoint que planea usar antes de dividir un guion largo. Un límite publicado para una interfaz no se aplica automáticamente a otra, y la omisión de un límite no significa entrada ilimitada.
Ambas variantes ofrecen controles de Stability y Similarity. Al seleccionar un Professional Voice Clone con Eleven v4, un control deslizante Clone Strength ajusta cuán de cerca sigue la salida a las grabaciones de entrenamiento del clon. Valores bajos permiten una entrega más flexible con un ligero suavizado de la voz; valores altos preservan más de la actuación original y rasgos vocales distintivos, incluidos acentos. ElevenLabs recomienda comenzar en 0% para la mayoría de voces. Los controles Style y Speed no están disponibles en la experiencia nativa de v4, y SSML no está soportado.
La implicación para la migración es práctica: preserve el significado de sus instrucciones de voz existentes, pero revise cómo se expresan. Un guion antiguo con mucho SSML debe adaptarse y probarse en lugar de copiarse sin cambios.
Eleven v4 vs v4 Turbo: Performance
Published Benchmarks and Source Boundaries
Dos resultados oficiales importan aquí: preferencia de escucha y latencia de respuesta. Responden a preguntas diferentes.
Evidencia publicada — metodología de benchmark oficial
Resultado reportado
Qué establece
Pruebas ciegas de preferencia del modelo estándar
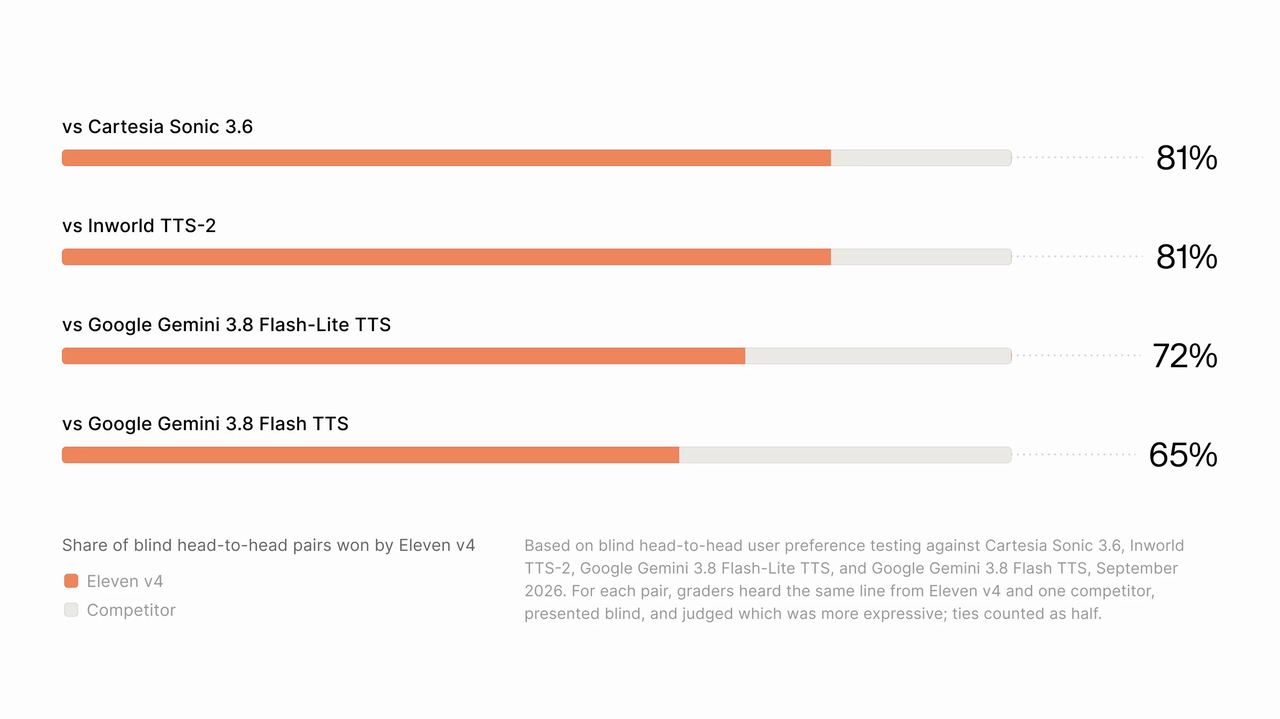
Aproximadamente 75% de preferencia general; el gráfico abarca 65%–81%
Preferencia de los oyentes sobre los modelos competidores probados
Latencia mediana de inferencia de Turbo
Aproximadamente 100 ms
Una afirmación de temporización de inferencia del modelo
Mediana del tiempo hasta el primer habla de Turbo
Aproximadamente 150 ms
Medición de solicitud a habla audible bajo el montaje de prueba indicado
Las pruebas de escucha publicadas comparan Eleven v4 con modelos de voz competidores. No establecen cuánto, si es que algo, lo prefieren los oyentes frente a Eleven v4 Turbo. Para esa elección, compare ambas variantes usando los mismos guiones y voces en su propia prueba ciega de escucha.
Gráfico oficial de latencia de ElevenLabs. Su temporización reportada excluye la latencia de red medida.
Evaluation Conditions
El estudio oficial de escucha de septiembre de 2026 usó comparaciones pareadas ciegas de la misma línea de Eleven v4 y un modelo competidor, juzgando expresividad y naturalidad; los empates contaron como medio punto. Los sistemas comparados y las tasas de preferencia por sistema aparecen en el gráfico oficial a continuación. Estos resultados reportados por el proveedor comparan Eleven v4 con sistemas competidores. No cuantifican una diferencia de calidad de escucha entre Eleven v4 y Eleven v4 Turbo.
La comparación de latencia de septiembre de 2026 usó guiones idénticos y ajustes predeterminados, eliminó la latencia de red medida para cada sistema y ejecutó Turbo por transmisión WebSocket. Los 150 ms reportados miden de la solicitud al habla audible; es una métrica diferente a la cifra de inferencia de aproximadamente 100 ms. La metodología citada no proporciona un desglose completo de hardware, región, carga y tamaño de muestra, por lo que no establece una garantía de latencia en producción.
Voice Quality and Production Consistency
ElevenLabs destaca el soporte de Professional Voice Clone, la mejora en consistencia del hablante a través de líneas regeneradas y el ensamblaje de solicitudes para audio de formato largo. Evalúe estas afirmaciones con un pasaje completo y una línea de reemplazo insertada en una grabación existente.
Para audio grabado, separe la entrega expresiva de la consistencia de producción. Escuche el énfasis, la emoción, la pronunciación y si el mismo hablante sigue siendo reconocible a lo largo de los pasajes. El modelo estándar es la opción del proveedor que prioriza la calidad, pero un guion instructivo simple puede no revelar una diferencia útil. Compare tomas aceptadas en lugar de suponer que una generación de mayor precio siempre requerirá menos edición.
Voice Direction and Multilingual Delivery
Ambas variantes admiten entrega expresiva, pero una expresión útil depende del guion y la voz que elija. Comience con un pequeño número de instrucciones claras y luego escuche si mejoran el significado previsto.
Una respuesta de soporte tranquilizadora puede combinar un tono cálido con una breve pausa:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Esto es un ejemplo ilustrativo, no un resultado de rendimiento medido. Pruébelo junto con una versión sin etiquetas. Las instrucciones adicionales solo son útiles cuando mejoran la salida.
La localización también merece una pasada de escucha por separado. Según la guía de producto nativa, la generación en el mismo idioma preserva el acento original de la voz de referencia, mientras que la generación entre idiomas adopta una pronunciación natural del idioma destino en lugar de arrastrar el acento del idioma fuente.
Ese comportamiento puede ser adecuado para un tutorial de producto localizado, pero un personaje ficticio con un acento extranjero deliberadamente reconocible puede requerir instrucciones adicionales. Evalúe por separado la pronunciación, la identidad y el acento previsto; una voz puede sonar fluida y aun así no cumplir con el brief creativo.
Latency and Reliability
Para un agente de voz en producción, la síntesis de voz es solo parte del retraso. El reconocimiento de voz, la detección de turno, la salida del modelo de lenguaje, el viaje por la red y el almacenamiento en búfer de audio pueden afectar cuándo el usuario escucha una respuesta.
Mida tanto los tiempos de respuesta medianos como los de la cola lenta en su propia aplicación. Una mediana baja puede coexistir con pausas ocasionales que hacen que una conversación resulte frustrante.
Eleven v4 vs v4 Turbo: Cost
Official API Character Prices
La comparación de la API nativa a continuación usa tarifas publicadas verificadas el 19 de octubre de 2026. Los totales de volumen son cálculos a partir de esas tarifas, en lugar de cotizaciones de paquetes por separado.
Uso — precios oficiales de la API
Variante estándar
Variante Turbo
Ahorro calculado con Turbo
1,000 characters
$0.08
$0.04
$0.04
100,000 characters
$8.00
$4.00
$4.00
1 million characters
$80.00
$40.00
$40.00
10 million characters
$800.00
$400.00
$400.00
Estas cifras describen la generación de voz basada en caracteres, no toda la factura de un agente de voz. Las asignaciones por suscripción, otros servicios y términos comerciales aplicables deben considerarse por separado.
CometAPI Pricing and Billing Conditions
CometAPI muestra precios denominados en tokens, mientras que las tarifas nativas anteriores son por carácter. Compare costos solo después de confirmar cómo el endpoint seleccionado mide y factura el uso. Si necesita Turbo, confirme que el modelo está disponible en la ruta de CometAPI elegida antes de planificar la integración.
Cost per Accepted Recording or Interaction
Para presupuestar, use:
Costo de generación de voz = caracteres facturables ÷ 1,000 × tarifa por carácter aplicable
Para producción de contenido, una medida operativa más útil es el costo por grabación aceptada. Incluya tomas regeneradas y tiempo de edición. Si la variante más barata falla repetidamente en una actuación difícil, su ventaja de precio unitario puede reducirse.
Para agentes en vivo, compare el costo de interacciones completadas al nivel de calidad y tiempo de respuesta requeridos. Una factura de síntesis baja tiene un valor limitado si los usuarios abandonan conversaciones lentas o confusas.
Eleven v4 vs v4 Turbo: Comparison and Selection
Capability and Workload-Based Selection
Las siguientes recomendaciones combinan el posicionamiento publicado con criterios de evaluación prácticos. Son puntos de partida para pruebas, no resultados de benchmark adicionales.
Proyecto
Punto de partida recomendado
Evaluación decisiva
Audiolibro o documental
Variante estándar
Consistencia en pasajes y líneas regeneradas
Escena dramática de personajes
Variante estándar
Entrega emocional e interacción entre hablantes
Agente de atención al cliente
Turbo
Tiempo de respuesta audible, pronunciación y manejo de interrupciones
Personaje de juego interactivo
Turbo
Capacidad de respuesta y rendimiento durante turnos cortos
Clips instructivos simples
Probar ambos
Si los oyentes notan una diferencia de calidad significativa
Producción multilingüe
Probar ambos por idioma
Pronunciación, acento e identidad de la voz
Producto con audio grabado y en vivo
Enrutamiento separado por carga
Si cada ruta cumple sus propios criterios de aceptación
Para audiolibros, publicidad y escenas dramáticas, pruebe Eleven v4 con un pasaje neutral, un pasaje emocional y una línea regenerada insertada en una grabación existente. Escuche coherencia de identidad de voz, ritmo y pronunciación en las uniones. Elija la variante estándar cuando la actuación aceptada o el tiempo ahorrado en edición justifiquen su mayor costo de generación.
Para agentes de soporte y personajes interactivos, pruebe Turbo a lo largo de toda la conversación: habla del usuario, detección de turno, generación de respuesta, síntesis y reproducción. Incluya conexiones lentas, fallos de conexión e interrupciones. Confirme que la reproducción se detiene con prontitud cuando el usuario interrumpe y que la siguiente respuesta comienza limpiamente. Elija Turbo cuando cumpla tanto su umbral de calidad de escucha como su objetivo de tiempo de respuesta.
Construya un conjunto de pruebas representativo: incluya una explicación neutral, una respuesta tranquilizadora, un pasaje emocional, nombres o abreviaturas y texto multilingüe que use su audiencia.
Mantenga el guion, la voz y los ajustes de salida tan comparables como lo permita cada interfaz.
Revise las grabaciones sin etiquetas de modelo. Registre errores de pronunciación, incoherencias de identidad de voz y las correcciones que necesita cada toma.
Mida el tiempo de respuesta en vivo por separado de la calidad de escucha, incluyendo tanto la latencia mediana como los retrasos de la cola lenta.
Fije umbrales de aceptación antes de elegir una ruta: pronunciación, consistencia de voz, esfuerzo de edición, tiempo de respuesta mediano y tiempo de respuesta de cola lenta.
Pase tráfico representativo por el endpoint que desplegará. Rastree salidas rechazadas, reintentos y fallos de reproducción o conexión.
Compare el costo por grabación aceptada o interacción completada, incluyendo tomas regeneradas y esfuerzo de edición.
Para productos con audio pregrabado y en vivo, pruebe enrutamientos separados y confirme que cada ruta cumple sus propios umbrales de aceptación.
Where Can You Access Eleven v4 and v4 Turbo?
Official Provider Access
Use la ruta nativa del proveedor que coincide con la carga de trabajo: síntesis y diálogo generados para audio producido, y transmisión WebSocket de Text to Dialogue para interacción con Turbo. El ejemplo oficial a continuación documenta la conexión de transmisión y sus restricciones de registro de voces. Verifique el esquema actual del endpoint, los requisitos de autenticación y los límites de cuenta antes de conectar una carga de trabajo de producción.
La misma referencia especifica exactamente una voz registrada por conexión de Turbo, en comparación con hasta diez para la variante estándar en ese endpoint. Son reglas a nivel de conexión, no una declaración universal sobre cada interfaz.
CometAPI Access
La API de Eleven v4 en CometAPI proporciona una ruta para generar voz a través de una interfaz compatible con Runway. Su anuncio de integración del 10 de octubre de 2026 documenta el comportamiento específico del proveedor resumido a continuación.
Detalle de integración — anuncio de CometAPI
Comportamiento publicado
Model ID
eleven_v4
Endpoint de envío
POST /runwayml/v1/text_to_speech
Procesamiento
Envío de tareas asíncrono
Salida
Audio MP3
Límite de entrada
Hasta 2,500 caracteres por solicitud
Configuración de voz
Voces preconfiguradas
Control adicional expuesto
Velocidad de habla ajustable
Estos son detalles de integración específicos del proveedor. El límite nativo de 10,000 caracteres y los controles de la interfaz nativa no deben sustituirse por el comportamiento documentado de esta interfaz. Del mismo modo, el flujo de trabajo asíncrono no establece que el rendimiento nativo de WebSocket de Turbo esté disponible a través de esta ruta.
Una secuencia práctica de integración es enviar un guion corto, seguir el flujo de trabajo documentado de estado de tarea, recuperar el resultado y verificar la pronunciación y la duración de salida antes de aumentar el volumen.
Conclusion
Elija Eleven v4 cuando sus grabaciones aceptadas ofrezcan suficiente calidad de rendimiento o ahorro de producción para justificar la mayor tarifa por carácter. Elija Eleven v4 Turbo cuando supere su umbral de escucha y respalde la capacidad de respuesta necesaria para una conversación en vivo. Tome la decisión final sobre el endpoint que desplegará, incluyendo guiones representativos, reintentos y el costo operativo total.
FAQ
¿Cómo se deben dividir guiones largos de Eleven v4 para producción?
Divida en límites de párrafo, oración o escena en lugar de la mitad de una palabra o el turno de un hablante. Deje espacio para cualquier texto de dirección dentro de la entrada permitida del endpoint, mantenga un registro del guion y la configuración de voz de cada segmento y escuche las uniones después de ensamblar el audio. Compare sonoridad, ritmo, pronunciación e identidad de voz a través de los límites; aceptar cada clip individualmente no establece que la grabación combinada sea continua. Use el límite del endpoint del proveedor real, ya que los límites de solicitudes nativos y de CometAPI difieren.
¿Cómo se debe reintentar una solicitud de Eleven v4 interrumpida?
Rastree el identificador de la solicitud o tarea original y determine su estado antes de enviar el mismo texto nuevamente. Para un flujo de trabajo asíncrono del proveedor, verifique si la tarea original se completó y si su resultado sigue siendo recuperable. Para una transmisión en vivo, registre qué audio ya se reprodujo y decida si volver a reproducir la frase o recuperar en un límite limpio. Confirme las reglas de reintento, idempotencia y facturación del endpoint; no asuma que repetir una solicitud es gratis o que produce audio idéntico.
¿Cómo pueden los equipos hacer pruebas de regresión de una versión de voz de Eleven v4?
Mantenga un conjunto fijo de aceptación que contenga nombres de marca, abreviaturas, números, pronunciaciones difíciles, pasajes emocionales y los idiomas usados por el producto. Archive el guion, identificador del modelo, identificador de la voz, ajustes disponibles, fecha de generación y grabaciones de referencia aceptadas. Cuando cambien un modelo, voz o integración, escuche nuevas muestras frente a esas referencias y documente cualquier corrección requerida. Separe un procedimiento de prueba reproducible de la suposición de formas de onda idénticas: pasar una grabación no garantiza que cada generación posterior pase.